2 Décrire une variable
Décrire une variable consiste à résumer sa distribution observée, c’est-à-dire la façon dont ses valeurs se répartissent dans l’échantillon. Les outils ne sont pas les mêmes - sinon ce n’est pas drôle - pour une variable quantitative et pour une variable qualitative.
2.1 Variables quantitatives
Comme l’on travaille avec des variables pouvant prendre beaucoup de valeurs différentes, on ne peut pas se contenter de compter les effectifs de chaque valeur : il nous faut un moyen de résumer le tout. Deux informations peuvent être utiles : une valeur “typique” de notre variable - un indicateur de position - et à quel point les valeurs sont globalement éparpillées - un indicateur de dispersion.
Pour la suite, on note \(n\) l’effectif total (soit le nombre d’observations), et \(x_1,\ldots,x_n\) les valeurs observées de la variable quantitative.
2.1.1 Indicateurs de position
Les indicateurs de position résument l’ensemble des valeurs par une valeur “typique”.
Les deux premiers sont assez faciles, ce sont le minimum et le maximum.
Ensuite, le mode d’une variable est la valeur la plus fréquente. Pour une variable quantitative continue regroupée en classes, on parle plutôt de classe modale.
Le plus connu des indicateurs est la moyenne arithmétique, qui correspond simplement à l’opération que vous faites quand vous calculez la moyenne de vos notes de cours ! Pour \(n\) observations \(x_1,\ldots,x_n\), la moyenne empirique \(\bar{x}\) est \[ \bar x=\frac{1}{n}\sum_{i=1}^n x_i \] Autrement dit, on additionne toutes les valeurs, et on divise par le nombre d’observations.
Bien qu’elle utilise toutes les valeurs, deux moyennes identiques ne signifient pas nécessairement que les distributions sont similaires. De plus, elle est sensible aux valeurs extrêmes.
La médiane est la valeur qui sépare l’échantillon ordonné en deux parties de même effectif : 50 % des observations sont inférieures ou égales à la médiane et 50 % sont supérieures ou égales. C’est, grossièrement, la valeur du milieu.
Contrairement à la moyenne, la médiane est beaucoup moins sensible aux valeurs extrêmes : elle est dite “robuste”. Elle est un bon indicateur de position lorsque la distribution est très asymétrique ou contient des valeurs extrêmes.
Ses proches cousins sont les quartiles \(Q_1\), \(Q_2\) et \(Q_3\), qui découpent la série en quatre parties. Le premier quartile \(Q_1\) correspond à la valeur en dessous de laquelle se trouvent 25 % des observations, le deuxième quartile \(Q_2\) correspond à la médiane, et le troisième quartile \(Q_3\) correspond à la valeur en dessous de laquelle se trouvent 75 % des observations. Pour les calculer, on doit ordonner les valeurs par ordre croissant.
La remarque sur la robustesse de la médiane s’applique aussi aux quartiles.
Note
Il existe beaucoup d’approches pour calculer les quartiles. Pour rester simple, nous considérons \(Q_1\) et \(Q_3\) comme les médianes des deux moitiés de la série. Pour cela, on ordonne la série par ordre croissant et on calcule la médiane. On obtient alors deux “parties” : la partie à gauche de la médiane et celle à droite. Alors
- le premier quartile est la médiane des valeurs à gauche de la médiane,
- et le troisième quartile est la médiane des valeurs à droite de la médiane.
En pratique, votre logiciel statistique préféré utilisera une “meilleure” méthode, ce qui peut expliquer que vos résultats diffèrent légèrement de ceux obtenus à la main !
2.1.2 Indicateurs de dispersion
À lui seul, un indicateur de position n’est pas suffisant pour décrire une série de valeurs.
C’est pour éviter ces ambiguïtés que les indicateurs de dispersion existent. Ils sont généralement à compléter avec un indicateur de position pour décrire une variable quantitative.
Quand on calcule la moyenne, on fournit généralement la variance empirique corrigée (on dira simplement variance entre nous). La formule est la suivante : \[ s^2=\frac{1}{n-1}\sum_{i=1}^n (x_i-\bar x)^2 \] et on a donc besoin de la moyenne empirique \(\bar{x}\) pour la calculer. Il est assez difficile d’interpréter directement la variance, mais gardez en tête deux points : 1/ plus la valeur est grande, plus les données sont dispersées autour de la moyenne ; 2/ la variance s’exprime dans l’unité de la variable au carré.
Le dénominateur \(n-1\) correspond à la correction de Bessel (vous en faites ce que vous voulez) ; c’est la formule utilisée en pratique lorsque l’on décrit un échantillon et que l’on veut estimer la variabilité dans une population plus large.
Pour ce second point, un moyen d’exprimer cette variabilité dans la même unité que la variable est de calculer l’écart-type \(s\). Il s’agit de la racine carrée de la variance, soit : \[ s = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i-\bar x)^2} = \sqrt{s^2} \]
Note
Bien qu’il ne soit pas aisé de l’interpréter, la variance/écart-type nous sera très utile pour tous les cours suivants : intervalles de confiance, tests statistiques …
-
On peut voir un cas où l’utiliser peut être utile, à savoir pour comparer la dispersion de deux séries d’une même variable quantitative. Dans notre exemple avec les notes de mathématiques, on a deux séries : 0, 5, 15, 20 et 10, 10, 10, 10. Ces deux séries ont la même moyenne arithmétique ; cependant :
- Pour la première série, on a une variance empirique corrigée d’environ \(83,3\), contre \(0\) pour la seconde.
- Ainsi, la première série est beaucoup plus dispersée que la seconde (qui, en l’occurrence, ne présente aucune dispersion puisque la variance est nulle).
L’étendue est la différence entre le maximum et le minimum. Elle est simple à calculer, mais très sensible aux valeurs extrêmes.
Enfin, l’intervalle interquartile est l’intervalle \([Q_1,Q_3]\). Sa largeur, appelée écart interquartile (ou étendue interquartile) vaut \(IQR=Q_3-Q_1\). \[ IQR=Q_3-Q_1. \] Cette mesure décrit la dispersion de la moitié centrale des valeurs : plus elle est grande, plus cette moitié centrale est dispersée (et inversement si elle est petite).
“IQR” signifie “interquartile range” en anglais.
2.1.3 Forme de la distribution
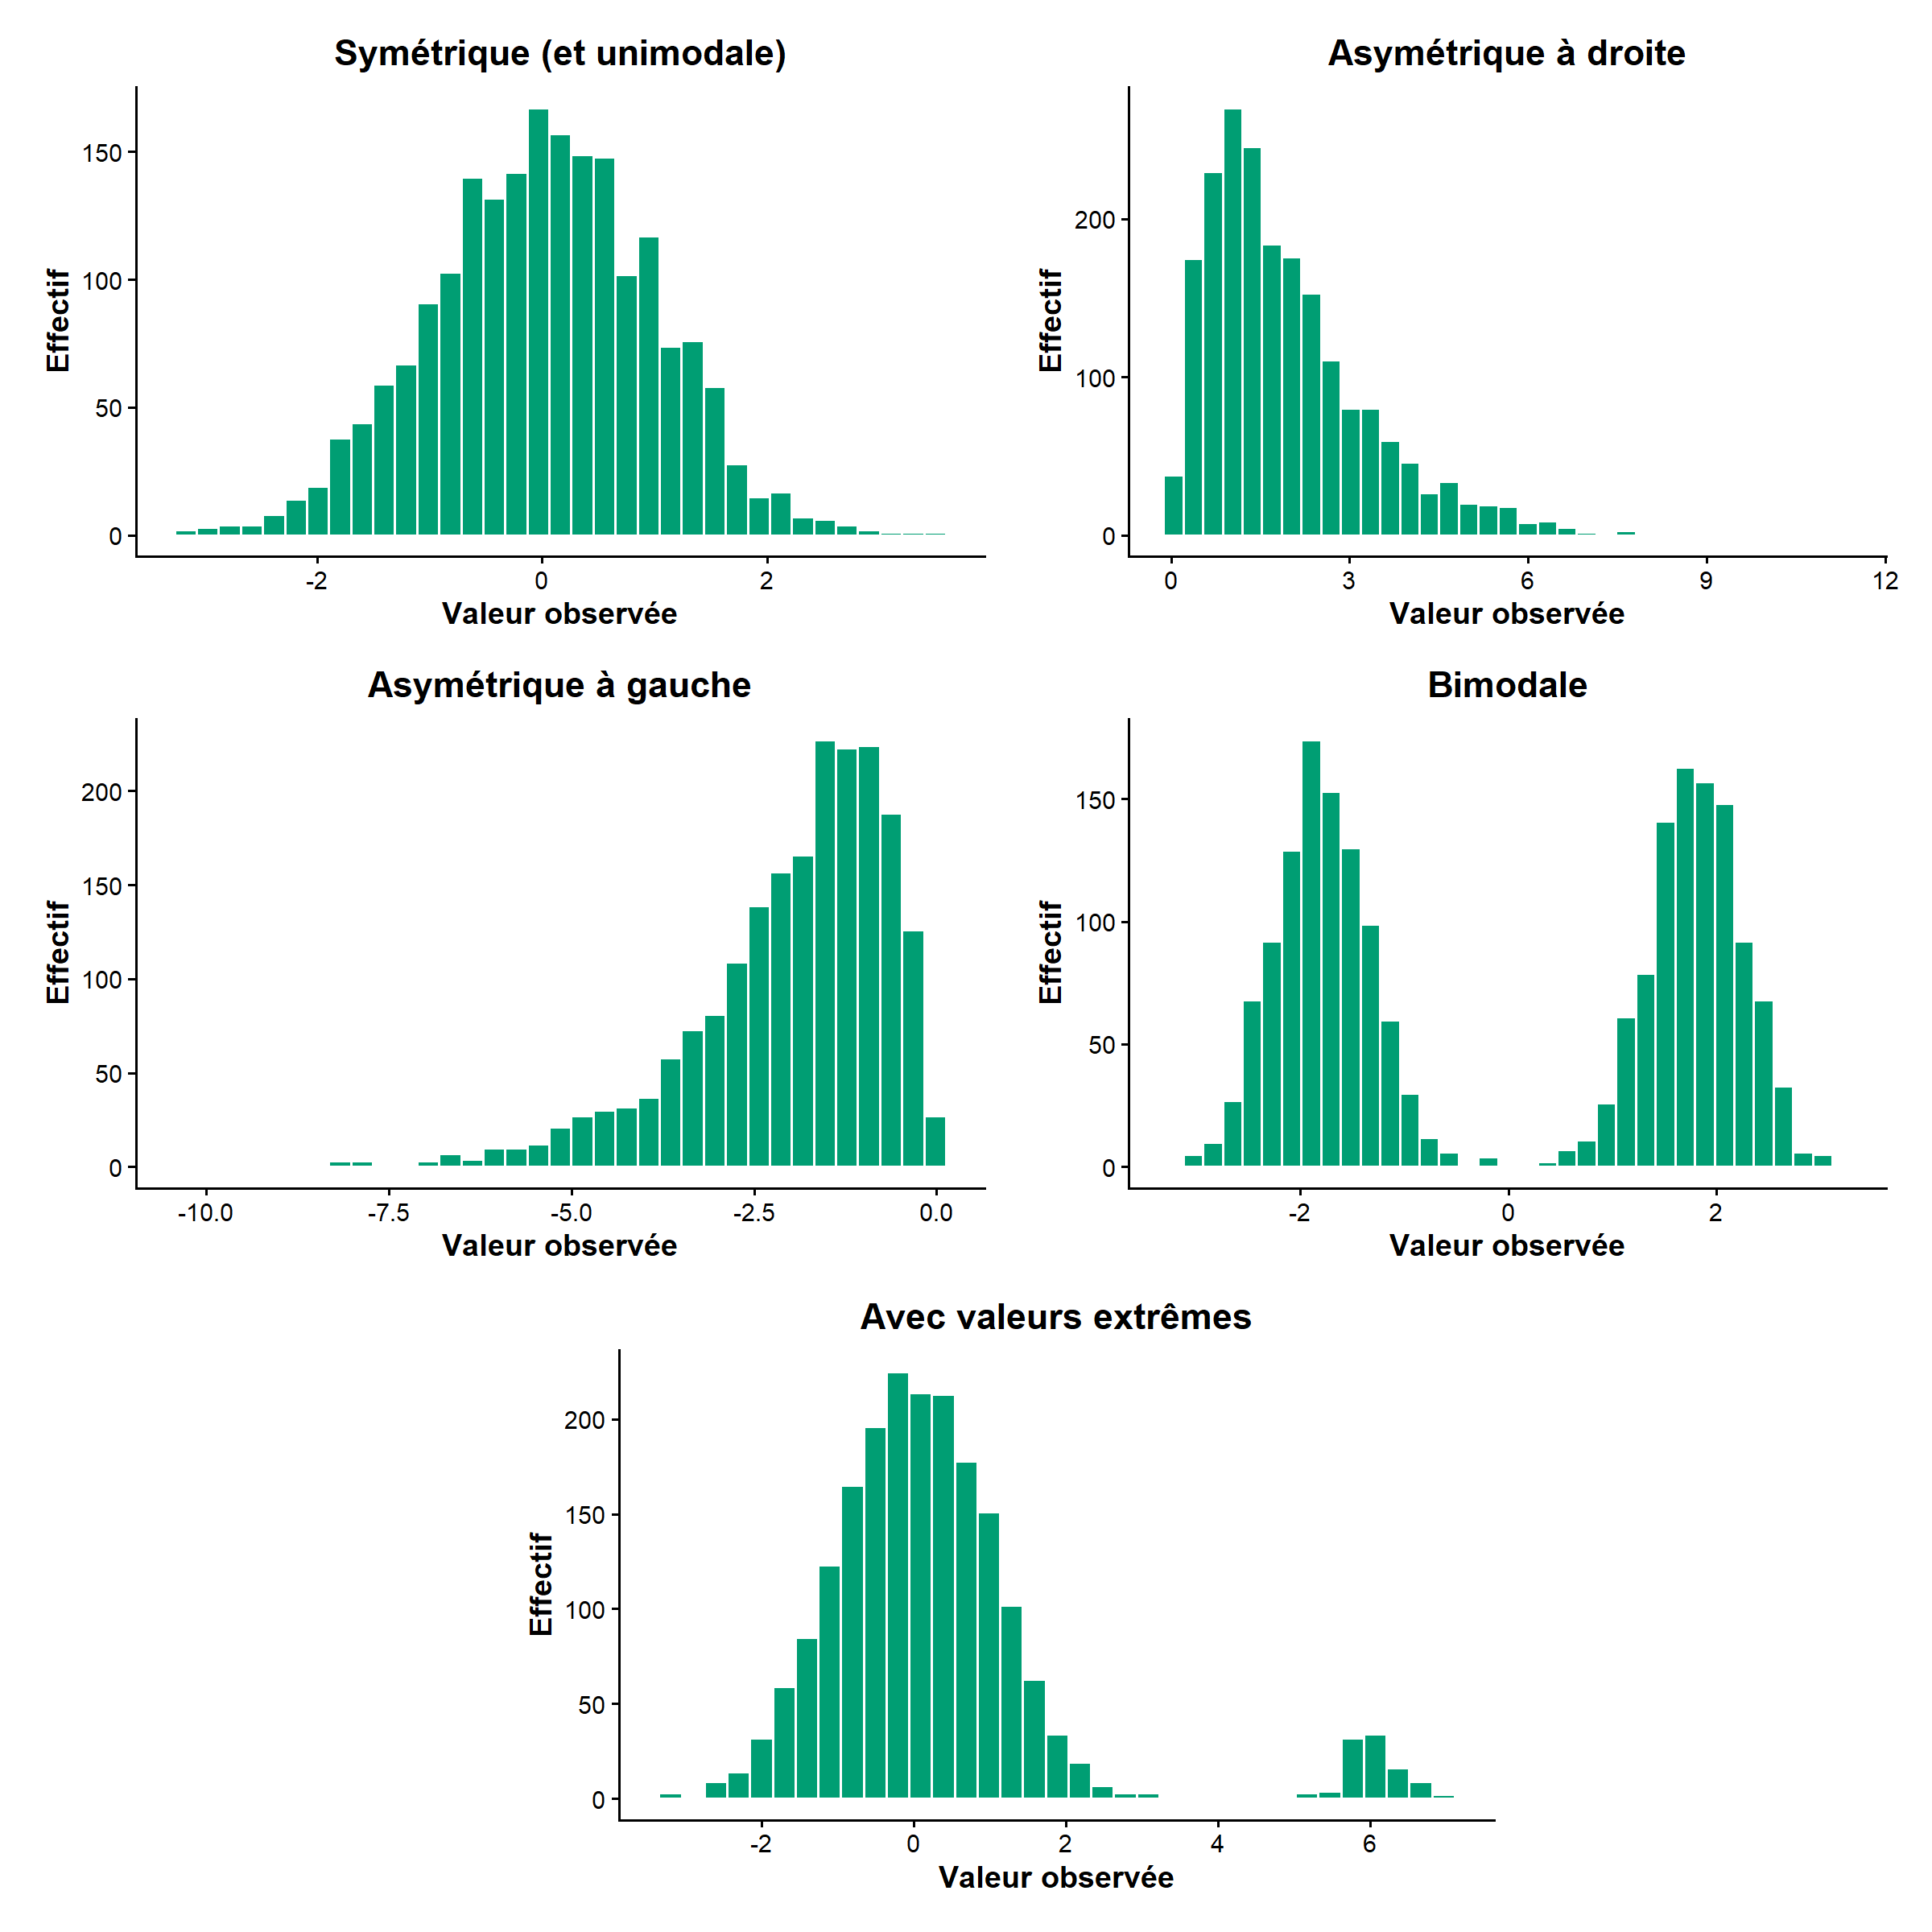
En pratique, il n’y a pas de recette magique pour choisir l’indicateur de position et de dispersion à utiliser. Nous le verrons dans le chapitre Représentation des données, mais il est souvent utile de visualiser la distribution de la variable pour se faire une idée de sa forme. Une distribution peut être :
- symétrique ;
- asymétrique à droite (ou à gauche) ;
- unimodale, bimodale, ou plus généralement multimodale ;
- avec des valeurs extrêmes.
Note
Pour une distribution à peu près symétrique et sans valeur extrême majeure, le couple moyenne-écart-type est souvent adapté. Avec de l’asymétrie / valeurs extrêmes, on préfère la médiane et l’écart interquartile.
“Mais, c’est à l’envers votre asymétrie à gauche et à droite !”. Et non ! Il ne faut pas voir “droite” et “gauche” comme “où est la grosse partie de ma distribution”, mais plutôt “dans quelle direction ma distribution s’étire”.
2.2 Variables qualitatives
Cette partie est un peu plus rapide, car il n’y a pas une myriade d’indicateurs à connaître. Comme nous travaillons avec des modalités, on peut donner le nombre d’observations pour chaque modalité : c’est l’effectif. On peut aussi rapporter cette valeur au nombre total d’observations : c’est la fréquence (ou proportion). Mathématiquement, en notant \(n_j\) l’effectif de la modalité \(j\) et \(n_{obs}\) l’effectif observé sans valeur manquante, la fréquence \(f_j\) de la modalité \(j\) est : \[ f_j=\frac{n_j}{n_{obs}} \]
En anglais, on parle de “frequency” (ou “absolute frequency”) pour l’effectif, et de “relative frequency” pour la proportion. Attention aux faux-amis !
Plutôt qu’une fréquence, il est souvent plus parlant de donner le pourcentage correspondant, qui est \(100\times f_j\). Pour une variable ordonnée, on peut aussi calculer une fréquence cumulée, c’est-à-dire la proportion d’observations situées jusqu’à une modalité donnée.
Quelques remarques :
Comme pour la variable quantitative, on peut calculer le mode, soit la modalité la plus fréquente. Dans l’exemple précédent, il s’agit de “légère” avec 40 % des patients.
Pour une variable nominale, l’ordre d’affichage des modalités doit être “parlant” : ordre alphabétique, ordre de fréquence ou ordre fixé par le dictionnaire de données.
Pour une variable ordinale, il faut conserver l’ordre naturel des modalités. C’est ce que nous avons fait dans l’exemple précédent, en commençant par “absente” et en finissant par “sévère”. Cela rend aussi plus facile l’interprétation des fréquences cumulées.