1 Loi statistique
Une variable aléatoire est une quantité dont la valeur dépend du hasard. Elle peut être binaire, comme un événement oui/non, discrète, comme un nombre d’événements, ou continue, comme une mesure biologique.
Une loi précise notamment :
- les valeurs possibles de la variable ;
- la façon dont les probabilités sont réparties ;
- les paramètres qui gouvernent cette répartition.
Un paramètre est une quantité théorique qui décrit la population ou le mécanisme étudié. En statistique, on l’observe rarement directement : on l’estime à partir d’un échantillon.
On note souvent : \[ X \sim \mathcal D(\theta), \] ce qui se lit : “la variable aléatoire \(X\) suit la loi \(\mathcal D\) de paramètre \(\theta\)”.
Avertissement
Une loi statistique ne dit pas ce qui va forcément arriver dans le prochain échantillon. Elle décrit ce qui est attendu sur un grand nombre d’échantillons comparables. C’est exactement cette idée qui sera utilisée plus loin pour comprendre les intervalles.
1.1 Lois pour variables discrètes
Les lois discrètes concernent des variables qui prennent des valeurs séparées : 0 ou 1, un nombre de patients, un nombre de consultations, un nombre de cas, etc. Elles sont utiles dès que la variable est un comptage ou un événement binaire.
1.1.1 Loi de Bernoulli
Une variable de Bernoulli modélise un seul événement binaire : oui/non, malade/non malade, succès/échec, décès/survie pendant une période donnée.
Le paramètre \(\pi\) est la probabilité de l’événement codé 1. Par convention, on choisit soi-même quel événement vaut 1, mais il faut l’écrire explicitement.
Cette formulation suppose que le statut est connu pour tous à une échéance commune ; en présence de durées de suivi différentes ou de censure, il faut utiliser les méthodes d’analyse de survie (voir le chapitre Introduction à l’analyse de survie).
1.1.2 Loi binomiale
On peut être amené à répéter plusieurs fois une expérience qui pourrait être modélisée par une loi de Bernoulli. Ainsi, une loi binomiale modélise le nombre de succès lors de \(n\) répétitions indépendantes d’une même expérience de Bernoulli.
Si \(X\sim\mathcal B(n,\pi)\) : \[ \mathbb P(X=k)=\binom{n}{k}\pi^k(1-\pi)^{n-k},\quad k=0,\ldots,n. \]
Ici, \(X\) est un comptage : il peut valoir 0, 1, 2, …, \(n\). Le paramètre \(n\) est la taille de l’échantillon ou le nombre d’essais, et \(\pi\) est la probabilité individuelle de succès.
1.1.3 Loi de Poisson
La loi de Poisson modélise souvent un nombre d’événements observés sur une durée, une surface, un volume ou une population fixée.
Si \(X\sim\mathrm{Poisson}(\lambda)\) : \[ \mathbb P(X=k)=e^{-\lambda}\frac{\lambda^k}{k!},\quad k=0,1,2,\ldots \]
Le paramètre \(\lambda\) représente le nombre moyen d’événements attendus sur l’unité d’observation choisie. Si l’unité change, \(\lambda\) change aussi.
1.2 Lois pour variables continues
Les lois continues concernent des variables qui peuvent, en théorie, prendre toutes les valeurs d’un intervalle : IMC, âge, pression artérielle, concentration d’un biomarqueur, etc.
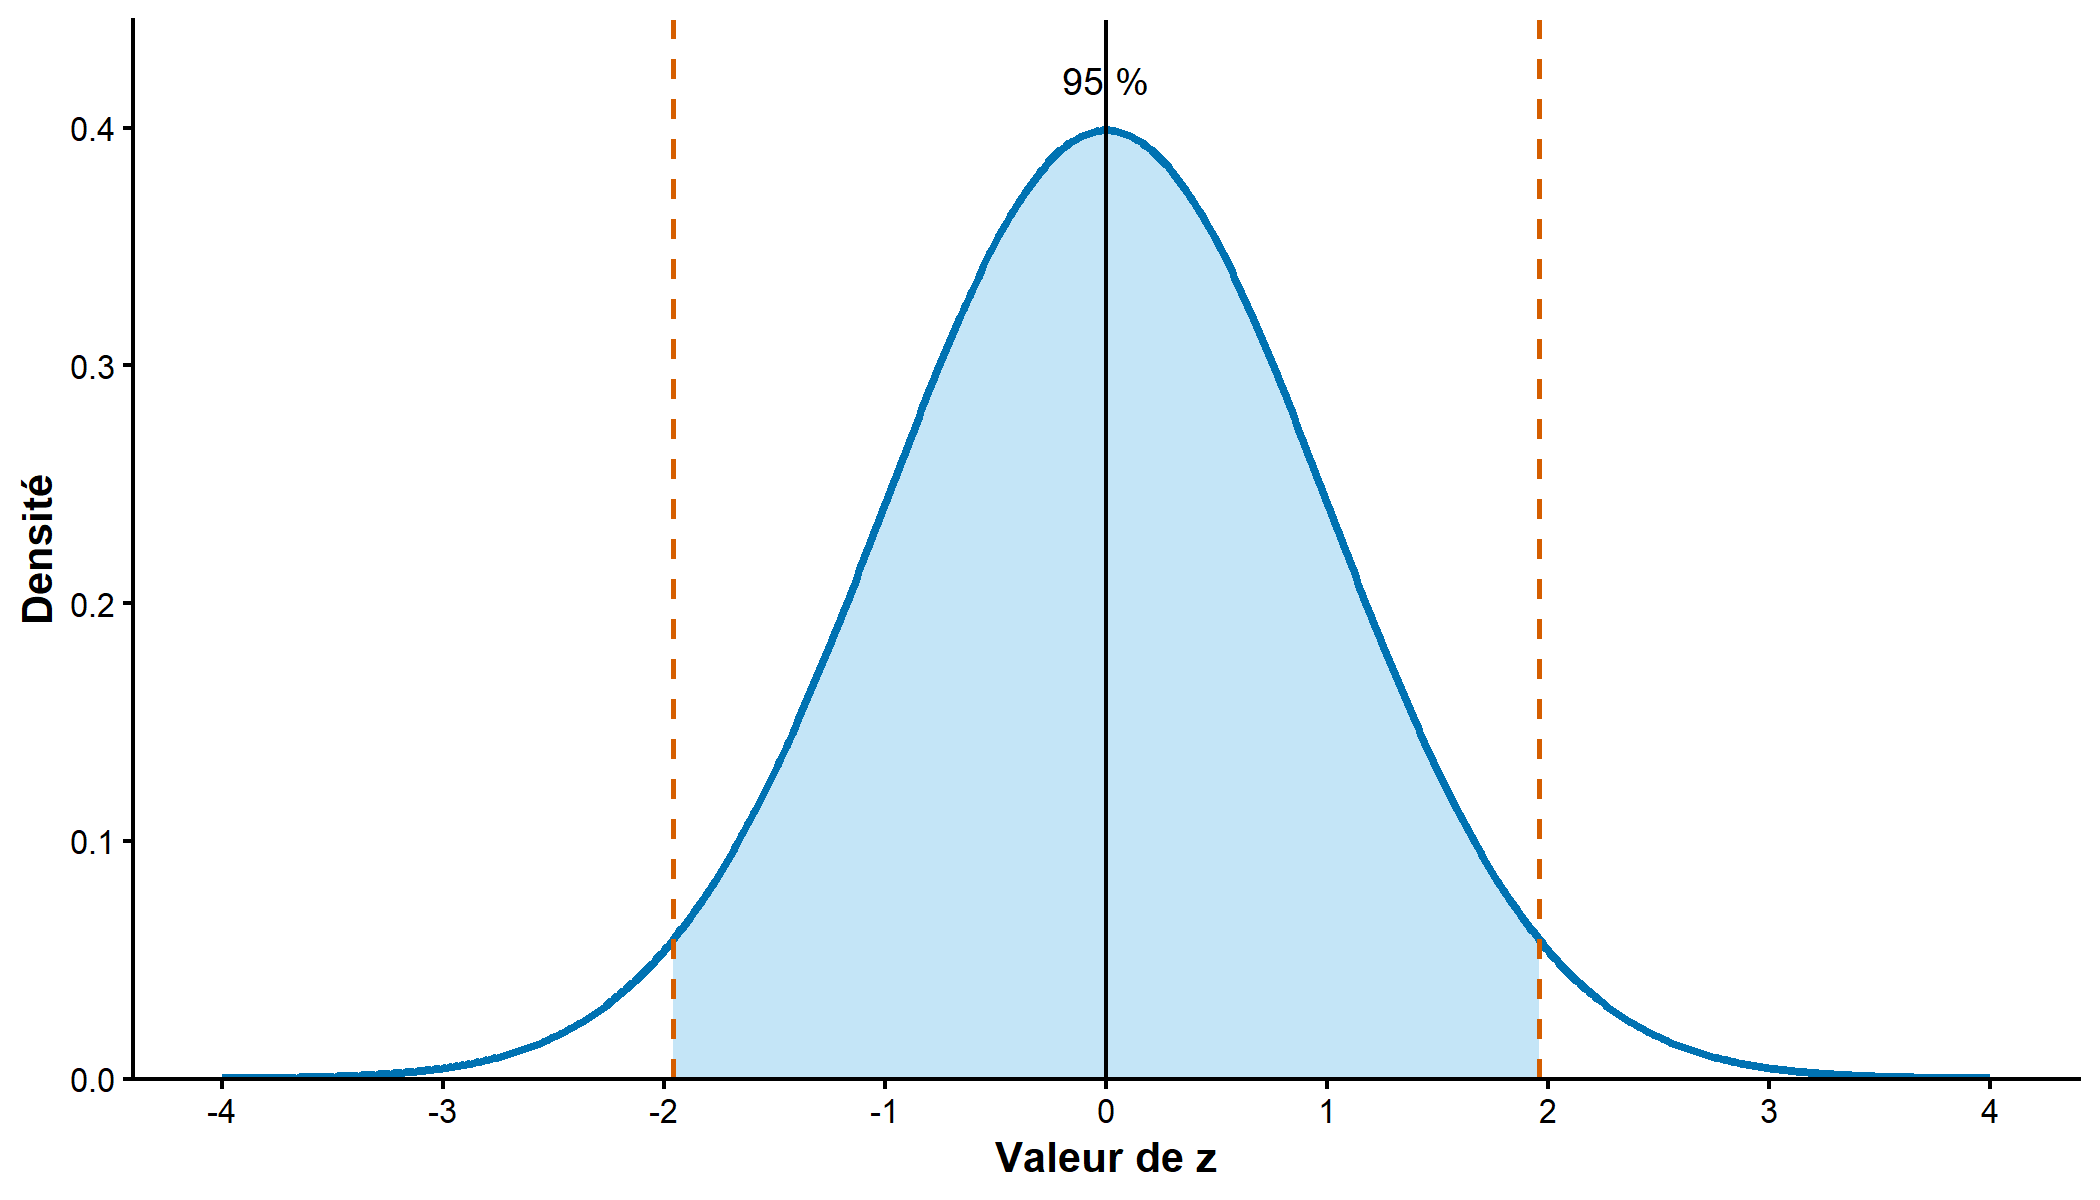
Sur les prochains graphiques, l’axe horizontal représente les valeurs possibles de la variable aléatoire. L’axe vertical représente une densité. Pour une variable continue, la probabilité ne se lit pas à la hauteur de la courbe, mais dans l’aire sous la courbe entre deux valeurs.
Dans la loi normale centrée réduite, les quantiles sont souvent notés avec la lettre \(z\). Dans la loi de Student, ils sont souvent notés avec la lettre \(t\). Ce sont ces quantiles qui fournissent les constantes utilisées dans les formules d’intervalles.
1.2.1 Loi normale (ou loi de Gauss)
C’est probablement la plus connue des lois continues. La loi normale est centrale en statistique car elle décrit assez bien certaines mesures biologiques et, surtout, parce qu’elle apparaît dans de nombreuses approximations lorsque la taille d’échantillon est grande.
On note \(X\sim\mathcal N(\mu,\sigma^2)\) lorsque la distribution est normale de moyenne \(\mu\) (le centre de la distribution) et de variance \(\sigma^2\) (la dispersion de la distribution autour de la moyenne). Plus \(\sigma\) est grand, plus la distribution est étalée.
La valeur de \(z\) au quantile 2,5 % est \(z_{0,025}=-1,96\), et au quantile 97,5 %, \(z_{0,975}=1,96\) : ce sont les fameux “1,96” qu’on retrouve dans beaucoup de formules.
Le “5 %” souvent associé à un niveau de confiance de 95 % correspond à la probabilité située en dehors de l’intervalle \([-1,96 \, ; \, 1,96]\) : 2,5 % à gauche et 2,5 % à droite.
Note
On peut se ramener à la loi normale centrée réduite \(\mathcal N(0,1)\) en standardisant la variable \(X\). Si \(X \sim \mathcal N(\mu, \sigma^2)\), la variable standardisée \[ Z=\frac{X-\mu}{\sigma} \] suit une loi normale centrée réduite \(\mathcal N(0,1)\). Cette opération explique la forme de nombreuses statistiques de test (voir le chapitre Tests statistiques) : on compare une différence observée à une quantité qui mesure sa variabilité.
1.2.2 Lois de Student, du \(\chi^2\) et de Fisher
On ne va pas détailler ces lois ici, mais elles reviendront souvent dans la suite du cours parce qu’elles interviennent dans la construction des intervalles de confiance et des tests statistiques :
- la loi de Student (test t, intervalle de confiance) ;
- la loi du \(\chi^2\) (tests du chi-deux) ;
- la loi de Fisher (test ANOVA, tests de comparaison de variances).
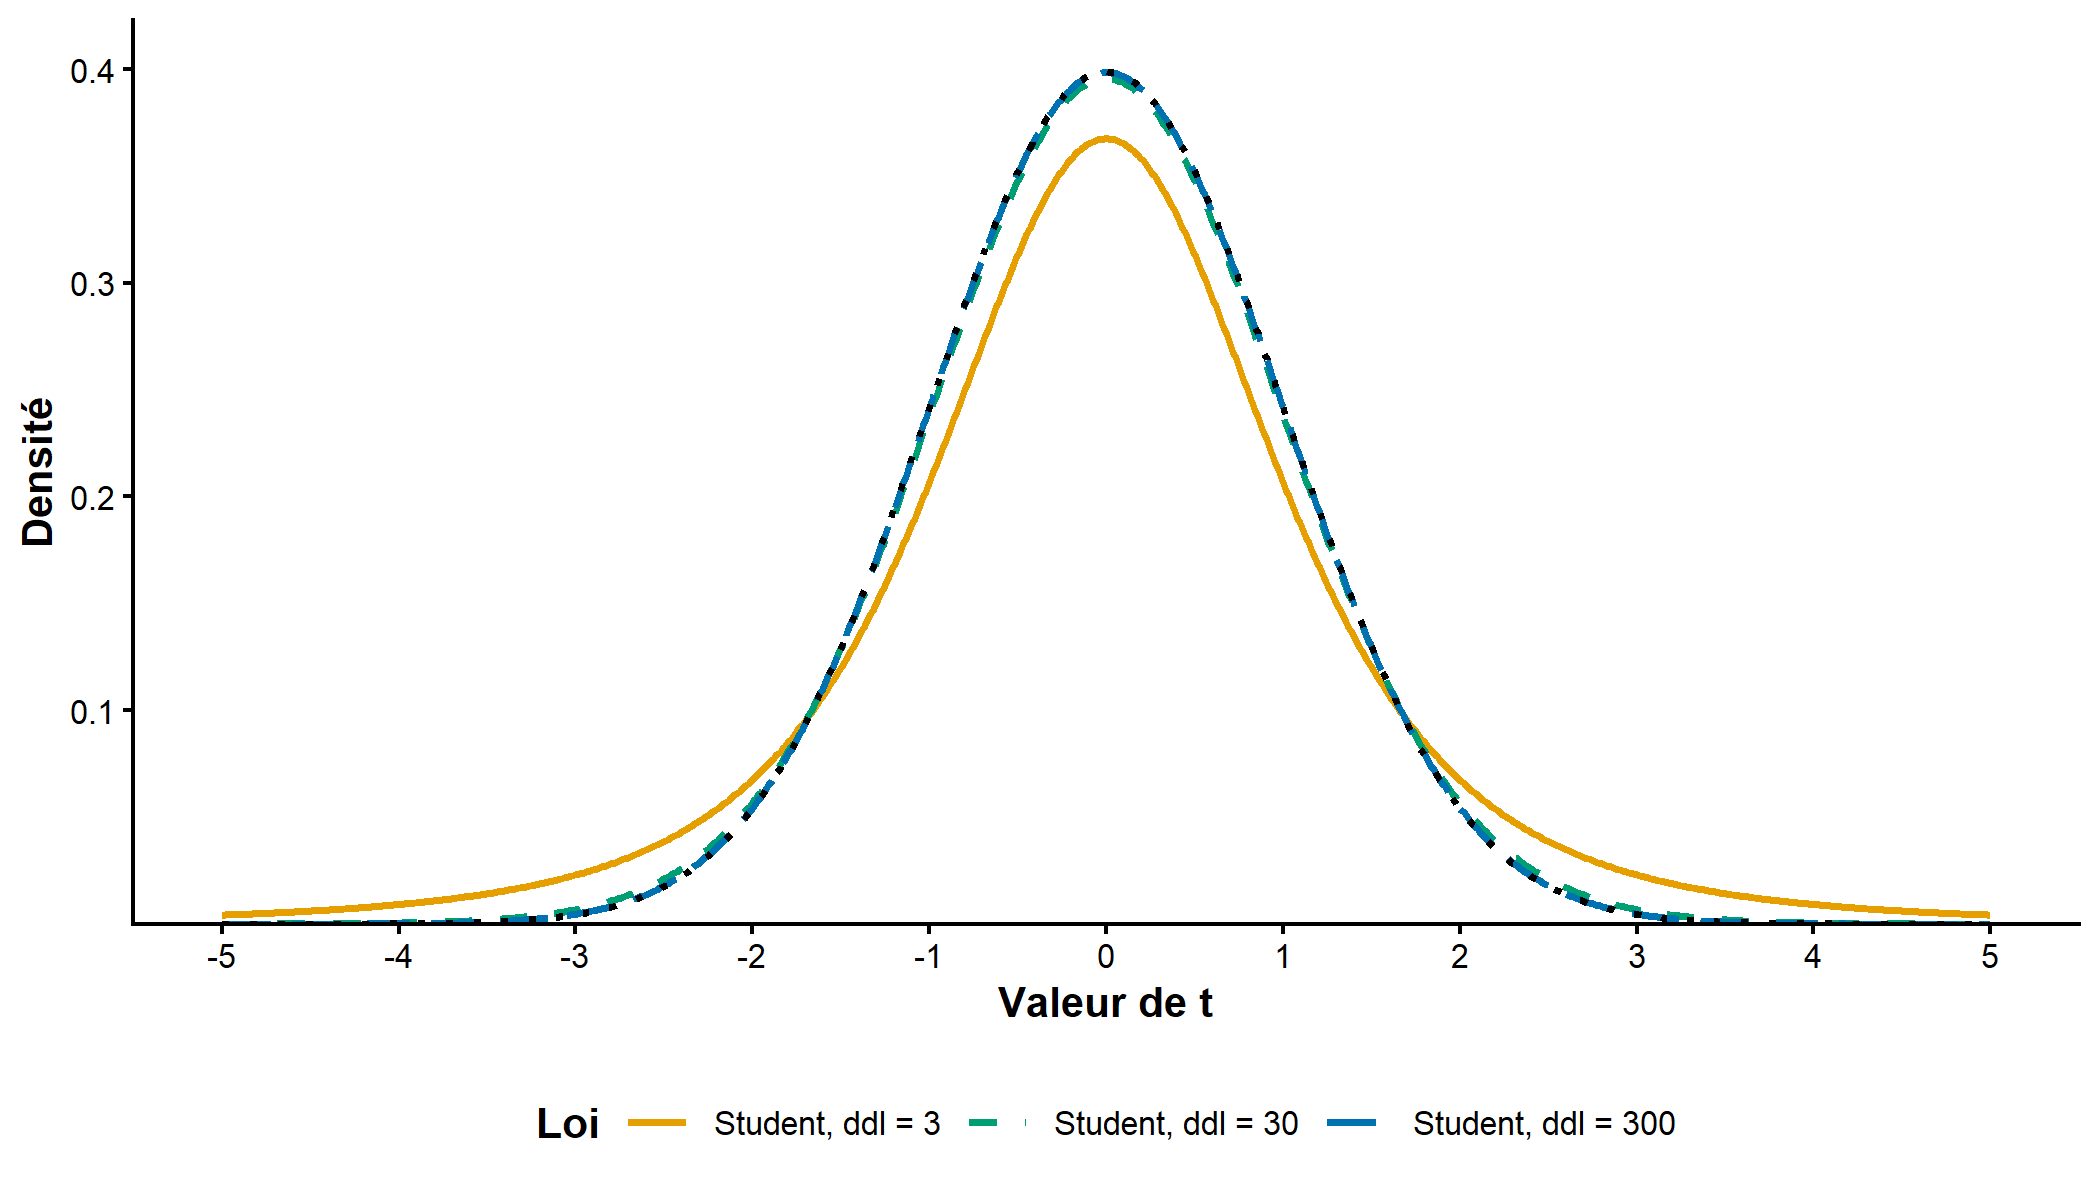
La loi de Student ressemble à la loi normale, mais avec des queues plus épaisses quand l’échantillon est petit. Elle dépend d’un paramètre appelé degrés de liberté. Pour une moyenne calculée sur \(n\) sujets, on utilise souvent \(n-1\) degrés de liberté.
Lorsque l’échantillon est suffisamment grand, la loi de Student devient très proche de la loi normale. C’est pour cela que les formules avec Student et les formules avec 1,96 donnent presque le même résultat dans les grands échantillons. La Figure 2 illustre ce rapprochement.