Et avec R ?
Le package survival est la référence pour l’analyse de survie. Il permet de créer les données de survie, d’estimer des fonctions de survie et de réaliser des tests statistiques. Le package survminer permet de produire plus facilement les graphiques présentés dans le cours !
Nous travaillerons ici sur les données de l’étude Toxo utilisées dans le cours. Pour chaque sujet, il faut au minimum connaître le temps observé et savoir si ce temps se termine par l’évènement (codé 1) ou par une censure (codée 0).
| deltoxo | indtoxo | age | age_status | traitement |
|---|---|---|---|---|
| 1 | 0 | 33.03 | 33.03 | Pyriméthamine |
| 7 | 1 | 36.68 | 36.70 | Placebo |
| 19 | 1 | 52.38 | 52.44 | Pyriméthamine |
| 20 | 1 | 39.84 | 39.89 | Placebo |
| 22 | 0 | 39.09 | 39.15 | Pyriméthamine |
| 28 | 0 | 53.41 | 53.49 | Pyriméthamine |
Construire un objet de survie
La fonction Surv() rassemble le temps et l’indicatrice d’évènement dans un objet compris par les fonctions d’analyse de survie (quasiment toutes les fonctions en R qui travaillent sur la survie prennent un objet Surv() en entrée, c’est dire !).
Dans le cas habituel d’une censure à droite, on indique un temps de suivi et l’indicatrice d’évènement. Ici, deltoxo est le délai en jours depuis l’inclusion et indtoxo vaut 1 en cas de toxoplasmose et 0 en cas de censure :
[1] 1+ 7 19 20 22+ 28+Le symbole + affiché après un temps indique une observation censurée.
Si l’on choisit l’âge comme axe du temps, les sujets ne sont pas observés depuis leur naissance : ils entrent dans l’étude à des âges différents. Il faut alors préciser le début et la fin de la période pendant laquelle chaque sujet est à risque. Cette écriture prend en compte la troncature à gauche, aussi appelée entrée retardée :
Estimateur de Kaplan-Meier
On obtient l’estimateur de Kaplan-Meier avec survfit(). La partie droite de la formule vaut 1 lorsqu’on estime une seule fonction de survie pour l’ensemble de l’échantillon.
Avec le délai depuis l’inclusion
Call: survfit(formula = Surv(deltoxo, indtoxo) ~ 1, data = toxo)

 time n.risk n.event survival std.err lower 95% CI upper 95% CI
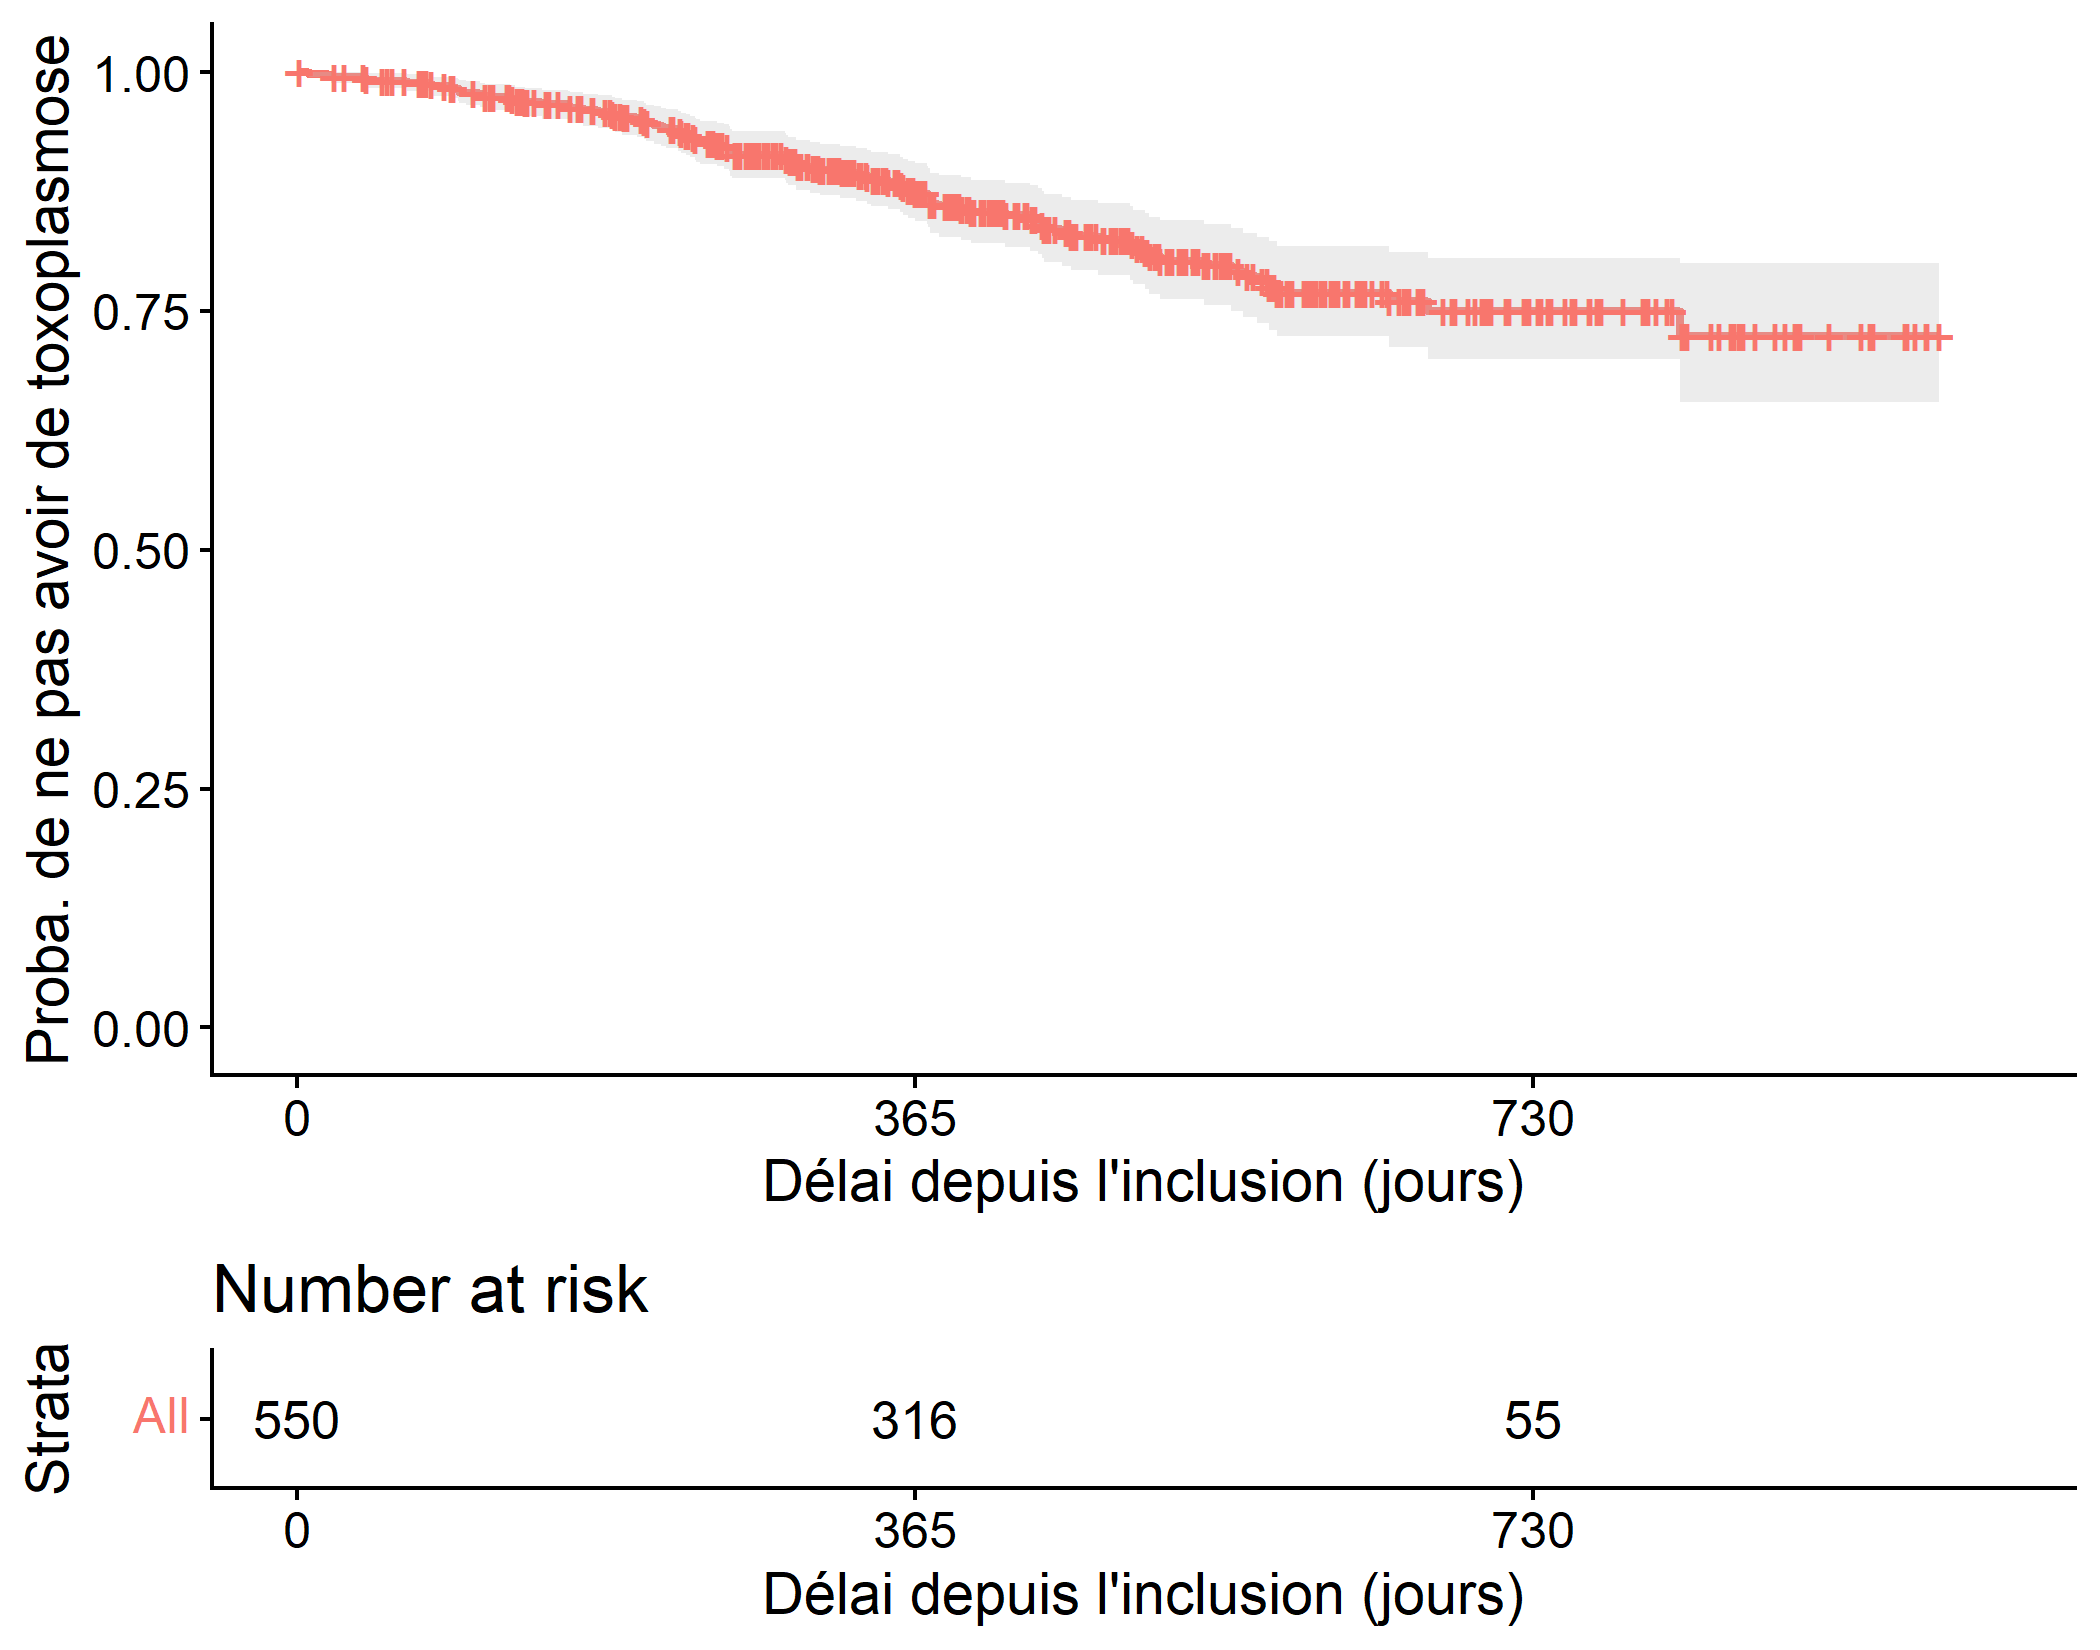
  365    316      60    0.874  0.0154        0.844        0.905
  730     55      28    0.750  0.0270        0.699        0.805
La médiane de survie est le premier temps auquel la survie estimée devient inférieure ou égale à 0,5. Elle n’est pas estimable si la courbe ne descend jamais jusque-là pendant le suivi. Ceci se traduit ici par des NA :
On peut ensuite visualiser la fonction de survie avec ggsurvplot(). Pour rappel, les “marches” descendent aux temps d’évènement, tandis que les petits traits verticaux repèrent les censures. L’option risk.table = TRUE ajoute les effectifs encore à risque sous la courbe.
Avec l’âge comme axe du temps
On procède de la même façon avec l’âge, mais en donnant à Surv() l’âge d’entrée et l’âge de sortie afin que l’effectif à risque soit correctement calculé :
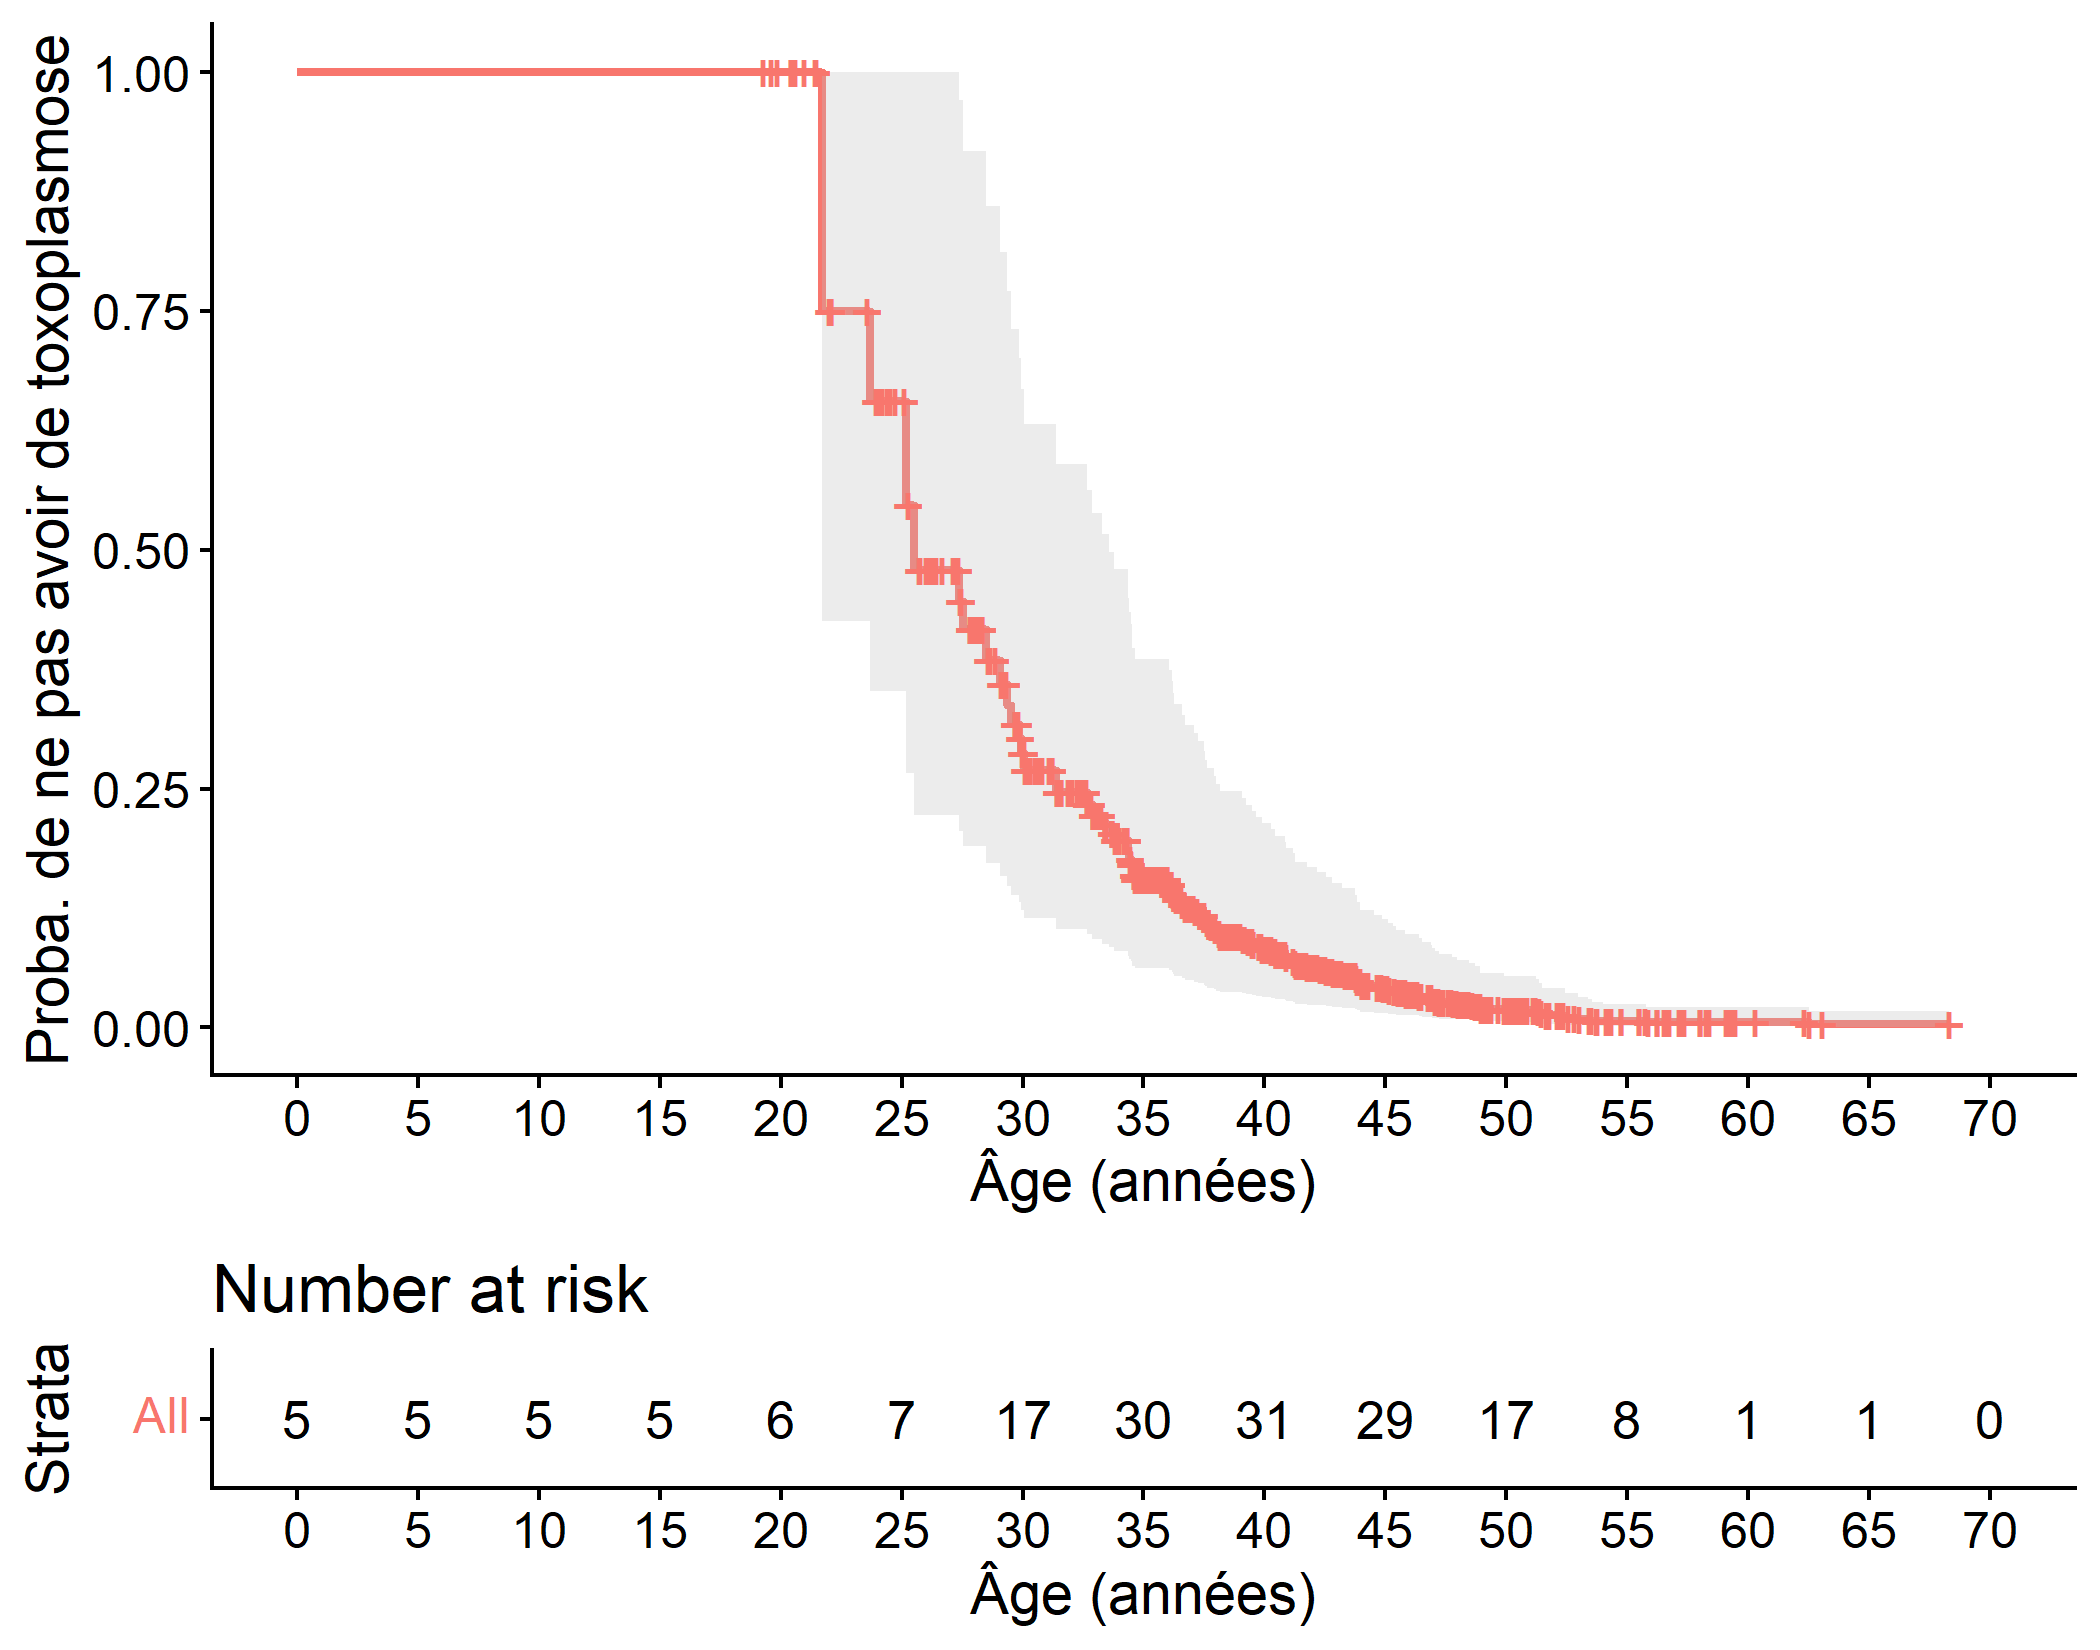
Changer l’axe du temps change l’interprétation, mais aussi les sujets présents dans l’effectif à risque à chaque instant. Les estimations et les conclusions peuvent donc être différentes.
Comparer des fonctions de survie
Pour estimer une fonction dans chaque groupe, on remplace le 1 précédent par la variable de groupe à droite de ~ (comme on faisait en régression). Ici, on compare le groupe placebo au groupe pyriméthamine :
km_traitement <- survfit(
    Surv(deltoxo, indtoxo) ~ traitement,
    data = toxo
)

ggsurvplot(
    km_traitement,
    data = toxo,
    conf.int = TRUE,
    censor = TRUE,
    risk.table = TRUE,
    pval = FALSE,
    xlab = "Délai depuis l'inclusion (jours)",
    ylab = "Proba. de ne pas avoir de toxoplasmose",
    legend.title = "Groupe",
    legend.labs = c("Placebo", "Pyriméthamine"),
    palette = c("#E69F00", "#0072B2")
)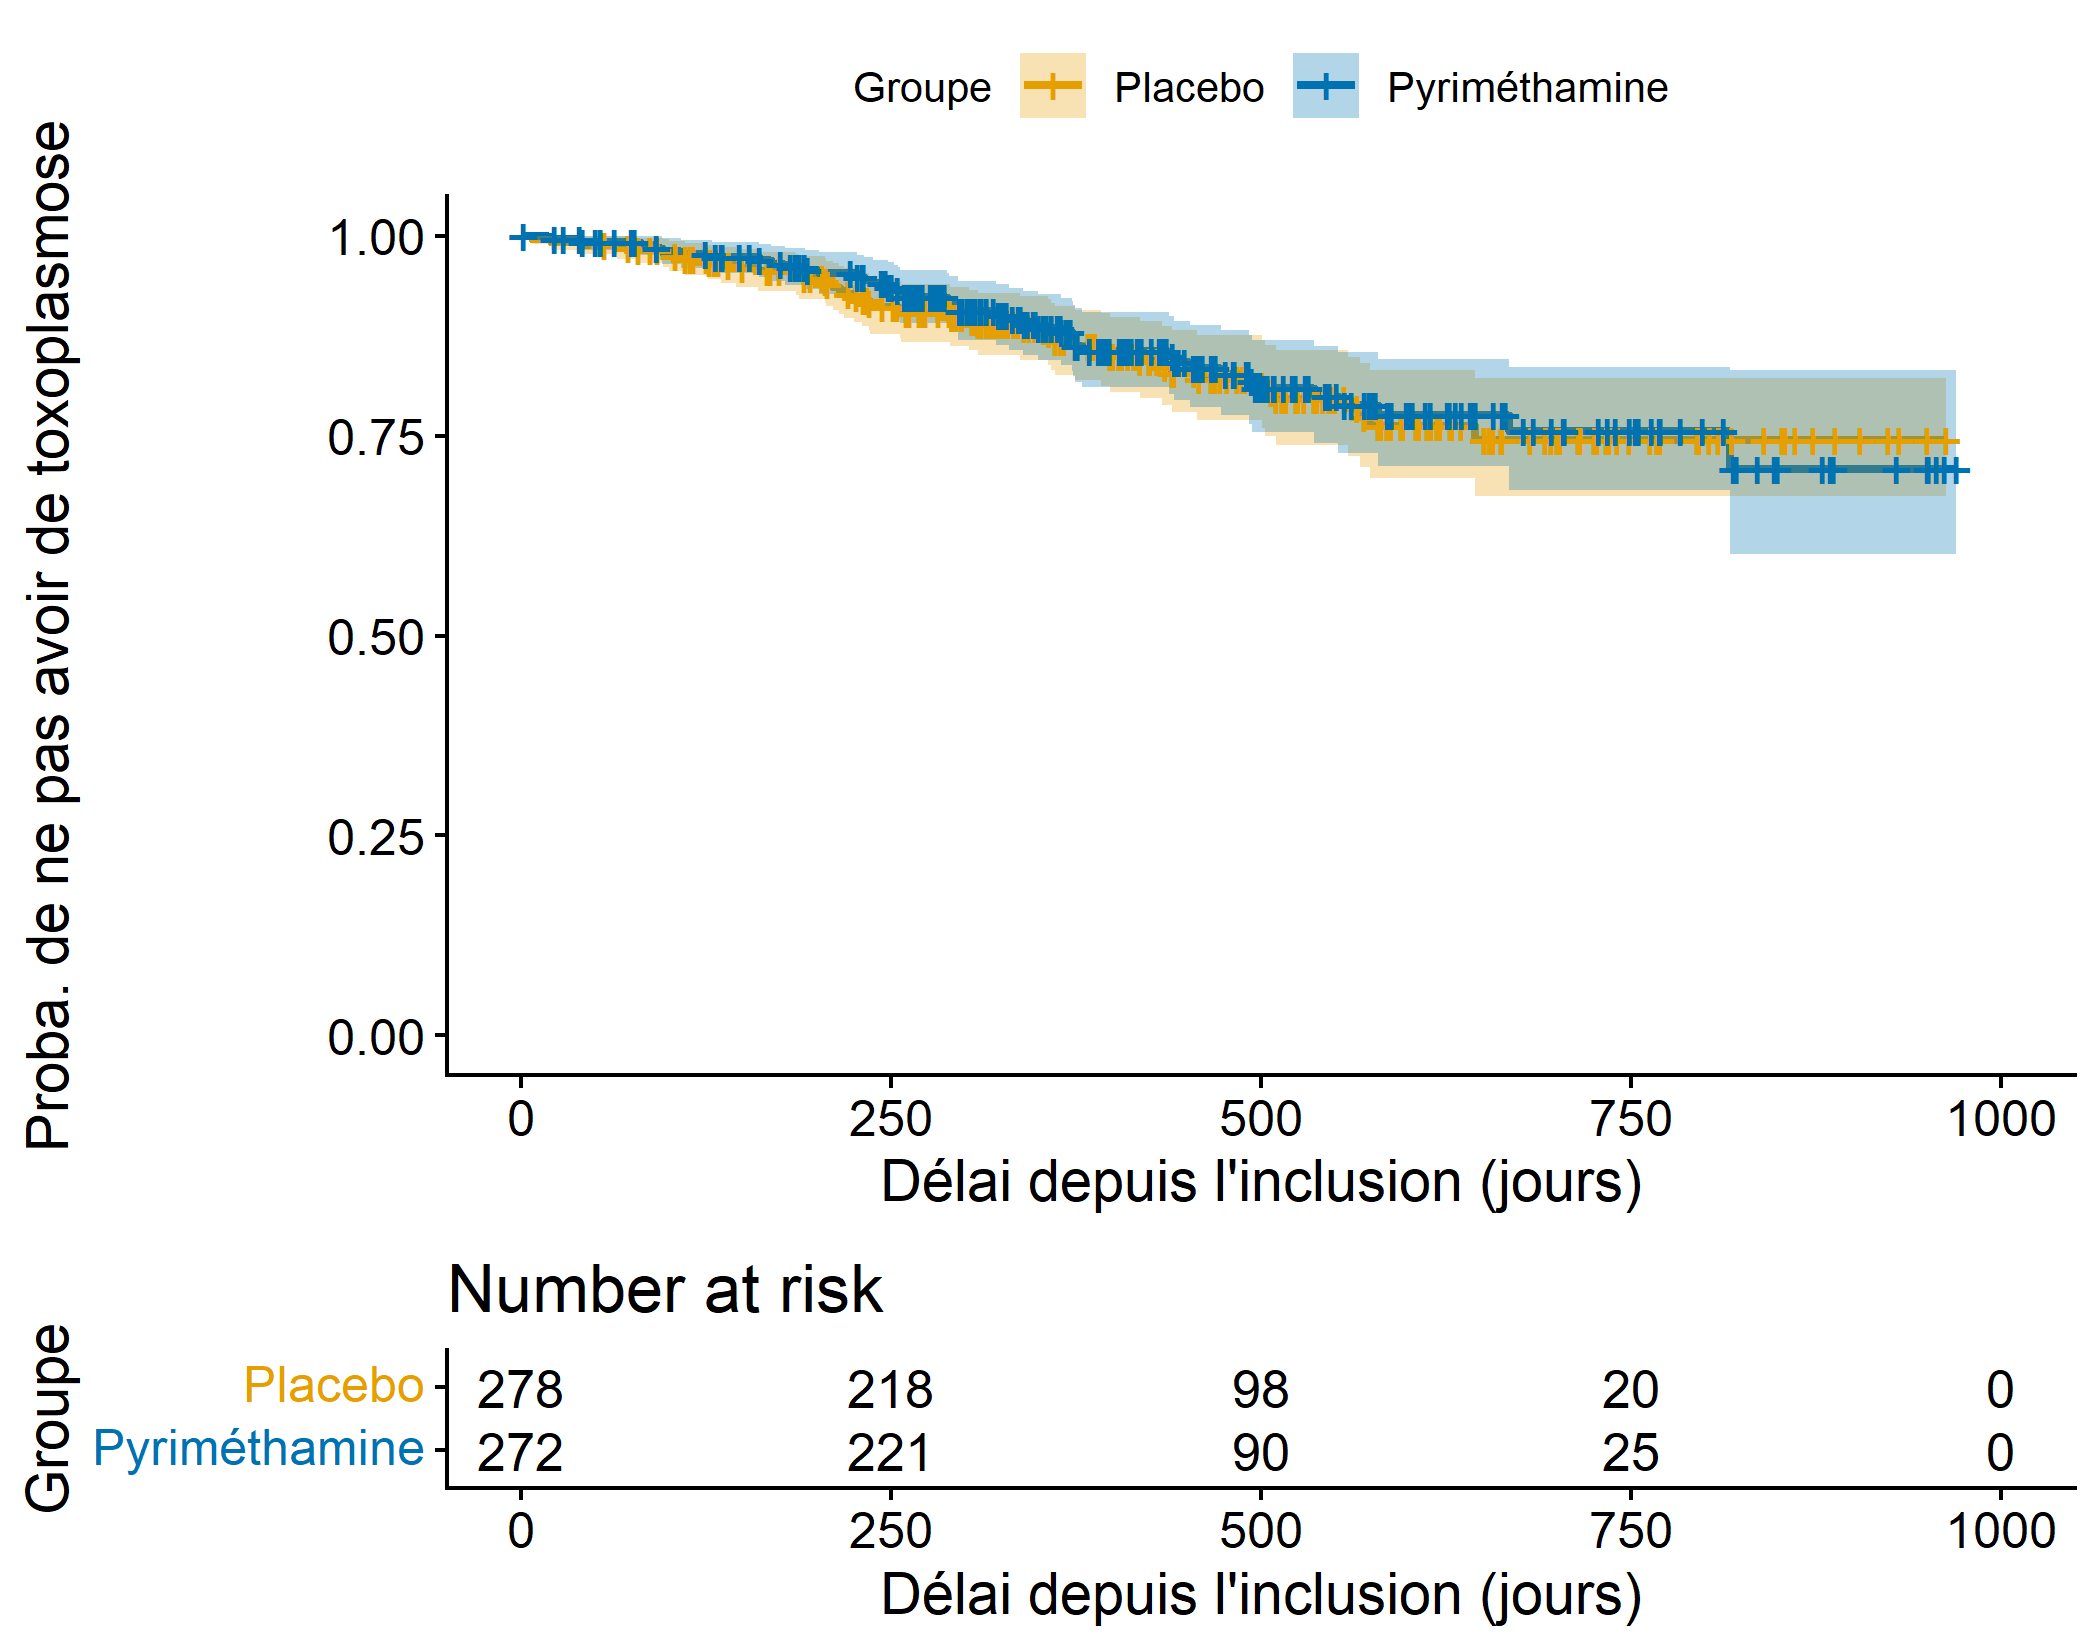
Ceci permet de voir l’évolution de la survie entre les groupes, ainsi que de voir si la médiane de survie est atteinte quelque part (ce qui n’est pas le cas ici).
Comparaison ponctuelle
Si un temps est pertinent d’un point de vue clinique, on peut comparer les deux fonctions de survie uniquement à ce temps. Ici, on choisit un an de suivi (\(t=365\) jours) pour comparer les deux groupes. On extrait toutes les informations nécessaires avec summary() :
| groupe | survie | erreur_standard |
|---|---|---|
| traitement=Placebo | 0.8680296 | 0.0220346 |
| traitement=Pyriméthamine | 0.8796806 | 0.0215583 |
Dans le cours, la statistique de test est donnée par la formule suivante : \[ X^2 = \frac{\left(\widehat S_1(t)-\widehat S_2(t)\right)^2}{\widehat\sigma_1^2+\widehat\sigma_2^2}, \] qui suit approximativement une loi du \(\chi^2\) à 1 degré de liberté sous l’hypothèse d’égalité des deux survies au temps choisi. En R, voici ce que ça donne :
surv_1 <- survie_1_an$surv[1]
std_1 <- survie_1_an$std.err[1]
surv_2 <- survie_1_an$surv[2]
std_2 <- survie_1_an$std.err[2]
X2_1_an <- (surv_1 - surv_2)^2 / (std_1^2 + std_2^2)

p_1_an <- pchisq(X2_1_an, df = 1, lower.tail = FALSE)

data.frame(
    statistique_X2 = unname(X2_1_an),
    ddl = 1,
    p_valeur = unname(p_1_an)
)| statistique_X2 | ddl | p_valeur |
|---|---|---|
| 0.1428474 | 1 | 0.7054666 |
Finalement, \(p>0,05\), on ne peut pas conclure à une différence de survie entre les deux groupes au bout d’un an. Notez que choisir un autre temps aurait pu mener à une autre conclusion.
Comparaison globale : test du log-rank
Le test du log-rank compare les nombres d’évènements observés et attendus dans les groupes à l’ensemble des temps d’évènement. Il teste l’égalité des fonctions de survie sur toute la période de suivi. On le réalise avec la fonction survival::survdiff.
Call:
survdiff(formula = Surv(deltoxo, indtoxo) ~ traitement, data = toxo)

                           N Observed Expected (O-E)^2/E (O-E)^2/V
traitement=Placebo       278       46     44.6    0.0461    0.0924
traitement=Pyriméthamine 272       43     44.4    0.0462    0.0924

 Chisq= 0.1  on 1 degrees of freedom, p= 0.8
On peut extraire directement la statistique de test et la p-valeur :
| statistique_X2 | ddl | p_valeur |
|---|---|---|
| 0.0923845 | 1 | 0.7611674 |
Comme \(p>0,05\), alors on ne peut pas non plus conclure à une différence de survie entre les deux groupes sur l’ensemble du suivi. Notez que, lorsque les courbes se croisent, des différences en sens opposés peuvent toutefois se compenser. Par exemple, le groupe placébo peut avoir une moins bonne survie que le groupe traitement jusqu’à un certain temps, puis une meilleure survie par la suite. Le test du log-rank ne permet pas de détecter ce type de situation : une analyse graphique est donc toujours nécessaire !