3 Interpréter un modèle logistique
On part du modèle de régression linéaire simple, une seule variable explicative \(X\) : \[ \operatorname{logit}(p(x)) =\log\left(\frac{p(x)}{1-p(x)}\right) =\beta_0+\beta_1x \]
D’une part, on peut obtenir des probabilités. En posant \(\eta(x)=\beta_0+\beta_1x\), on peut en tirer la probabilité d’avoir l’événement pour un individu \(X=x\) : \[ p(x)=\frac{\exp(\eta(x))}{1+\exp(\eta(x))} =\frac{\exp(\beta_0+\beta_1x)}{1+\exp(\beta_0+\beta_1x)} \]
Cette écriture garantit que \(0<p(x)<1\), quelle que soit la valeur de \(\beta_0+\beta_1x\) ! Mais si vous avez lu (et compris) la section précédente, vous devriez déjà le savoir :)
La probabilité d’avoir l’événement à partir de ce modèle,
pour les personnes \(X = 0\) (i.e., 0 pour une variable quantitative ou le groupe de référence pour la variable qualitative binaire), est de : \[ p(0) = \frac{\exp(\beta_0+\beta_1 \times 0)}{1+\exp(\beta_0+\beta_1\times 0)} = \frac{\exp(\beta_0)}{1+\exp(\beta_0)} \]
Si \(X\) est qualitative binaire, on peut calculer la probabilité d’avoir l’événement dans le groupe d’intérêt par : \[ p(1) = \frac{\exp(\beta_0+\beta_1)}{1+\exp(\beta_0+\beta_1)} \]
Si \(X\) est une variable quantitative, on peut calculer la probabilité d’avoir l’événement pour une valeur \(X = x\) en utilisant directement : \[ p(x) = \frac{\exp(\beta_0+\beta_1x)}{1+\exp(\beta_0+\beta_1x)} \]
D’autre part, on peut interpréter les coefficients de régression. Suivant la nature de \(X\), l’interprétation de \(\beta_1\) diffère légèrement.
3.1 Variable explicative binaire
Si \(X\) est binaire et codée 0/1 : \[ \operatorname{logit}(p(x))=\beta_0+\beta_1x. \]
Alors
- \(\exp(\beta_0)\) est la cote de l’événement dans le groupe \(X=0\) ;
- \(\exp(\beta_0+\beta_1)\) est la cote dans le groupe \(X=1\) ;
- \(\beta_1\) est donc la différence de log-odds entre les deux groupes, telle que \(\exp(\beta_1)\) correspond à l’OR entre le groupe \(X=1\) par rapport au groupe \(X=0\).
3.2 Variable explicative quantitative
Si \(X\) est quantitative, \(\exp(\beta_1)\) est l’OR associé à une augmentation d’une unité de \(X\). En effet, comme \[ \operatorname{odds}(x) = \frac{p(x)}{1-p(x)}=\exp(\beta_0+\beta_1x), \] alors : \[ \frac{\operatorname{odds}(x+1)}{\operatorname{odds}(x)} =\frac{\exp(\beta_0+\beta_1(x+1))}{\exp(\beta_0+\beta_1x)} =\exp(\beta_1) \]
Plus généralement, pour une augmentation de \(a\) unités : \[ OR(a)=\exp(a\beta_1) \]
L’OR par X années (p. ex., 10 ans) est souvent plus lisible que l’OR par 1 an si l’effet annuel est très proche de 1.
Note
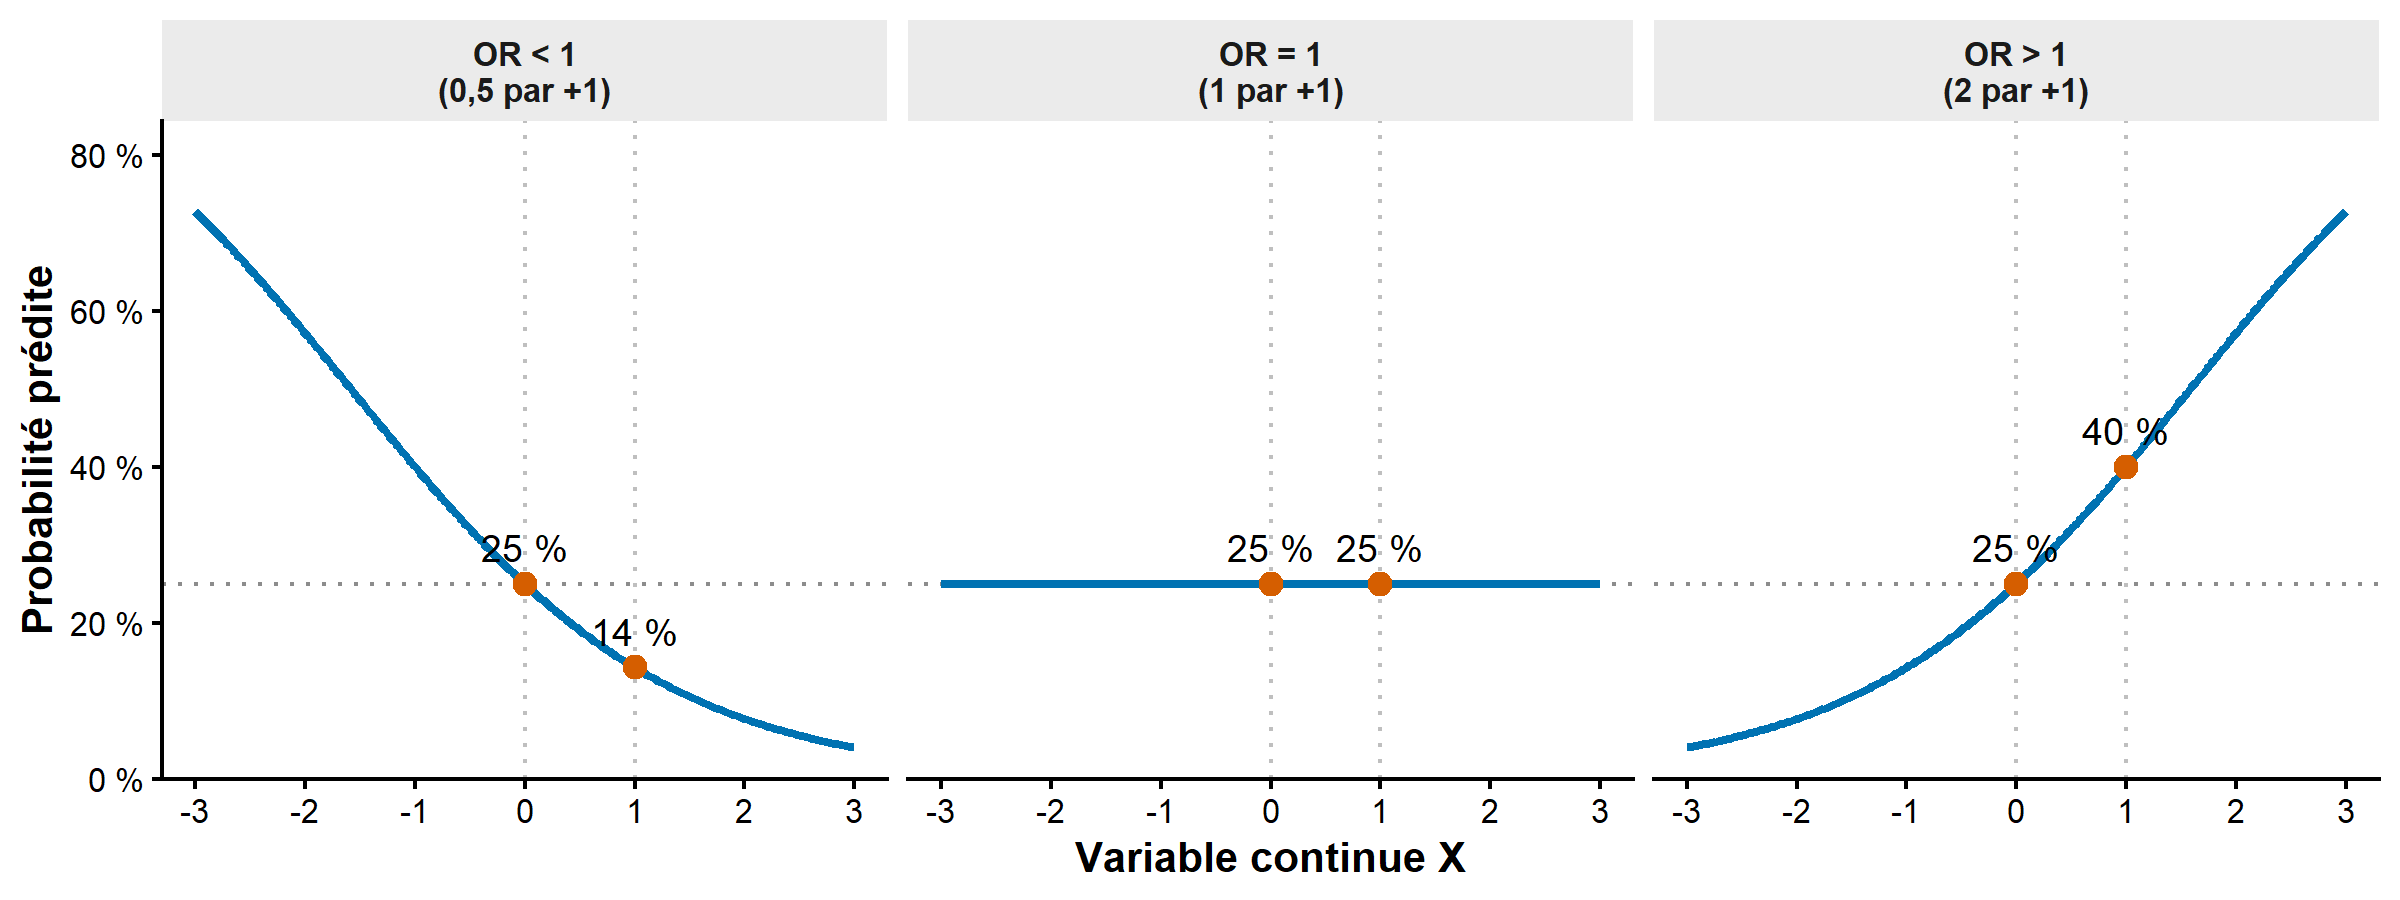
Comme nous aimons les graphiques, montrons brièvement l’effet de l’OR sur la probabilité prédite, quand on étudie l’association entre une variable continue et un événement binaire. En Figure 1, on montre les probabilités prédites par trois modèles logistiques simples avec une variable \(X\) continue. Dans chaque cas, la probabilité prédite vaut 25 % pour \(X=0\). On change seulement \(\beta_1\), donc l’OR \(\exp(\beta_1)\) associé à une augmentation d’une unité de \(X\).
Quand \(OR > 1\), la probabilité d’événement augmente avec \(X\) ; quand \(OR < 1\), la probabilité d’événement diminue avec \(X\) ; et quand \(OR = 1\), la probabilité d’événement ne change pas avec \(X\).
3.3 Interpréter l’intercept
Dans une régression logistique, l’intercept \(\beta_0\) est le log-odds de l’événement lorsque toutes les variables explicatives valent 0.
La probabilité correspondante est : \[ p_0=\frac{\exp(\beta_0)}{1+\exp(\beta_0)} \]
Comme en régression linéaire, l’intercept est souvent peu intéressant si la situation \(X_1=\cdots=X_p=0\) n’a pas de sens clinique. Centrer les variables quantitatives peut rendre l’intercept plus interprétable. Récapitulons le tout à l’aide d’un exemple :
Important
Quand on étudie l’association entre une variable binaire et un événement, la régression logistique simple estime le même OR que l’OR brut présenté précédemment !
Pour un public non statisticien (et même pour nous), il est souvent utile de compléter les OR par des probabilités prédites dans quelques profils cliniquement pertinents.
3.4 Régression logistique multiple
Il s’agit de la même chose qu’avant, mais avec plusieurs variables explicatives …
Le modèle de régression logistique s’écrit : \[ \operatorname{logit}(p(x_1,\ldots,x_p)) =\beta_0+\beta_1x_1+\cdots+\beta_px_p, \] et la probabilité correspondante est : \[ p(x_1,\ldots,x_p)=\frac{\exp(\beta_0+\beta_1x_1+\cdots+\beta_px_p)}{1+\exp(\beta_0+\beta_1x_1+\cdots+\beta_px_p)} \]
Dans un modèle multiple, \(\exp(\beta_j)\) est un odds ratio ajusté sur les autres variables du modèle. Pour une variable quantitative, il compare deux profils différant d’une unité sur \(X_j\) ; pour une variable qualitative, il compare la modalité concernée à la modalité de référence ; à chaque fois toutes choses égales par ailleurs.
Quand on a un IC large - comme pour l’hypertension - c’est souvent le signe que l’on dispose de peu d’événements dans certaines catégories. Les estimations deviennent alors “instables”, avec de grandes erreurs standards et/ou des OR très éloignés de 1.
Avertissement
Tout comme avec un OR brut, l’OR ajusté n’est pas un risque relatif ajusté. Ainsi (pour une variable catégorielle binaire \(X\)), si \(OR = 2\), on ne peut pas conclure que le risque d’événement est deux fois plus grand pour \(X = 1\) que pour \(X = 0\).