6 Adéquation aux hypothèses d’application du modèle de Cox
Obtenir des résultats à partir d’un modèle de Cox (un coefficient \(\hat{\beta}\), un intervalle de confiance, une p-valeur) ne garantit pas que ces résultats soient fiables. Le logiciel peut fournir des estimations même si le modèle est inadapté aux données. Or, l’interprétation de ces estimations repose sur plusieurs hypothèses, dont les plus importantes sont :
- la proportionnalité des risques ;
- la log-linéarité de la relation entre la fonction de risque et une variable quantitative ;
- la censure non informative ;
- l’indépendance des observations, ou une prise en compte adaptée de leur dépendance.
Si l’une de ces hypothèses n’est pas respectée, les estimations peuvent être biaisées ou mal interprétées. Il faut donc évaluer les hypothèses du modèle, discuter celles qui ne sont pas vérifiables à partir des seules données et contrôler la façon dont les temps sont recueillis. Les observations corrélées, par exemple au sein de familles, nécessitent des méthodes adaptées ; nous supposons ici des sujets indépendants.
6.1 Hypothèse de proportionnalité des risques
Nous l’avons vu lors de la présentation du modèle de Cox, le rapport des fonctions de risque de deux sujets ne dépend pas du temps. Cette hypothèse se vérifie variable par variable. Pour une variable explicative \(X_k\), on suppose que les fonctions de risque associées à ses différentes modalités (ou valeurs) sont proportionnelles, et que leur rapport, \(\exp(\beta_k)\), reste le même à tout instant du suivi, les autres variables étant fixées. Autrement dit, le coefficient \(\beta_k\) ne dépend pas du temps.
Pour illustrer les méthodes de vérification, nous utiliserons dans cette section une cohorte fictive simulée de 1000 sujets avec 500 sujets non exposés (X = 0) et 500 sujets exposés (X = 1), suivis 24 mois. Afin d’explorer de nombreux exemples et cas d’application, les données de cette cohorte fictive ont été simulées selon trois scénarios :
- hypothèse des risques proportionnels respectée. Le RR est constant tout au long du suivi.
- modification quantitative du RR qui diminue au cours des 12 premiers mois, puis reste constant ensuite (vrai pour la valeur réelle du RR simulé). Cependant l’exposition augmente toujours le risque, seulement de moins en moins.
- modification qualitative du RR qui diminue au cours des 12 premiers mois, puis reste constant ensuite (vrai pour la valeur réelle du RR simulé). L’exposition augmente le risque en début de suivi, puis devient protectrice.
6.1.1 Évaluation graphique par les courbes \(\ln(-\ln(S(t)))\)
Considérons une variable qualitative à deux modalités, par exemple l’exposition. Notons \(\alpha_1(t)\) et \(S_1(t)\) les fonctions de risque et de survie des non exposés, \(\alpha_2(t)\) et \(S_2(t)\) celles des exposés. L’hypothèse de proportionnalité des risques s’écrit : \[ \alpha_2(t) = \exp(\beta)\,\alpha_1(t). \]
En intégrant les deux membres entre \(0\) et \(t\), on obtient \(\int_0^t \alpha_2(u)\,\mathrm{d}u = \exp(\beta)\int_0^t \alpha_1(u)\,\mathrm{d}u\). Or, d’après la relation \(S(t) = \exp\left(-\int_0^t \alpha(u)\,\mathrm{d}u\right)\), on a \(-\ln(S(t)) = \int_0^t \alpha(u)\,\mathrm{d}u\). Donc : \[ -\ln(S_2(t)) = \exp(\beta)\times\bigl(-\ln(S_1(t))\bigr), \quad \text{soit} \quad S_2(t) = S_1(t)^{\exp(\beta)}. \]
Comme \(-\ln(S(t))\) est strictement positif et fini lorsque \(0<S(t)<1\), on peut prendre une seconde fois le logarithme : \[ \ln\bigl(-\ln(S_2(t))\bigr) = \ln\bigl(-\ln(S_1(t))\bigr) + \beta. \]
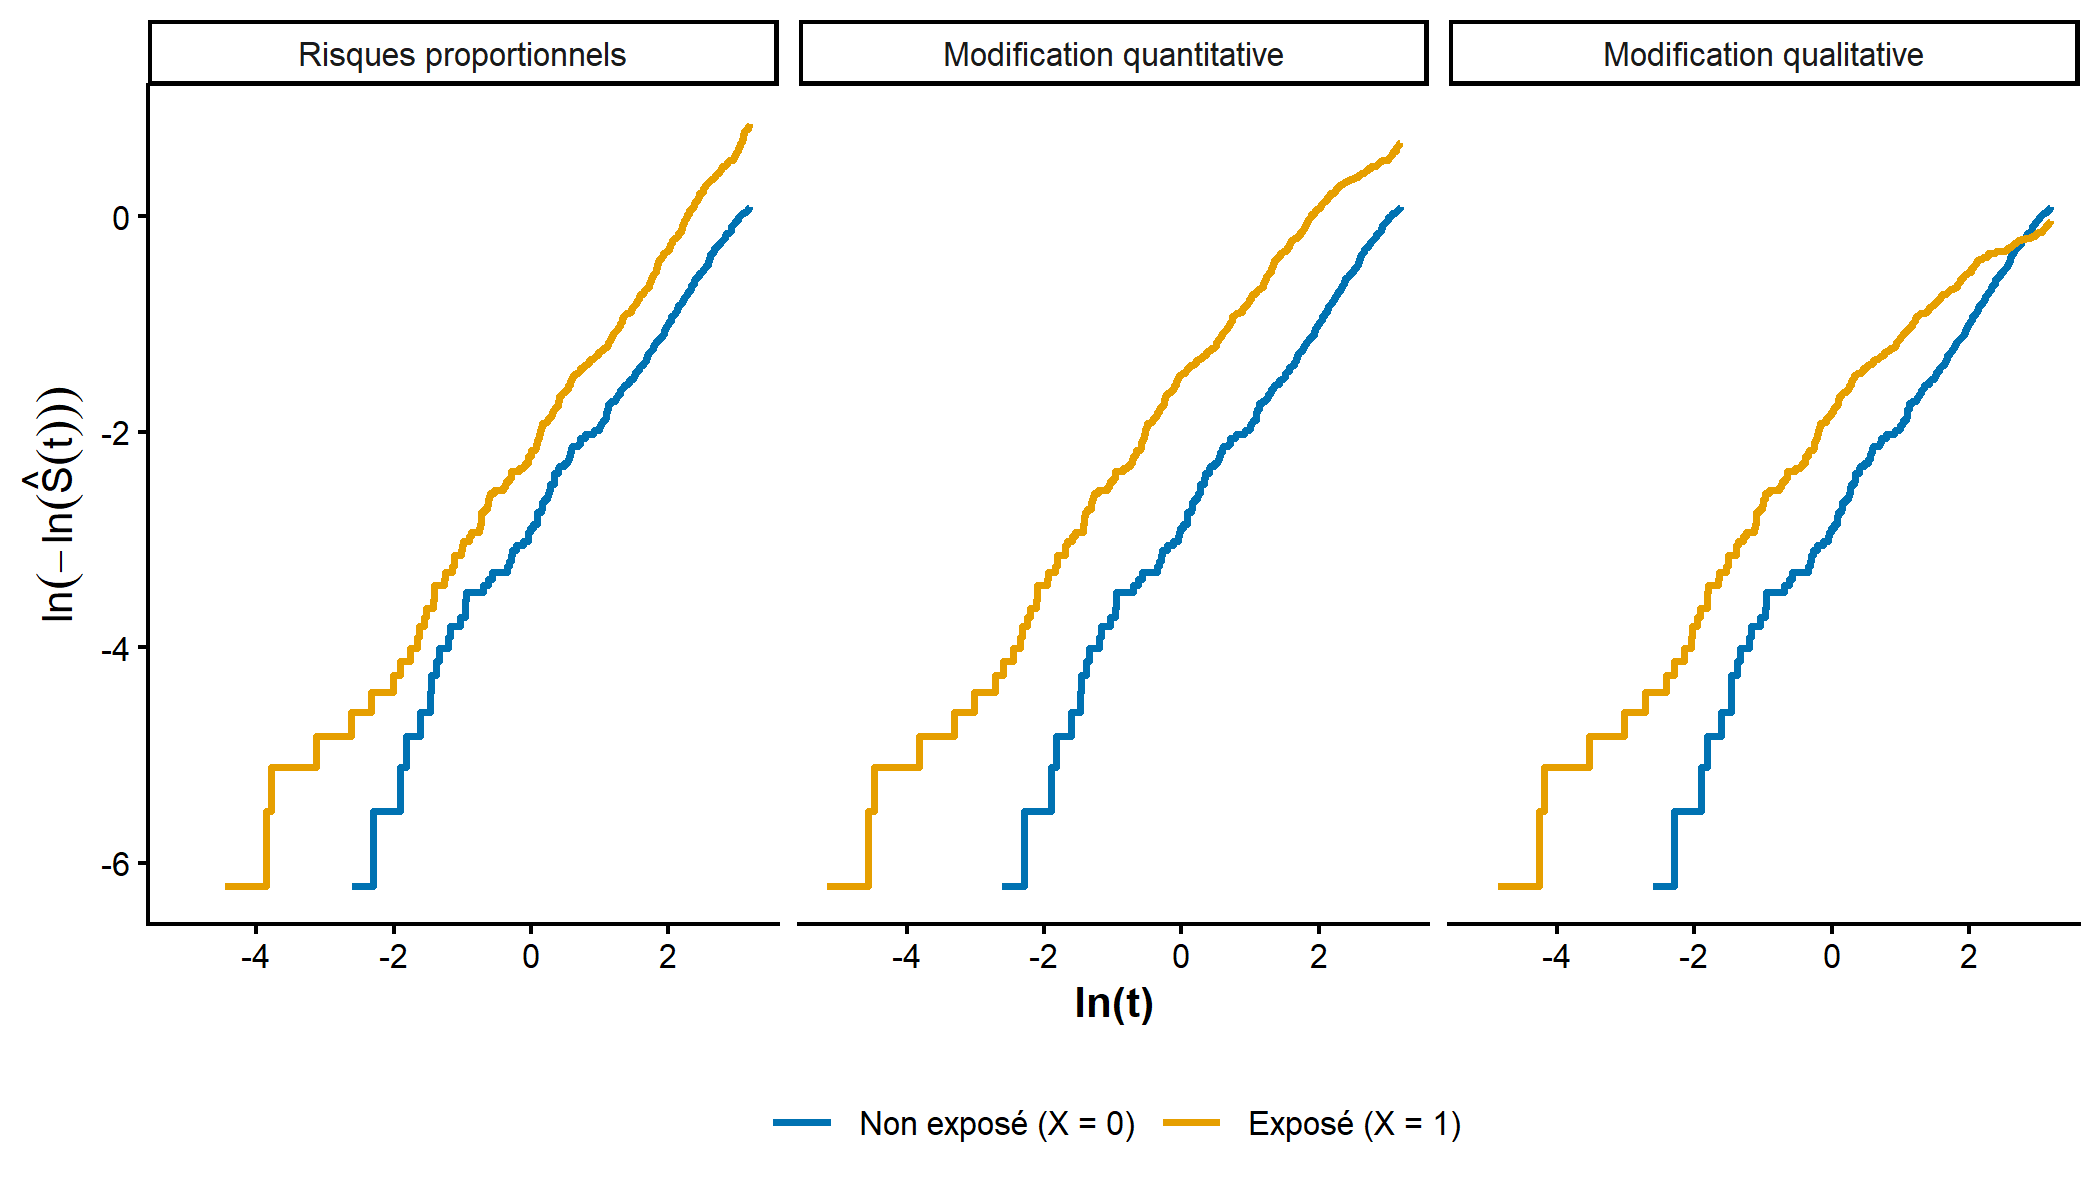
Sous l’hypothèse de proportionnalité des risques, les courbes \(\ln(-\ln(S(t)))\) des deux groupes sont donc parallèles, séparées par un écart vertical constant égal à \(\beta\). En pratique, on remplace \(S(t)\) par son estimation de Kaplan-Meier \(\hat S(t)\) dans chaque groupe, on trace les courbes \(\ln(-\ln(\hat S(t)))\) conjointement, et on regarde si leur écart reste à peu près constant (et proche de \(\hat\beta\)). On les trace souvent en fonction de \(\ln(t)\) plutôt que de \(t\), ce qui étale les premiers temps du suivi. Comme l’écart est vertical, ce choix ne change pas le critère. Des courbes qui se rapprochent, s’éloignent ou se croisent suggèrent un non-respect de l’hypothèse.
La Figure 1 montre ces courbes pour nos trois scénarios. À l’œil, les scénarios à risques proportionnels et de modification quantitative sont presque impossibles à distinguer. Dans les deux cas, les courbes paraissent parallèles. Seul le scénario de modification qualitative montre des courbes qui se rapprochent puis se croisent en fin de suivi et dont l’hypothèse de proportionnalité des risques n’est très probablement pas respectée.
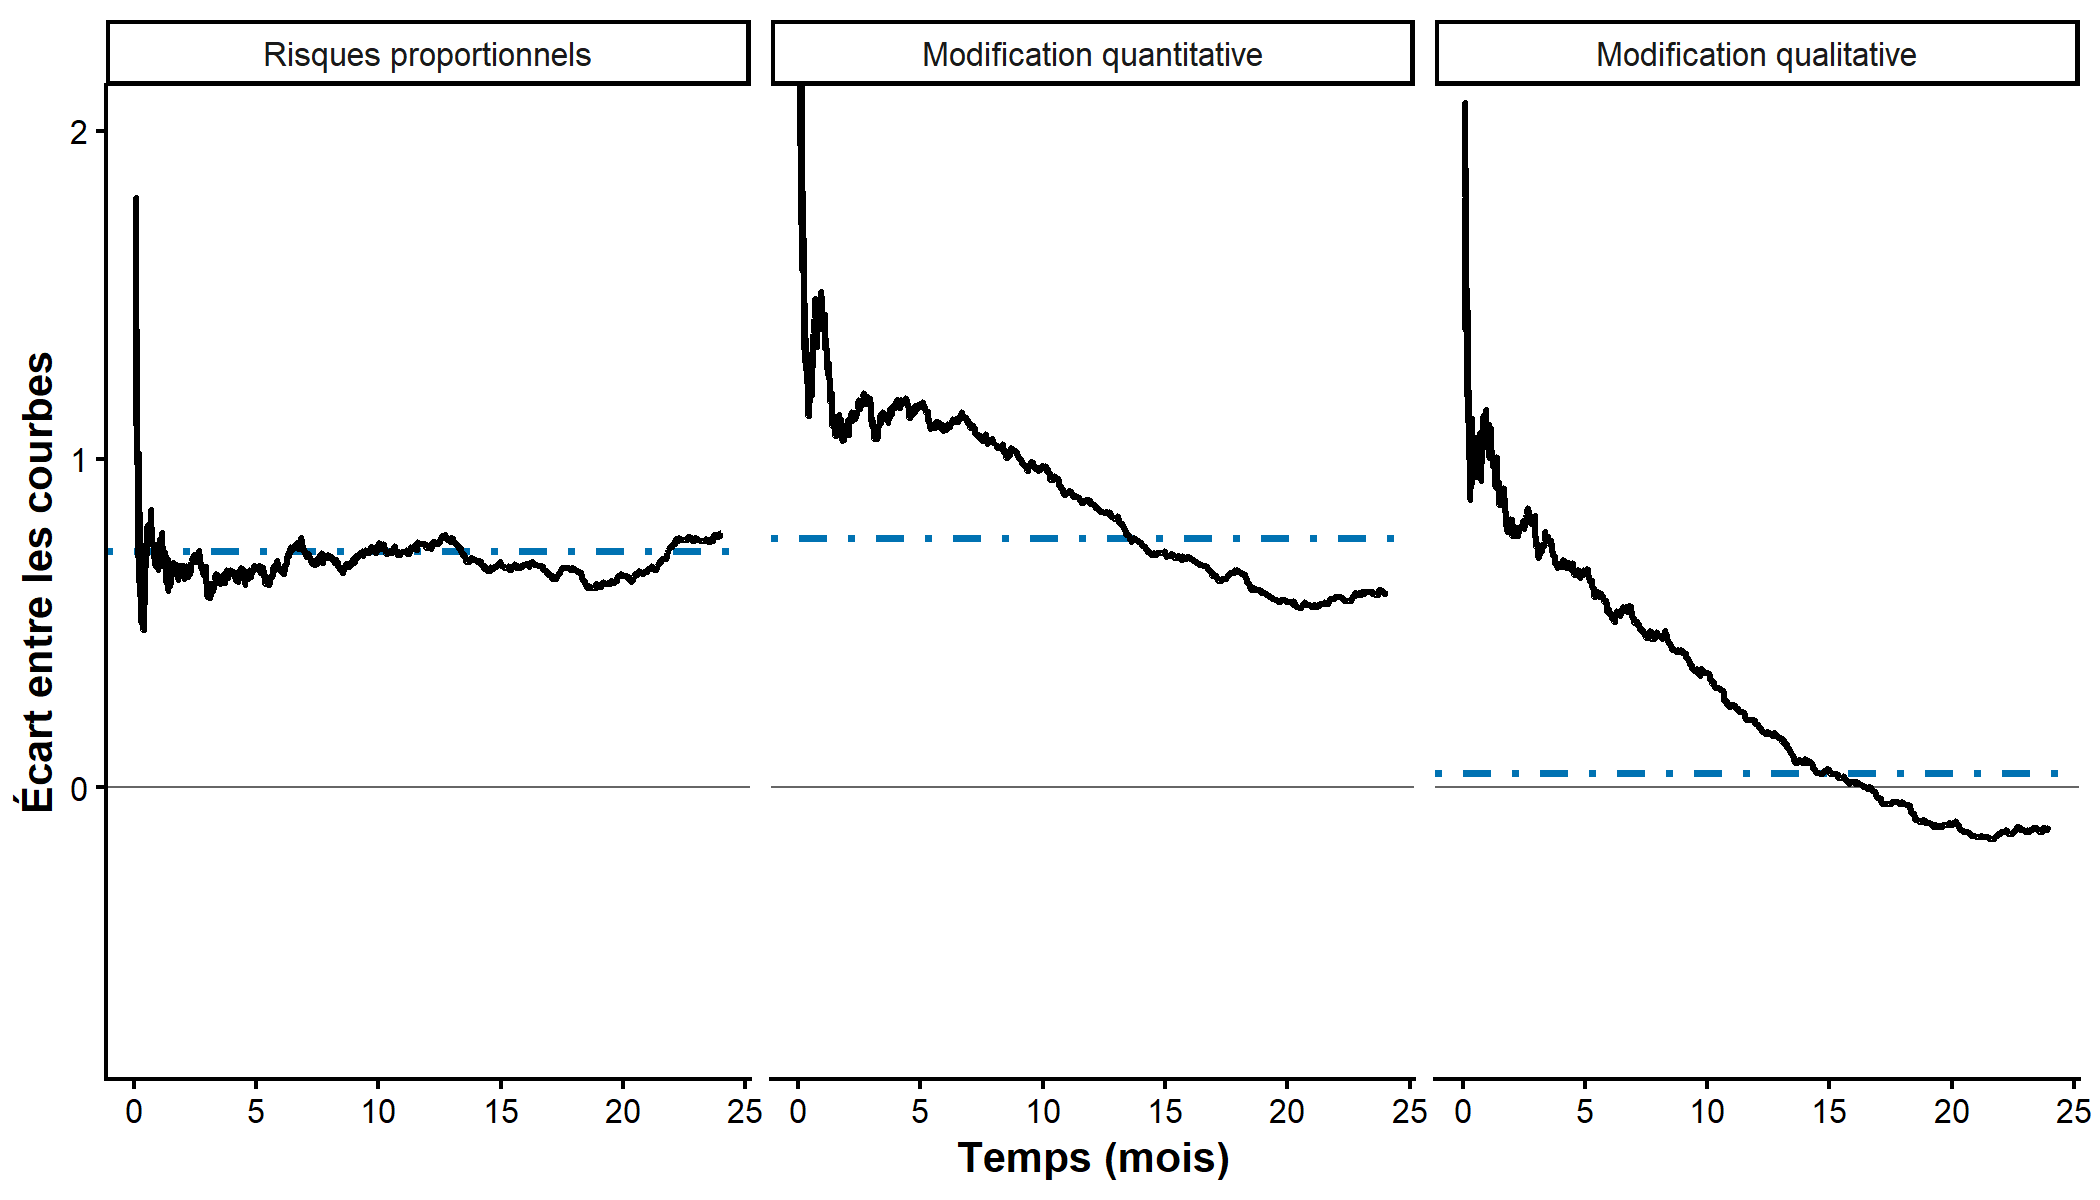
Pour faciliter la lecture, on peut tracer directement l’écart entre les deux courbes en fonction du temps (Figure 2), et le comparer à \(\hat\beta\). Dans le scénario à risques proportionnels, l’écart reste stable autour de \(\hat\beta\). Dans le scénario de modification quantitative, il diminue régulièrement tout en restant positif. Dans le scénario de modification qualitative, il diminue jusqu’à devenir négatif vers 16 mois. Les irrégularités des tout premiers temps, où très peu d’évènements sont observés, ne doivent pas être surinterprétées.
L’incapacité à distinguer visuellement une diminution ou une augmentation de l’écart entre les courbes \(\ln(-\ln(\hat S(t)))\) de chaque groupe, rend cette méthode de validation graphique subjective. En plus d’estimer les fonctions de survie par Kaplan-Meier groupe par groupe, cette méthode ne permet pas de prendre en compte les variables d’ajustement car on trace ces courbes pour une seule variable (ici la variable exposition). Enfin, pour une variable quantitative, il est nécessaire de discrétiser la variable (par exemple selon ses terciles ou ses quartiles, en s’assurant d’un nombre suffisant d’évènements par classe) puis vérifier que les courbes des différentes classes sont parallèles. On perd alors de l’information, et la conclusion peut dépendre des bornes choisies. La validation graphique par \(\ln(-\ln(\hat S(t)))\) est simple à mettre en place, mais dans les faits on privilégiera les méthodes basées sur les résidus pour conclure sur le respect de l’hypothèse de proportionnalité des risques
6.1.2 Évaluation par les résidus de Schoenfeld
David Schoenfeld a proposé ces résidus en 1982 pour examiner le modèle de Cox (Schoenfeld 1982). Patricia Grambsch et Terry Therneau ont ensuite développé des diagnostics et des tests fondés sur des résidus pondérés (Grambsch et Therneau 1994).
La quantité \(\bar X_k(t_i)\) est la moyenne de \(X_k\) parmi les sujets à risque en \(t_i\), chaque sujet étant pondéré par son risque estimé par le modèle. C’est la valeur de \(X_k\) que le modèle “attend” pour le sujet qui présente l’évènement en \(t_i\). Le résidu compare donc la valeur observée chez ce sujet à la valeur attendue. Les résidus de Schoenfeld ne sont définis qu’aux temps d’évènement, ce qui signifie donc que les sujets censurés n’en ont pas.
Prenons l’exposition. \(\bar X(t_i)\) est alors la probabilité, estimée par le modèle, que l’évènement survenant en \(t_i\) concerne un sujet exposé. Si le modèle est correct, les résidus se répartissent autour de \(0\), quel que soit le moment du suivi. Si l’effet de l’exposition diminue au cours du temps, les évènements du début du suivi concernent plus souvent des exposés que ne le prévoit le modèle (résidus plutôt positifs), et ceux de la fin du suivi moins souvent (résidus plutôt négatifs). Sous un modèle correctement spécifié à risques proportionnels, leur moyenne ne doit pas présenter de tendance avec le temps. En pratique, on utilise des résidus mis à l’échelle \(r^*_{ik}\), souvent appelés résidus de Schoenfeld standardisés. Cette transformation utilise l’information sur les coefficients, et non une simple division de chaque résidu par son écart-type. Ils vérifient approximativement : \[ \mathbb{E}(r^*_{ik}) + \hat\beta_k \approx \beta_k(t_i). \]
En traçant \(\hat\beta_k + r^*_{ik}\) en fonction du temps et en lissant le nuage de points, on obtient donc une estimation de la courbe \(\beta_k(t)\) avec son intervalle de confiance. Sous l’hypothèse de proportionnalité des risques, cette courbe doit rester à peu près horizontale, au niveau de \(\boldsymbol{\hat\beta_k}\).
Cette absence de corrélation se teste. Pour une fonction du temps \(g(t)\) choisie, on teste :
- \(H_0 : \beta_k(t) = \beta_k\), pas de corrélation entre les résidus standardisés et \(g(t)\) (les risques sont proportionnels)
- \(H_1 : \beta_k(t)\) varie avec \(g(t)\)
Pour un seul coefficient, la statistique suit asymptotiquement sous \(H_0\) une loi du \(\chi^2\) à 1 degré de liberté. Un test conjoint pour une variable représentée par \(q\) coefficients a généralement \(q\) degrés de liberté ; le test global utilise le nombre total de coefficients testés. La fonction \(g(t)\) peut être le temps lui-même, son logarithme, le rang des temps d’évènement, ou d’autres formes du temps.
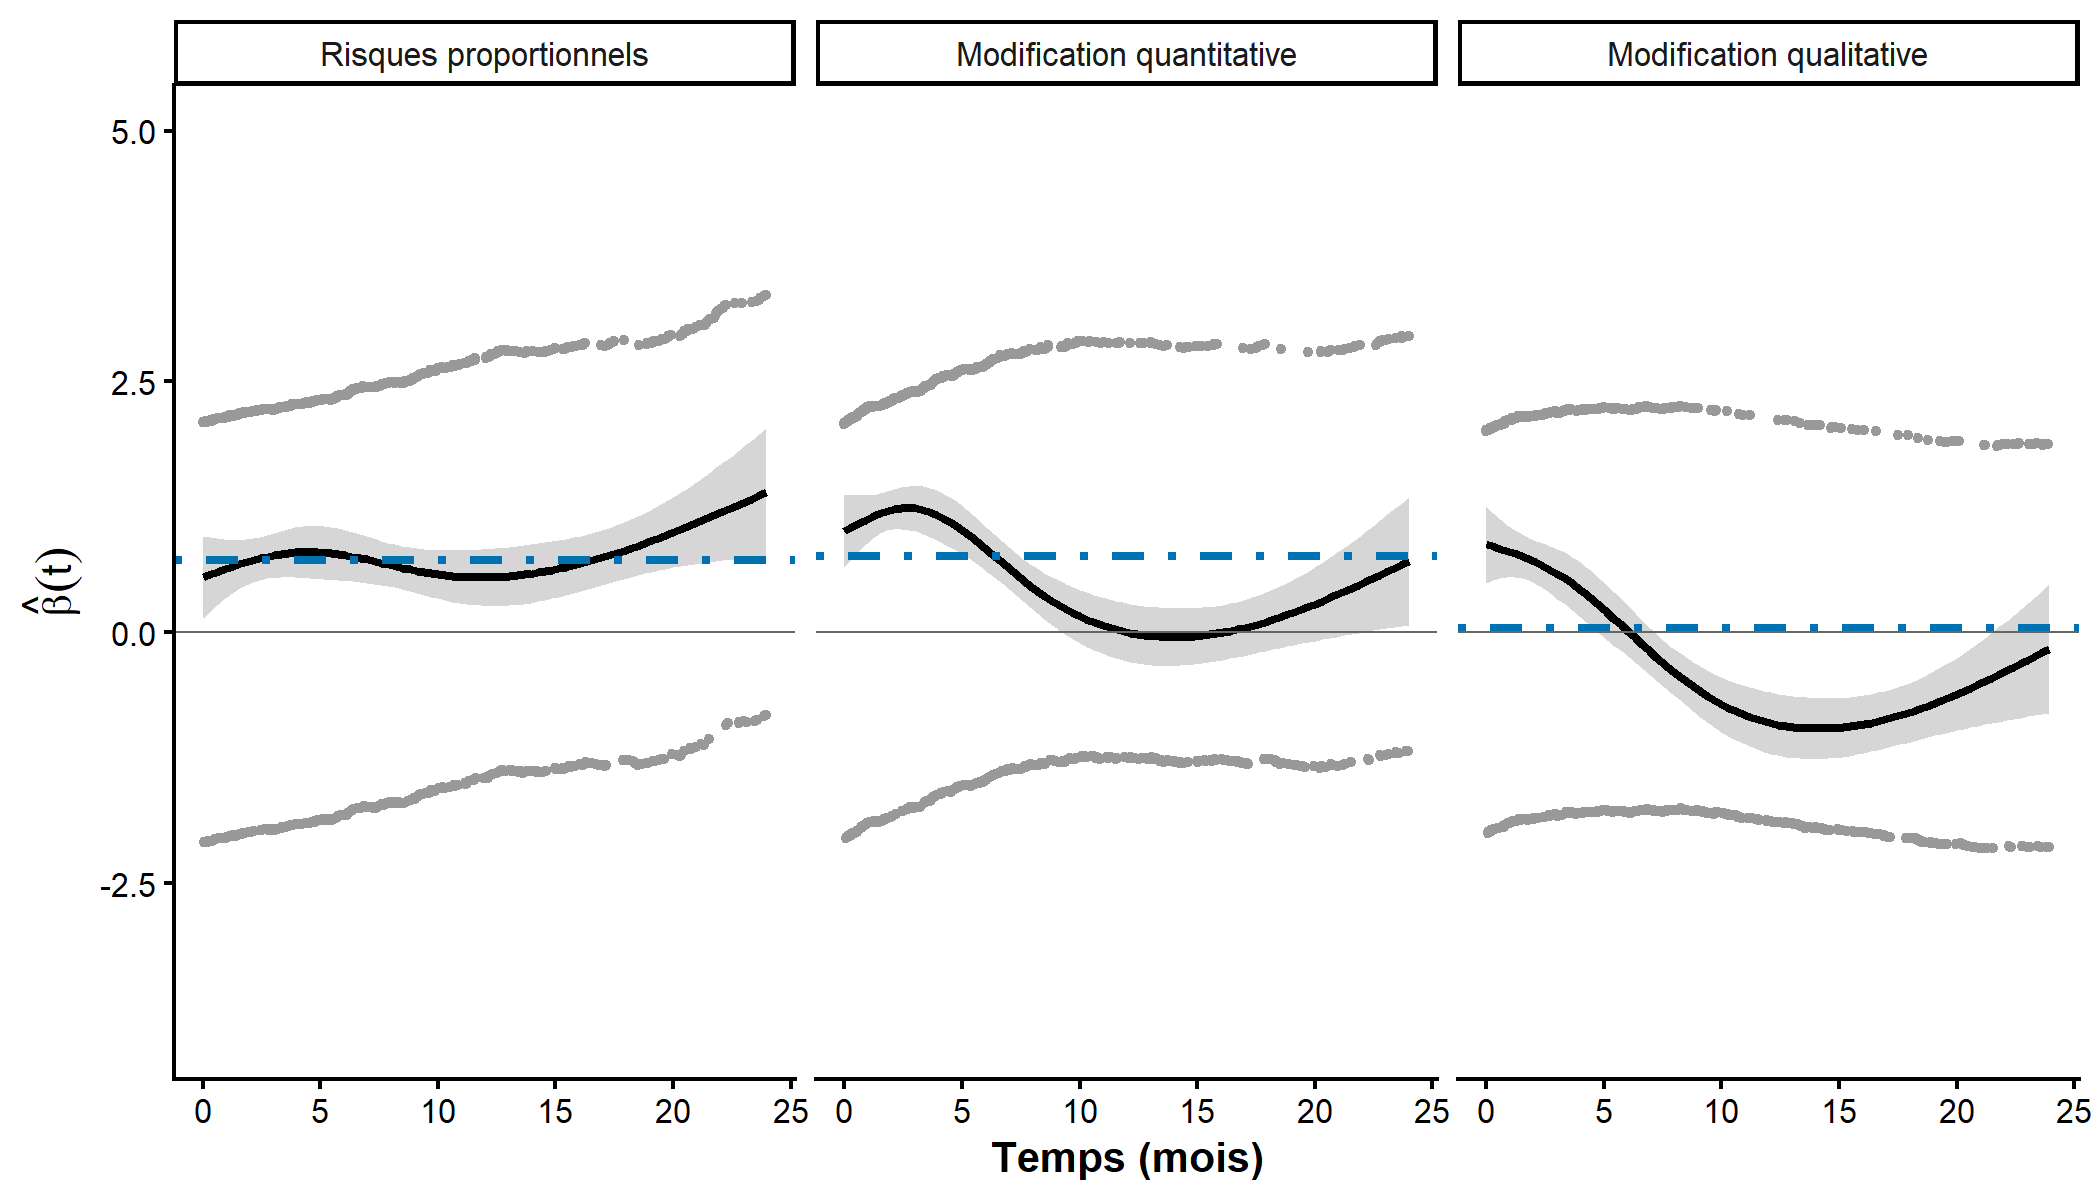
Sur la Figure 3, les résidus forment deux bandes. L’exposition étant binaire, les résidus des exposés sont positifs et ceux des non exposés négatifs. Ce ne sont pas ces bandes qu’il faut interpréter, mais la courbe lissée. Dans le scénario à risques proportionnels, elle reste proche de \(\hat\beta\). La légère remontée en fin de suivi, où moins de sujets restent à risque, s’accompagne d’un intervalle de confiance plus large qui contient toujours la droite horizontale. Dans les deux autres scénarios, elle décroît nettement. Dans le scénario de modification qualitative, elle passe sous \(0\) vers 6 mois, ce qui traduit l’inversion de l’effet.
| Scénario | Statistique (\(\chi^2\), 1 ddl) | \(p\) |
|---|---|---|
| Risques proportionnels | \(0{,}64\) | \(0{,}42\) |
| Modification quantitative | \(27{,}5\) | \(< 0{,}001\) |
| Modification qualitative | \(62{,}7\) | \(< 0{,}001\) |
Les tests complètent la lecture graphique. L’hypothèse de proportionnalité des risques est rejetée pour les deux scénarios où l’effet varie, mais pas pour le scénario à risques proportionnels.
6.1.3 Test d’interaction entre le temps et la variable explicative
Une autre solution pour tester l’hypothèse de proportionnalité des risques est d’intégrer dans le modèle, une interaction entre la variable et une fonction du temps puis de tester cette interaction. L’idée est ici de représenter explicitement une modification de l’effet au cours du temps. Deux approches existent selon que le temps est considéré de façon continue ou découpé en classes.
Interaction avec le temps continu. On ajoute au modèle le produit de la variable \(X\) et d’une fonction du temps \(g(t)\) : \[ \alpha(t) = \alpha_0(t)\exp\bigl(\beta X + \gamma\, X g(t)\bigr). \] Le RR comparant \(X=1\) à \(X=0\) devient alors une fonction du temps : \[ RR(t) = \exp\bigl(\beta + \gamma\, g(t)\bigr), \quad \text{soit} \quad \ln(RR(t)) = \beta + \gamma\, g(t). \]
Avec \(g(t) = t\) le logarithme du RR varie linéairement avec le temps. On parle d’interaction log-linéaire avec le temps. Concrètement, à chaque unité de temps supplémentaire, le RR est multiplié par \(\exp(\gamma)\). L’effet de \(X\) diminue au cours du suivi si \(\gamma < 0\) et augmente si \(\gamma > 0\). Avec \(g(t) = \ln(t)\), le logarithme du RR varie linéairement avec \(\ln(t)\).
Les hypothèses du test sont :
- \(H_0 : \gamma = 0\), l’effet de \(X\) ne varie pas selon \(g(t)\)
- \(H_1 : \gamma \neq 0\), l’effet de \(X\) varie selon \(g(t)\)
On utilise le test de Wald, \(X_W^2 = \hat\gamma^2 / \widehat{SE}^2(\hat\gamma)\), ou le test du rapport des vraisemblances partielles comparant les modèles avec et sans interaction. Sous \(H_0\), les deux statistiques suivent asymptotiquement une loi du \(\chi^2\) à 1 degré de liberté. Cette approche n’est adaptée qu’aux modifications de l’effet qui suivent la forme imposée par \(g(t)\). Si le RR diminue puis se stabilise, ou diminue puis ré-augmente, un terme linéaire le représente mal et peut ne pas détecter la modification.
Avertissement
Le terme \(X g(t)\) est une variable dépendante du temps, sa valeur change au cours du suivi pour un même sujet. Il ne faut surtout pas créer dans la base de données une colonne égale à \(X\) multiplié par le délai de suivi observé de chaque sujet. Cela reviendrait à utiliser, à chaque instant, une information qui n’est connue qu’à la fin du suivi du sujet, et les résultats seraient fortement biaisés. Sous R, on utilise l’argument tt de coxph() ou on découpe le suivi en intervalles avec survSplit().
Dans le scénario de modification quantitative, l’interaction avec \(g(t) = t\) donne \(\hat\gamma = -0{,}061\) (\(\widehat{SE} = 0{,}013\)), soit \(X_W^2 = 23{,}7\) et \(p < 0{,}001\). On rejette \(H_0\). Le RR estimé s’écrit \(\widehat{RR}(t) = \exp(1{,}194 - 0{,}061\,t)\) et vaut \(3{,}30\) à \(t=0\), \(1{,}58\) à 12 mois et \(0{,}76\) à 24 mois. Le test détecte la modification de l’effet. Dans le scénario à risques proportionnels, on obtient \(\hat\gamma = 0{,}012\) (\(\widehat{SE} = 0{,}011\)), soit \(X_W^2 = 1{,}19\) et \(p = 0{,}28\), on ne rejette pas \(H_0\).
Interaction avec le temps en classes. On découpe le suivi en \(K\) périodes \(I_1, \dots, I_K\) à l’aide de temps de coupure \(\tau_1 < \dots < \tau_{K-1}\), et on remplace \(X\) par \(K\) variables \(X \times \mathbf{1}(t \in I_k)\), où \(\mathbf{1}(t \in I_k)\) vaut \(1\) si \(t\) appartient à la période \(I_k\) et \(0\) sinon : \[ \alpha(t) = \alpha_0(t)\exp\left(\sum_{k=1}^{K} \beta_k\, X\,\mathbf{1}(t \in I_k)\right). \] Pendant la période \(I_k\), le RR vaut \(\exp(\beta_k)\). L’effet est supposé constant au sein de chaque période, mais peut différer d’une période à l’autre. Les hypothèses du test sont :
- \(H_0 : \beta_1 = \beta_2 = \dots = \beta_K\), l’effet de \(X\) est le même sur toutes les périodes
- \(H_1 : \text{au moins deux coefficients } \beta_k\) diffèrent
On compare ce modèle au modèle à un seul coefficient \(\beta\) par le test du rapport des vraisemblances partielles. Sous \(H_0\), la statistique suit asymptotiquement une loi du \(\chi^2\) à \(K-1\) degrés de liberté. Avec deux périodes, le modèle peut s’écrire de façon équivalente \(\alpha_0(t)\exp(\beta X + \gamma\, X\,\mathbf{1}(t > \tau))\), et l’on teste \(H_0 : \gamma = 0\).
Cette approche n’impose pas de forme particulière à la modification de l’effet, et fournit un RR par période, facile à interpréter. En contrepartie, le résultat dépend des temps de coupure choisis. Pour les choisir, on peut s’appuyer sur les courbes \(\ln(-\ln(\hat S(t)))\). La courbe lissée des résidus de Schoenfeld peut être utilisée de la même manière. Dans tous les cas, chaque période doit contenir suffisamment d’évènements. À défaut d’indication graphique claire, on peut couper à la médiane des temps d’évènement.
Dans le scénario de modification quantitative, les Figures 1 et 3 suggèrent que l’effet de l’exposition diminue surtout pendant les premiers mois. Avec une coupure à \(\tau = 6\) mois, on obtient \(\widehat{RR} = 3{,}01\) pendant les 6 premiers mois et \(\widehat{RR} = 1{,}43\) ensuite. Le test du rapport des vraisemblances partielles vaut \(X_L^2 = 24{,}07\), pour 1 degré de liberté (\(p < 0{,}001\)) : on rejette \(H_0\).
Avertissement
- Un rejet de \(H_0\) constitue un argument contre la proportionnalité des risques, sous réserve des autres hypothèses du test. Si l’on ne rejette pas \(H_0\), on peut seulement conclure que les données ne permettent pas de mettre en évidence une modification de l’effet de la forme choisie (fonction \(g(t)\) ou découpage en classes). Une modification d’une autre forme reste possible. L’absence de rejet ne constitue donc pas une validation de la proportionnalité.
- Vérifier l’hypothèse de proportionnalité des risques conduit rapidement à réaliser beaucoup de tests. On peut réaliser un test par variable du modèle, un test global, éventuellement plusieurs fonctions \(g(t)\) ou plusieurs découpages du temps. Or, plus le nombre de tests réalisés augmente et plus la probabilité de rejeter \(H_0\) à tort augmente. Une solution par exemple dans le cas de la réalisation de tests pour vérifier l’hypothèse de proportionnalité des risques, est de choisir a priori la fonction du temps \(g(t)\) (ou le découpage), plutôt que d’essayer plusieurs formes et de retenir celle qui conduit au rejet.
6.1.4 Conséquences du non-respect de l’hypothèse
Lorsque l’hypothèse n’est pas respectée, le RR constant estimé par Cox est un résumé de l’association sur le suivi, dont la pondération dépend des évènements, des ensembles à risque et de la censure. Selon la manière dont l’effet évolue, cette estimation est plus ou moins problématique. On distingue deux schémas couramment rencontrés, illustrés par la Figure 4 ci-dessous.
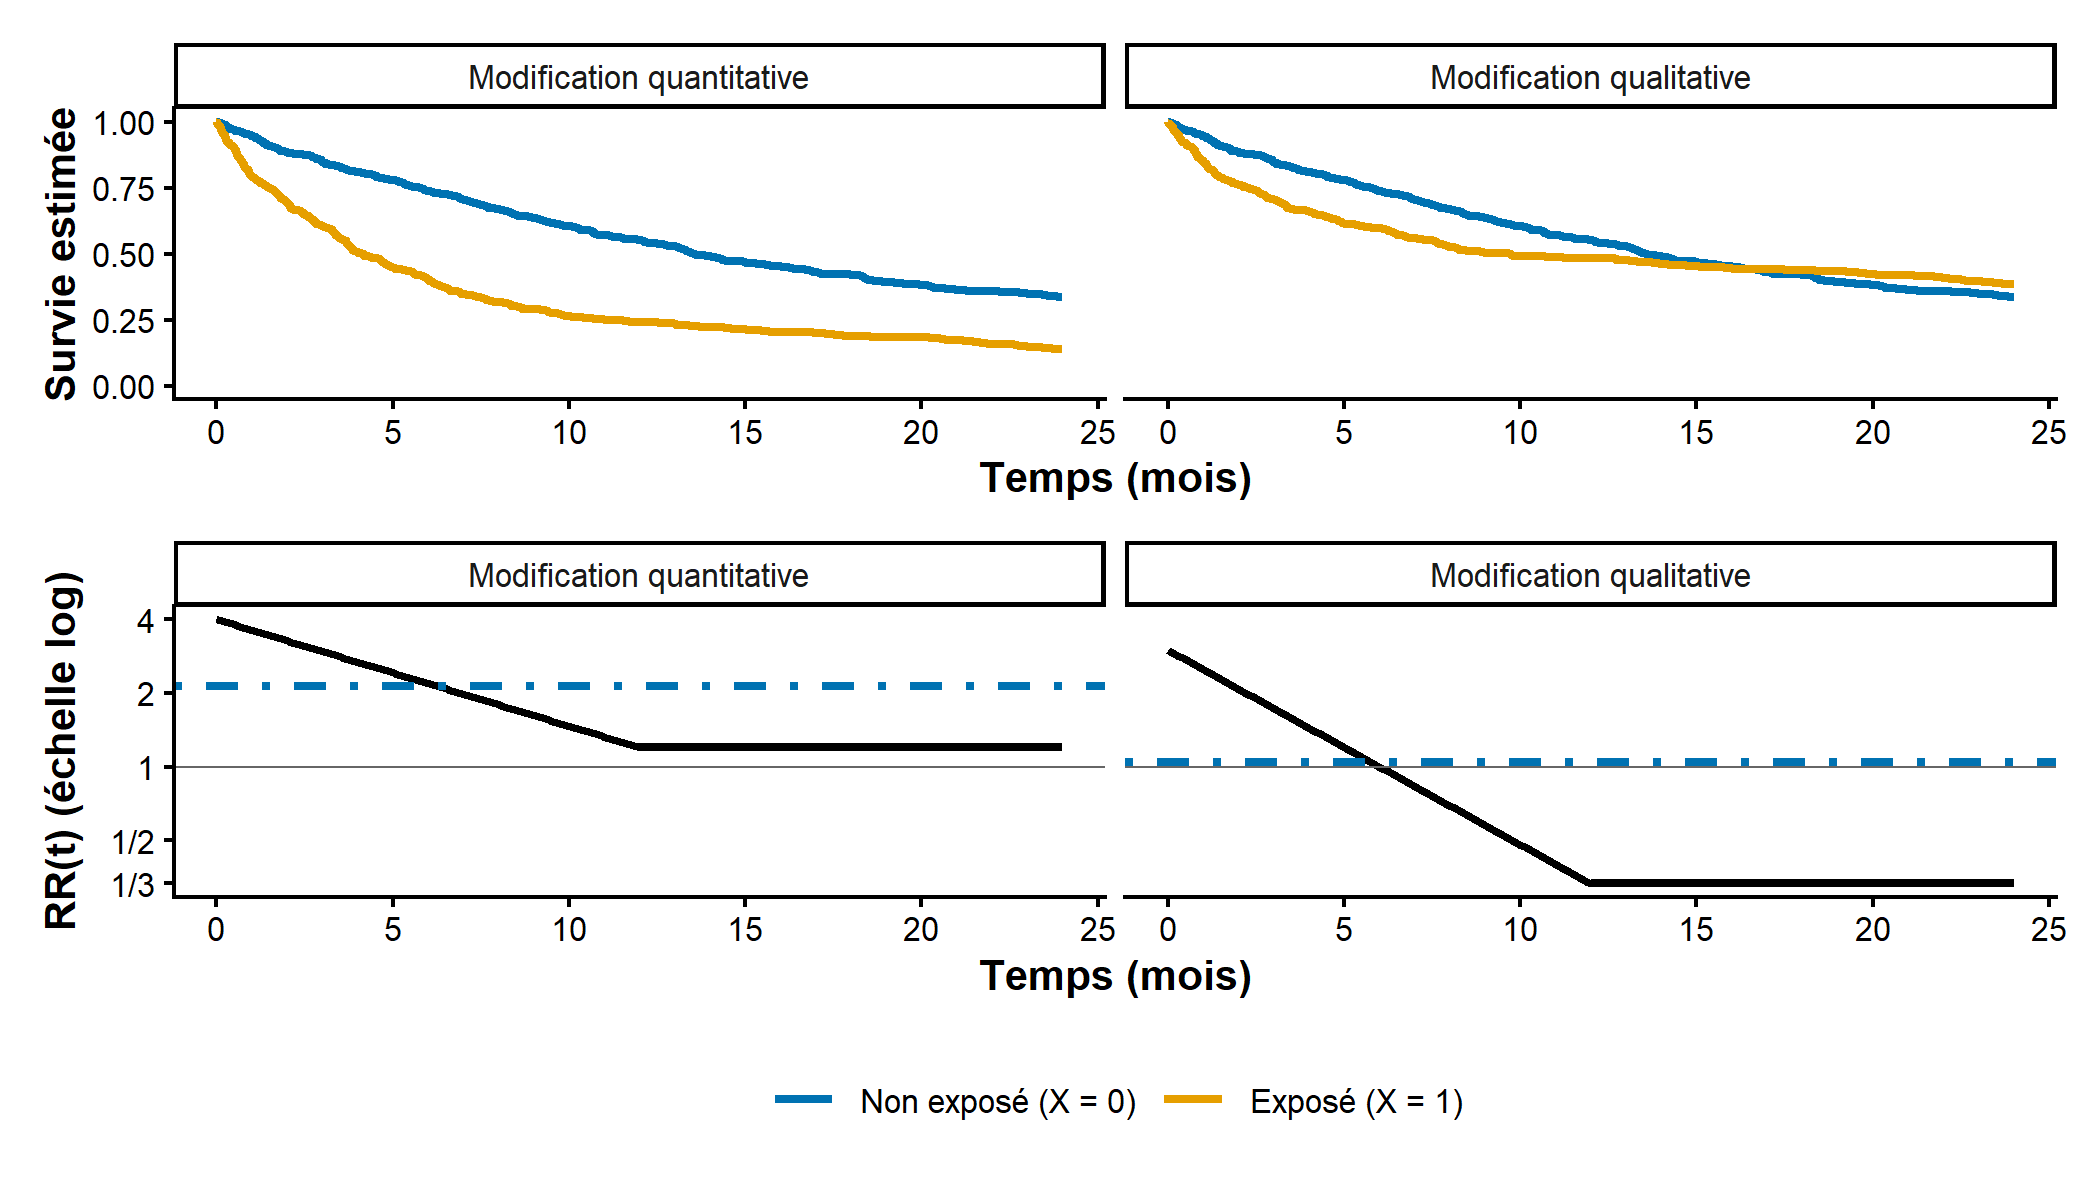
Modification quantitative. Le risque associé à la variable diminue ou augmente au cours du temps, mais le RR ne franchit jamais la valeur \(1\). Cela pourrait par exemple être le cas d’une cohorte où l’efficacité d’un traitement s’estompe progressivement. Dans notre cohorte, le modèle de Cox estime \(\widehat{RR} = 2{,}14\) (\(\text{IC}_{95\%} = [1{,}85 \; ; \; 2{,}47]\)), alors que la vraie valeur du RR dans ce scénario de cohorte simulée décroît de \(4\) à \(1{,}2\). Le RR constant conserve ici le sens de l’association, mais masque une variation importante. Il ne doit pas être présenté comme valable à chaque instant, et son intervalle de confiance ne constitue pas un intervalle pour le vrai RR à un temps donné.
Modification qualitative. Le RR franchit la valeur \(1\) au cours du temps. La variable augmente le risque sur une partie du suivi et le diminue sur une autre. Par exemple, dans le cas où une opération chirurgicale serait connue pour augmenter le risque de décès dans la période périopératoire, mais le diminuer à plus long terme, on s’attendrait alors à avoir une inversion du RR au cours du suivi. Dans ce cas, non seulement l’effet de la variable est mal représenté, mais les effets opposés des différentes périodes se compensent. Dans notre cohorte, le modèle de Cox estime \(\widehat{RR} = 1{,}04\) (\(\text{IC}_{95\%} = [0{,}89 \; ; \; 1{,}22]\), \(p = 0{,}59\)). On pourrait être tenté de conclure à tort à une absence de liaison entre l’exposition et l’évènement, alors que l’exposition triple le risque en tout début de suivi et le divise par trois à partir de 12 mois. En découpant le suivi à 6 mois, on retrouve deux effets opposés : \(\widehat{RR} = 1{,}77\) pendant les 6 premiers mois et \(\widehat{RR} = 0{,}58\) ensuite (\(X_L^2 = 48{,}22\), 1 ddl, \(p < 0{,}001\)).
6.1.5 Que faire en cas de non-respect de l’hypothèse ?
La solution dépend du rôle de la variable dans l’analyse, variable explicative ou variable d’ajustement.
Variable explicative d’intérêt. On souhaite estimer son effet sur la survenue de l’évènement. Plusieurs options sont possibles.
- Introduire une interaction avec le temps, et présenter l’effet de la variable sous forme d’un RR qui dépend du temps en veillant à ce que le modèle reste interprétable. Plusieurs formes d’interaction sont possibles avec \(g(t) = t\), \(g(t) = \ln(t)\), le temps en classes, etc… En fonction de la forme du temps choisi, on présentera les résultats du RR à différents temps de suivi.
- Garder la variable telle quelle, lorsque l’interaction rend le modèle trop complexe ou ne modifie pas nettement la relation. Un mauvais ajustement est parfois meilleur que pas d’ajustement du tout. Le RR s’interprète alors comme un effet moyen sur la période de suivi, ce qu’il faut signaler et discuter après la présentation des résultats. Par exemple, dans le scénario de modification quantitative, on peut présenter \(\widehat{RR} = 2{,}14\) en précisant que l’effet de l’exposition semble plus marqué en début de suivi. Cette option est à proscrire en cas de modification qualitative.
- Changer de modèle. D’autres modèles ont été développés pour pallier à ce problème de non respect de l’hypothèse de proportionnalité des risques comme les modèles de vie accélérée et modèles additifs dont on ne fera pas le développement. L’inconvénient de ces modèles est l’interprétation des paramètres de régression qui diffèrent du modèle de Cox.
La variable est une variable d’ajustement. Son effet propre n’est pas l’objet de l’analyse, on souhaite seulement ajuster la relation entre la variable explicative d’intérêt et l’évènement.
- Stratifier sur la variable. Le modèle de Cox stratifié autorise une fonction de risque de base différente dans chaque strate \(s\) définie par les modalités de la variable : \[ \alpha_s(t) = \alpha_{0s}(t)\exp(\beta^\top X). \]
Aucune hypothèse de proportionnalité n’est faite entre les strates, puisque les risques de base \(\alpha_{0s}(t)\) peuvent avoir des formes quelconques. En revanche, les coefficients \(\beta\) des autres variables sont supposés identiques dans toutes les strates. La variable de stratification n’a pas de coefficient, on n’obtient donc aucun RR pour elle. Une variable quantitative doit être découpée en classes, et les strates doivent contenir suffisamment d’évènements.
- Éliminer la variable du modèle, si ce n’est pas un facteur de confusion. Par exemple, si la variable n’est pas liée à l’exposition et que son retrait ne modifie pratiquement pas le RR de l’exposition, rien n’oblige à la conserver.
- Garder la variable telle quelle, pour la même raison que précédemment, un mauvais ajustement est parfois meilleur que pas d’ajustement du tout. Par exemple, si l’âge est un facteur de confusion dont l’effet s’atténue légèrement au cours du suivi, le conserver dans le modèle corrige tout de même l’essentiel de la confusion, ce que le retirer ne permettrait pas.
6.2 Hypothèse de log-linéarité de la relation entre la fonction de risque et une variable quantitative
Cette hypothèse ne concerne que les variables quantitatives introduites telles quelles dans le modèle. Une variable qualitative, représentée par des indicatrices, n’impose aucune contrainte de ce type, puisque chaque modalité possède son propre coefficient.
Reprenons l’écriture du modèle de Cox pour une variable quantitative \(X\) : \[ \ln \alpha(t) = \ln \alpha_0(t) + \beta X \]
Le logarithme du risque est donc une fonction linéaire de \(X\), d’où le nom de l’hypothèse. Comparons deux sujets dont les valeurs de \(X\) diffèrent de \(d\) unités : \[ \frac{\alpha(t \mid X = x + d)}{\alpha(t \mid X = x)} = \frac{\alpha_0(t)\exp(\beta(x+d))}{\alpha_0(t)\exp(\beta x)} = \exp(\beta d). \]
Ce rapport ne dépend pas de \(x\), c’est-à-dire de l’endroit où l’on se situe sur l’échelle de la variable. Autrement dit, \(\exp(\hat\beta)\) est le RR associé à une augmentation d’une unité de \(X\), quelle que soit la valeur de \(X\).
C’est une hypothèse forte, et de nombreuses relations ne sont pas log-linéaires. Un effet peut apparaître au-delà d’un seuil, ou encore être en U, le risque étant minimal pour les valeurs intermédiaires et plus élevé aux deux extrêmes (c’est fréquent lorsque l’on étudie dans une cohorte le lien entre un évènement de santé et un indicateur comme l’indice de masse corporelle ou la pression artérielle).
Pour illustrer ces méthodes, nous simulons une seconde cohorte, de 1000 sujets, avec 500 exposés et 500 non exposés, suivis au plus 24 mois. L’âge à l’inclusion est compris entre 40 et 85 ans. On impose un RR de \(2\) pour l’exposition et de \(1,03\) par année d’âge, avec des risques proportionnels et une censure administrative à 24 mois. Le modèle contenant l’exposition et l’âge en continu donne : \[ \widehat{RR}_{\text{âge}} = 1{,}035 \quad ; \quad \text{IC}_{95\%} = [1{,}027 \; ; \; 1{,}044] \quad ; \quad p < 0{,}001. \] L’âge est donc associé au risque. Reste à savoir si la relation entre cette variable et la fonction de risque est bien log-linéaire.
6.2.1 Vérification par découpage en classes
L’idée est de découper la variable en classes, puis de regarder si le modèle avec la variable continue rend bien compte de ce que l’on observe classe par classe. La démarche se déroule ainsi :
1. Découper la variable en classes. Trois ou quatre classes suffisent en général. On peut les définir par les terciles ou les quartiles, ou par des bornes fixées a priori lorsque la littérature le suggère. Dans les deux cas, chaque classe doit contenir suffisamment d’évènements.
2. Ajuster le modèle avec les indicatrices. On remplace la variable quantitative par les indicatrices des classes. La première servant de référence, on conserve les autres variables du modèle. On obtient un \(\widehat{RR}\) et son intervalle de confiance pour chaque classe. Ces estimations autorisent un effet différent par classe, mais supposent cet effet constant à l’intérieur de chaque classe.
3. Résumer chaque classe. On calcule la moyenne (ou la médiane) de la variable au sein de chaque classe, puis la différence entre la valeur moyenne (ou la médiane) de chaque classe et celle de la classe de référence.
4. Calculer le RR attendu sous l’hypothèse de log-linéarité. Une fois le calcul des différences effectué, on prend la valeur obtenue pour chaque classe \(k\), puis l’on estime le RR avec les paramètres du modèle continu : \[ HR_k^{\text{attendu}} = \exp\bigl(\hat\beta \times (\bar X_k - \bar X_{\text{réf}})\bigr), \] où \(\hat\beta\) est le coefficient estimé dans le modèle continu.
5. Comparer. L’hypothèse est jugée acceptable si, pour chaque classe, le RR attendu se situe à l’intérieur de l’intervalle de confiance du RR observé. Dès qu’une classe fait exception, on peut considérer que la relation entre la variable quantitative et la fonction de risque ne respecte pas l’hypothèse de log-linéarité.
Appliquons cette démarche dans notre cohorte simulée à l’âge, découpé en quartiles. Le découpage de la variable de l’âge nous fournit les quatre classes suivantes : \([40;53]\), \([54;60]\), \([61;66]\) et \([67;85]\). Ainsi, on estime un premier modèle contenant les classes d’âge et l’on extrait les \(\widehat{RR}\) ainsi que leur \(\text{IC}_{95\%}\). Le modèle est le suivant : \[ \alpha(t) = \alpha_0(t)\exp(\beta_{1}\text{Expo} + \beta_{2}\mathbf{1}_{[54;60]}(\text{âge}) + \beta_{3}\mathbf{1}_{[61;66]}(\text{âge}) + \beta_{4}\mathbf{1}_{[67;85]}(\text{âge})) \] où \(\text{Expo}\) est la variable d’exposition et la modalité de référence pour l’âge est \([40;53]\). Les indicatrices valent \(1\) si l’âge appartient à la classe considérée, \(0\) sinon. Les âges sont entiers.
La classe de référence a un âge moyen de \(48,37\) ans, contre \(57,19\) ans dans la deuxième classe. L’écart est donc d’environ \(8,82\) ans. Comme le coefficient du modèle où l’âge est traité comme une variable continue estimé vaut \(0{,}03477\), on a : \[ HR_{]54;60]}^{\text{attendu}} = \exp\bigl(0.0326 \times 8,1\bigr) = 1,30 \]
On répète la même opération pour toutes les classes restantes et on obtient les résultats suivants :
| Classe | Étendue (années) | Âge moyen | Évènements | \(\widehat{RR}\) [\(\text{IC}_{95\%}\)] | RR attendu |
|---|---|---|---|---|---|
| C1 | \([40;54]\) | \(49,3\) | \(189\) | référence | – |
| C2 | \(]54;60]\) | \(57,4\) | \(189\) | \(1,41\) \([1,16 ; 1,73]\) | \(1,30\) |
| C3 | \(]60;66]\) | \(63,2\) | \(186\) | \(1,52\) \([1,24 ; 1,86]\) | \(1,58\) |
| C4 | \(]66;84]\) | \(72,3\) | \(221\) | \(2,14\) \([1,76 ; 2,60]\) | \(2,12\) |
Les trois RR attendus appartiennent aux intervalles de confiance estimés avec la variable âge en classe. Ainsi, on peut affirmer que l’hypothèse de log-linéarité est acceptable pour l’âge.
Cette méthode est simple. Cependant, le résultat dépend du découpage retenu. Les intervalles de confiance sont plus larges à mesure que le nombre de classes augmente, ce qui rend la vérification d’autant plus permissive. Enfin, il ne s’agit pas d’un test, simplement une lecture de résultats entre deux modèles. Il est ainsi préférable de la combiner à un test.
6.2.2 Vérification par les résidus de martingale
Le résidu compare, pour chaque sujet, ce qui a été observé (\(0\) ou \(1\)) au risque cumulé prédit sur sa durée observée, \(\hat\Lambda_0(t_i)\exp(\hat\beta^\top X_i)\). Contrairement aux résidus de Schoenfeld, définis à chaque temps d’évènement, il y a ici un résidu par sujet, puisque chacun est représenté par une seule observation.
Si le modèle est correctement spécifié, la moyenne des résidus doit rester proche de \(0\) sur l’échelle de la variable étudiée. En revanche, dans une zone de l’échelle où le modèle sous-estime le risque, les sujets présentent plus d’évènements que prévu et leur moyenne résiduelle tend à être positive ; elle tend à être négative là où le modèle surestime le risque. Les résidus individuels sont asymétriques : leur majorité n’a pas nécessairement le signe de leur moyenne.
On ajuste le modèle avec la variable âge continue, on ordonne les sujets par valeurs croissantes de cette variable, et on cumule leurs résidus au fur et à mesure. On obtient un processus \(W(x)\), la somme des résidus de tous les sujets dont la valeur est inférieure ou égale à \(x\). Si le modèle continu est correct, le processus fluctue autour de \(0\) sans dérive systématique ; s’il sous-estime le risque dans une zone, les résidus de cette zone s’accumulent dans le même sens et le processus s’éloigne de \(0\).
C’est sur ce processus que repose le test du supremum de Lin, Wei et Ying (1993). La statistique de test est la plus grande valeur absolue atteinte par le processus, \(\sup_x |W(x)|\). Les hypothèses sont :
- \(H_0\) : l’effet de la variable est log-linéaire, sous réserve de la bonne spécification des autres composantes du modèle ;
- \(H_1\) : il ne l’est pas.
La loi de la statistique de test sous \(H_0\) n’a pas de forme analytique simple, on l’obtient en simulant un grand nombre de trajectoires du processus \(\sup_x |W(x)|\) en faisant l’hypothèse du respect de la relation log-linéaire entre l’âge et la fonction de risque, puis on note pour chacune des trajectoires sa distance maximale à 0. La p-valeur est la proportion de ces courbes qui dépassent la distance observée. Sur notre cohorte, le test donne \(\sup|W| = 16{,}9\) et \(p = 0{,}32\). \(32\%\) des courbes simulées s’écartent au moins autant de 0. \(p>0,05\). On ne rejette pas \(H_0\). Autrement dit, la relation entre la variable âge continue et la fonction de risque n’a rien d’inhabituel quand le modèle respecte l’hypothèse de log-linéarité.
Avertissement
Comme pour la proportionnalité des risques, ces tests ne permettent de conclure que lorsque \(H_0\) est rejetée. Un test non significatif signifie seulement que les données ne permettent pas de mettre en évidence un écart à la log-linéarité, et non que la relation est log-linéaire.
6.2.3 Que faire en cas de non-respect de l’hypothèse ?
Il ne s’agit pas de retirer la variable du modèle, mais de lui donner une forme adaptée. Pour solutionner le problème, on peut transformer la variable en appliquant le logarithme ou la racine à celle-ci. Également, on peut ajouter un terme quadratique dans la dépendance de la fonction de risque (inclure \(X^2\) en plus de \(X\)). Sans détailler comment appliquer cette solution, utiliser des fonctions splines qui n’imposent pas de forme particulière à la variable \(X\) peut permettre de s’approcher plus facilement de la relation qui la lie à la fonction de risque.
Utiliser le découpage en classes reste la solution la plus simple à mettre en place et à communiquer, avec un RR par classe, sans imposer aucune forme à la relation. En revanche, cette solution perd de l’information, dépend des bornes choisies et suppose un risque constant à l’intérieur de chaque classe.
6.3 Hypothèse de censure non-informative
Cette hypothèse porte sur la nature des données elles-mêmes. La censure est dite non informative lorsque le fait d’être censuré n’apporte aucune information sur le risque de survenue de l’évènement. Un sujet censuré au temps \(t\) doit avoir, après \(t\), le même risque que les sujets de mêmes caractéristiques qui restent suivis au-delà de \(t\). En d’autres termes, la censure d’un sujet ne doit pas être le marqueur d’une dégradation de son état.
La méthode d’estimation de la fonction de survie par l’estimateur de Kaplan-Meier ou de la fonction de risque instantanée par le modèle de Cox, fait cette hypothèse de censure non-informative et traite les sujets censurés en \(t\) en les retirant simplement de l’effectif à risque. Puis, estime avec les sujets restant encore suivis après \(t\) ces fonctions. Procéder ainsi, force à émettre l’hypothèse que le sujet censuré est représentatif des sujets encore à risque après \(t\). Plus clairement, qu’un sujet censuré devrait être autant à risque de présenter l’évènement que les sujets encore dans l’étude n’ayant pas encore présenté l’évènement.
Or, dans certaines configurations, on observe des sorties d’études informatives. C’est-à-dire, des patients qui n’ont pas encore rencontré l’évènement, mais qui sortent de l’étude en raison d’un traitement testé non adapté ou d’une détérioration de leur état clinique. Cela a une conséquence directe sur l’estimation des paramètres du modèle, puisque l’on risque de ne conserver que les patients en meilleure santé jusqu’à la fin du suivi. Le risque de survenue de l’évènement aura tendance à être sous-estimé.
À l’inverse, il est possible avec d’autres schémas d’étude de voir des sujets en bonne santé sortir prématurément en raison d’une amélioration de leur état clinique (les sujets ne souhaitent plus participer car ne voient pas l’intérêt de leur présence dans l’étude). Dans cette configuration, les sujets censurés sont en bonne santé et ceux restant n’ayant pas encore présenté l’évènement sont ceux avec un état clinique globalement plus grave. Le risque de survenue de l’évènement aura alors tendance à être sur-estimé.
Cette hypothèse ne se vérifie donc pas, elle se discute, à partir du protocole de l’étude et des raisons de sortie de chaque sujet. Au cours de l’analyse, on décrira les censures en précisant leur nombre, les raisons si celles-ci sont connues et à quels temps de l’étude celles-ci interviennent. Il est également intéressant de décrire les données observées des sujets sortis d’étude sans évènement en comparaison de celles des sujets censurés en fin de suivi.
Enfin, il est parfois courant de rencontrer dans diverses populations, ce que l’on appelle des risques compétitifs. Par exemple, dans une étude, on souhaite regarder le lien entre des caractéristiques recueillies à l’inclusion et une maladie. Cependant, dans le cas de populations à l’état clinique détérioré, les sujets peuvent décéder avant d’avoir été diagnostiqués de la maladie étudiée. Le risque de maladie est en compétition avec le risque de décès. Ici, le modèle de Cox classique que nous avons vu jusqu’ici n’est plus adapté à ce schéma d’étude et les paramètres estimés sont biaisés. Il est nécessaire de se tourner vers d’autres modèles, comme le modèle à risques compétitifs.
6.4 Hypothèse de données continues
Nous avons supposé, dès la définition des fonctions de survie et de risque, que le délai \(T\) est une variable aléatoire continue (section 2.5). Cela signifie que deux sujets ne peuvent pas présenter l’évènement exactement au même instant. Dans les faits, cela arrive souvent à cause de la discrétisation du temps et le mode de recueil des données inhérentes aux données de survie. On parle alors d’ex-aequo (ou ties), c’est-à-dire qu’au moins deux sujets présentent l’évènement en même temps.
Sans rentrer dans les détails, la méthode utilisée pour estimer la vraisemblance partielle (ce qui permet d’obtenir les paramètres du modèle) a besoin de savoir, à chaque évènement, qui était encore à risque à cet instant et qui a présenté l’évènement. Quand deux sujets partagent le même délai, on ne sait plus lequel des deux a présenté l’évènement en premier, et donc si le second était ou non encore à risque au moment du premier. L’ordre réel existe bien, mais le mode de recueil ne l’a pas conservé.
La méthode d’approximation de cette vraisemblance partielle la plus simple et rapide à estimer est celle dite de Breslow (par défaut celle de SAS). Cette méthode a tendance à rapprocher les coefficients estimés du modèle de 0 (donc rapprocher les RR de 1). La méthode d’approximation exacte existe et estime cette vraisemblance en fonction de tous les ordres possibles entre les sujets ex aequo. C’est la méthode la plus rigoureuse, mais son temps de calcul devient vite long. Un compromis, notamment utilisé par défaut dans R, est la méthode d’Efron.
Toutefois, lorsque le nombre d’ex aequo est trop élevé ou que l’évènement ne peut survenir qu’à des temps très précis et qu’aucune des méthodes d’estimation ne donne de résultats satisfaisants, on se tourne généralement vers la régression de Poisson (pas discutée dans ce cours) qui est plus adaptée à l’analyse de données avec ex-aequo que le modèle de Cox.
Les références
Grambsch, Patricia M., et Terry M. Therneau. 1994. « Proportional Hazards Tests and Diagnostics Based on Weighted Residuals ». Biometrika 81 (3): 515‑26. https://doi.org/10.1093/biomet/81.3.515.
Schoenfeld, David. 1982. « Partial Residuals for the Proportional Hazards Regression Model ». Biometrika 69 (1): 239‑41. https://doi.org/10.1093/biomet/69.1.239.