2 Concepts clés de l’analyse de survie
2.1 Dates et délais
L’analyse commence par le choix d’une origine du temps, cohérente avec la question posée : naissance, randomisation, intervention chirurgicale ou mise sous traitement, par exemple. Pour un évènement incident, la durée étudiée est le délai entre cette origine et sa survenue.
Il faut également distinguer :
- la date d’entrée dans l’étude, à partir de laquelle le sujet est observé ; elle peut être postérieure à l’origine du temps ;
- la date de dernières nouvelles, dernière date à laquelle le statut vis-à-vis de l’évènement est connu ;
- la date de point, date limite fixée pour les observations retenues dans l’analyse.
Pour l’analyse du premier évènement, l’observation s’arrête à sa survenue, à la perte de suivi ou à la date de point, selon ce qui survient en premier. Si l’origine du temps précède l’entrée dans l’étude, le délai depuis l’origine ne doit pas être confondu avec la durée effectivement observée.
Plusieurs échelles de temps sont possibles :
| Échelle de temps | Origine | Exemple d’usage |
|---|---|---|
| Temps depuis la randomisation ou l’inclusion | Date propre à chaque sujet | Essai clinique |
| Âge | Naissance | Évènement dont la fréquence / sévérité dépend de l’âge |
| Temps calendaire | Date de référence commune | Évolution d’une épidémie, catastrophe naturelle |
Dans les études longitudinales, plusieurs échelles de temps sont possibles. Les méthodes que nous allons aborder dans ce chapitre fonctionnent pour toutes ces échelles, mais l’interprétation des résultats va s’en trouver modifiée ! En l’occurrence, avec l’âge ou le temps calendaire, il faudra tenir compte des entrées retardées, présentées ci-dessous.
Le “temps depuis inclusion” est la plus fréquemment utilisée
2.2 Évènement
La définition de l’évènement d’intérêt doit être précise et être la même pour l’ensemble des sujets. Pour le décès, on précisera s’il s’agit de toutes les causes ou d’une cause particulière (p. ex., accident de la route, infarctus du myocarde). Pour l’apparition d’une maladie, les critères diagnostiques doivent être définis en amont. Il est également important de tenir compte du délai entre l’apparition de la maladie et le diagnostic si celui-ci est long.
2.3 Censure et troncature
Le temps exact de survenue de l’évènement n’est pas toujours observable. Deux mécanismes doivent être distingués : la censure, qui laisse une information partielle sur un sujet présent dans les données, et la troncature, qui détermine quels sujets apparaissent dans les données.
Retenez qu’un sujet censuré est présent dans les données, tandis qu’un sujet exclu par le mécanisme de troncature est absent. La censure est une forme d’observation incomplète, mais qui conserve une information sur le délai.
2.3.1 Censure
Kaplan-Meier et le modèle de Cox - présentés plus loin - reposent sur une hypothèse de censure dite non informative : les sujets encore suivis doivent représenter le devenir des sujets censurés. Cette hypothèse peut être vite mise à défaut (p. ex., des personnes sortent de l’étude pour des raisons liées à leur état de santé)
On distingue trois types de censure.
C’est le cas le plus fréquent en analyse de survie. On a deux principaux cas de censure à droite :
- un perdu de vue : le sujet quitte l’étude avant d’avoir subi l’évènement ;
- une censure administrative : le sujet n’a pas subi d’évènement de toute l’étude.
Mathématiquement, pour chaque sujet, on observe le couple \((\widetilde{T},\delta)\) défini par
\[ \widetilde{T}=\min(T,C) \;\text{et}\; \delta= \begin{cases} 1 & \text{si } T\leq C\\ 0 & \text{si } T>C \end{cases} \]
Ainsi, \(\delta=1\) indique que l’évènement a été observé et \(\delta=0\) que la durée est censurée à droite.
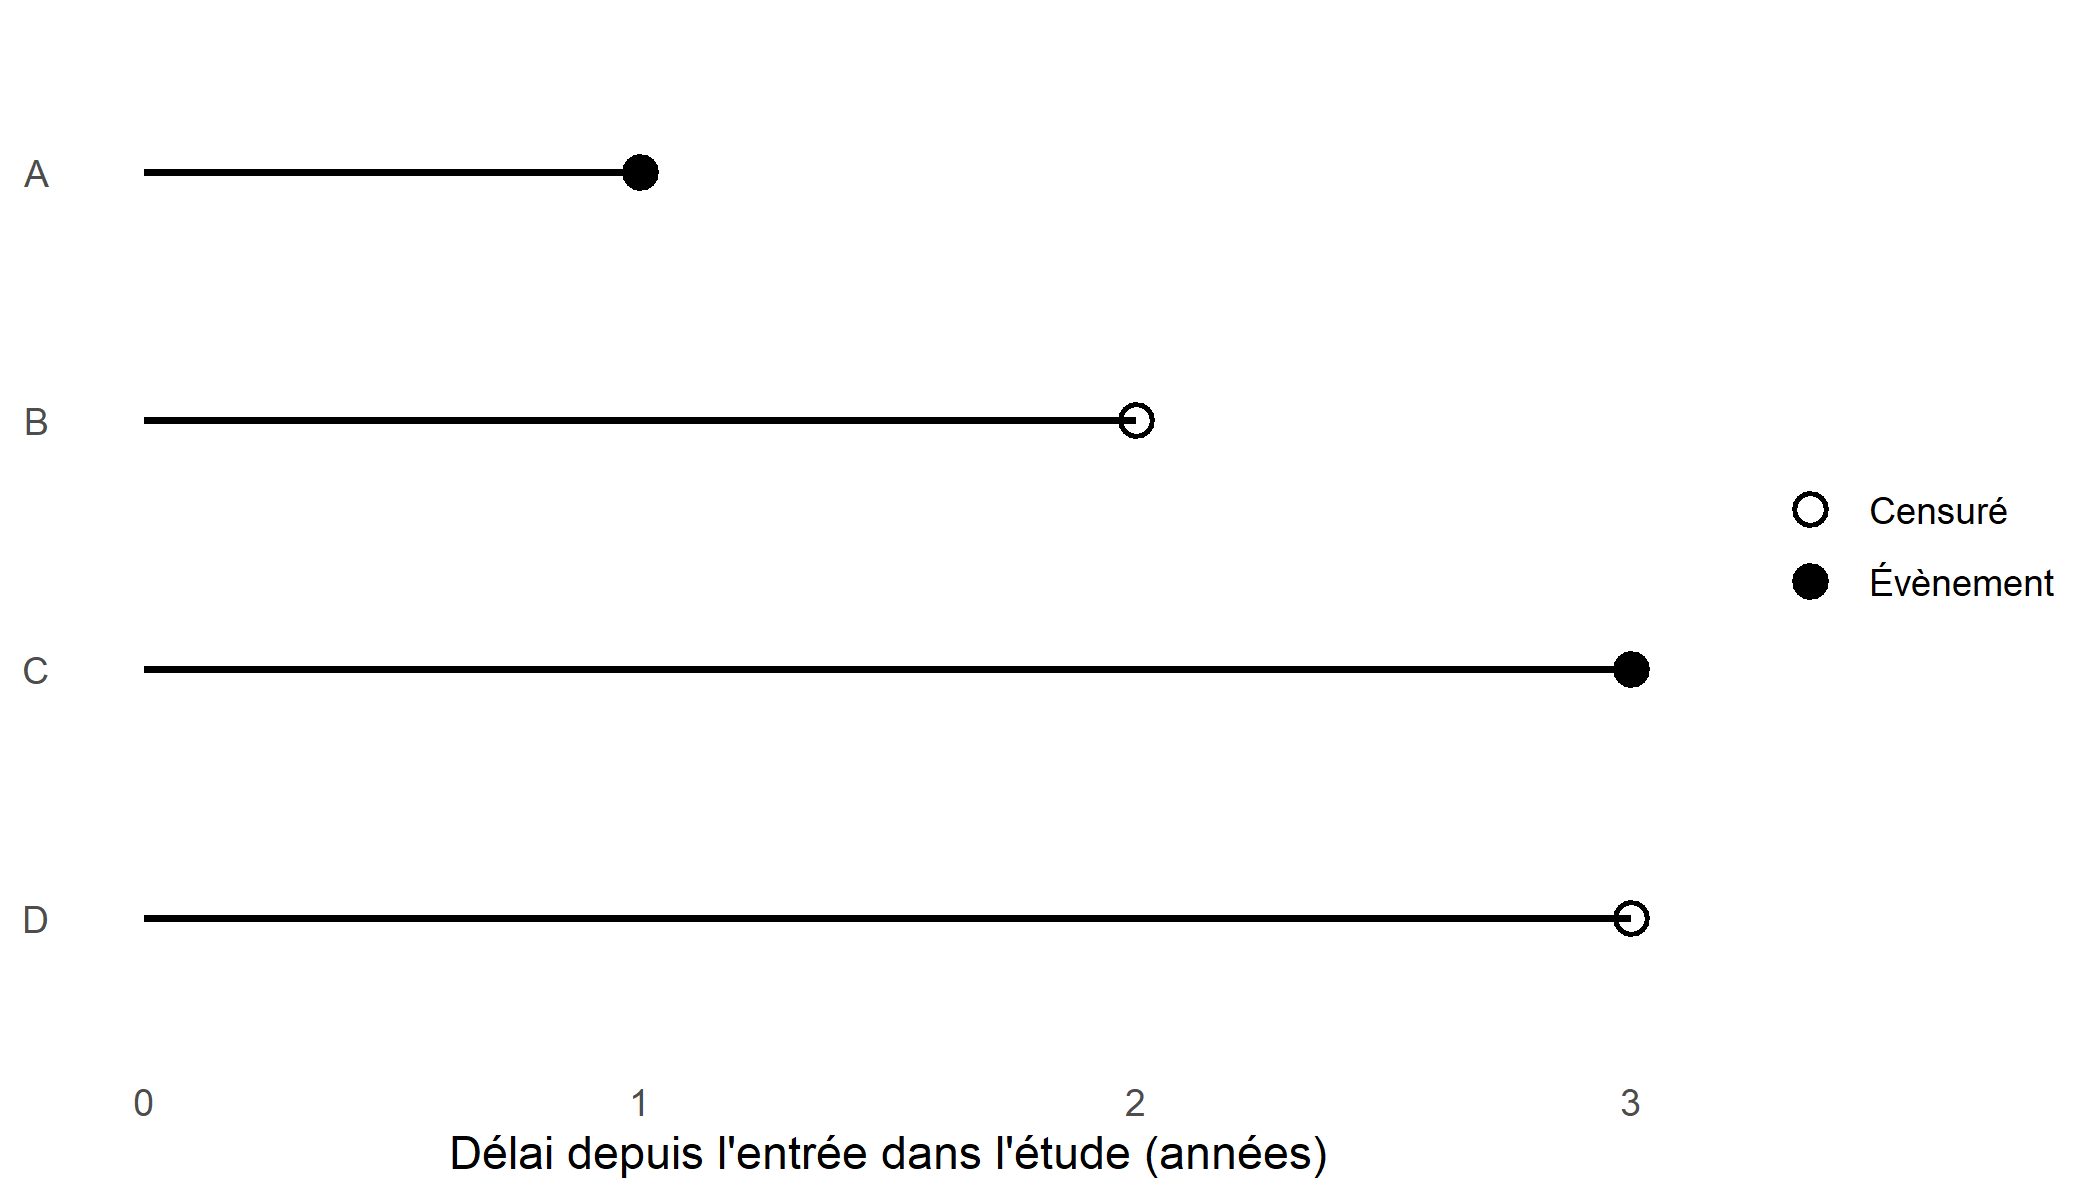
On peut aussi représenter chaque suivi par un segment allant de l’inclusion à l’évènement ou à la censure. Considérons alors quatre sujets, notés A à D, suivis jusqu’à un premier infarctus du myocarde (IdM). Les sujets B et D sont observés pendant 2 et 3 ans, puis leur suivi s’arrête sans avoir présenté d’IdM. Leur durée est censurée à droite : si l’évènement survient, ce sera après leur dernière observation. Les sujets A et C présentent un IdM après 1 et 3 ans.
| Sujet | A | C | B | D |
|---|---|---|---|---|
| Délai en années depuis l’entrée dans l’étude | 1 | 3 | 2 | 3 |
| Statut | 1 | 1 | 0 (= perdu de vue) | 0 (= censure administrative) |
Ce mécanisme est fréquent lorsque l’état des sujets n’est évalué qu’à des visites périodiques. Il n’y a toutefois censure par intervalle que si la date exacte de l’évènement reste inconnue.
2.3.2 Troncature
La troncature ne désigne pas n’importe quelle exclusion : la sélection doit dépendre du temps d’évènement. Comme pour la censure, on distingue trois types de troncature.
La notion d’effectif à risque est présentée en Section 2.4
Dans un essai où le temps est mesuré depuis la randomisation, tous les sujets entrent au temps \(E=0\) : il n’y a pas d’entrée retardée, même si les dates calendaires de randomisation diffèrent. Si l’on étudie l’âge au premier infarctus du myocarde chez des sujets encore indemnes à l’inclusion, et que l’âge est utilisé comme échelle de temps, l’origine devient la naissance et l’âge à la randomisation devient le temps d’entrée \(E_i\). Les sujets ne contribuent alors à l’effectif à risque qu’à partir de cet âge : les données sont tronquées à gauche par l’âge.
Dans la figure suivante, le trait vertical marque l’âge d’entrée de chaque sujet. Les sujets A et C entrent respectivement à 52 et 40 ans, puis présentent un IdM 1 et 3 ans plus tard. Les sujets B et D entrent à 35 et 47 ans, puis sont censurés à droite après 2 et 3 ans de suivi.
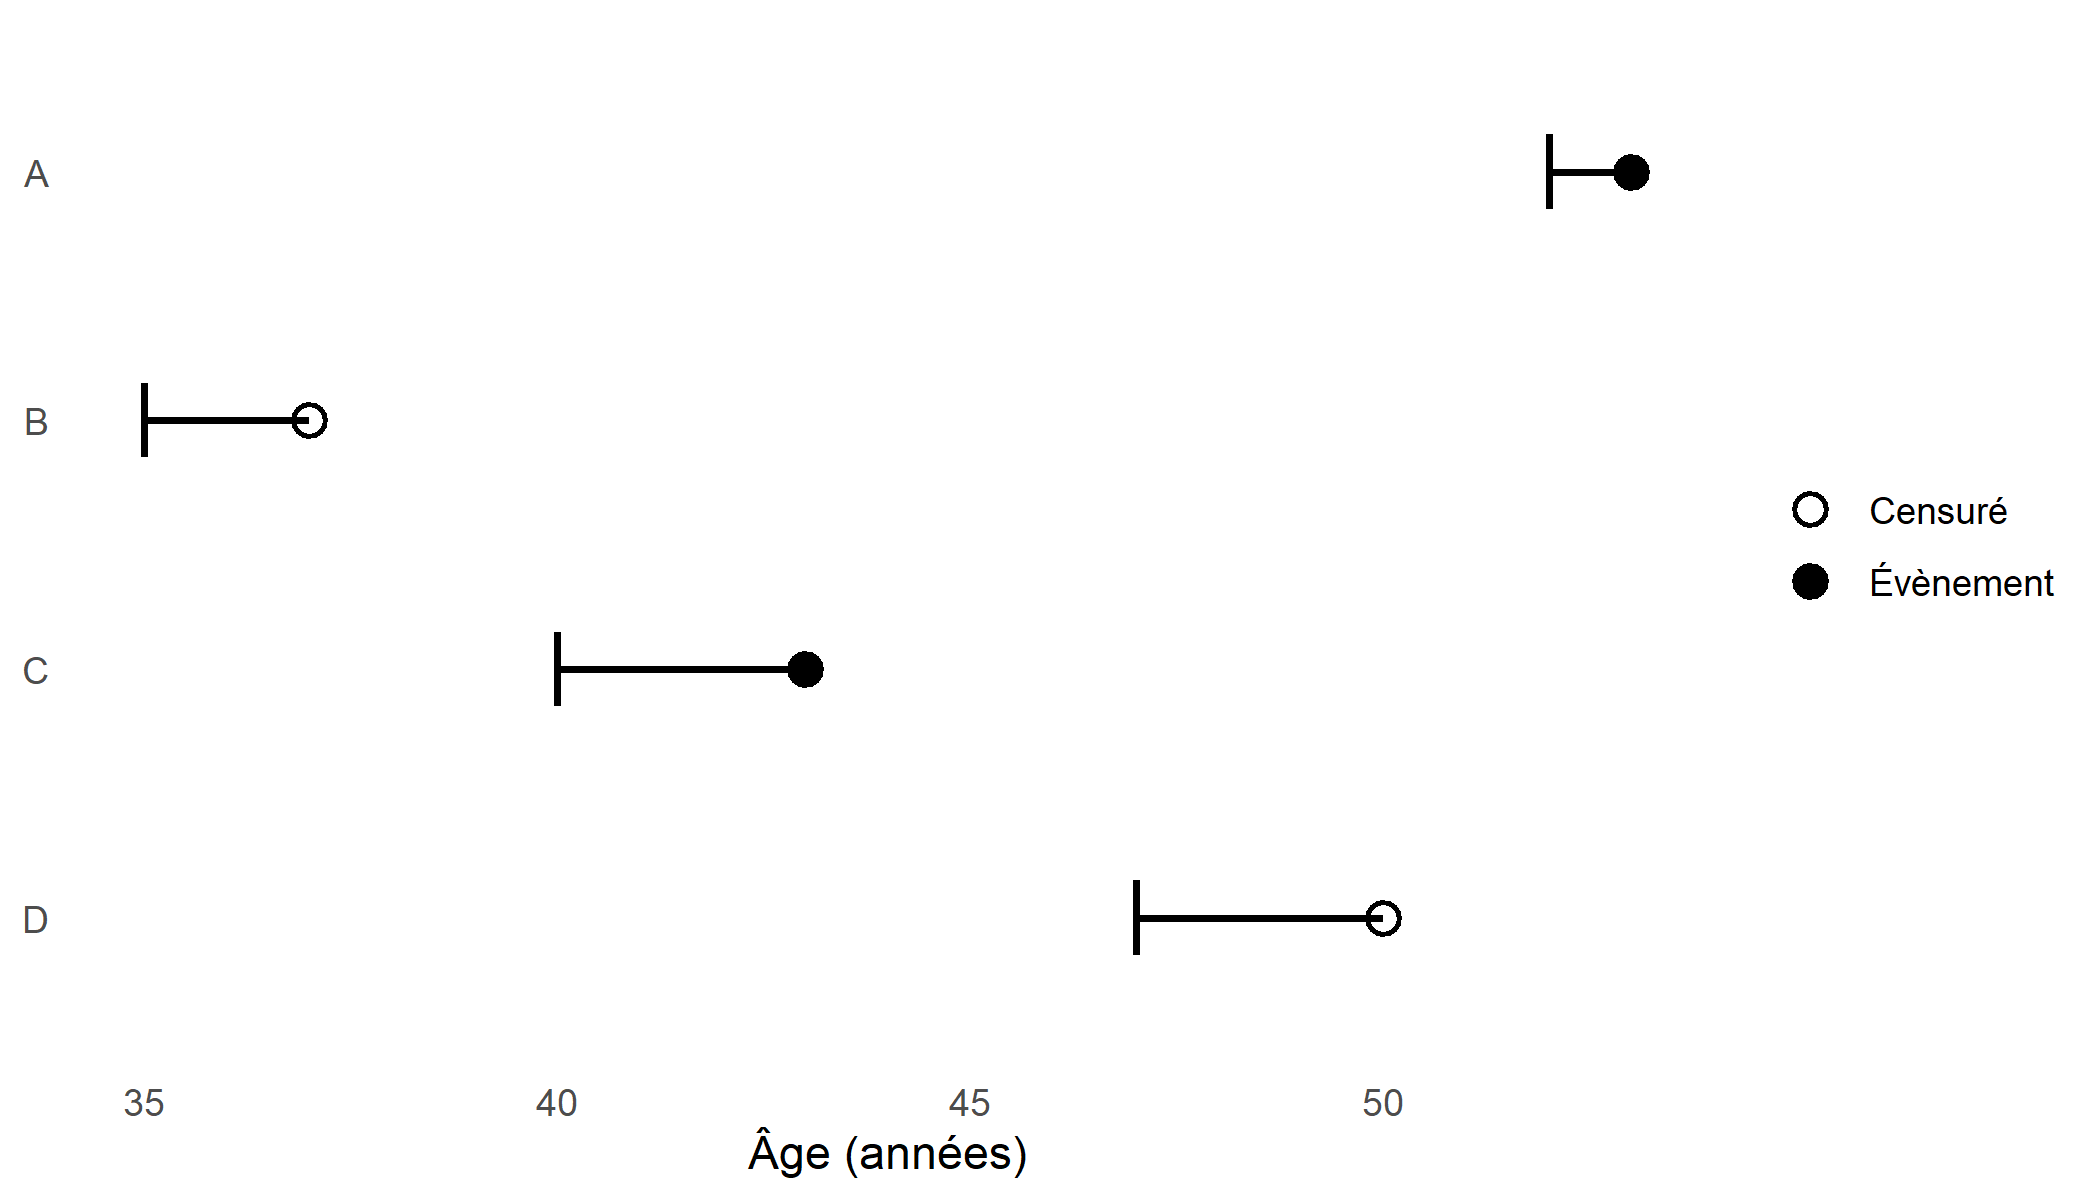
Une fin de suivi qui conserve dans la base les sujets sans évènement produit une censure à droite, et non une troncature. Dans un exemple volontairement artificiel fondé sur l’étude Toxo, il y aurait troncature à droite si la base ne contenait que les patients ayant présenté une toxoplasmose au plus tard deux ans après la randomisation : tous les autres patients seraient absents.
Note
L’estimateur de Kaplan-Meier, présenté dans la suite, traite la censure à droite. La troncature à gauche doit être prise en compte par l’entrée retardée dans l’effectif à risque. La censure à gauche ou par intervalle et la troncature à droite nécessitent des méthodes adaptées. Enfin, l’entrée retardée suppose que le mécanisme d’entrée n’apporte pas d’information supplémentaire sur le risque futur.
2.4 Effectif à risque
L’effectif à risque au temps \(t\) est le nombre de sujets observés et susceptibles de présenter l’évènement juste avant \(t\). Un sujet appartient à cet effectif s’il :
- est déjà entré dans l’étude ;
- n’a pas présenté l’évènement avant \(t\) ;
- n’a pas été censuré avant \(t\).
Un sujet qui présente l’évènement en \(t\) est donc inclus dans le dénominateur utilisé à cet instant. Avec une entrée retardée \(E_i\), la convention usuelle des intervalles \(]E_i,\widetilde T_i]\) donne : \[ n(t)=\sum_i \mathbf{1}\{E_i<t\leq\widetilde T_i\} \]
C’est une notation barbare, pour simplement dire “combien de sujets sont encore à risque juste avant \(t\) ?”
En cas d’évènements et de censures enregistrés au même temps, la convention usuelle compte les évènements avant de retirer les sujets censurés à ce temps.
C’est ce que nous représentons au Tableau 2 de la section 3
2.5 Fonctions
Enfin, terminons cette section par un peu de mathématiques. Bien qu’elles ne soient pas à apprendre par cœur, ces fonctions sont à la base des méthodes de l’analyse de survie. On représente le délai par la variable aléatoire \(T\) que l’on suppose continue et strictement positive.
-
La première est la fonction de survie \(S(t)\). Pour la définir, nous avons besoin de la fonction de répartition \(F(t)\), qui décrit la probabilité qu’un évènement survienne avant \(t\) : \[ F(t) = \mathbb{P}(T\leq t) \] Comme \(F(t)\) décrit la probabilité d’avoir eu un évènement avant \(t\), alors la probabilité de ne pas avoir subi l’évènement avant \(t\) est donnée par la relation : \[ S(t) = \mathbb{P}(T>t) = 1 - F(t) \]
Si l’évènement étudié est le décès, \(S(t)\) représente la probabilité d’être encore “vivant” en \(t\).
\(S\) est une fonction non croissante, avec \(S(0)=1\).
La fonction de survie estimée peut rester au-dessus de \(0\) à la fin du suivi, même si l’évènement finit par survenir pour tous les sujets (par la censure à droite).
-
La seconde fonction est la fonction de risque instantané \(\alpha(t)\). Pour la définir, nous avons besoin de la fonction de densité de probabilité \(f(t)\) : \[ f(t) = \lim_{\Delta t \rightarrow 0^{+}}\frac{\mathbb{P}(t \leq T < t + \Delta t)}{\Delta t} \] Pour un petit intervalle de durée \(\Delta t\), \(f(t)\Delta t\) approche la probabilité que l’évènement survienne entre \(t\) et \(t+\Delta t\).
Cependant, elle ne prend pas en compte le fait que le sujet soit toujours à risque en \(t\) (voir Section 2.4). La fonction de risque instantané \(\alpha(t)\) affine alors cette idée, en ne considérant que les sujets encore à risque en \(t\) : \[ \alpha(t) = \lim_{\Delta t \rightarrow 0^{+}}\frac{\mathbb{P}(t \leq T < t + \Delta t | T \geq t )}{\Delta t} \] Pour un petit \(\Delta t\), \(\alpha(t)\Delta t\) approche la probabilité de présenter l’évènement dans cet intervalle, conditionnellement au fait d’être encore sans évènement en \(t\). Le risque instantané est un taux, exprimé dans l’inverse de l’unité de temps, et non une probabilité : il peut donc dépasser \(1\). On a \(\alpha(t)=f(t)/S(t)\) lorsque \(S(t)>0\).
On a appelé \(\alpha(t)\) la fonction de risque instantané, mais elle est aussi appelée hazard function et se note aussi souvent \(\lambda(t)\).