1 Vers notre premier modèle de régression
Pour rester le plus abordable possible, nous proposons dans un premier temps de nous concentrer sur les bases de l’analyse de régression au travers de la régression linéaire simple.
Si vous comprenez bien cette première section, alors la suivante sur la régression linéaire multiple devrait être plus abordable !
1.1 Écrire le modèle
En régression linéaire simple, on cherche à modéliser la valeur moyenne de la variable réponse \(Y\) en fonction d’une seule variable explicative \(X\).
Le mot “régression” nous vient des travaux de Francis Galton : en 1886, il décrit comment la taille moyenne des enfants de parents très grands ou très petits est moins éloignée de la moyenne que celle de leurs parents (Galton 1886). Le terme a ensuite été conservé pour des modèles bien plus généraux.
L’opérateur “\(\mathbb E\)” correspond à l’espérance : voyez cela comme une moyenne. On parle de moyenne “conditionnelle”, car on modélise la moyenne de \(Y\) dans la population conditionnellement à une valeur \(x\), modélisée à partir des observations disponibles (p. ex., la moyenne chez les femmes).
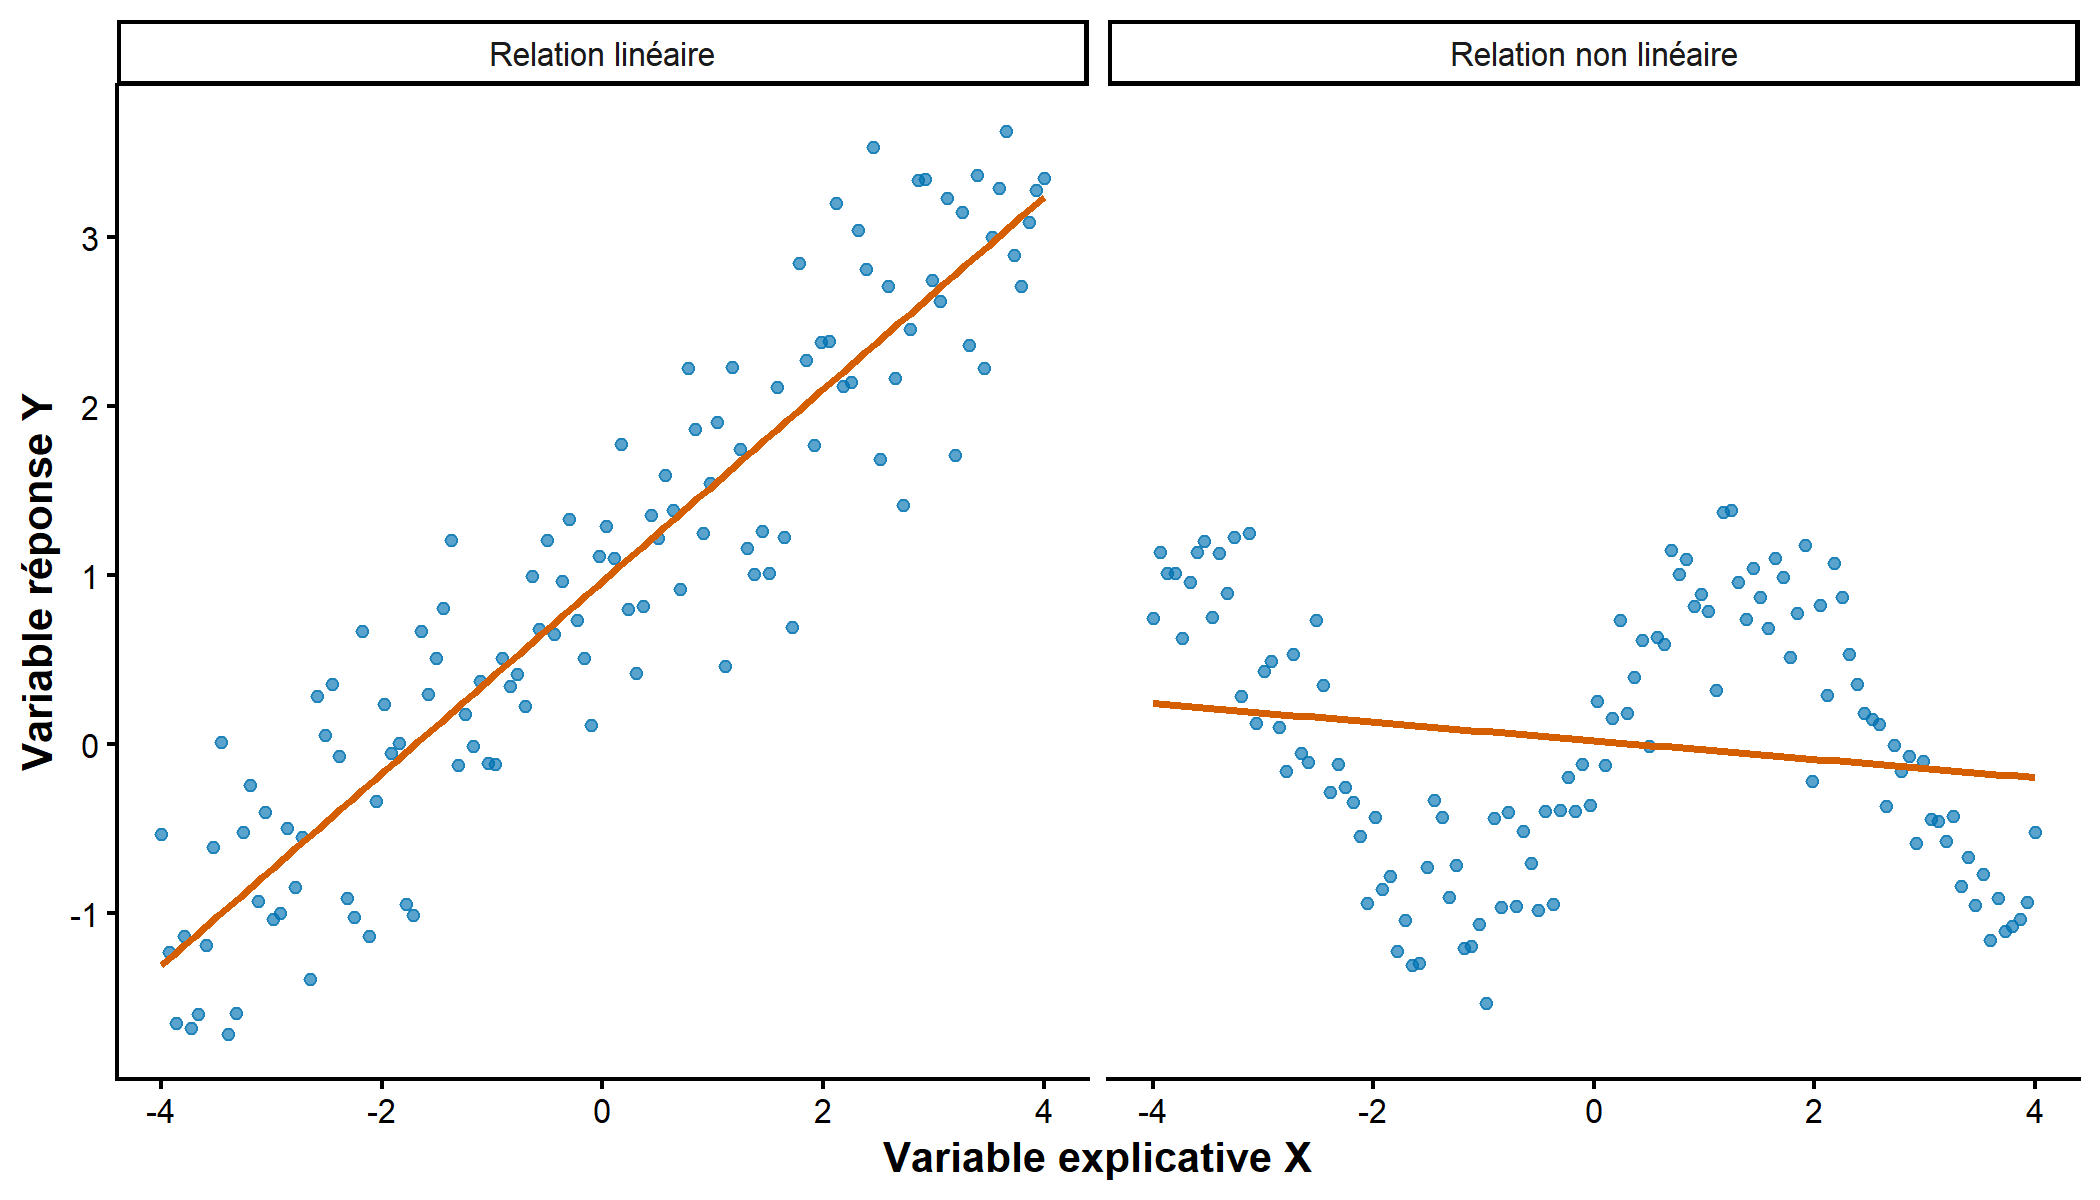
Le modèle simple présenté ici suppose que la moyenne de \(Y\) varie selon une droite en fonction de \(X\). Avant de l’utiliser, il est donc utile de vérifier graphiquement si cette forme semble adaptée. En Figure 1, nous présentons deux exemples (exagérés) : une relation linéaire (à gauche) et non linéaire (à droite).
En réalité, on ment un peu ici. A des fins de simplifications, on considère ici des tendances en “forme de droite” pour nos modèles. En réalité, “linéaire” dans “modèle de régression linéaire” se réfère à la linéarité en ses coefficients. En utilisant des fonctions de \(X\), comme des splines ou des polynômes fractionnaires, on peut modéliser une relation courbe tout en restant dans le cadre de la régression linéaire. Ces approches seront abordées dans un cours en construction.
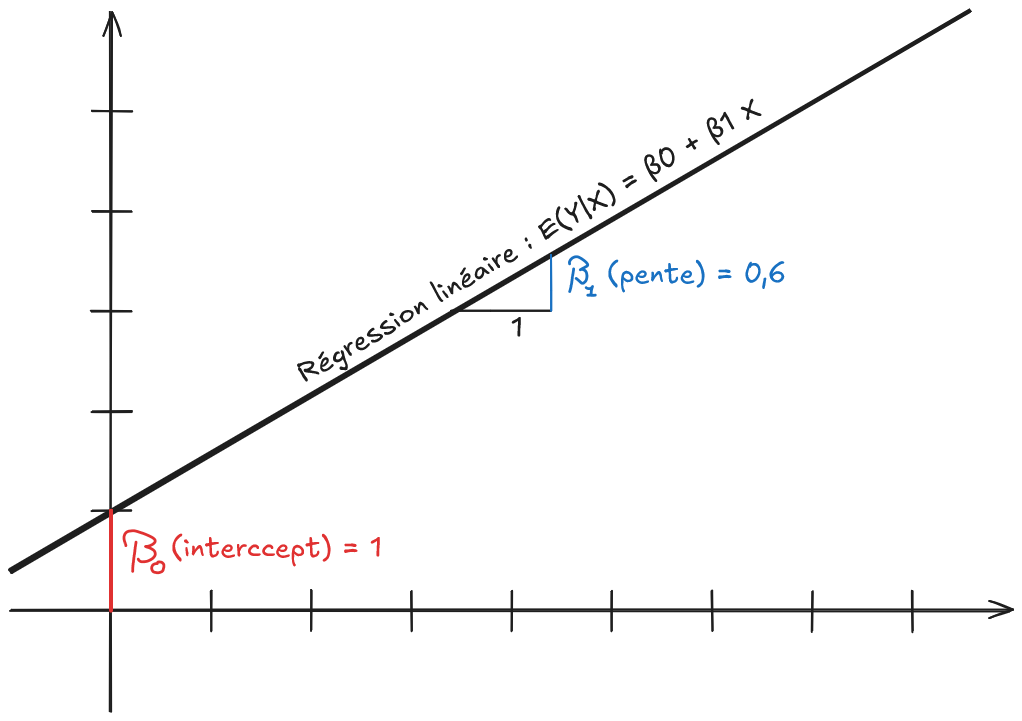
En régression linéaire simple, on suppose que cette moyenne conditionnelle est une droite : \[ \mathbb E(Y\mid X=x)=\beta_0+\beta_1x, \] où \(\beta_0\) est l’intercept et \(\beta_1\) la pente. On peut aussi écrire ce modèle, au niveau “individuel” : \[ Y_i=\beta_0+\beta_1X_i+\varepsilon_i, \; \boldsymbol\varepsilon\mid\mathbf X\sim \mathcal N_n(\mathbf 0,\sigma^2\mathbf I_n) \] où \(\varepsilon_i\) est un terme d’erreur (englobant tout ce que le modèle n’arrive pas à expliquer).
1.2 Interpréter les coefficients
Dans le modèle simple précédent : \[ \mathbb E(Y\mid X=x)=\beta_0+\beta_1x, \]
- \(\beta_0\) est l’intercept : c’est la moyenne attendue de \(Y\) lorsque \(X=0\).
- \(\beta_1\) est la pente : c’est la variation moyenne de \(Y\) associée à une augmentation d’une unité de \(X\). C’est ce coefficient qui quantifie l’association entre \(X\) et \(Y\).
Mathématiquement, “l’augmentation d’une unité” vient de : \[ \mathbb E(Y\mid X=x+1)-\mathbb E(Y\mid X=x)= (\beta_0+\beta_1(x+1)) - (\beta_0+\beta_1x) = \beta_1 \]
Suivant la nature de la variable explicative \(X\), l’interprétation de \(\beta_1\) peut être différente :
- Pour une variable explicative quantitative, \(\beta_1\) est la variation moyenne de \(Y\) associée à une augmentation d’une unité de \(X\) (p. ex., par an, par livre, par mg/dL …).
- Pour une variable explicative binaire, \(\beta_1\) est la différence moyenne de \(Y\) entre les deux groupes (p. ex., fumeuse vs non-fumeuse, homme vs femme, …).
Avertissement
- L’intercept n’est pas toujours interprétable. Si \(X\) est l’âge maternel, \(X=0\) ne correspond pas à une situation clinique possible dans l’échantillon.
- Un moyen de rendre l’intercept plus interprétable est de centrer la variable explicative autour d’une valeur de référence (p. ex., moyenne, médiane …).
Centrer, c’est soustraire cette valeur de référence à chaque observation (p. ex.,
AGE_centre = AGE - 25). On en reparle en section 2.3.
1.3 Calculer nos intervalles de confiance
Quand on estime un modèle de régression, on obtiendra plusieurs informations. Parmi elles, une estimation \(\widehat\beta_j\) de notre coefficient, ainsi que son erreur standard \(SE(\widehat\beta_j)\).
\(SE\) pour “standard error” en anglais
Avec ces deux quantités, on va pouvoir faire deux choses. La première : construire un intervalle de confiance pour le coefficient. Au niveau de confiance de \(100(1-\alpha)\,\%\), on peut écrire : \[ \text{IC}_{100(1-\alpha)\%}(\beta_j) = \left[\widehat\beta_j - t_{1-\alpha/2,n-2}\times SE(\widehat\beta_j) \, ; \, \widehat\beta_j + t_{1-\alpha/2,n-2}\times SE(\widehat\beta_j)\right] \]
Note
Pour un test bilatéral au risque \(\alpha = 5 \%\), si l’IC 95 % d’un coefficient contient 0, alors le test correspondant n’est pas significatif au seuil de 5 %.
Avertissement
Pour un même modèle, un test bilatéral au seuil de 5 % et l’IC 95 % associé donnent la même conclusion. L’intervalle est même plus informatif : il renseigne aussi sur l’amplitude de l’association et sa précision.
1.4 Tester nos hypothèses
La seconde : tester si notre coefficient est significativement différent de zéro, via le test t. On pose : \[ H_0:\beta_j=0 \;\text{vs.}\; H_1^{\text{bilatéral}}:\beta_j\neq0 \]
Comme dans le chapitre précédent, on peut aussi tester un effet dans un sens particulier (unilatéral) ; auquel cas on écrirait “\(\beta_j>0\)” ou “\(\beta_j<0\)” pour l’hypothèse alternative.
Sous \(H_0\), la statistique de test est alors : \[ T=\frac{\widehat\beta_j}{SE(\widehat\beta_j)} \underset{H_0}{\sim} \text{Student}_{n-2} \] Comme dans le chapitre précédent, on conclura au rejet de \(H_0\) si la statistique de test est dans la région critique. Pour notre test bilatéral au risque \(\alpha\), on rejette \(H_0\) si : \[ |T| > t_{1-\alpha/2,n-2} \]
\(n-2\) degrés de liberté, car deux paramètres sont estimés : l’intercept et la pente.
1.5 Deux exemples
1.5.1 Association âge - poids de naissance
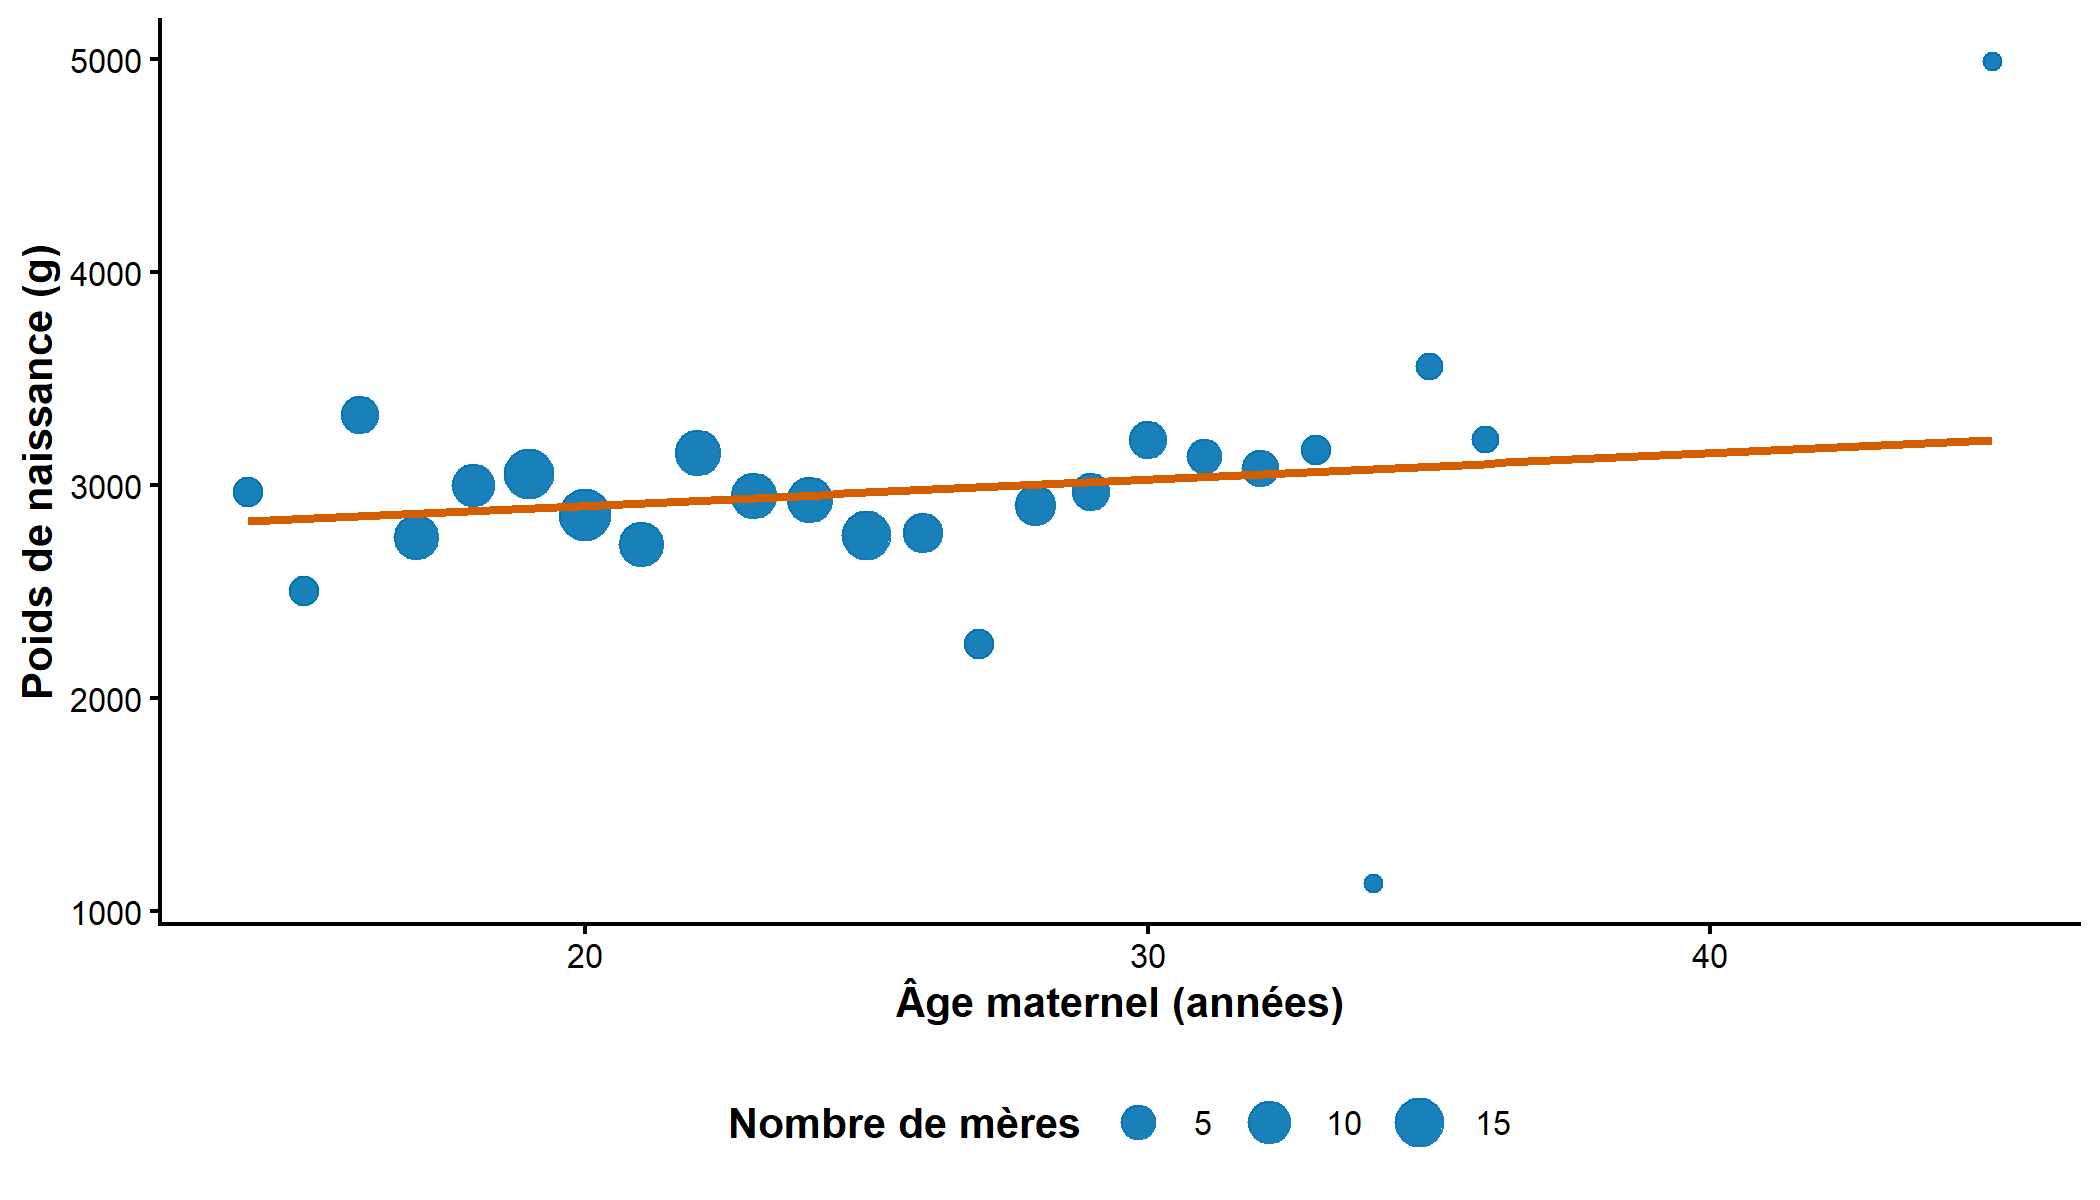
On souhaite modéliser le lien entre l’âge maternel et le poids de naissance. On peut déjà visualiser la situation avec un tableau, afin d’observer les poids moyens par âge.
| Âge (années) | n | Moyenne (g) | Écart-type (g) |
|---|---|---|---|
| 14 | 3 | 2 967,33 | 843,34 |
| 15 | 3 | 2 504,00 | 237,70 |
| \(\vdots\) | |||
| 36 | 2 | 3 218,00 | 540,23 |
| 45 | 1 | 4 990,00 |
L’écart-type n’est pas défini à 45 ans, car il n’y a qu’une seule observation.
Ainsi, même si la moyenne conditionnelle était parfaitement linéaire, les moyennes observées par âge ne seraient pas exactement alignées : c’est surtout la tendance qui nous intéresse. La Figure 3 permet de visualiser cette tendance, et l’on voit bien qu’on a une différence entre les moyennes observées et la droite de régression estimée sur les données individuelles.
Maintenant, place à la modélisation ! Notre modèle s’écrit : \[ \mathbb{E}(\mathrm{BWT}\mid \mathrm{AGE}=x)=\beta_0+\beta_1x \] Ici,
- \(\beta_0\) correspond au poids de naissance moyen pour une mère d’âge 0 (ce qui n’est pas interprétable)
- \(\beta_1\) correspond à la variation moyenne associée à une année supplémentaire d’âge maternel. Cette association peut être positive (\(\beta_1 > 0\)) ou négative (\(\beta_1 < 0\)).
Voici ce qu’on obtient après avoir estimé notre modèle sur nos données :
| Terme | Estimation | Erreur standard | t | p-valeur | IC 95 % |
|---|---|---|---|---|---|
| Intercept | 2 657,33 | 238,80 | 11,13 | < 0,001 | [2 186,2 ; 3 128,4] |
| Âge maternel (par an) | 12,36 | 10,02 | 1,23 | 0,219 | [-7,4 ; 32,1] |
- Le poids moyen d’un bébé né d’une mère âgée de 0 an est estimé à 2 657,33 g. Ceci n’a pas de sens …
- Pour chaque année supplémentaire d’âge maternel, le poids de naissance moyen est estimé augmenter de 12,36 g (\(\text{IC}_{95\%} = [-7{,}4 \, ; \, 32{,}1]\) g).
En testant si l’association est significativement différente de zéro, on a : \[ t = \frac{12{,}36}{10{,}02} = 1{,}23 \] Avec \(n-2=187\) degrés de liberté, on rejette \(H_0\) à 5 % si \(|T|>1{,}97\). Comme \(|T|=1{,}23<1{,}97\), on ne rejette pas \(H_0\) : l’augmentation moyenne de 12,36 g/an n’est pas significativement différente de zéro au seuil de 5 %.
Ceci est par ailleurs cohérent avec l’IC 95 % qui contient 0.
Note
Ne pas rejeter \(H_0\) ne PROUVE PAS que l’association est inexistante dans la vraie vie (réciproquement pour le rejet). C’est pour cela qu’on doit répliquer les études !
Notons qu’on peut aussi tester \(\beta_0\) (l’intercept) : ici, on rejette \(H_0\) car la moyenne attendue pour une mère d’âge 0 est significativement différente de zéro.
Note
- Tester l’intercept PEUT être intéressant, s’il est au moins interprétable. Dans notre exemple, l’âge maternel ne peut pas être égal à 0, donc ce test n’a pas de sens…
- Même avec du “sens”, il est rarement intéressant de tester l’intercept, car il ne renseigne pas sur l’association entre la variable explicative et la variable réponse !
1.5.2 Association tabagisme - poids de naissance
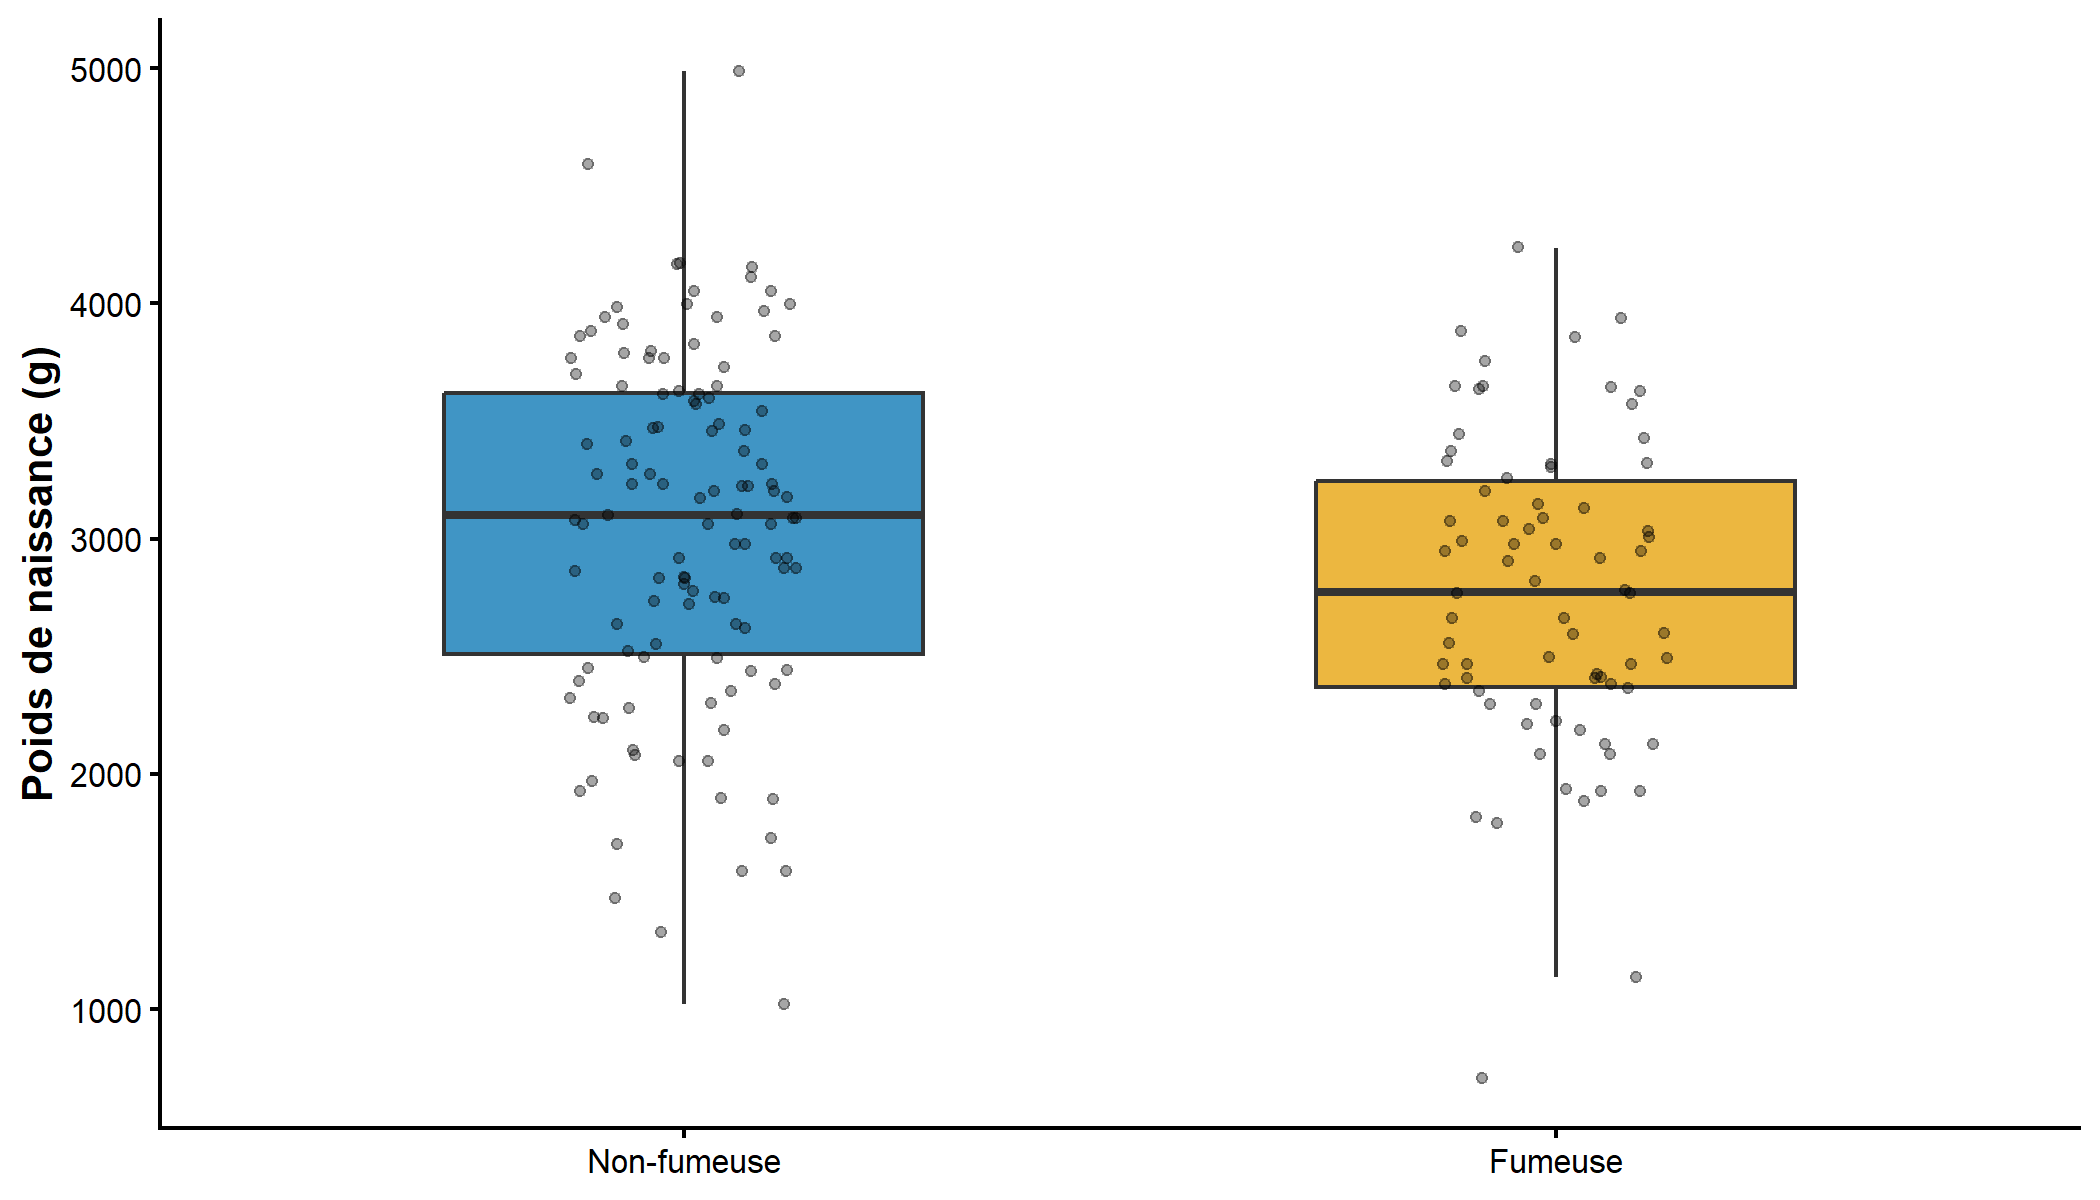
Comme précédemment, on peut d’abord visualiser à l’aide d’un tableau et d’une figure les poids moyens observés selon le statut tabagique maternel.
| Statut tabagique | n | Moyenne (g) | Écart-type (g) |
|---|---|---|---|
| Non-fumeuse | 115 | 3 054,96 | 752,41 |
| Fumeuse | 74 | 2 773,24 | 660,08 |
Le poids moyen de naissance chez les enfants de mères non-fumeuses est de 3 054,96 g, et semble plus faible de 281,71 g chez les enfants de mères fumeuses. Contrairement à avant, on ne peut pas faire un nuage de points pour visualiser la potentielle relation. Cependant, on peut quand même faire un boxplot, comme montré en Figure 4.
Dans ce cas, le modèle s’écrit : \[ \mathbb E(\mathrm{BWT}\mid \mathrm{SMOKE}=x)=\beta_0+\beta_1x \]
- \(\beta_0\) est la moyenne attendue quand \(X=0\), donc chez les enfants de mères non-fumeuses ;
- \(\beta_0+\beta_1\) est la moyenne attendue quand \(X=1\), donc chez les enfants de mères fumeuses ;
- \(\beta_1\) est alors la différence de moyennes entre les deux groupes.
| Terme | Estimation | Erreur standard | t | p-valeur | IC 95 % |
|---|---|---|---|---|---|
| Intercept | 3 054,96 | 66,93 | 45,64 | < 0,001 | [2 922,9 ; 3 187,0] |
| Tabagisme (Oui vs. non) | -281,71 | 106,97 | -2,63 | 0,009 | [-492,7 ; -70,7] |
On a \(\widehat\beta_0=3\,054{,}96\) g et \(\widehat\beta_1=-281{,}71\) g. D’après l’estimation de la pente, le poids moyen de naissance est estimé inférieur de 281,71 g chez les enfants de mères fumeuses que chez les enfants de mères non fumeuses (IC 95 % = [-492,7 ; -70,7] g). Le test t associé donne \(p=0{,}009\) : cette différence est significativement différente de zéro au seuil de 5 %.
Tiens tiens tiens ! Tout ça me rappelle les résultats du Tableau 3…
Note
Tester \(\beta_1\) dans un modèle de régression linéaire avec une variable explicative binaire est équivalent au test de Student à variances supposées égales vu en section “Comparaisons de moyennes” du chapitre Tests statistiques !
Les références
Galton, Francis. 1886. « Regression towards Mediocrity in Hereditary Stature ». The Journal of the Anthropological Institute of Great Britain and Ireland 15: 246‑63. https://doi.org/10.2307/2841583.