7 Pour aller plus loin
7.1 Exemple de Kaplan-Meier avec entrée retardée
Reprenons l’exemple de la section 3, mais avec l’âge comme échelle de temps. Le calcul suit le même principe : on trie les données par âge d’entrée, puis on estime la fonction de survie. Voici l’âge d’entrée, l’âge de sortie et le statut du sous-échantillon précédent, trié par l’âge d’entrée :
| Sujet | Âge à l’entrée | Âge à la sortie | Statut |
|---|---|---|---|
| 118 | 32,59 | 33,29 | 1 |
| 515 | 32,70 | 34,84 | 0 |
| 532 | 33,15 | 35,49 | 0 |
| 294 | 33,20 | 34,35 | 1 |
| 314 | 33,20 | 34,41 | 1 |
| 235 | 33,52 | 34,52 | 1 |
| 252 | 33,72 | 34,75 | 0 |
| 261 | 33,87 | 34,93 | 0 |
| 550 | 33,89 | 36,55 | 0 |
| 542 | 34,08 | 36,63 | 0 |
| 206 | 34,13 | 35,06 | 0 |
| 40 | 35,70 | 36,05 | 1 |
| 156 | 35,84 | 36,66 | 0 |
| 89 | 35,87 | 36,48 | 0 |
| 32 | 35,94 | 36,25 | 1 |
On peut alors calculer l’effectif à risque à chaque temps d’évènement :
| Âge de toxoplasmose | Sujets | Effectif à risque |
|---|---|---|
| 33,29 | 118, 294, 314, 515, 532 | 5 |
| 34,35 | 206, 235, 252, 261, 294, 314, 515, 532, 542, 550 | 10 |
| 34,41 | 206, 235, 252, 261, 314, 515, 532, 542, 550 | 9 |
| 34,52 | 206, 235, 252, 261, 515, 532, 542, 550 | 8 |
| 36,05 | 32, 40, 89, 156, 542, 550 | 6 |
| 36,25 | 32, 89, 156, 542, 550 | 5 |
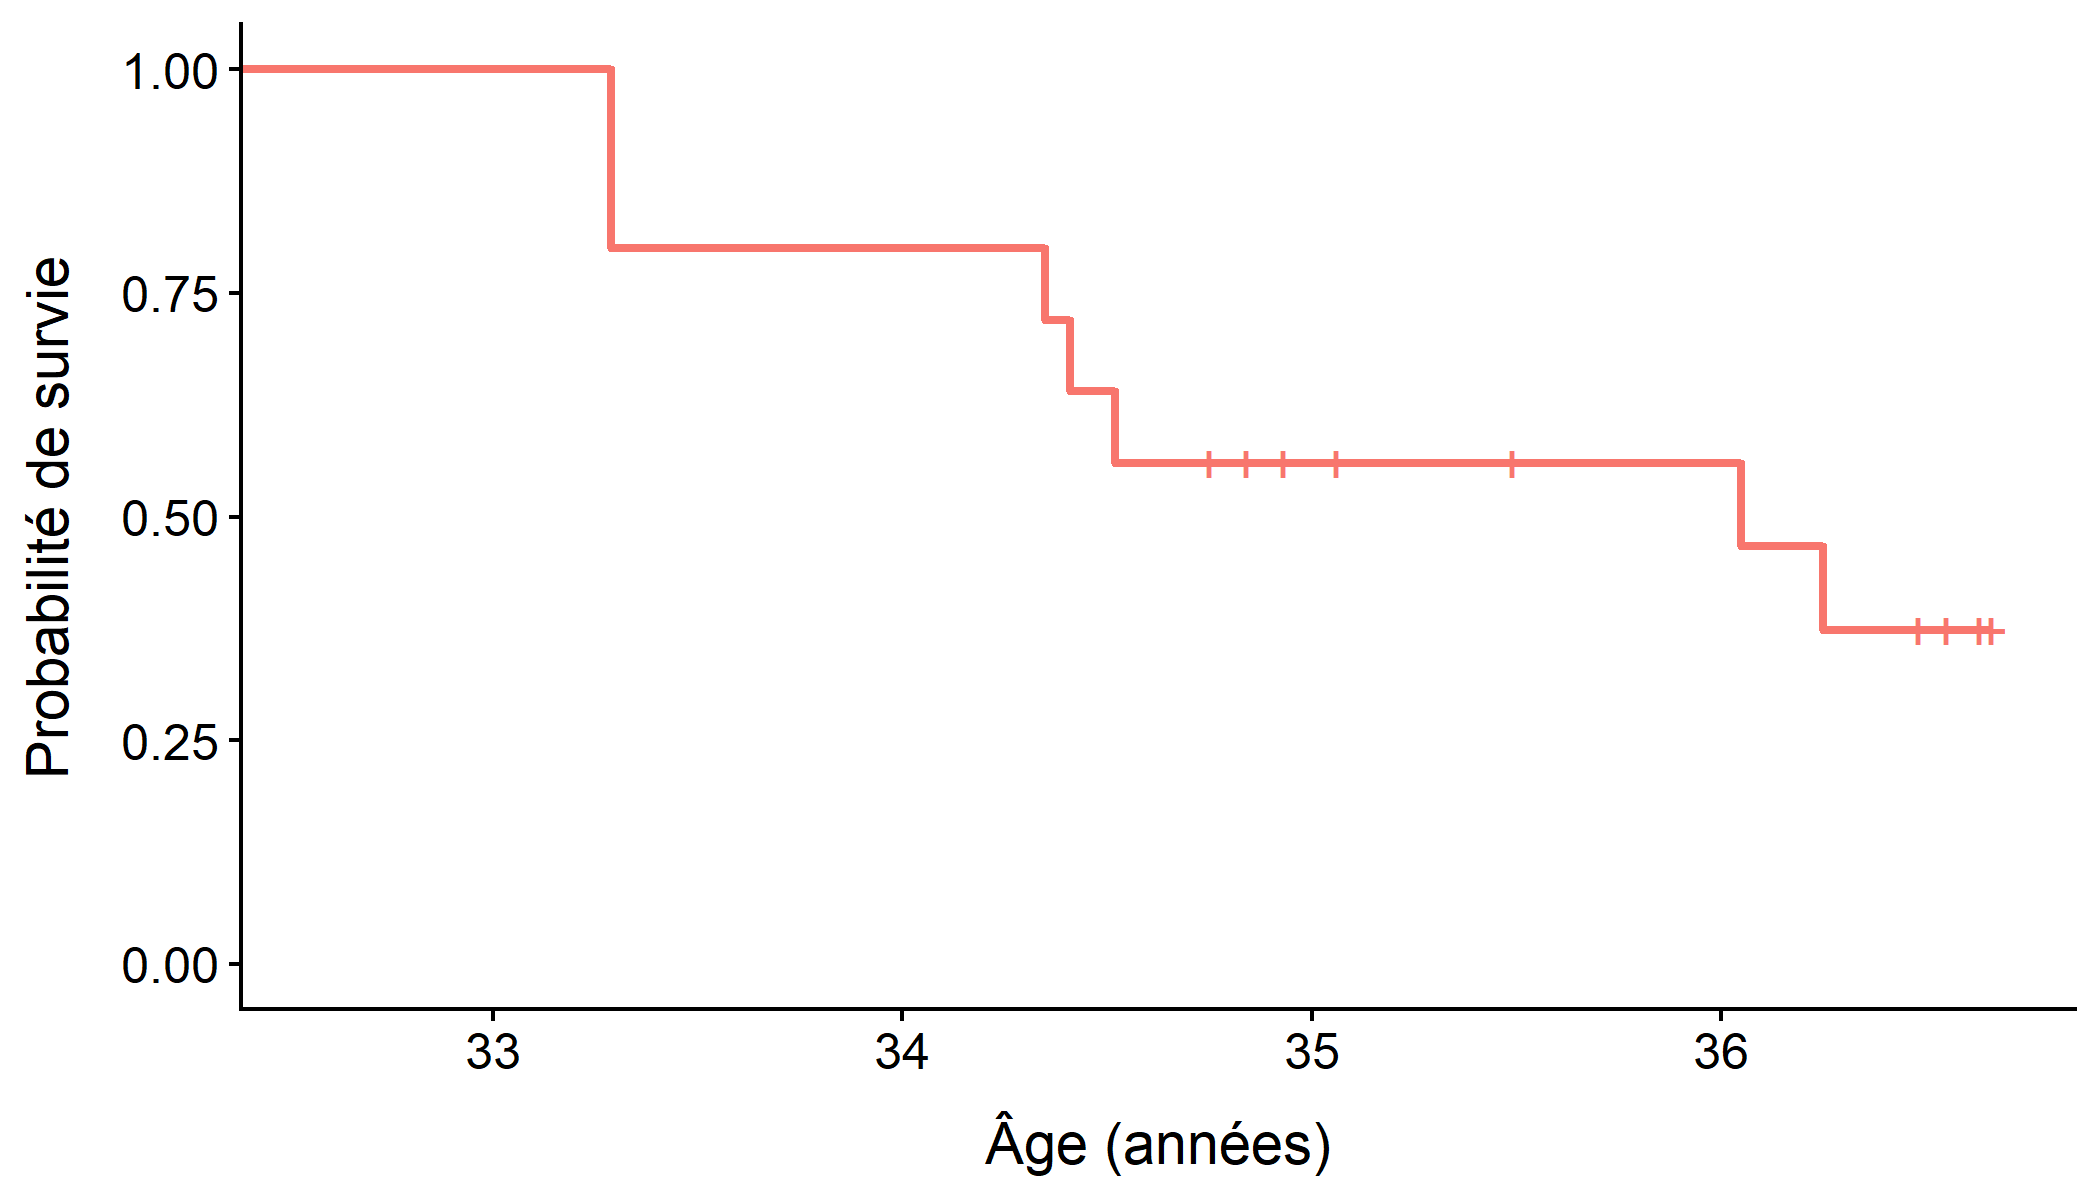
Une fois que l’on connaît les effectifs à risque à chaque temps d’évènement, on peut calculer notre estimateur de Kaplan-Meier comme précédemment. Contrairement à avant, la première ligne n’est pas forcément à \(t=0\). En effet, tout temps avant \(t=33,29\) n’est pas observable, donc la fonction de survie estimée vaut 1 avant ce temps.
| Âge de toxoplasmose | Nombre d’évènements | Effectifs à risque | Probabilité conditionnelle | Survie estimée |
|---|---|---|---|---|
| \(t_j\) | \(d_j\) | \(n_j\) | \((n_j-d_j)/n_j\) | \(\hat{S}(t_j)\) |
| 33 | 0 | 5 | 1,000 | 1,000 |
| 33,29 | 1 | 5 | 0,800 | 0,800 |
| 34,35 | 1 | 10 | 0,900 | 0,720 |
| 34,41 | 1 | 9 | 0,889 | 0,640 |
| 34,52 | 1 | 8 | 0,875 | 0,560 |
| 36,05 | 1 | 6 | 0,833 | 0,467 |
| 36,25 | 1 | 5 | 0,800 | 0,373 |
Conditionnellement au fait de ne pas avoir eu de toxoplasmose avant l’âge d’entrée, la probabilité estimée de rester sans toxoplasmose jusqu’à 36,25 ans est de 0,373. La médiane de survie estimée est donc de 36,05 ans. On peut aussi tracer la courbe de survie sans toxoplasmose estimée avec l’âge comme échelle de temps, en tenant compte de l’entrée retardée des sujets :
7.2 Détails sur le test du log-rank
On l’a dit, le test du log-rank compare, à chaque temps d’évènement, le nombre d’évènements observés dans chaque groupe au nombre attendu sous l’hypothèse \(\text{H}_0 : S_1(t) = S_2(t) \forall t\) et \(\text{H}_1 : \exists t \quad S_1(t) \neq S_2(t)\).
Notons \(t_1 < \dots < t_k\) l’ensemble des temps d’évènements des deux groupes réunis, classés par ordre croissant. Soient \(d_{lj}\) le nombre d’évènements observés en \(t_j\) dans le groupe \(l\) (avec \(l=1,2\)), \(d_j\) le nombre total d’évènements observés en \(t_j\) et \(n_{lj}\) le nombre de sujets à risque en \(t_j\) dans le groupe \(l\) avec \(n_j=n_{1j}+n_{2j}\).
Connaissant le nombre d’évènements observés à chaque temps \(t_j\), on cherche à déterminer combien seraient attendus dans chaque groupe sous l’hypothèse nulle. Pour cela, on construit, à chaque temps d’évènement, le tableau de contingence suivant :
| Évènement en \(t_j\) | Pas d’évènement en \(t_j\) | Effectif à risque juste avant \(t_j\) | |
|---|---|---|---|
| Groupe 1 | \(d_{1j}\) | \(n_{1j}-d_{1j}\) | \(n_{1j}\) |
| Groupe 2 | \(d_{2j}\) | \(n_{2j}-d_{2j}\) | \(n_{2j}\) |
| Ensemble | \(d_j\) | \(n_j-d_j\) | \(n_j\) |
Il y a donc un tableau de contingence pour chaque temps d’évènement. Sous \(H_0\), conditionnellement aux effectifs à risque et au nombre total \(d_j\) d’évènements, le nombre observé \(d_{lj}\) suit une loi hypergéométrique. Son espérance, c’est-à-dire le nombre attendu, est : \[ e_{lj}=n_{lj}\frac{d_j}{n_j} \]
La variance de cette variable aléatoire, commune aux deux groupes, est la suivante : \[ v_j=\frac{d_j(n_j-d_j)n_{1j}n_{2j}}{n^2_j(n_j-1)} \]
Cette expression s’applique pour \(n_j>1\). Si un seul sujet reste à risque, ce temps n’apporte pas d’information pour comparer les groupes et sa contribution à la variance est nulle
Le log-rank additionne alors les écarts observé-attendu sur les temps d’évènement. Pour deux groupes indépendants, sous censure non informative dans chacun des groupes et avec suffisamment d’évènements, la statistique suivante suit asymptotiquement sous \(H_0\) une loi du \(\chi^2\) à 1 degré de liberté : \[ X^2=\frac{\Bigl( \sum_{j=1}^k d_{1j} - \sum_{j=1}^k e_{1j} \Bigr)^2}{\sum_{j=1}^k v_{j}} \]
Ici, la statistique est calculée avec le groupe 1 ; mais elle peut s’obtenir de manière équivalente avec le groupe 2 : \[ X^2=\frac{\Bigl( \sum_{j=1}^k d_{2j} - \sum_{j=1}^k e_{2j} \Bigr)^2}{\sum_{j=1}^k v_{j}} \]
7.3 Variables explicatives dépendantes du temps
Le modèle de Cox suppose que les variables explicatives soient mesurées à l’inclusion et fixes dans le temps. On pourrait être intéressé d’inclure dans la dépendance de la fonction de risque, des variables recueillies au cours du suivi et donc dépendantes du temps. Ainsi le modèle pourrait s’écrire ainsi pour un ensemble de variables explicatives dont certaines sont dépendantes du temps : \[ \alpha(t) = \alpha_0(t) \exp(\beta^\top X(t)) \]
L’estimation des paramètres par la vraisemblance partielle nécessite de connaître la valeur des variables explicatives pour tous les sujets à risque en chaque temps d’évènement (ce qui sera rarement le cas sur données réelles). Si ce n’est pas le cas, les données manquantes doivent être “imputées” (on remplace la valeur manquante par une valeur calculée) et impliquent de nouvelles hypothèses sur la distribution de ces données. Également, l’interprétation des HR est rendue plus complexe, ainsi que l’adéquation dont les tests ne sont plus valables sur des variables dépendantes du temps.
Enfin, dernier problème, mais pas des moindres, une variable dépendante du temps doit être exogène. C’est-à-dire, que son évolution au cours du temps ne doit en aucun cas être influencée par la survenue d’un évènement (ou par un facteur qui modifie le risque de survenue de l’évènement). Ce qui sera faux dans une grande majorité des cas, en particulier pour les marqueurs biologiques prélevés sur un patient. On parlera alors de variables endogènes.
Plusieurs modèles ont été proposés pour répondre aux problèmes causés par l’introduction de variables endogènes dans la dépendance de la fonction de risque instantanée, en particulier la modélisation conjointe. Les modèles conjoints ont été développés pour étudier simultanément l’évolution de marqueurs longitudinaux (par régression linéaire notamment) et l’association de ces marqueurs au risque d’évènement (analyse de données de survie). De plus, leur conception permet de prendre en compte la sortie d’étude informative qui est un problème pour le modèle de Cox. Ces modèles sortent complètement du cadre de ce cours. Ils sont complexes, difficiles à interpréter et à estimer (en raison de leur charge computationnelle très élevée).
7.4 D’autres modèles en pagaille
Voici une liste non exhaustive de modèles exploitant également des données de survie :
- modèle de vie accélérée (ou accelerated failure time, AFT) : plutôt que de répondre à la question “par quel facteur le risque est-il multiplié”, on répond à la question “par quel facteur le temps jusqu’à l’évènement est-il multiplié”. Dans une étude, il pourrait arriver que l’on soit intéressé à l’idée d’étudier à quelle vitesse une maladie progresse en fonction de l’admission d’un traitement. C’est un modèle complètement paramétrique (il est nécessaire de spécifier la forme de \(\alpha_0(t)\) par une loi) qui est une bonne alternative au modèle de Cox lorsque l’hypothèse de proportionnalité des risques ne tient pas.
- modèle à risques additifs : contrairement au modèle de Cox, le modèle à risques additifs exprime la fonction de risque par une somme de la fonction risque de base avec une fonction de variables explicatives. Le modèle s’écrit : \(\alpha(t) = \alpha_0(t) + \beta(t)^\top X\). On ne fait pas d’hypothèse de proportionnalité des risques dans ce modèle. Par ailleurs, les coefficients de \(\beta\) sont dépendants du temps. Ce modèle peut être adapté aux situations où deux mécanismes de risques s’additionnent, par exemple dans une population avec un risque naturel plus un risque concomitant dû à une maladie.
- modèles à risques compétitifs : ces modèles sont utilisés quand il y a plusieurs évènements en compétition, la survenue d’un évènement en empêchant un autre. Dans beaucoup d’études, selon la population étudiée, il est possible qu’un sujet décède avant de développer l’évènement d’intérêt (comme une maladie). Pour répondre à ce problème, on modélise une fonction de risque instantanée par évènement possible.
- modèles à fragilité partagée : Parfois, le temps de survie peut être corrélé à l’appartenance d’un individu à un sous-groupe de la population d’étude (une famille, une zone géographique, etc.) ou une répétition d’un évènement de santé récurrent (une répétition de l’évènement au cours du suivi). Dans ce cas, ajuster la fonction de risque instantanée avec une variable indicatrice du groupe ou du nombre d’évènements déjà rencontrés serait possible. Cependant, procéder ainsi comporte plusieurs limites comme l’augmentation du nombre de paramètres avec le nombre de groupes ou la nécessité d’avoir au moins un évènement par groupe. De plus, modéliser ce type de données nécessite de tenir compte de la chronologie des évènements récurrents et de la dépendance entre ces mêmes évènements. Enfin, l’analyse de données avec évènements récurrents doit permettre de conserver un individu dans le modèle lorsque ce dernier subit un évènement, ce que ne fait pas le modèle de Cox. Les modèles à fragilité partagée sont une extension du modèle de Cox où l’on introduit une variable de fragilité \(u_i\) spécifique à chaque groupe \(i\) : \(\alpha_i(t) = u_i\alpha_0(t)\exp(\beta^\top X_i)\). Elle représente les facteurs de risque non observés (tout ce qui influence le risque sans être mesuré par les covariables) et communs à un même groupe. Par exemple certaines familles ont une prédisposition génétique à l’évènement d’intérêt ou un environnement commun (alimentation, exposition) qui n’est pas mesuré. La variable \(u_i\) permet de capturer cet effet.