2 Représentation par graphiques
Les graphiques complètent les tableaux et répondent à une question précise. Avant de les produire, il faut donc identifier (a minima) :
- le type de variable représentée : quantitative, qualitative nominale, qualitative ordinale ;
- l’objectif : décrire une distribution, comparer des groupes, visualiser une association ;
- l’échelle pertinente : effectifs, proportions, fréquences cumulées, valeurs brutes.
Dans ce cours, les figures sont construites avec ggplot2. Les couleurs proviennent de la palette “Okabe-Ito”, pensée pour rester lisible par les personnes daltoniennes. Pour que les figures restent aussi utilisables à l’impression, on évite les fonds colorés, les dégradés et les couleurs trop nombreuses ; lorsqu’une comparaison dépend de plusieurs groupes, la couleur est complétée par la position, la forme des points ou le type de ligne.
2.1 Règles de présentation des graphiques
Comme pour les tableaux, une figure scientifique doit pouvoir se comprendre sans avoir besoin de deviner ce qui a été représenté. Quelques règles générales :
-
Avoir un titre informatif, placé sous la figure.
Comme pour les tableaux, on doit préciser ce qui est représenté, la population ou l’échantillon étudié, la période et le lieu lorsque c’est pertinent.
Indiquer les unités de mesure sur les axes : âge (années), poids (kg), taille (cm), etc.
Nommer clairement les modalités des variables qualitatives. Les codes bruts du fichier de données (ex.
1,AA) ne doivent pas apparaître dans une figure destinée à être lue.Éviter les éléments qui ne portent pas d’information : fond coloré, quadrillage dense, ombres, effets de perspective, bordures décoratives.
L’axe portant les effectifs ou les proportions (généralement l’axe vertical) doit commencer à zéro (sinon, on pourrait exagérer les différences en “zoomant”) ;
Ne pas tronquer un axe quantitatif sans le préciser ;
Éviter les doubles axes verticaux. Ils sont souvent ambigus car deux échelles différentes sont affichées sur la même surface graphique.
Éviter les figures en 3D. Elles déforment les longueurs, les surfaces et les volumes, ce qui rend les comparaisons difficiles (et puis, entre nous, c’est laid).
Afficher les effectifs utiles, surtout quand on compare des proportions entre groupes.
Ne pas utiliser la couleur comme unique support d’information. Une figure importante doit rester interprétable en noir et blanc.
Note
Une figure n’est pas meilleure parce qu’elle est plus “sophistiquée” !!
2.2 Variables quantitatives
2.2.1 Nuage de points (ou scatter plot)
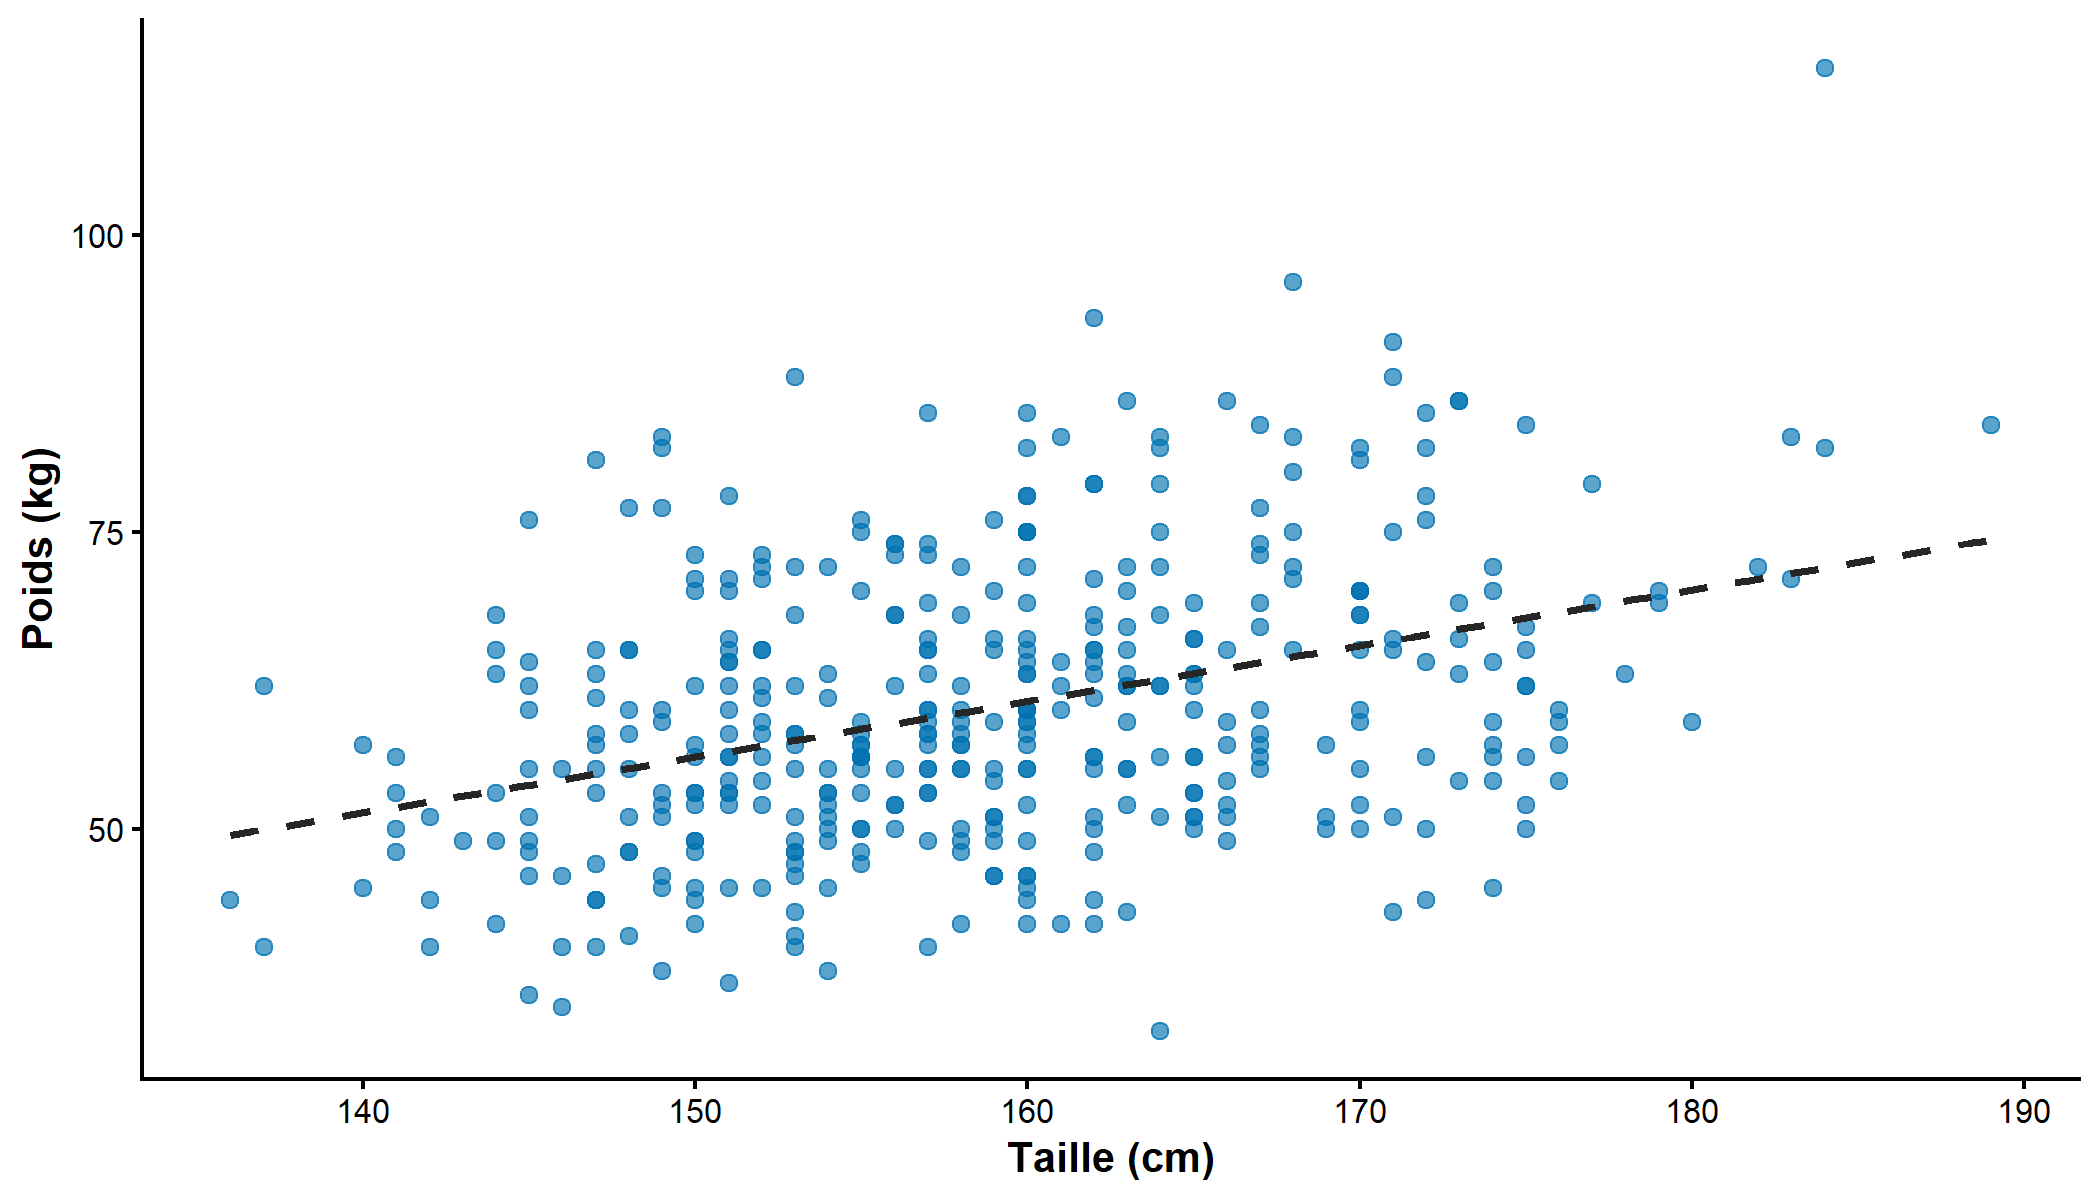
Le nuage de points est la première représentation à utiliser pour étudier la relation entre deux variables quantitatives. Chaque point représente une unité statistique. Sa position horizontale correspond à la valeur de la première variable et sa position verticale à la valeur de la seconde.
Il permet d’évaluer :
- la direction de l’association : positive, négative ou absente ;
- la forme de la relation : linéaire, courbe, seuil, plateau ;
- l’intensité de l’association ;
- la présence de valeurs atypiques ;
- l’hétéroscédasticité, c’est-à-dire une dispersion qui change selon le niveau de la variable en abscisse ;
- l’existence possible de sous-groupes.
Dans la Figure 1, les points ont tendance à monter lorsque la taille augmente : les sujets plus grands ont en moyenne un poids plus élevé. La dispersion reste cependant importante : deux sujets de même taille peuvent avoir des poids très différents. Le graphique suggère donc une association positive, mais pas une relation déterministe.
On peut accompagner le nuage de points d’un coefficient de corrélation pour quantifier une association linéaire (Pearson) ou monotone (Spearman) entre deux variables quantitatives. On en parle en section 4.1.
2.2.2 Histogramme
Un histogramme représente une variable quantitative continue ou une variable quantitative discrète prenant beaucoup de valeurs possibles. Les valeurs sont regroupées en intervalles, appelés classes. Chaque rectangle correspond à une classe.
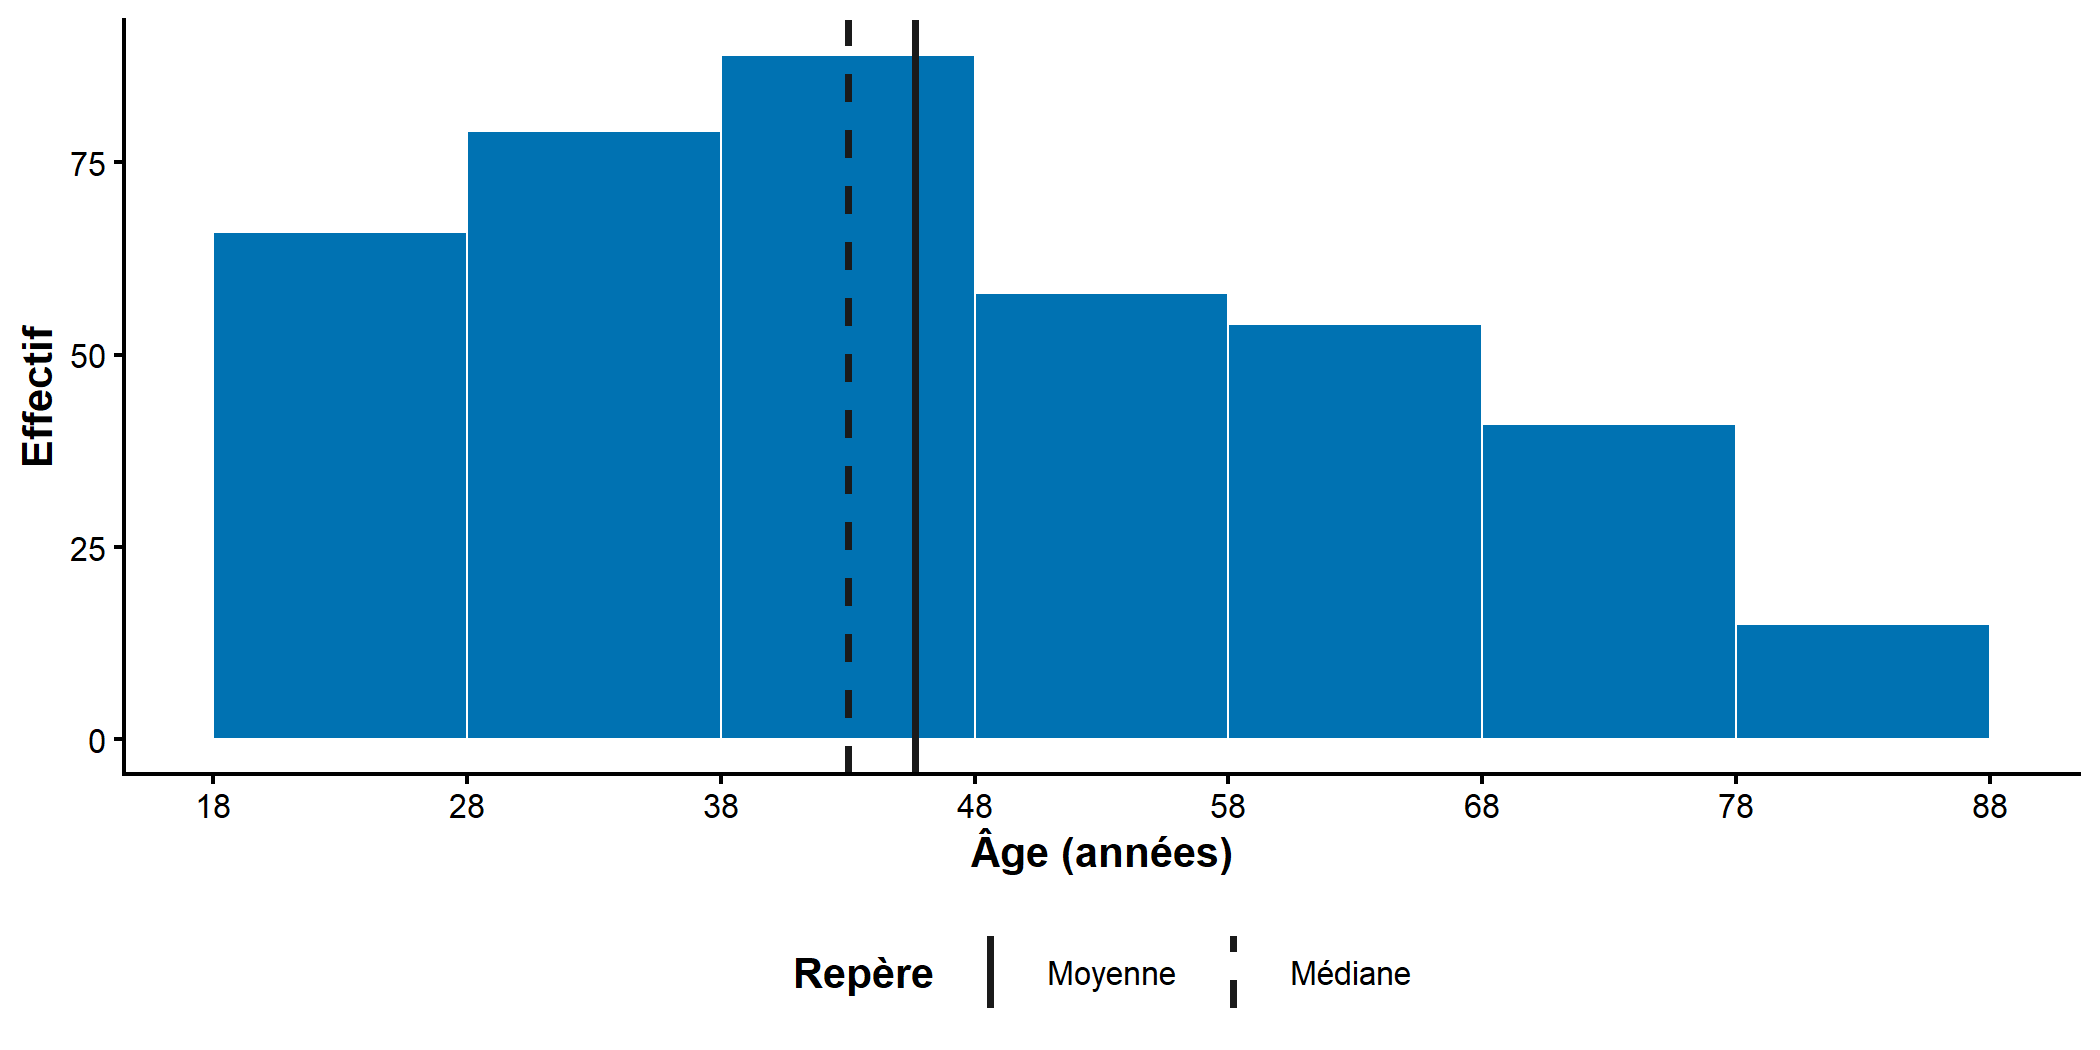
Le choix du nombre de classes influence fortement l’apparence de l’histogramme : trop larges, elles masquent la forme de la distribution ; trop fines, le graphique devient très bruité. Il faut donc choisir une largeur de classe adaptée à l’échelle de la variable et à l’effectif disponible.
En anglais, ces classes sont appelées “bins”.
Dans un histogramme, ce sont les aires des rectangles qui représentent les effectifs ou les fréquences. Si toutes les classes ont la même largeur, la hauteur est alors proportionnelle à l’effectif ou la fréquence de la classe. Le cas échéant, il est fréquent que la hauteur soit simplement l’effectif.
Mise en garde
Attention à ne pas confondre histogramme et diagramme en barres. Retenez que histogramme = valeurs continues (+ rectangles collés généralement), et que diagramme en barres = catégories distinctes (+ rectangles séparés généralement).
2.2.3 Boxplot (ou boîte à moustaches ou whisker plot)
Le boxplot résume la distribution d’une variable quantitative à partir de la médiane, des quartiles et des valeurs atypiques potentielles. Il est particulièrement utile pour comparer plusieurs groupes (voir section 3.3), mais peut aussi servir à décrire rapidement une seule variable quantitative.
Pour la petite histoire, John W. Tukey a popularisé la boîte à moustaches dans Exploratory Data Analysis (1977), un ouvrage de référence de l’analyse exploratoire (Tukey 1977).
La boîte s’étend du premier quartile \(Q_1\) au troisième quartile \(Q_3\). Le trait à l’intérieur de la boîte représente la médiane. L’intervalle interquartile vaut : \[ IQR = Q_3 - Q_1. \]
La convention la plus fréquente définit les limites internes comme : \[ L = Q_1 - 1{,}5 \times IQR \quad \text{et} \quad U = Q_3 + 1{,}5 \times IQR. \]
Les moustaches vont jusqu’aux observations les plus extrêmes qui restent entre \(L\) et \(U\). Les valeurs situées au-delà sont représentées par des points, comme représenté en Figure 3.
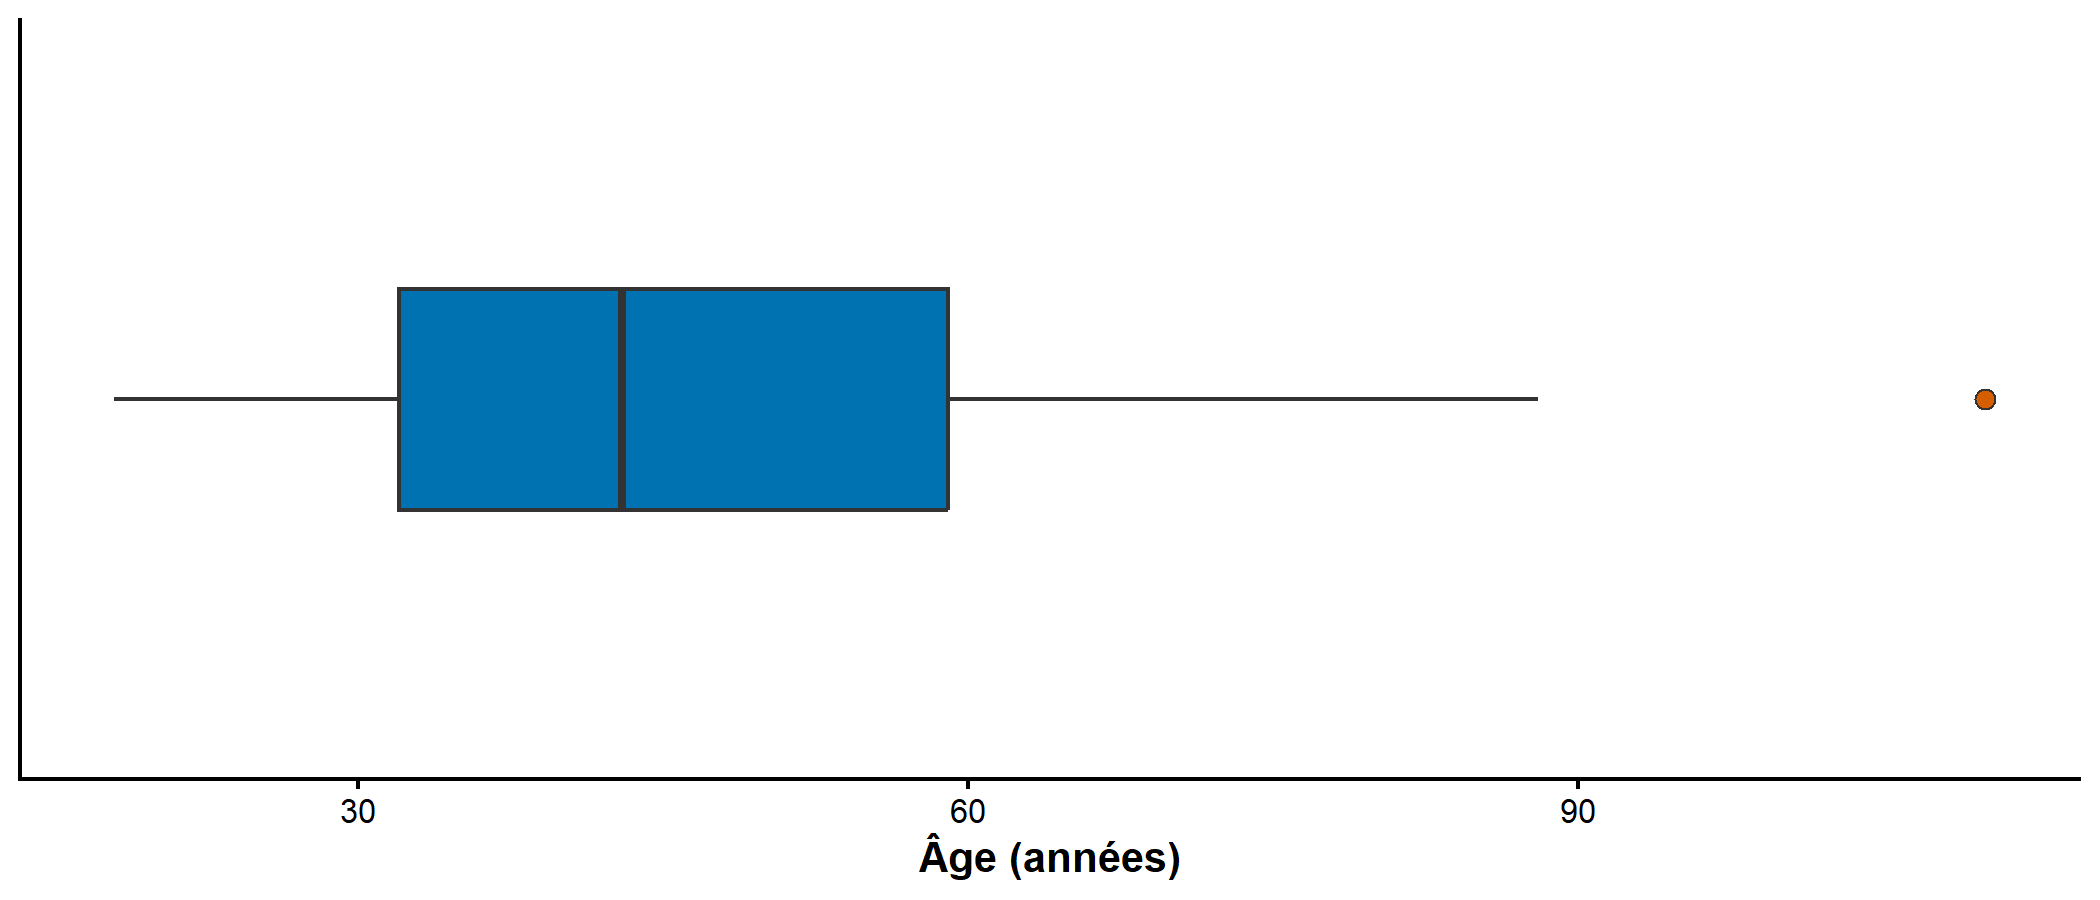
Ainsi, attention : les extrémités des moustaches d’un boxplot ne sont pas forcément le minimum et le maximum !
Aussi “excellent” soit-il, le boxplot ne renseigne pas entièrement sur la distribution (unimodale ? bimodale ?). Il est donc souvent utile de l’associer à un histogramme ou à des points individuels lorsque l’effectif est faible. Mon graphe préféré reste tout de même le raincloud plot ; cf. la figure du raincloud plot du chapitre Tests statistiques.
2.3 Variables qualitatives
2.3.1 Diagramme en barres
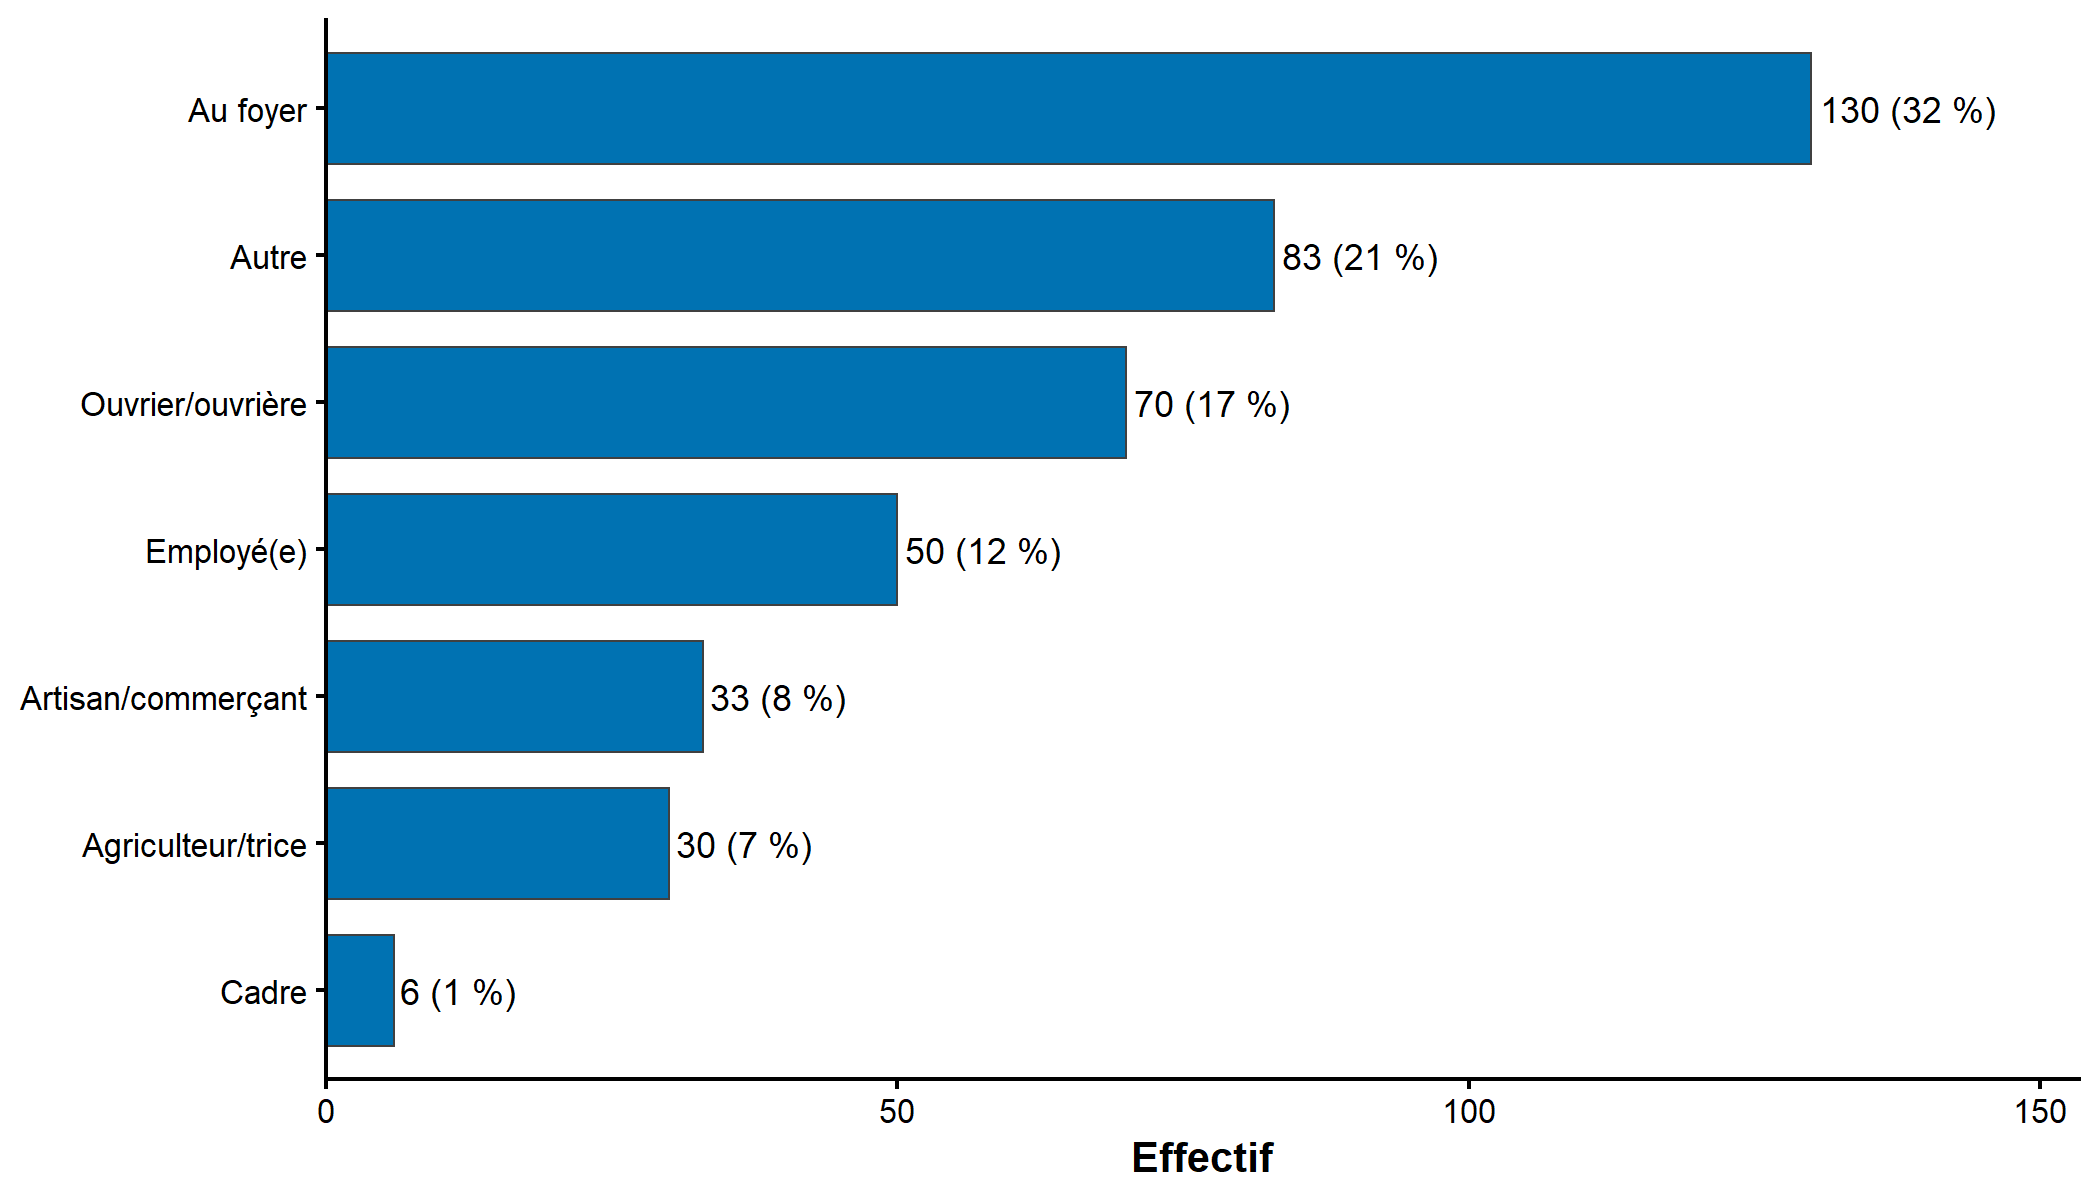
Pour une variable qualitative, le diagramme en barres est le plus lisible. Chaque barre représente une modalité et sa longueur correspond à l’effectif / proportion associée.
Les règles principales sont simples :
- pour une variable nominale, ordonner les modalités (p. ex., ordre alphabétique, effectif) ;
- pour une variable ordinale, conserver l’ordre naturel des modalités ;
- commencer l’axe des effectifs ou des proportions à zéro ;
- préférer des barres horizontales lorsque les noms des modalités sont longs ;
- afficher les effectifs lorsque cela aide à interpréter les proportions.
2.3.2 Diagramme circulaire / pie chart / diagramme en camembert
Le diagramme circulaire représente la distribution d’une variable qualitative en divisant un disque en secteurs proportionnels aux fréquences. Il peut être acceptable lorsqu’il y a très peu de modalités et que les différences sont importantes.
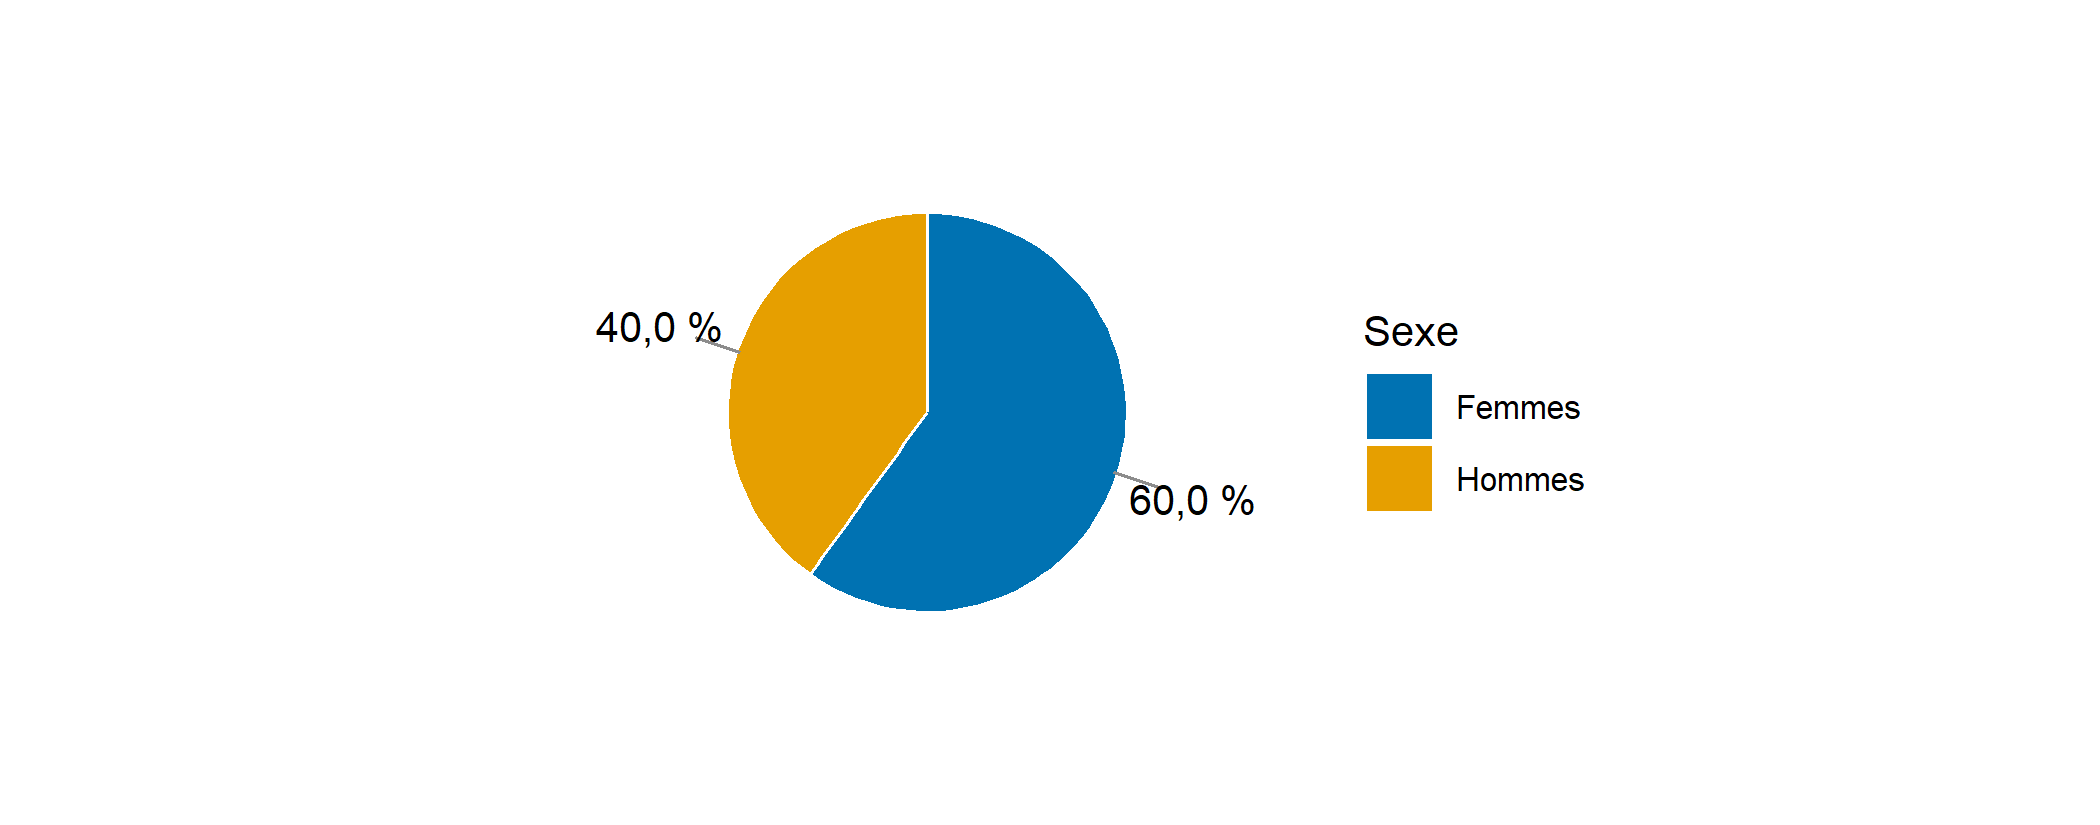
Avertissement
Les diagrammes circulaires sont souvent moins lisibles que les diagrammes en barres, surtout lorsque le nombre de modalités augmente ou que les proportions sont proches. Ils sont aussi peu adaptés aux variables ordinales, car l’ordre des modalités est plus difficile à percevoir sur un cercle.
En pratique, le diagramme en barres est presque toujours préférable : il est plus aisé de comparer des longueurs alignées que des angles ou des surfaces.
Les références
Tukey, John W. 1977. Exploratory Data Analysis. Addison-Wesley. https://books.google.com/books?id=Fz5DnwEACAAJ.