4 Confusion et ajustement
Quand on étudie l’association entre une réponse \(Y\) et une variable d’exposition (ou plusieurs), on peut inclure d’autres variables. Ces variables sont appelées facteurs de confusion. Si on les inclut dans le modèle, on dit qu’on ajuste sur ces facteurs de confusion.
En pratique, il faut ajuster sur des variables qui respectent les critères de définition d’un facteur de confusion. La confusion est une notion causale, et nous ne verrons pas en détail les manières de construire des modèles causaux.
Pour le troisième point, on dit aussi qu’il ne faut pas que \(Z\) soit sur le chemin causal entre \(X\) et \(Y\). C’est important : si \(Z\) est une conséquence de \(X\) et se trouve sur un chemin causal vers \(Y\), \(Z\) peut être un médiateur.
La confusion est un biais : si on ne prend pas en compte un facteur de confusion, on peut surestimer ou sous-estimer l’association entre \(X\) et \(Y\).
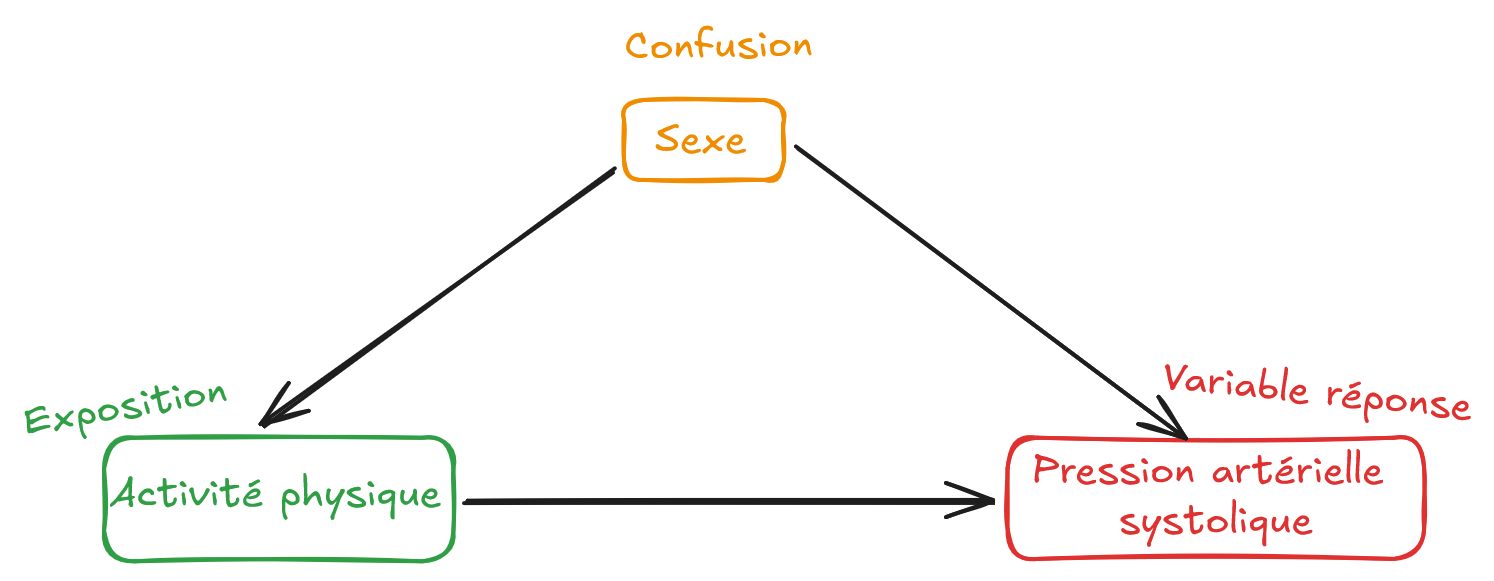
Pour déterminer quels pourraient être nos facteurs de confusion, il est fréquent de construire un diagramme acyclique dirigé (ou directed acyclic graph, DAG). Il s’agit d’un graphe orienté, sans cycle, qui représente les relations causales supposées entre les variables. On peut alors identifier les facteurs de confusion possibles et décider de les inclure ou non dans le modèle. En régression, on corrige ensuite la confusion en ajustant sur le ou les facteurs de confusion.
Des logiciels comme dagitty permettent de construire des DAG et d’identifier les facteurs de confusion à ajuster.
4.1 Vision épidémiologique
Nous avons souvent une exposition principale (notons-la \(E\)) dont on souhaite étudier l’association avec une variable réponse. On se demande alors si une variable \(C\) peut être un facteur de confusion.
En absence d’information pour construire un DAG, il est fréquent de regarder la variation relative du coefficient de l’exposition. Pour cela, on estime deux modèles :
- le modèle avec la variable \(C\) : \(\mathbb{E}(Y\mid E,C,Z)=\beta_0+\beta_{E, ajusté} E+\beta_{C} C + \beta_1 Z_1 + \cdots + \beta_k Z_k\)
- le modèle sans la variable \(C\) : \(\mathbb{E}(Y\mid E,Z)\phantom{,C}=\beta_0+\beta_{E, brut} E\phantom{+\beta_{C} C} \phantom{+} + \beta_1 Z_1 + \cdots + \beta_k Z_k\)
Après avoir estimé les deux modèles, on calcule ensuite la variation relative du coefficient de l’exposition : \[ VR=\frac{|\widehat\beta_{E,\mathrm{ajusté}}-\widehat\beta_{E,\mathrm{brut}}|} {|\widehat\beta_{E,\mathrm{brut}}|}. \tag{1}\] et on regarde si cette dernière est plus grande que 10 ou 20 %.
Nous n’aimons pas cette démarche, car 1/ le seuil est arbitraire et 2/ cela ne permet pas de déterminer si \(C\) est un facteur de confusion ou un médiateur.
Malgré tout, elle reste utilisée et il serait dommage de ne pas vous la présenter ; d’autant plus qu’elle peut être utile lors d’analyses exploratoires.
NoteExemple
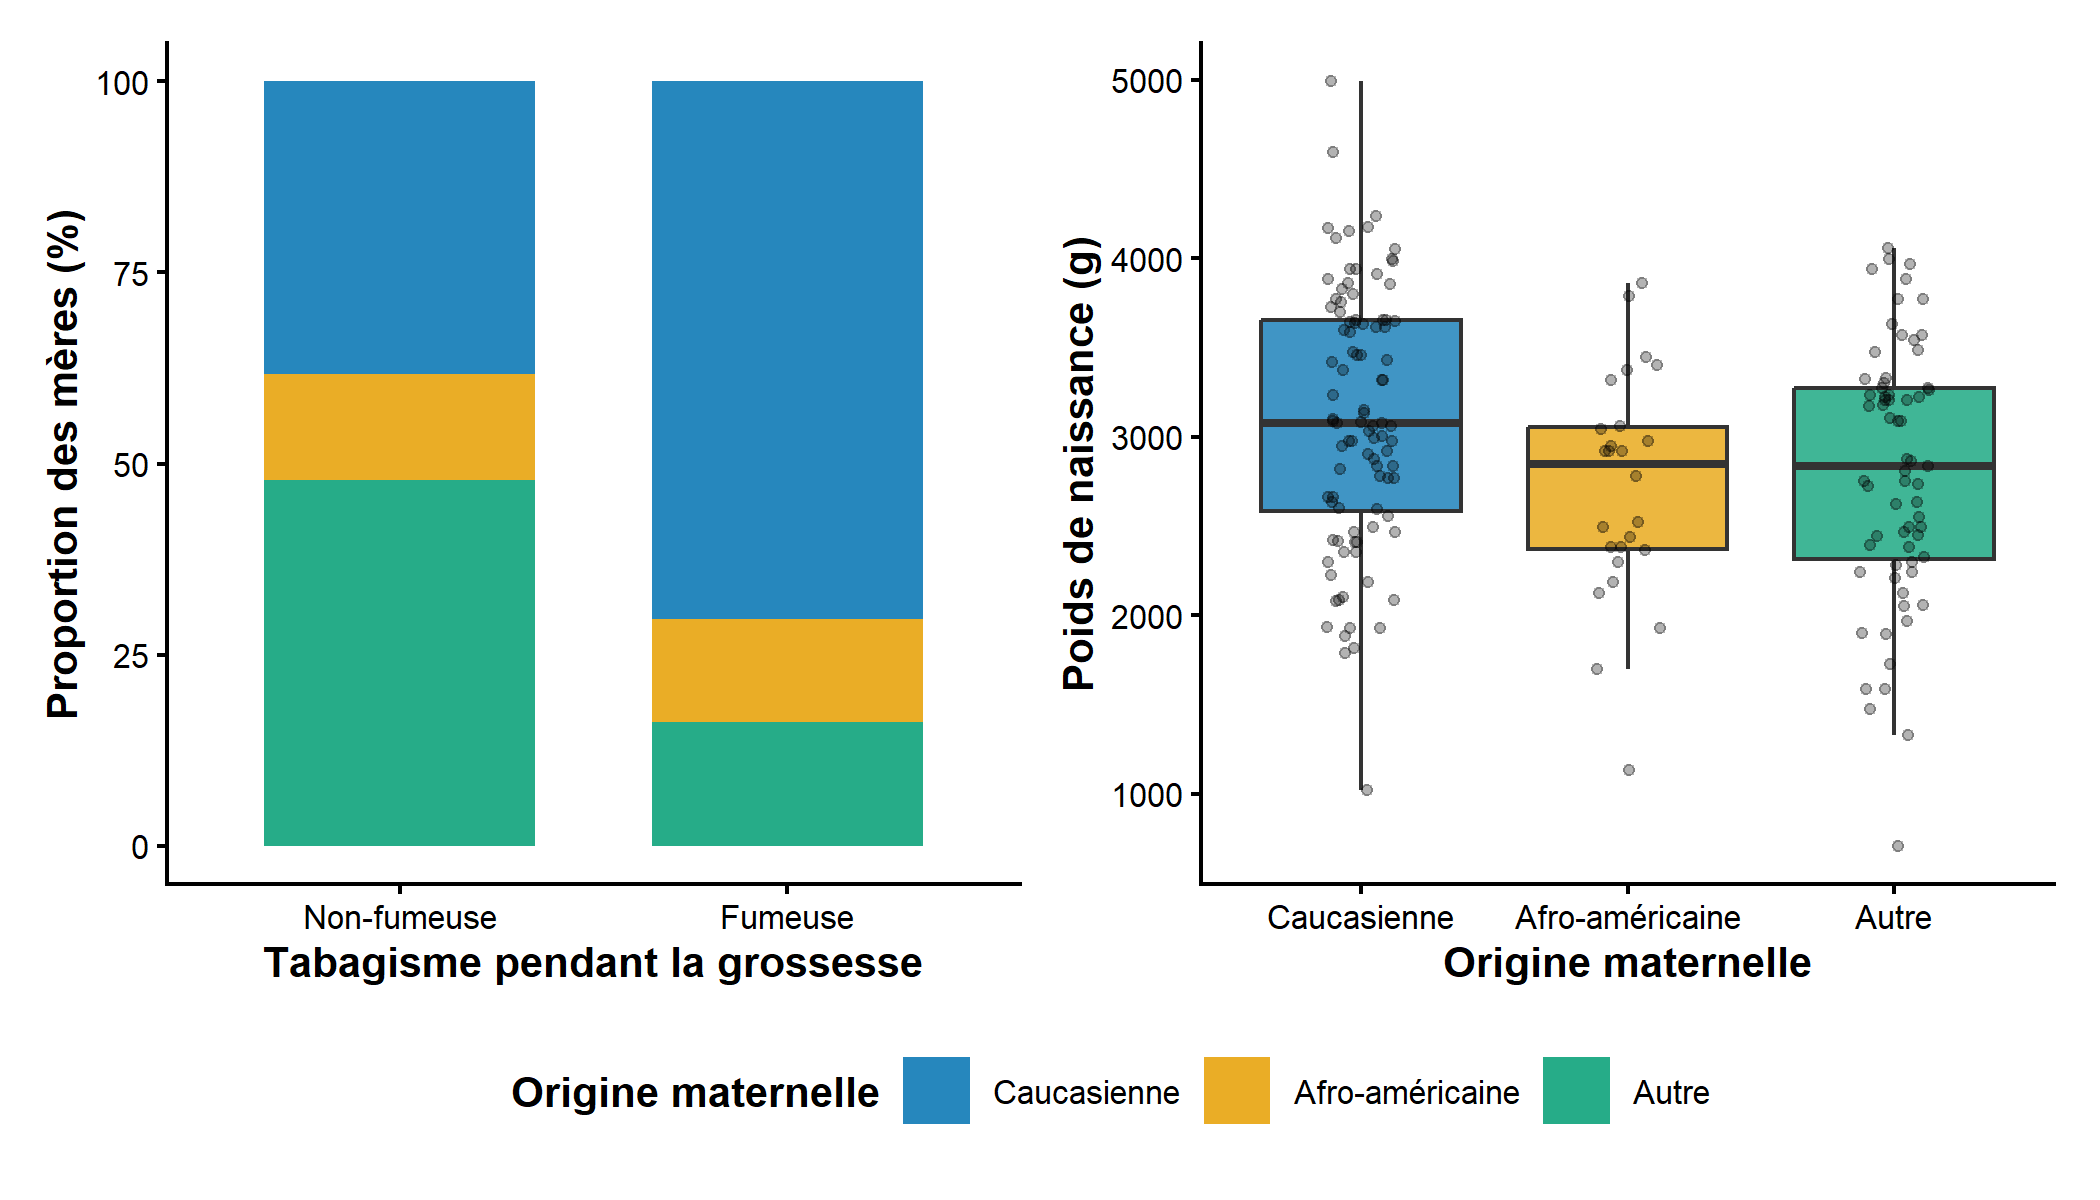
Notons \(\epsilon \sim \mathcal N(0, \sigma^2)\). Le modèle brut s’écrit : \[ \mathcal M_{\mathrm{brut}}:\mathrm{BWT}=\beta_0+\beta_{1,b}\mathrm{SMOKE}+\varepsilon \]
Le coefficient du tabagisme vaut \(\widehat\beta_{1,b}= -281{,}7\) g. Le modèle ajusté sur l’origine maternelle est : \[ \mathcal M_{\mathrm{ajusté}}:\mathrm{BWT}=\beta_0+\beta_{1,a}\mathrm{SMOKE} +\beta_2\mathbb{1}(\mathrm{ORIGINE}=\text{Afro-américaine}) +\beta_3\mathbb{1}(\mathrm{ORIGINE}=\text{Autre}) +\varepsilon \]
Le coefficient ajusté du tabagisme vaut \(\widehat\beta_{1,a}= -427{,}2\) g. La variation relative est : \[ VR = \frac{|\widehat\beta_{1,a} - \widehat\beta_{1,b}|}{|\widehat\beta_{1,b}|} = \frac{|-427{,}2 - (-281{,}7)|}{|-281{,}7|} = \frac{145{,}5}{281{,}7} \approx 51{,}65\% \] Cela suggérerait que l’origine maternelle serait un facteur de confusion de l’association entre tabagisme et poids de naissance.
Avertissement
Il ne faut pas ajuster à tire-larigot ! Ajuster sur un médiateur peut retirer une partie de l’effet étudié, tandis qu’ajuster sur un collider peut créer une association artificielle.
4.2 Vision statistique
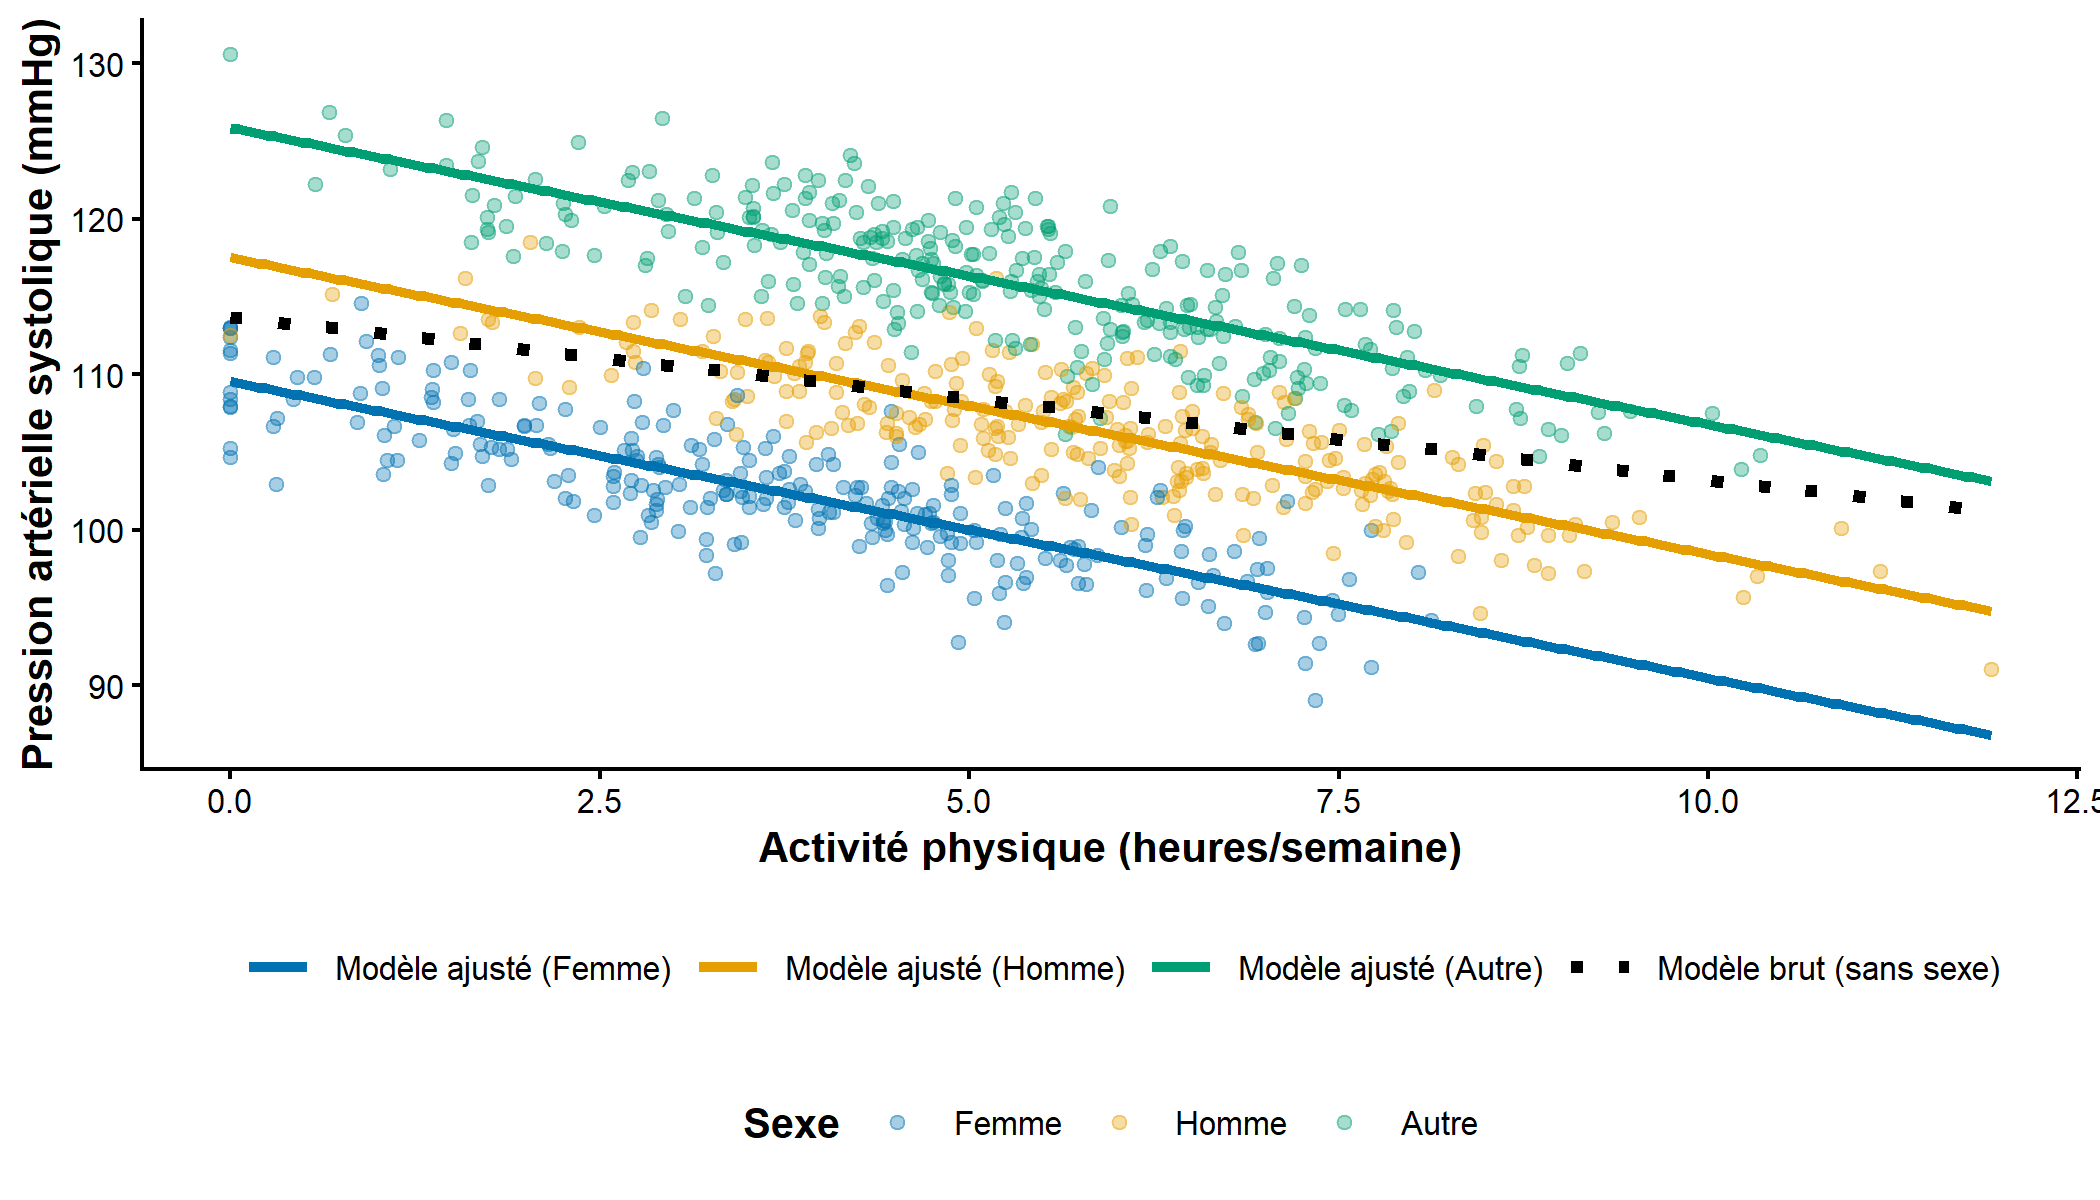
Concrètement, qu’est-ce que cela fait d’ajuster sur une variable dans un modèle de régression linéaire ? Supposons que l’on étudie l’association entre la pression artérielle systolique (PAS) et la pratique d’activité physique (AP), après ajustement sur le sexe. Le modèle complet est : \[ \mathbb E(\text{PAS}\mid \text{AP},\text{Sexe}) = \beta_0 + \beta_1 \text{AP} + \beta_2 \mathbb{1}(\text{Sexe}=\text{Homme}) + \beta_3 \mathbb{1}(\text{Sexe}=\text{Autre}) \]
Regardons comment s’écrit le modèle …
- … chez les “femmes” : \(\mathbb E(\text{PAS}\mid \text{AP},\text{Sexe} = \text{Femme}) = \beta_0 + \beta_1 \text{AP}\) ;
- … chez les “hommes” : \(\mathbb E(\text{PAS}\mid \text{AP},\text{Sexe} = \text{Homme}) = (\beta_0 + \beta_2) + \beta_1 \text{AP}\) ;
- … chez les “autres” : \(\mathbb E(\text{PAS}\mid \text{AP},\text{Sexe} = \text{Autre}) = (\beta_0 + \beta_3) + \beta_1 \text{AP}\).
Ajuster sur une variable catégorielle revient en fait à avoir plusieurs intercepts : un pour chaque niveau de la variable catégorielle ! On peut aussi remarquer que la pente de \(X\) est la même pour tous les niveaux de la variable catégorielle.
Autrement dit, dans ce modèle additif sans interaction, on suppose que l’association avec notre exposition principale est la même dans tous les groupes, et que la seule chose qui change d’un niveau à l’autre est la valeur moyenne de \(Y\) quand \(X=0\) (l’intercept, en somme).
Attention, ce n’est pas équivalent à faire un modèle séparé pour chaque niveau de la variable catégorielle ! Des modèles séparés autorisent aussi des pentes différentes et utilisent chacun un sous-échantillon, ce qui augmente généralement la variance des estimateurs.
On a représenté, dans la Figure 2, l’effet - exagéré certes - de l’ajustement sur l’étude de l’association entre la pression artérielle systolique et la pratique d’activité physique.