2 Régression linéaire multiple
2.1 Modèle
La régression linéaire multiple étend la régression simple à plusieurs variables explicatives : \[ \mathbb E(Y\mid X_1=x_1,\ldots,X_p=x_p) =\beta_0+\beta_1x_1+\cdots+\beta_px_p \]
Au niveau individuel : \[ Y_i=\beta_0+\beta_1X_{i1}+\cdots+\beta_pX_{ip}+\varepsilon_i \]
Dans un modèle multiple, le coefficient \(\beta_j\) s’interprète conditionnellement aux autres variables du modèle. On peut aussi dire “après ajustement sur les autres covariables” ou “toutes choses égales par ailleurs”.
Précédemment, nous avons modélisé le poids de naissance en fonction du tabagisme maternel ou de l’âge maternel, séparément. En régression linéaire multiple, on peut choisir d’utiliser les deux variables explicatives dans le même modèle, mais aussi en rajouter d’autres !
Nous n’ajoutons pas des variables “au hasard” ; nous en discutons un peu plus en section 4 et section 5.
NoteExemple
On souhaite modéliser le poids de naissance en fonction de l’âge maternel, du poids maternel et du tabagisme. Le modèle s’écrit : \[ \mathbb E(\mathrm{BWT}\mid \mathrm{AGE},\mathrm{LWT},\mathrm{SMOKE}) =\beta_0+\beta_1\mathrm{AGE}+\beta_2\mathrm{LWT}+\beta_3\mathrm{SMOKE}, \tag{1}\]
Voici plusieurs interprétations possibles des coefficients du modèle défini par l’équation 1 :
- L’intercept \(\beta_0\) est la moyenne attendue du poids de naissance pour une mère non-fumeuse, d’âge 0 et de poids maternel 0 (ce qui n’est toujours pas interprétable, il faudrait centrer l’âge ET le poids maternel).
- \(\beta_1\) est la variation moyenne du poids de naissance associée à une année supplémentaire d’âge maternel, à poids maternel et tabagisme identiques.
- \(\beta_2\) est la variation moyenne du poids de naissance associée à une livre supplémentaire de poids maternel, ajustée sur l’âge maternel et le tabagisme.
- \(\beta_3\) est la différence moyenne de poids de naissance entre enfants de mères fumeuses et non fumeuses, toutes choses égales par ailleurs.
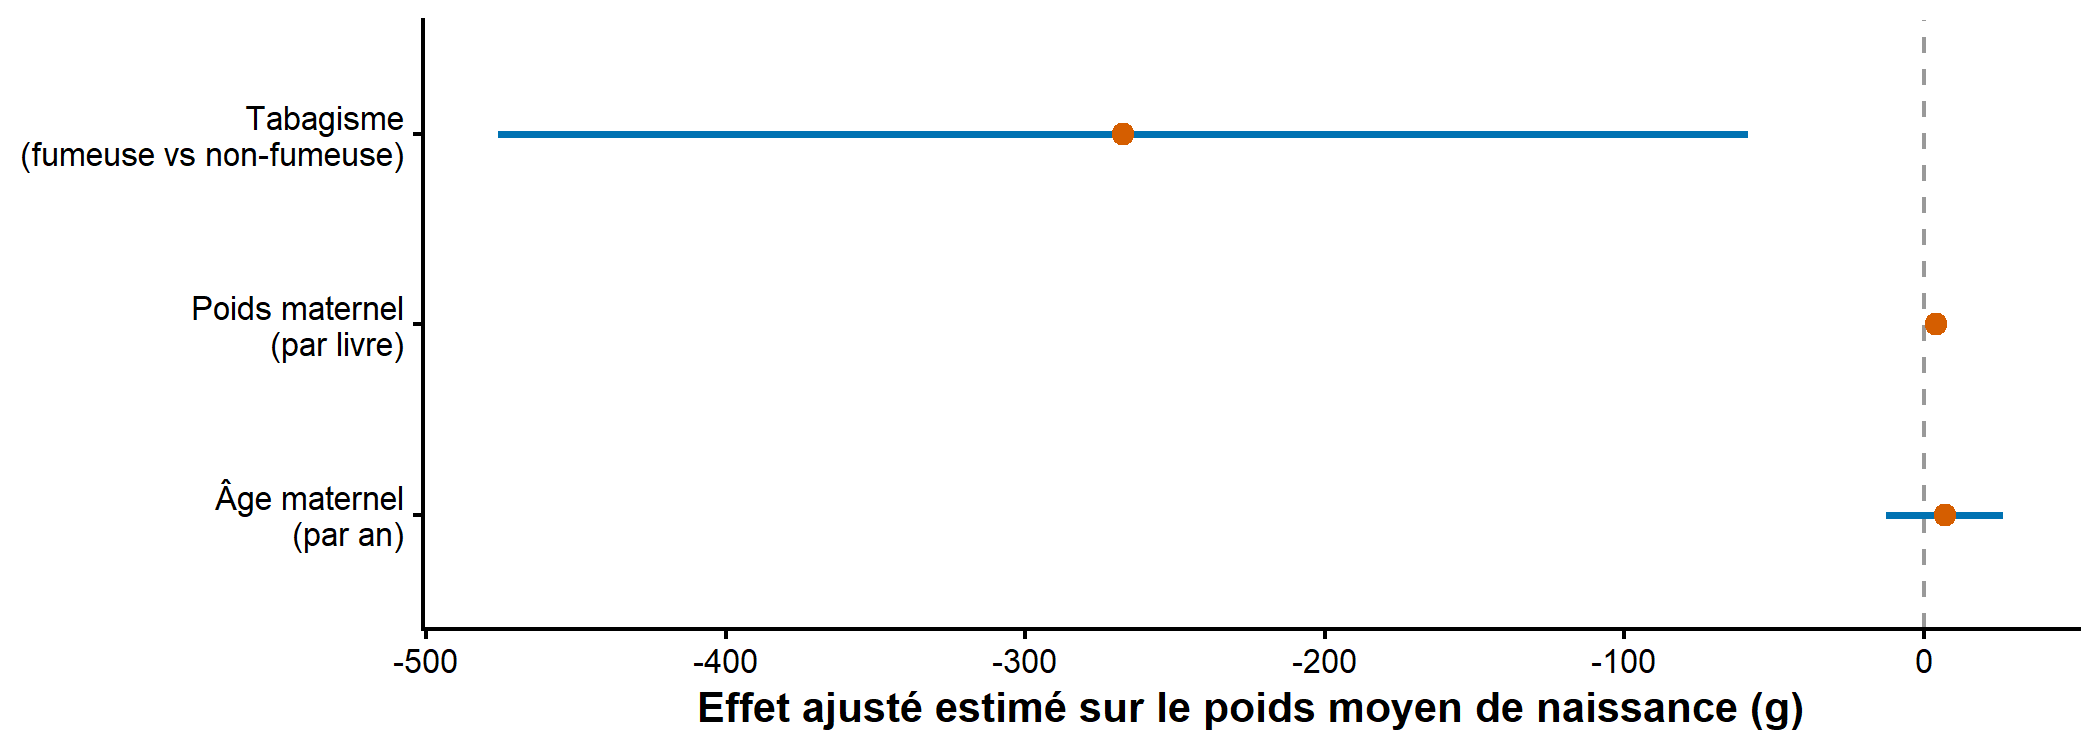
On résume les résultats de l’estimation dans le Tableau 1.
| Terme | Estimation | Erreur standard | t | p-valeur | IC 95 % |
|---|---|---|---|---|---|
| Intercept | 2 362,72 | 300,69 | 7,86 | < 0,001 | [1 769,5 ; 2 955,9] |
| Âge maternel (années) | 7,09 | 9,92 | 0,71 | 0,476 | [-12,5 ; 26,7] |
| Poids maternel pré-grossesse (lbs) | 4,02 | 1,72 | 2,34 | 0,021 | [0,6 ; 7,4] |
| Tabagisme (Oui vs. non) | -267,21 | 105,80 | -2,53 | 0,012 | [-475,9 ; -58,5] |
À statut tabagique et âge maternel identiques, une livre supplémentaire de poids maternel pré-grossesse est associée à une augmentation moyenne de 4,02 g du poids de naissance (IC 95 % = [0,6 ; 7,4] g). De même, toutes choses égales par ailleurs, le poids de naissance est en moyenne 267,21 g plus faible chez les enfants de mères fumeuses que chez ceux de mères non-fumeuses (IC 95 % = [-475,9 ; -58,5] g). Ces deux associations sont significativement différentes de zéro au seuil de 5 %.
Un moyen de représenter les estimations d’un modèle de régression est d’utiliser un forest plot, comme montré en Figure 1. Ceci est d’autant plus utile quand on souhaite montrer les résultats de nombreuses variables ou de plusieurs modèles.
On a dit “ajusté” précédemment. Cette notion est discutée en section 4.
2.2 Codage des variables explicatives
2.2.1 Variable binaire
Le plus fréquent est de coder la variable en 0 (la catégorie de référence) et 1 (la catégorie d’intérêt). Le modèle s’écrit alors : \[ \mathbb E(Y\mid X,\mathbf Z)=\beta_0+\beta_1X+\boldsymbol\gamma^\top\mathbf Z \] où \(\mathbf Z\) est un vecteur de covariables supplémentaires et \(\boldsymbol\gamma\) le vecteur de coefficients associés. Ainsi, \(\beta_1\) est la différence moyenne de \(Y\) entre le groupe \(X=1\) et le groupe \(X=0\), toutes choses égales par ailleurs.
2.2.2 Variable qualitative à plusieurs modalités
Ici, il faut “créer” des variables, appelées indicatrices. Une variable qualitative à \(L\) modalités est représentée par \(L-1\) indicatrices, avec une modalité de référence.
En anglais, on parle de “dummy variables”.
Dans l’étude “poids de naissance”, l’origine maternelle déclarée a trois modalités : “Caucasienne”, “Afro-américaine” et “Autre”. En prenant l’origine caucasienne comme référence, on note : \[ D_1=\mathbb{1}(\mathrm{ORIGINE}=\text{Afro-am.}) \text{ et } D_2=\mathbb{1}(\mathrm{ORIGINE}=\text{Autre}) \] En estimant le modèle, on aura alors :
- un coefficient spécifique pour les femmes afro-américaines (\(\beta_1\)) ;
- un coefficient spécifique pour les femmes de la modalité “Autre” (\(\beta_2\)) ;
- l’intercept \(\beta_0\) correspond à la moyenne attendue pour les femmes caucasiennes (quand \(D_1=D_2=0\)).
Mise en garde
Coder une variable nominale en 1/2/3 et la traiter comme quantitative impose une tendance linéaire arbitraire entre catégories ! Or, rien n’indique que la différence entre la catégorie 1 et 2 est la même que celle entre la catégorie 2 et 3…
2.2.3 Variable quantitative
Le coefficient d’une variable quantitative dépend de son unité, et certaines unités sont plus naturelles que d’autres. On peut transformer une variable de façon à changer son unité (p. ex., de kg à g, d’années à mois).
De façon similaire, pour estimer l’effet pour une augmentation de 10 ans, il suffit de créer une nouvelle variable
AGE_10ans = AGE/10. On obtiendra alors \(\widehat\beta_1=123{,}6\) g/10 ans !
Notre variable peut déjà être dans la “bonne unité” pour communiquer les résultats. Il est préférable d’utiliser des caractéristiques cliniquement pertinentes. Centrer une variable signifie remplacer \(X\) par : \[ X_c=X-x_0, \] où \(x_0\) est une valeur cliniquement pertinente (p. ex., moyenne, minimum, médiane).
Note
- Sans interaction, centrer une variable ne change pas l’estimation de sa pente, seulement celle de l’intercept (qui devient la moyenne attendue pour \(X=x_0\)) ;
- Centrer une variable est particulièrement utile en présence d’interaction (présenté en section 5) : les effets principaux deviennent interprétables à une valeur réaliste de l’autre variable.
Enfin, “l’augmentation d’une unité de notre variable explicative” peut ne pas être la chose la plus pertinente au monde. On voit deux grandes situations :
- \(X_j\) est une variable dont l’unité est peu interprétable ou trop fine (p. ex., un score psychométrique, un biomarqueur, un indice socioéconomique) ;
- Nos variables explicatives \(X_j\) sont sur des échelles très différentes (p. ex., âge en années, poids en livres, biomarqueur en mg/dL) ;
Pour ces deux cas, la standardisation remplace \(X\) par : \[ Z=\frac{X-\bar X}{s_X} \]
Le coefficient s’interprète alors pour une augmentation d’un écart-type de \(X\).
Note
Si la variable explicative a une unité naturelle ou clinique claire, alors centrer est (probablement) la bonne chose à faire. Sinon, on peut préférer standardiser.