1 Principe général d’un test
Un test statistique part d’une question scientifique, puis la traduit en deux hypothèses statistiques. On compare ensuite ce que l’on observe à ce que l’on aurait pu observer si l’hypothèse de référence était vraie.
On peut le voir comme un raisonnement par contradiction : on suppose d’abord que l’hypothèse nulle est vraie, puis on regarde si les données observées sont plausibles dans ce cadre. Si elles sont trop éloignées de ce que l’on attend sous \(H_0\), on rejette \(H_0\).
Ce raisonnement reprend deux héritages : Ronald Fisher a diffusé les tests de significativité dans son ouvrage de 1925 (Fisher 1925), tandis que Jerzy Neyman et Egon Pearson ont formalisé en 1933 le choix entre hypothèses et la maîtrise des risques d’erreur (Neyman et Pearson 1933).
La quantité qui mesure cet éloignement s’appelle une statistique de test. Avant d’observer les données, c’est une variable aléatoire : elle pourrait prendre plusieurs valeurs selon l’échantillon obtenu. Après observation, elle prend une valeur numérique précise.
On notera souvent la variable aléatoire avec une majuscule (p. ex., \(T\)) et sa valeur observée avec une minuscule (p. ex., \(t\)).
1.1 Les six étapes d’un test
Une démarche de test se rédige idéalement en six étapes.
Identifier la question et les variables pertinentes. On précise l’unité statistique, la variable réponse, le ou les groupes comparés, et le caractère indépendant ou apparié des observations.
Formuler \(H_0\) et \(H_1\). On peut voir \(H_0\) comme la situation de référence, que l’on souhaite “challenger” ; et \(H_1\) comme l’alternative scientifique définie avant l’examen des résultats, par exemple une différence ou un effet dans un sens donné.
Choisir le seuil \(\alpha\) et vérifier les conditions d’application. Le seuil est souvent fixé à 5 % et doit être choisi avant de regarder la conclusion du test. Les conditions dépendent du test (p. ex., indépendance, normalité, effectifs attendus).
Calculer une statistique de test. Elle mesure l’écart entre les données observées et ce qui serait attendu sous \(H_0\), en tenant compte de la variabilité d’échantillonnage.
Obtenir une p-valeur ou comparer à une région critique. La p-valeur quantifie à quel point la statistique observée serait inhabituelle si \(H_0\) était vraie. On peut aussi comparer la statistique observée à la région critique (RC) : si la statistique observée se situe dans la RC, on rejette \(H_0\) ; sinon, on ne le rejette pas.
Conclure dans le langage de la question. On dit si l’on rejette ou non \(H_0\) au seuil choisi, puis on conclut sur la question initialement posée - dans l’idéal en l’interprétant dans le contexte de l’étude.
AvertissementToujours rester intègre !
On ne choisit pas le test après avoir regardé la p-valeur, car “elle ne nous convient pas”. De même, on n’essaie pas plusieurs tests “histoire de voir”, et encore moins pour sélectionner celui qui donne la p-valeur la plus faible. Dans l’idéal, il faut être capable de choisir le test avant même d’avoir regardé les données. C’est ce qu’on appelle un plan d’analyse.
1.2 Test bilatéral ou unilatéral
Il est fréquent d’utiliser une alternative bilatérale : \[ H_1:\theta\neq\theta_0 \]
Un test unilatéral spécifie le sens de l’effet recherché : \[ H_1:\theta>\theta_0 \; \text{ ou } \; H_1:\theta<\theta_0 \]
Un test bilatéral cherche une différence, quelle qu’elle soit. Un test unilatéral cherche une différence dans un sens précis. Ainsi, une différence dans le sens opposé ne conduit alors pas au rejet de \(H_0\), même si elle est importante !
Un test unilatéral ne doit être retenu que si le sens de l’alternative est scientifiquement justifié et fixé avant l’examen des résultats.
1.3 Risques d’erreur, puissance et p-valeur
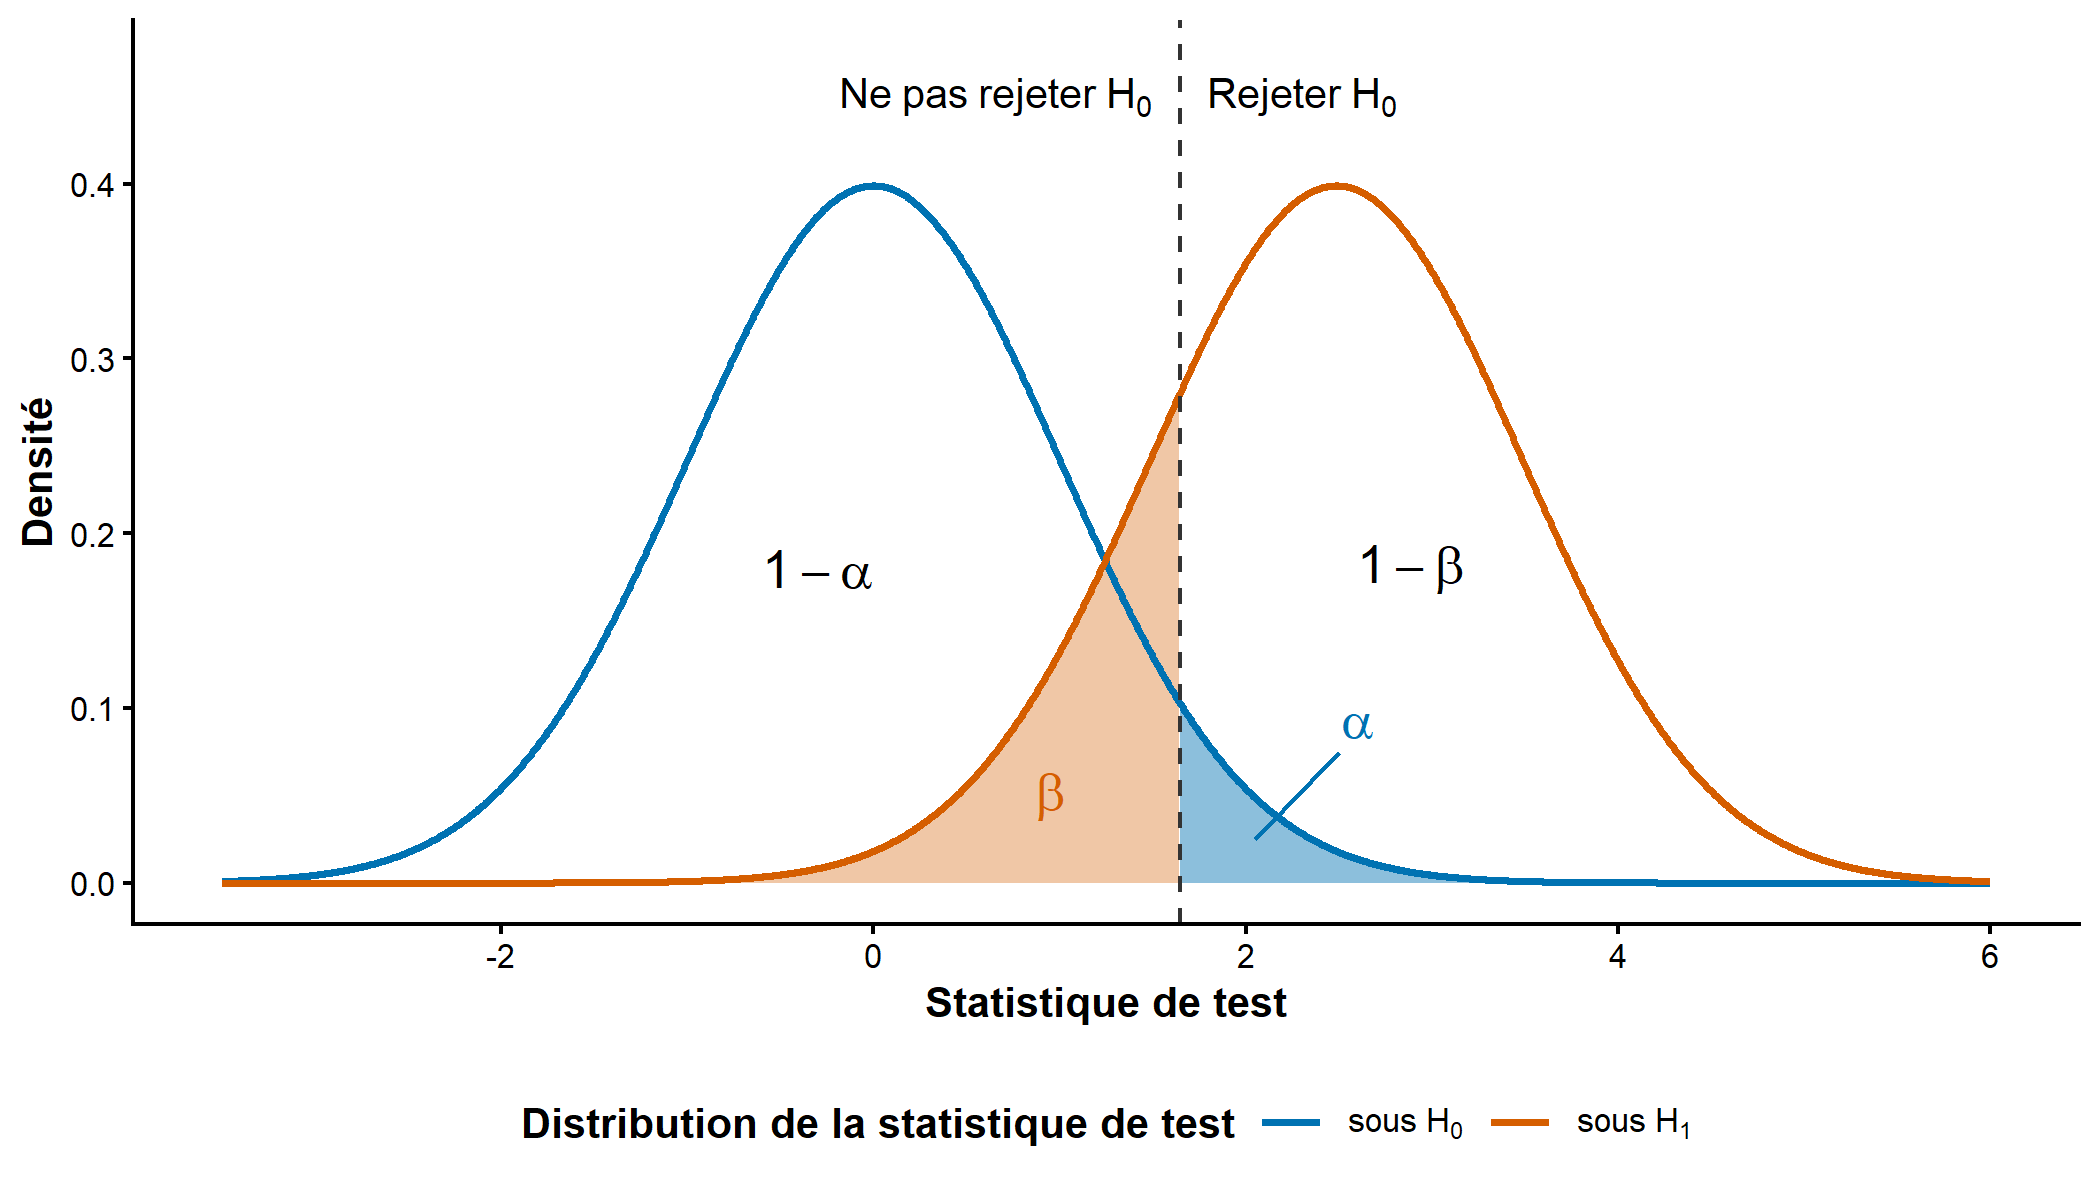
Le risque de première espèce est : \[ \alpha=\mathbb P(\text{rejeter }H_0 \mid H_0\text{ vraie}) \]
Cela se lit “probabilité de rejeter \(H_0\) sachant que \(H_0\) est vraie”, et correspond à la probabilité de dire qu’il existe un effet ou une différence alors qu’il n’y en a pas
Note
Le seuil \(\alpha\) est une valeur que nous fixons quand on construit des intervalles de confiance ou quand on applique des tests.
Le risque de deuxième espèce est : \[ \beta=\mathbb P(\text{ne pas rejeter }H_0 \mid H_1\text{ vraie}) \]
C’est le petit frère de \(\alpha\) : c’est la probabilité de ne pas détecter un effet ou une différence alors qu’il en existe un
De là, on peut dériver une autre valeur, très utile en clinique : la puissance du test, \[ 1-\beta=\mathbb P(\text{rejeter }H_0 \mid H_1\text{ vraie}) \]
C’est la probabilité de rejeter \(H_0\) sachant que \(H_1\) est vraie, c’est-à-dire la probabilité de détecter un effet ou une différence lorsqu’elle existe !
Note
Quand on conçoit une étude, il faut souvent choisir en amont combien de personnes recruter. Ce nombre ne se décide pas au hasard : il se calcule ! Généralement, on prend \(\alpha = 5\%\) et \(\beta = 20 \%\) (pour avoir une puissance de 80 %).
Ces quatre situations peuvent être résumées dans le tableau suivant :
| Décision | \(H_0\) vraie | \(H_1\) vraie |
|---|---|---|
| Ne pas rejeter \(H_0\) | \(1-\alpha\) = Décision correcte | \(\beta\) = Erreur de deuxième espèce / de type II |
| Rejeter \(H_0\) | \(\alpha\) = Erreur de première espèce / de type I | \(1-\beta\) = Décision correcte (puissance) |
NoteExemple
NoteExemple
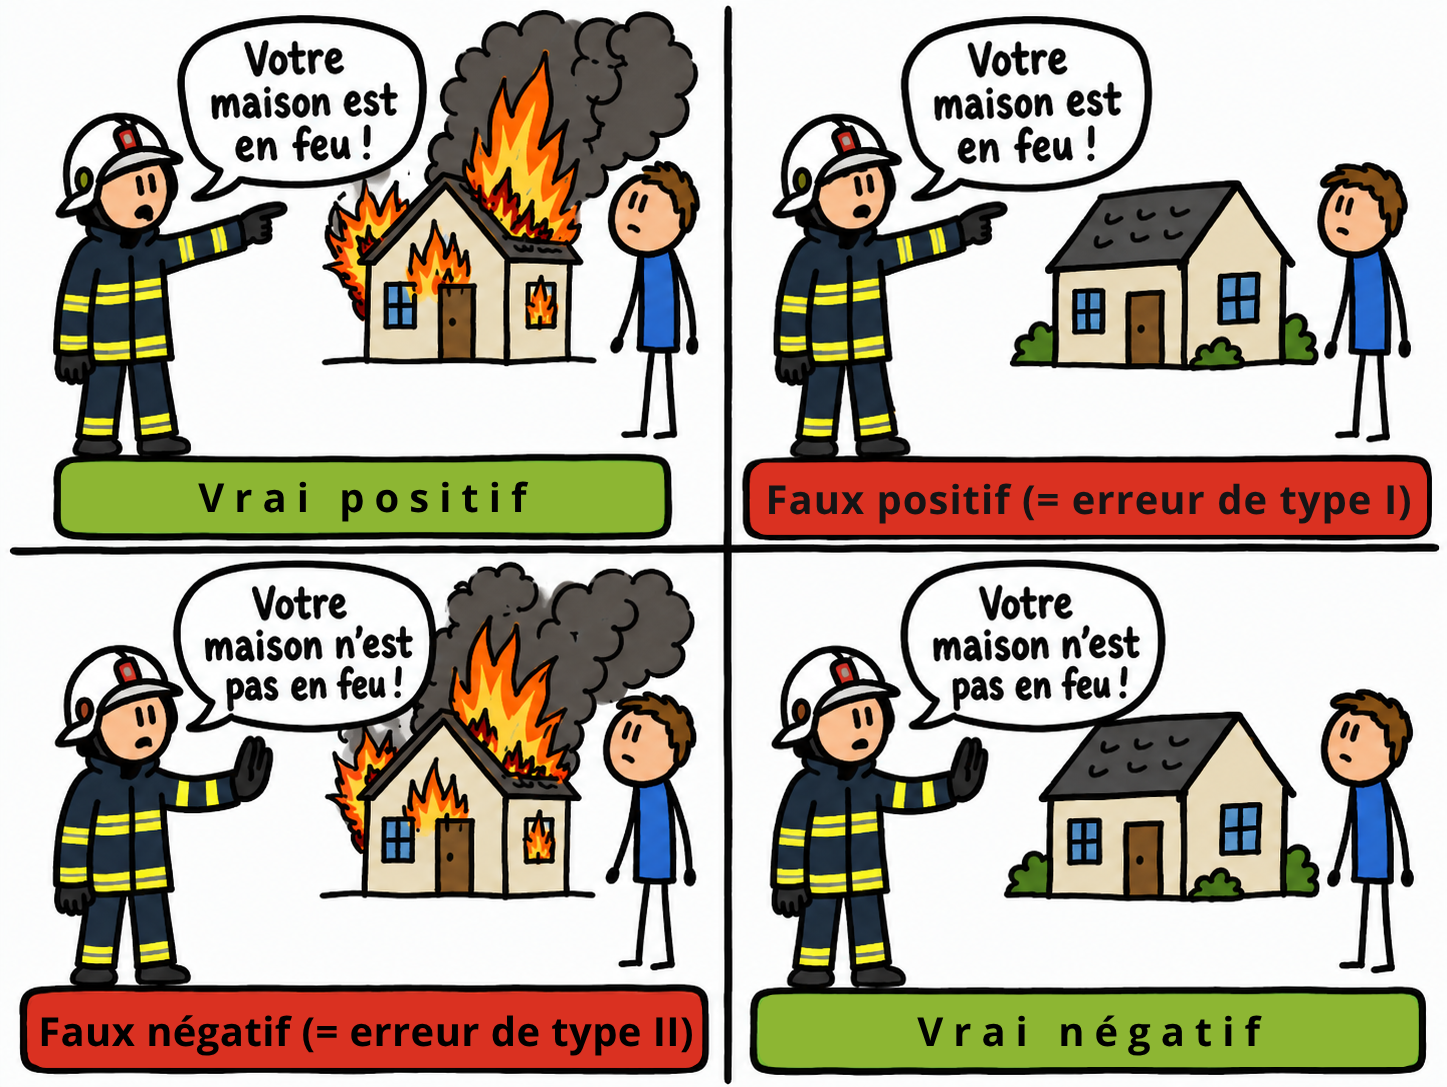
Si \(H_0\) est “la maison n’est pas en feu”, donner l’alerte revient à rejeter \(H_0\) : une fausse alerte illustre l’erreur de type I, tandis qu’un incendie non détecté illustre l’erreur de type II.
La notion d’“aussi extrême” dépend de l’alternative : bilatérale ou unilatérale.
Une petite p-valeur indique que les données observées sont peu compatibles avec \(H_0\). Si \(p<\alpha\), on rejette \(H_0\) au seuil \(\alpha\).
NoteExemple
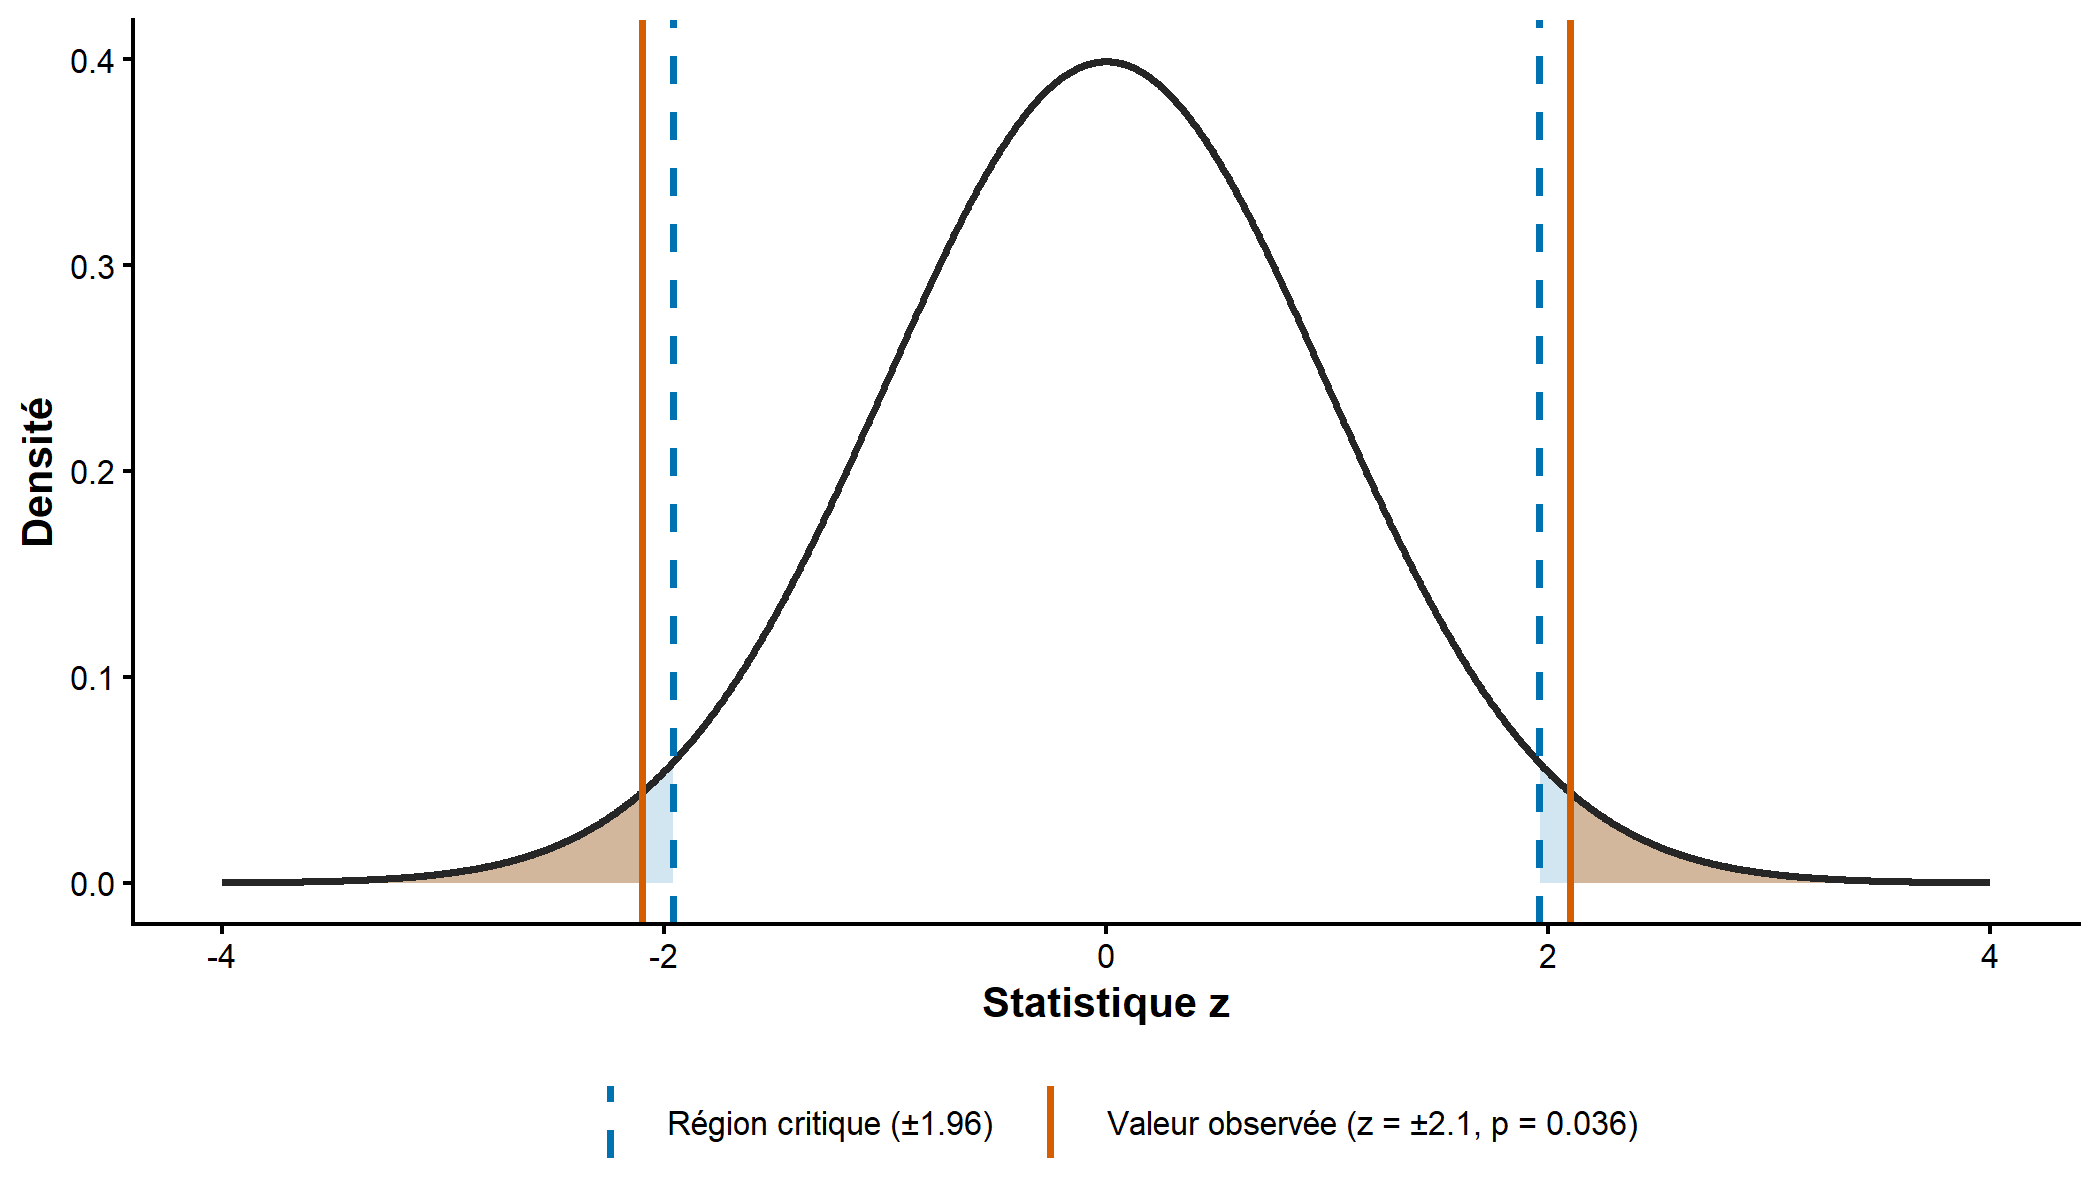
Pour un test bilatéral fondé sur une statistique normale centrée réduite \(Z\), supposons que la valeur observée soit \(z=2,1\). La p-valeur vaut : \[ p=2\,\mathbb P(Z\ge 2,1)\approx0,035 \] Au seuil de 5 %, on rejette \(H_0\) car \(p<0,05\). Au seuil de 1 %, on ne rejetterait pas \(H_0\).
Avertissement
ATTENTION ! La p-valeur n’est PAS la probabilité que \(H_0\) soit vraie !
Note
À effet observé identique, une conclusion peut changer selon la taille de l’échantillon, la dispersion des données et le seuil \(\alpha\). Ainsi :
- une différence faible peut devenir significative dans un très grand échantillon ;
- une différence importante peut être non significative dans une petite étude.
1.4 Conclure à un test statistique
Dans les travaux que vous mènerez, vous devrez souvent présenter une p-valeur. Cependant, sans ordinateur, il est compliqué de la calculer (à tout hasard, lors d’un examen). À la place, on utilise un nombre appelé valeur critique, qui permet de définir une région critique. Si la statistique de test observée se situe dans cette région critique, on rejette \(H_0\). Sinon, on ne rejette pas \(H_0\).
Les références
Fisher, Ronald A. 1925. Statistical Methods for Research Workers. Oliver; Boyd. https://www.yorku.ca/pclassic/Fisher/Methods/.
Neyman, Jerzy, et Egon S. Pearson. 1933. « On the Problem of the Most Efficient Tests of Statistical Hypotheses ». Philosophical Transactions of the Royal Society of London. Series A 231: 289‑337. https://doi.org/10.1098/rsta.1933.0009.