4 Comparaison de fonctions de survie
Un des principaux intérêts de l’estimation de la fonction de survie, est de pouvoir comparer la survie entre deux groupes de sujets d’un même échantillon. C’est-à-dire comparer la fonction de survie \(S_1(t)\) du groupe 1 et la fonction de survie \(S_2(t)\) du groupe 2. Nous présenterons deux tests, selon l’objectif :
- un test ponctuel comparant les deux courbes de survie à un instant \(t\)
- un test global comparant les deux courbes de survie sur toute la période de suivi, autrement appelé le test du log-rank
En pratique, on utilise notre logiciel statistique préféré pour réaliser ces tests.
4.1 Test de comparaison ponctuel des courbes de survie
Ce premier test n’a de sens que si le temps \(t\) est cliniquement pertinent. Les évènements et les censures antérieurs à \(t\) servent à estimer \(S(t)\), mais le test ne compare que les probabilités à cet horizon.
On teste : \(\text{H}_0 : S_1(t) = S_2(t)\) contre \(\text{H}_1 : S_1(t) \neq S_2(t)\) bilatérale. Pour deux groupes indépendants, sous \(\text{H}_0\), la statistique suit asymptotiquement une loi de \(\chi^2\) à 1 degré de liberté (ddl). Sa statistique de test est : \[ X^2=\frac{(\hat{S}_1(t) - \hat{S}_2(t))^2}{\hat{\sigma}_1^2 + \hat{\sigma}_2^2} \] où \(\hat{\sigma}_1^2\) et \(\hat{\sigma}_2^2\) sont les variances estimées de \(\hat{S}_1(t)\) et \(\hat{S}_2(t)\), obtenues ici par la formule de Greenwood (on vous épargne les détails de cette formule).
Major Greenwood a présenté une formule pour mesurer l’erreur d’échantillonnage des tables de survie dans un rapport de 1926 sur la durée des cancers (Greenwood 1926).
NoteExemple
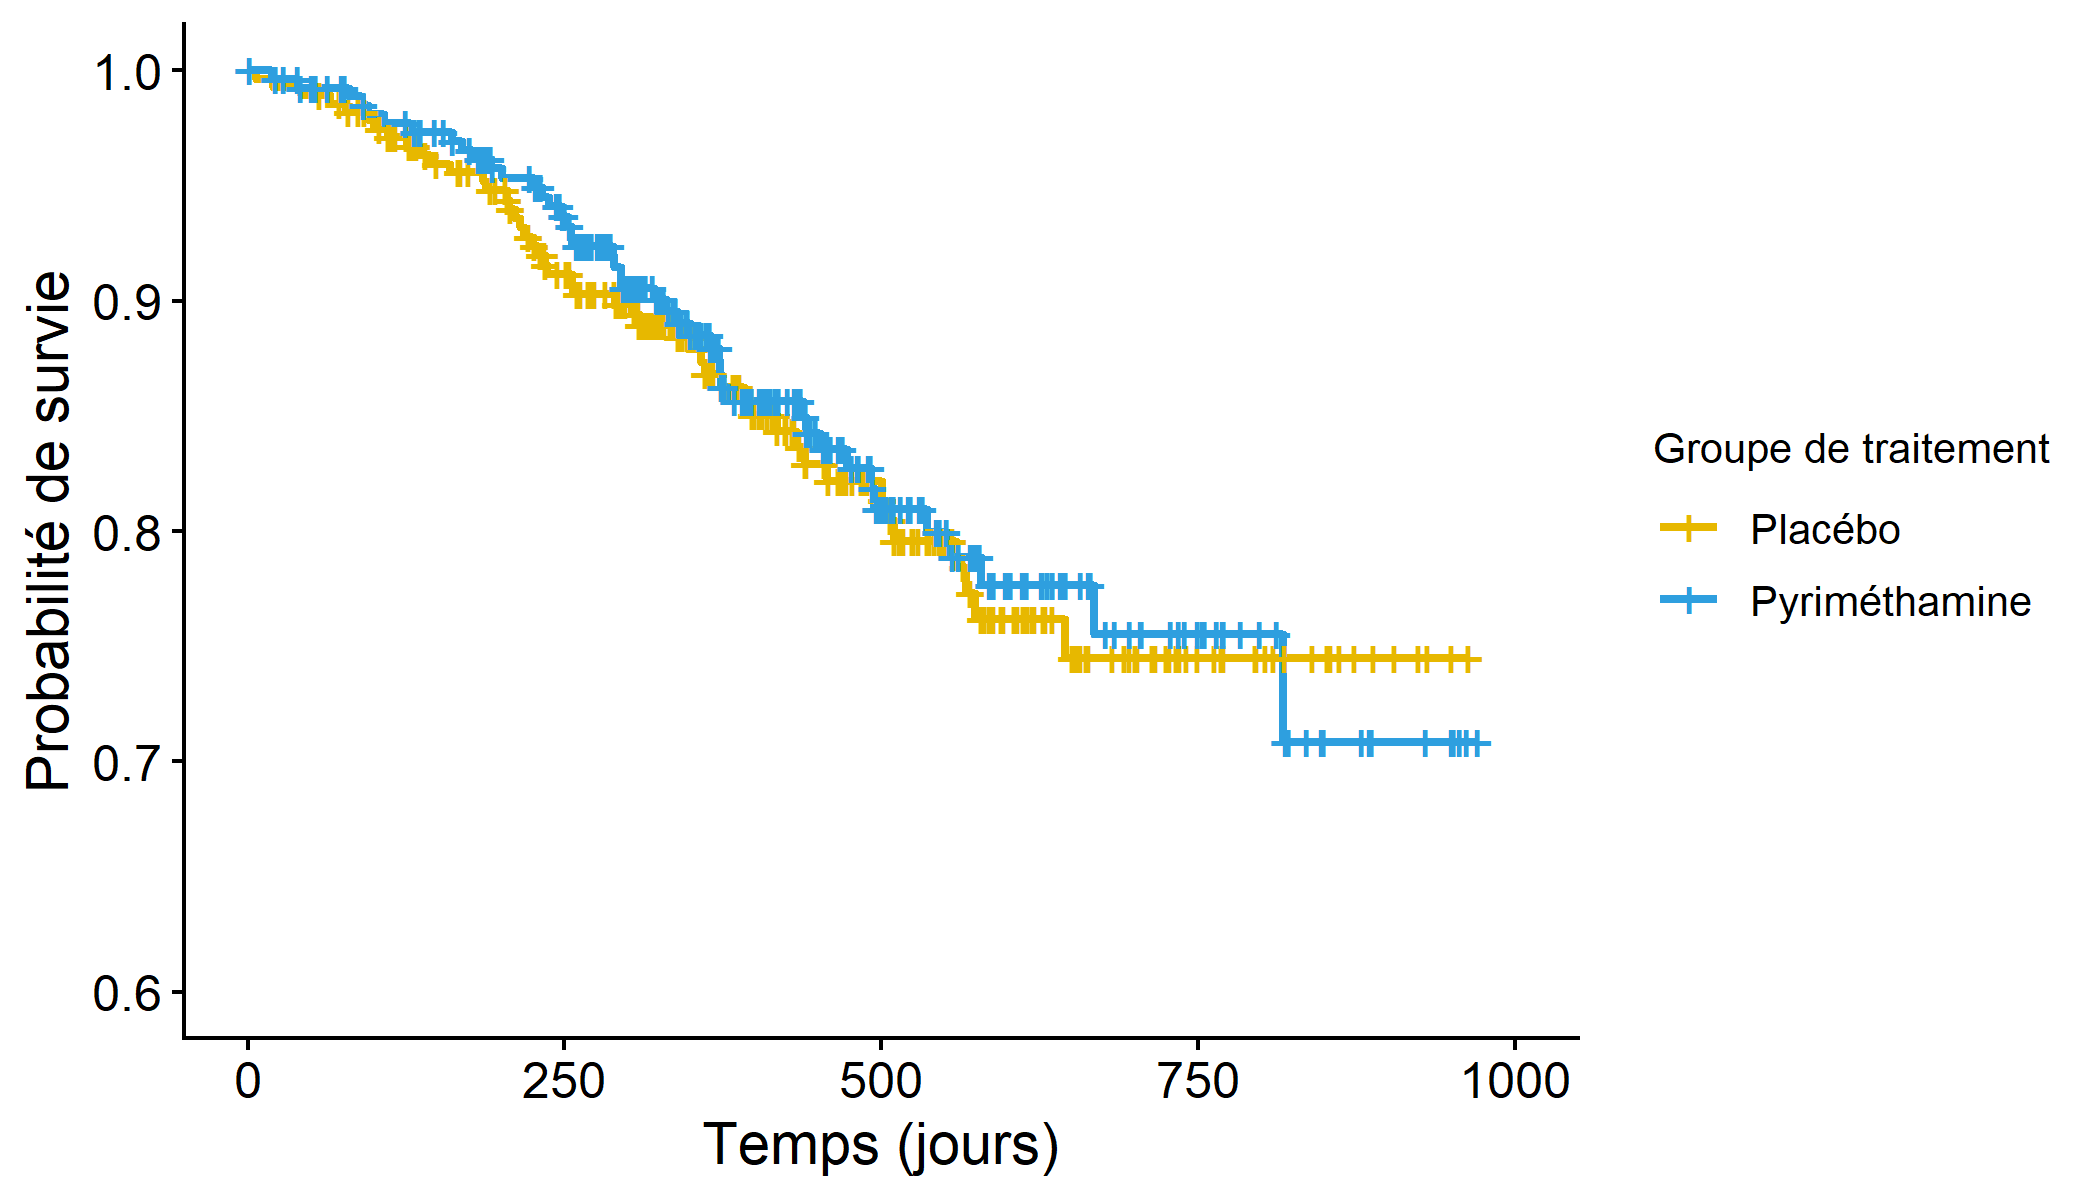
Prenons l’ensemble de nos sujets de l’étude Toxo. Pour rappel, cette étude visait à évaluer si la pyriméthamine réduit le risque de toxoplasmose. Nous avons ainsi deux groupes de sujets : le groupe placebo et le groupe pyriméthamine. En utilisant notre logiciel préféré, on estime la survie sans toxoplasmose, calculée en censurant les décès. On représente alors les fonctions de survie estimées dans la Figure 1.
On voit qu’un écart semble se faire vers 900 jours, en défaveur du groupe pyriméthamine. Testons alors si cette différence est significative. La fonction de survie pour le groupe placebo est estimée à \(\hat S_1(900) = 0,745\) (erreur standard : \(0,0377\)) sous placebo, contre \(\hat S_2(900) = 0,708\) (erreur standard : \(0,0585\)) sous pyriméthamine. La statistique de test estimée à \(t=900\) est \[ X^2 = \frac{(0,745 - 0,708)^2}{0,0377^2 + 0,0585^2} \approx 0,276 < 3,84 \]
Comme la valeur seuil à 5 % de la région critique de la loi de \(\chi^2\) à 1 ddl est \(3,841\), on ne rejette pas \(H_0\). Ainsi, les données ne permettent pas de conclure à une différence significative de survie entre le groupe placebo et le groupe pyriméthamine au bout de 900 jours de suivi.
On insiste sur le “au bout de 900 jours de suivi”. Si l’on avait choisi un autre temps \(t\), on aurait pu obtenir un résultat différent
Ce test peut aboutir à une conclusion différente du test suivant : celui du log-rank.
4.2 Test de comparaison global du log-rank
Nathan Mantel a proposé en 1966 une comparaison globale des temps de survie (Mantel 1966). Richard et Julian Peto ont ensuite étudié le test sous le nom de log-rank en 1972 (Peto et Peto 1972).
Le test du log-rank compare, à chaque temps d’évènement, le nombre d’évènements observés dans chaque groupe au nombre attendu sous l’hypothèse \(\text{H}_0 : S_1(t) = S_2(t) \forall t\) et \(\text{H}_1 : \exists t \quad S_1(t) \neq S_2(t)\). On peut illustrer cela graphiquement :
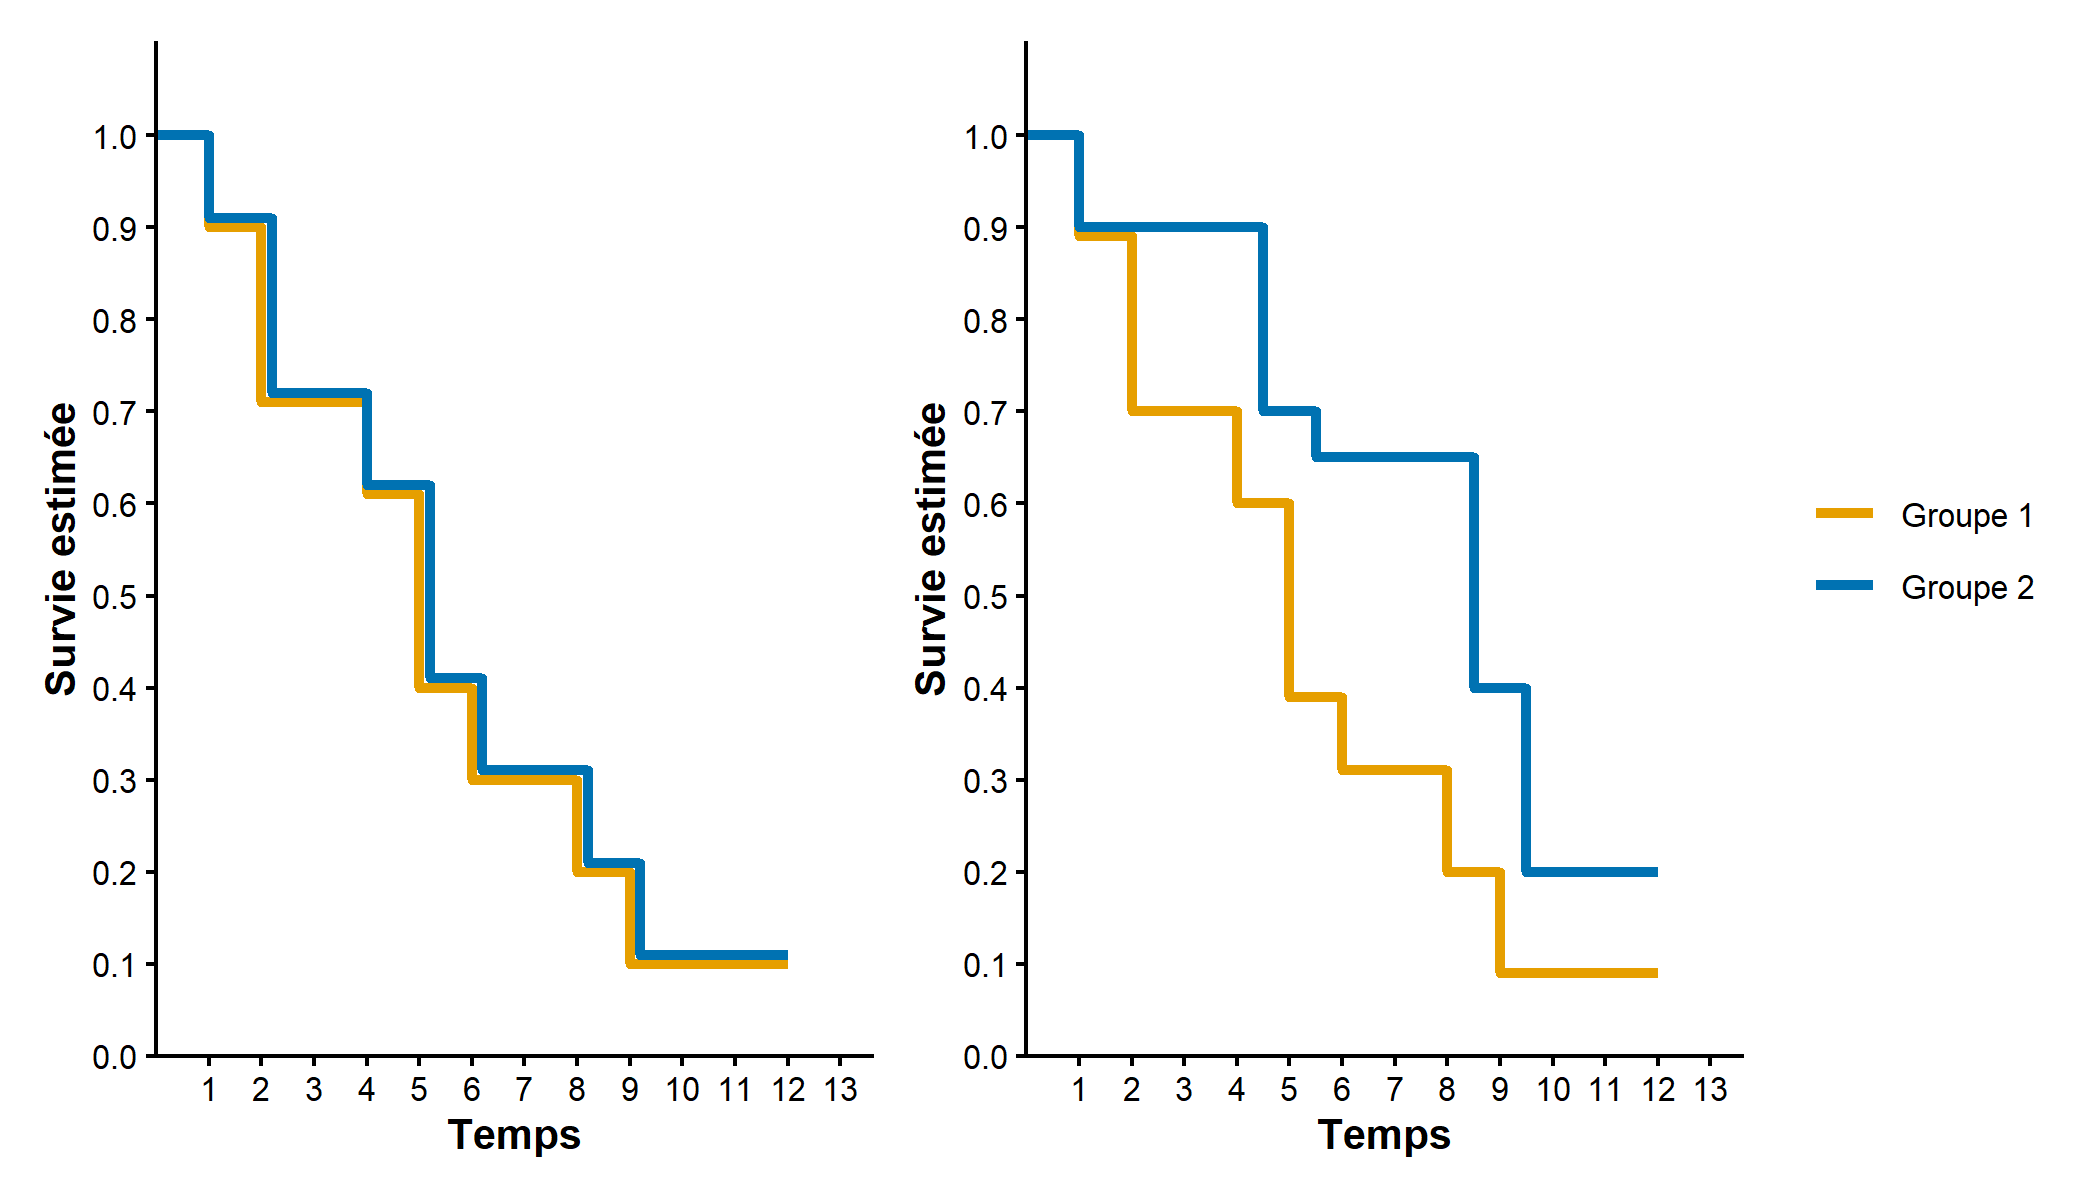
Le log-rank est particulièrement utile lorsque les risques sont proportionnels. Lorsque l’écart entre les risques change de signe, les contributions positives et négatives à la somme observé-attendu peuvent se compenser, ce qui réduit sa puissance.
Avertissement
Dans nos données, 131 sujets décèdent sans toxoplasmose préalable. Le décès empêche définitivement la survenue ultérieure de l’évènement étudié : il s’agit d’un évènement concurrent, et non d’une simple perte de suivi. La censure peut alors être informative !
Nous l’avons dit, il existe des méthodes spécifiques pour gérer ce genre de scénario (typiquement, on utilise une fonction d’incidence cumulée, avec l’estimateur d’Aalen-Johansen (Odd O. Aalen et Søren Johansen, 1978 (Aalen et Johansen 1978)) par exemple). Nous ne rentrerons pas plus dans les détails ici.
Les références
Aalen, Odd O., et Søren Johansen. 1978. « An Empirical Transition Matrix for Non-Homogeneous Markov Chains Based on Censored Observations ». Scandinavian Journal of Statistics 5 (3): 141‑50. https://www.jstor.org/stable/4615704.
Greenwood, Major. 1926. A Report on the Natural Duration of Cancer. Reports on Public Health et Medical Subjects 33. His Majesty’s Stationery Office. https://wellcomecollection.org/works/dyw3nj4k.
Mantel, Nathan. 1966. « Evaluation of Survival Data and Two New Rank Order Statistics Arising in Its Consideration ». Cancer Chemotherapy Reports 50 (3): 163‑70. https://pubmed.ncbi.nlm.nih.gov/5910392/.
Peto, Richard, et Julian Peto. 1972. « Asymptotically Efficient Rank Invariant Test Procedures ». Journal of the Royal Statistical Society: Series A (General) 135 (2): 185‑98. https://doi.org/10.2307/2344317.