6 Hypothèses et diagnostics du modèle
6.1 Hypothèses du modèle de régression linéaire
L’avantage d’un modèle, c’est qu’on simplifie la réalité. Le désavantage, c’est qu’on doit vérifier qu’on ait le droit de simplifier de la sorte.
Les hypothèses classiques portent sur les erreurs conditionnellement aux covariables.
| Hypothèse | Formulation |
|---|---|
| Normalité | \(\varepsilon_i\mid\mathbf X\sim\mathcal N(0,\sigma^2)\) |
| Erreurs de moyenne nulle | \(\mathbb E(\varepsilon_i\mid\mathbf X)=0\) |
| Homoscédasticité | \(\mathrm{Var}(\varepsilon_i\mid\mathbf X)=\sigma^2\) |
| Indépendance | \(\varepsilon_i\perp\!\!\!\perp\varepsilon_j\mid\mathbf X\) pour \(i\neq j\) |
| Linéarité | \(\mathbb E(Y_i\mid\mathbf X)=\beta_0+\beta_1x_{i1}+\cdots+\beta_px_{ip}\) |
Note
L’écriture compacte \(\varepsilon_i \mid \mathbf{X} \overset{\textcolor{red}{\text{i.i.d.}}}{\sim} \textcolor{blue}{\mathcal{N}}(\textcolor{teal}{0}, \sigma^2)\) combine les hypothèses de normalité, d’erreurs de moyenne nulle, d’homoscédasticité et d’indépendance.
Pour me souvenir des hypothèses, je me rappelle de l’acronyme NHIL (super pour l’appareil photo, génial !)
L’hypothèse de linéarité correspond à notre propos tenu précédemment, avec la figure 1 de la section 1. Pour l’indépendance, cela dépend des données que vous avez. Typiquement, si rien n’indique que des données sont corrélées (p. ex., mesures répétées dans les données longitudinales), on peut assumer l’indépendance. Pour les autres hypothèses, on doit d’abord estimer un modèle de régression, puis vérifier si elles semblent plausibles. On en parle en Section 6.2.
Avertissement
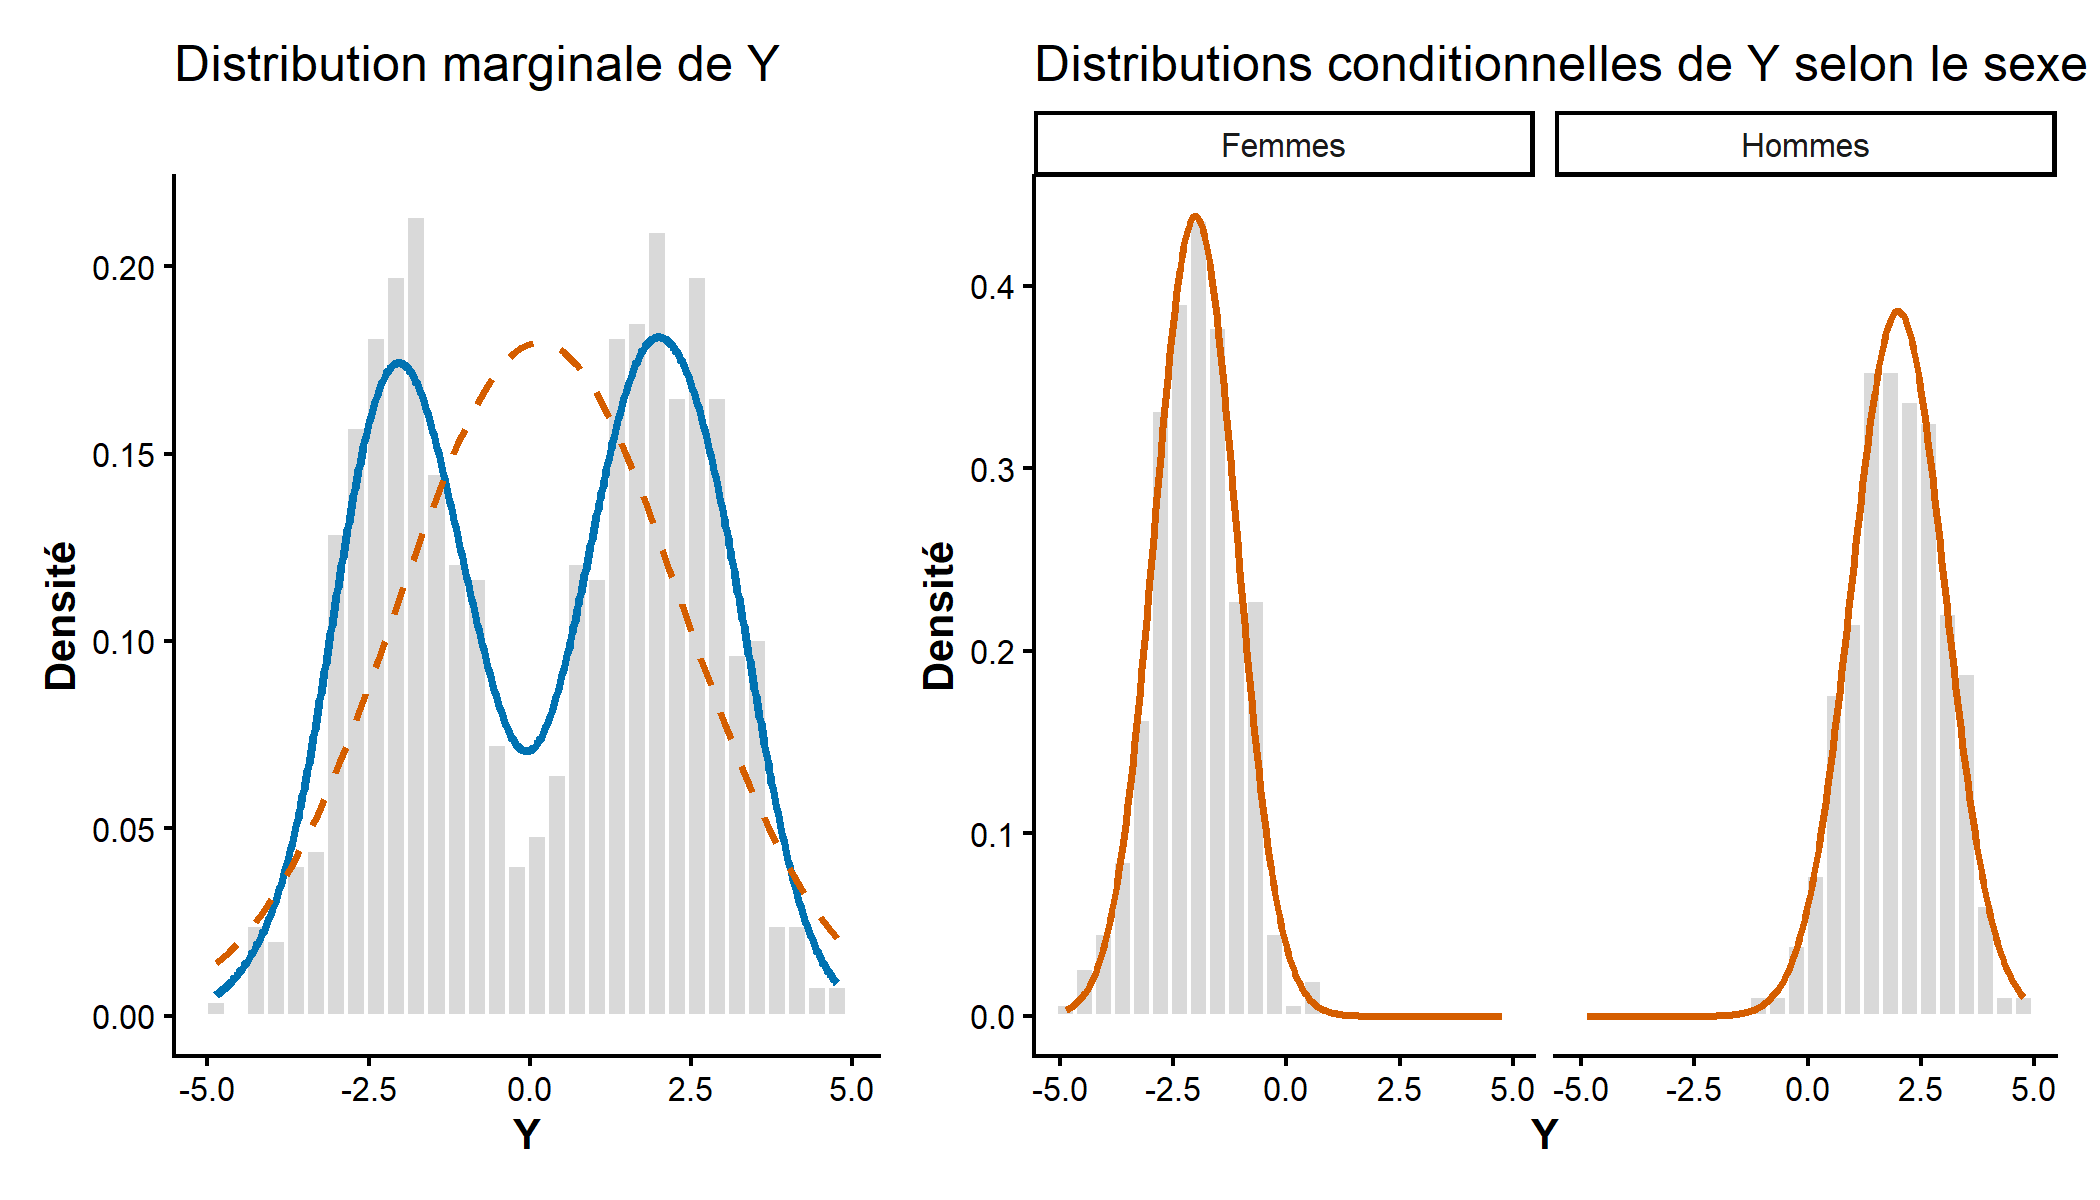
Une confusion fréquente consiste à penser que \(Y\) doit être normalement distribuée. En régression linéaire, l’hypothèse de normalité porte surtout sur les erreurs, donc sur la distribution de \(Y\) autour de sa moyenne conditionnelle.
6.2 Diagnostics du modèle
Après avoir estimé un modèle, il faut vérifier que les hypothèses du modèle soient plus ou moins respectées. Pour cela, on analyse les résidus, qui correspondent à l’écart entre la valeur observée \(y_i\) et la valeur prédite par le modèle \(\widehat y_i\) : \[ e_i=y_i-\widehat y_i \]
Cette analyse est surtout visuelle. Pour l’hypothèse…
- … de linéarité et d’homoscédasticité, on regarde les résidus en fonction des valeurs prédites : on regarde si les points sont aléatoirement dispersés autour de zéro (la droite horizontale) et sans grosses tendances ;
- … de normalité des résidus, on regarde le QQ-plot des résidus standardisés : on regarde si les observations se retrouvent approximativement sur la droite diagonale.
On peut aussi rechercher les observations susceptibles d’influencer fortement le modèle. Elles ne doivent pas être supprimées automatiquement : il faut d’abord vérifier leur validité, notamment pour exclure une erreur de saisie. Trois mesures sont couramment utilisées :
- les résidus standardisés repèrent les observations mal prédites, donc atypiques en \(Y\). On considère qu’une valeur absolue supérieure à 2 est élevée ;
- le levier repère les profils inhabituels en \(X\). Une valeur supérieure à \(2k/n\), où \(k\) est le nombre de coefficients estimés, est considérée élevée ;
- la distance de Cook mesure l’influence d’une observation sur les coefficients du modèle en combinant résidu et levier. Une valeur supérieure à \(4/n\) signale une observation potentiellement influente.
Note
Une observation peut être :
- atypique en \(Y\) : grand résidu standardisé ;
- atypique en \(X\) : levier élevé ;
- influente (l’enlever modifierait fortement les coefficients) : grande distance de Cook.
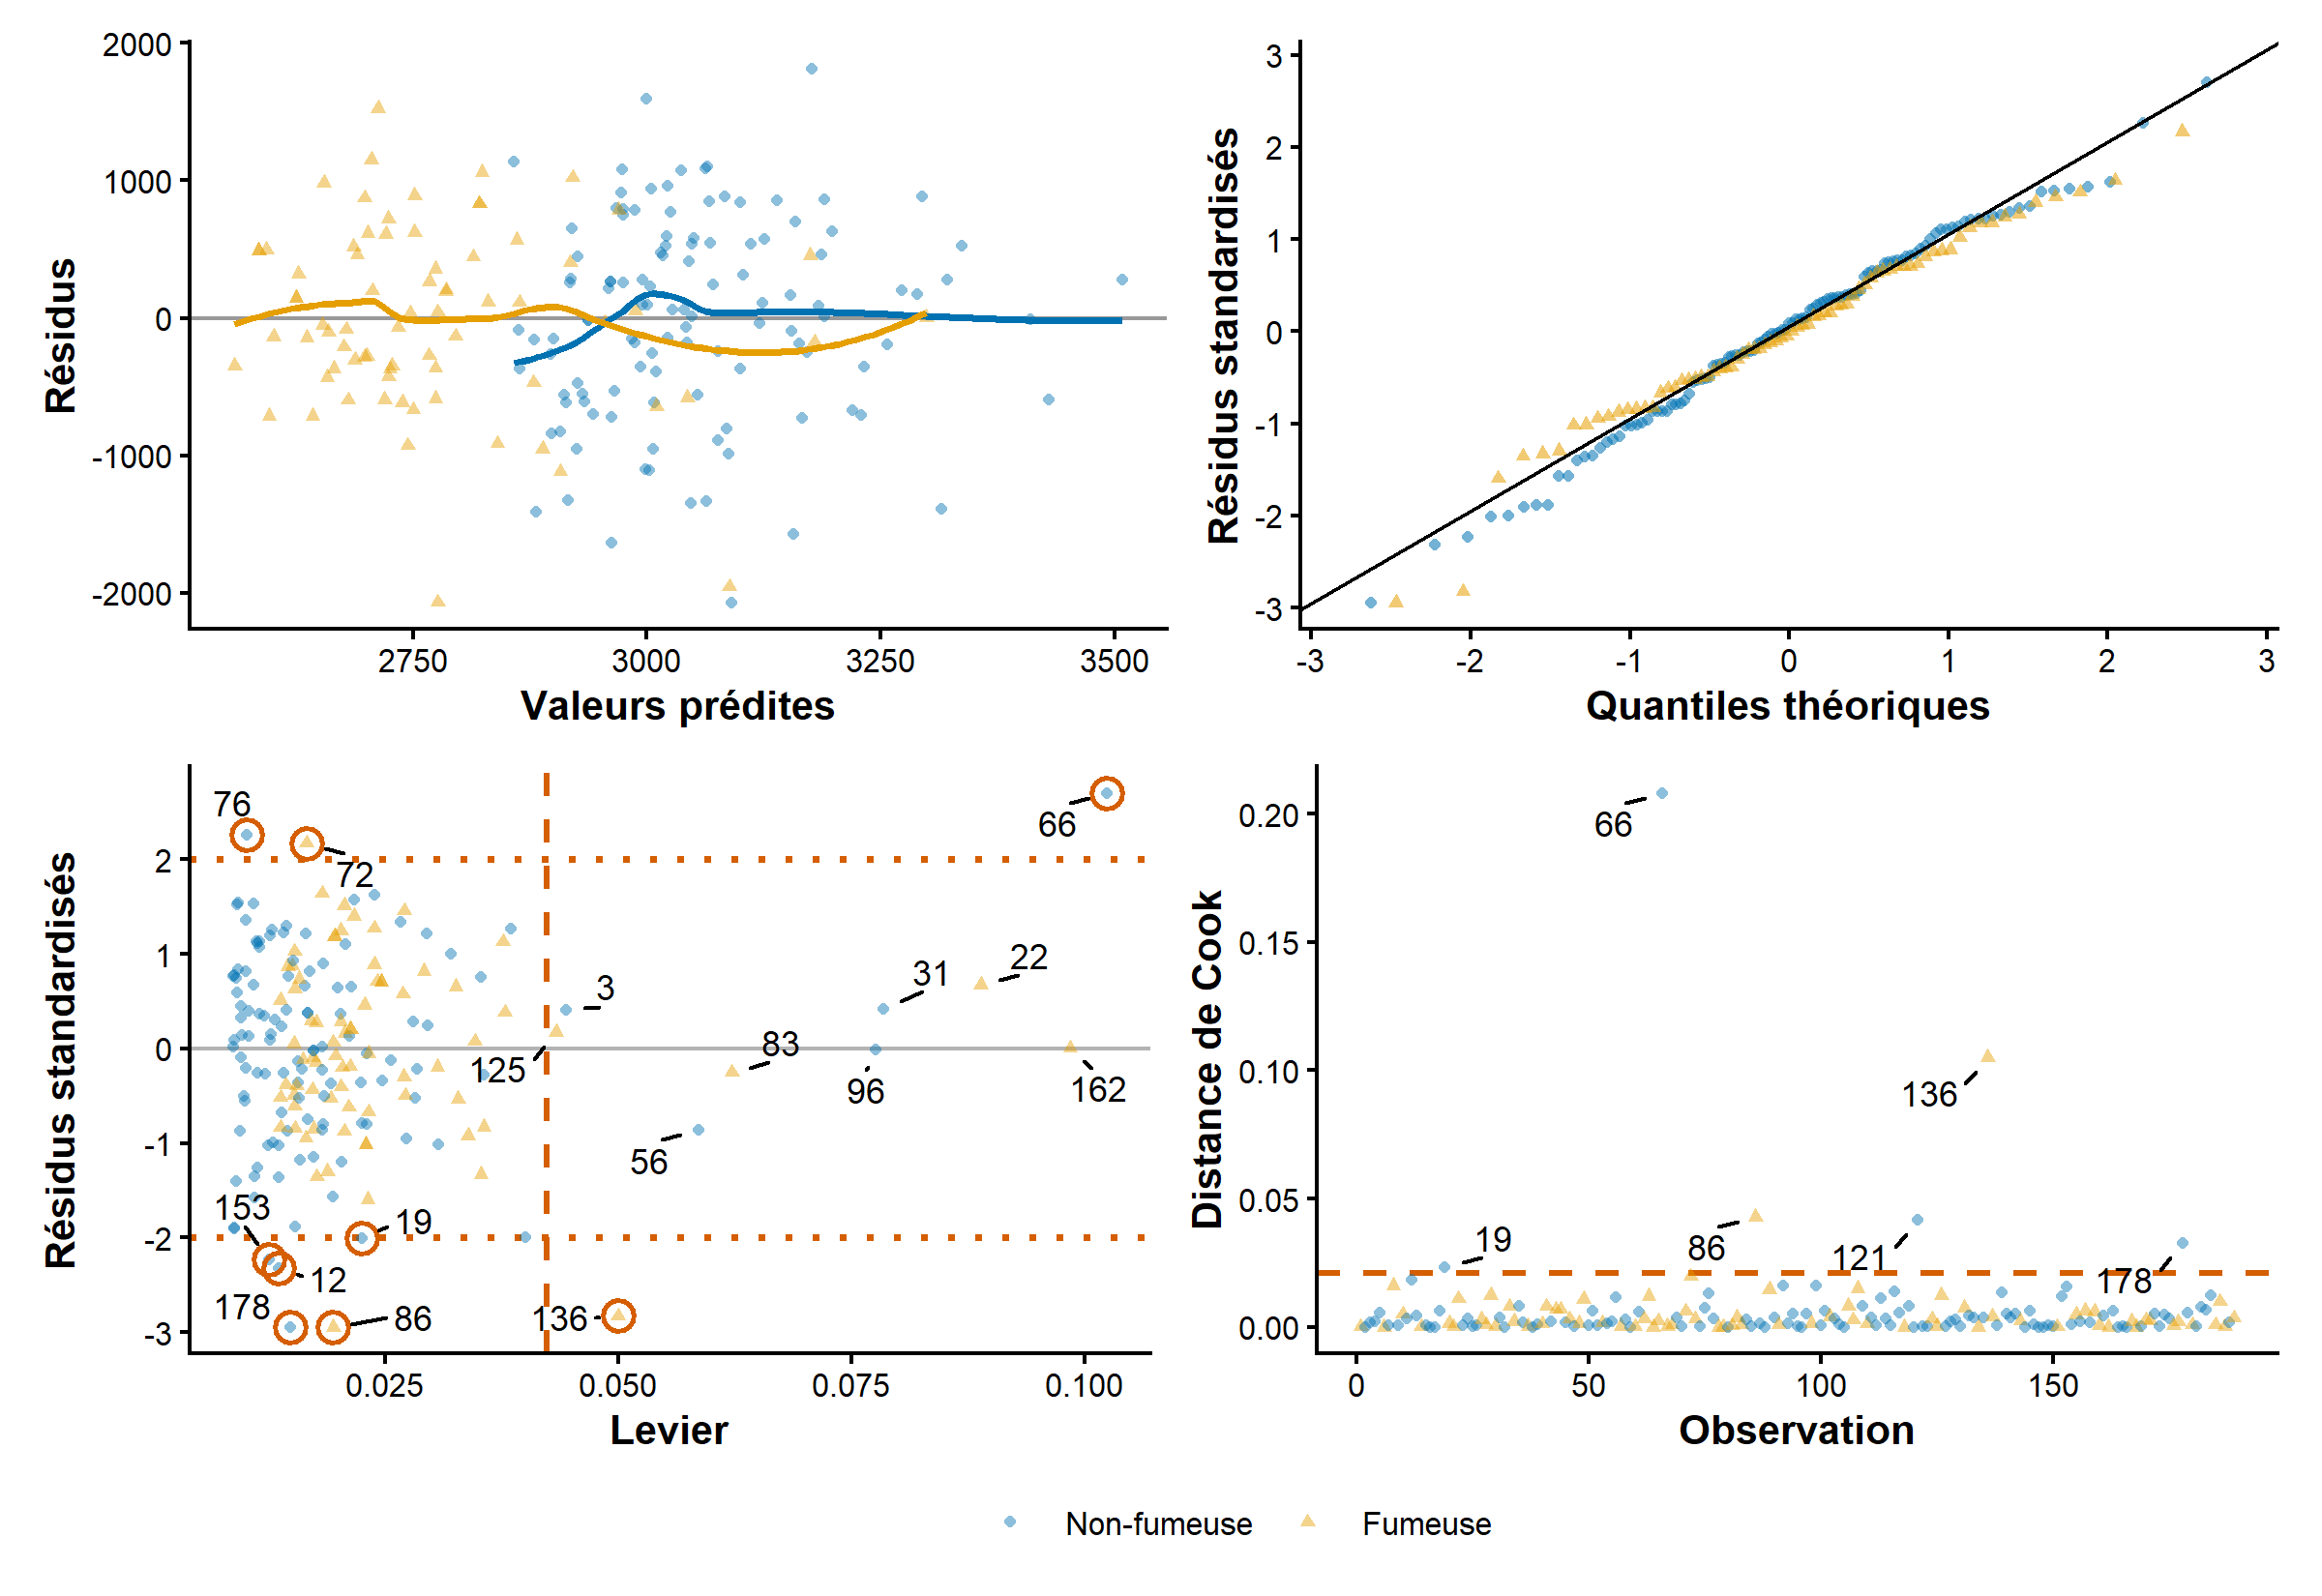
BWT ~ AGE + LWT + SMOKE. De gauche à droite et de haut en bas : résidus selon les valeurs prédites (linéarité et homogénéité de la variance), QQ-plot des résidus standardisés (normalité), levier (profils de covariables inhabituels) et distance de Cook (observations potentiellement influentes). Sur le graphique du levier, les lignes horizontales correspondent à \(r=-2\) et \(r=+2\), la ligne verticale au seuil \(2k/n\) et les cercles orange aux observations telles que \(|r|>2\). Les numéros identifient les observations qui dépassent au moins un repère.
- Le nuage des résidus est globalement centré autour de zéro, sans effet d’entonnoir marqué. Malgré les légères ondulations des courbes lissées, la linéarité semble OK ;
- Le QQ-plot est satisfaisant au centre, mais moins bon dans les extrémités : la normalité paraît donc approximative, avec quelques résidus plus extrêmes qu’attendu (peut-être liés aux observations atypiques identifiées ci-dessous) ;
- Neuf observations dépassent \(|r|=2\). Les observations 66 et 136 cumulent un résidu standardisé important et un levier supérieur à \(2k/n \approx 0{,}042\). À l’inverse, un levier élevé accompagné d’un résidu proche de zéro, comme pour les observations 96 et 162, n’implique pas à lui seul une forte influence ;
- Six observations dépassent le repère de Cook \(4/n \approx 0{,}021\) ; les observations 66 et 136 se distinguent nettement. Les enlever pourrait avoir un impact sur les coefficients du modèle ;
- Pour toutes ces observations, il faut vérifier qu’il n’y a pas d’erreur de saisie. Pour les observations influentes, on peut envisager de refaire l’analyse sans ces observations pour voir si les résultats changent beaucoup. Quoi qu’il en soit, il faudrait en discuter avec ses collègues et ne pas se contenter de supprimer les observations “à la va-vite”.
Avertissement
Un diagnostic ne “prouve” pas une hypothèse, mais aide à repérer un potentiel problème.