options(OutDec = ",", scipen = 999)
set.seed(67)

library(dplyr)
library(ggplot2)
library(gtsummary)

theme_gtsummary_language(
    language = "fr",
    decimal.mark = ",",
    # 95% CI separator : " - " à " ; "
    ci.sep = " ; ",
    big.mark = " "
)
theme_gtsummary_compact()

# Présentation commune des tableaux de régression
formater_estimation_table <- function(x) {
    gtsummary::style_number(x, digits = 2, decimal.mark = ",", big.mark = " ")
}
formater_ic_table <- function(x) {
    gtsummary::style_number(x, digits = 1, decimal.mark = ",", big.mark = " ")
}
formater_p_table <- function(p) {
    ifelse(is.na(p), NA_character_,
        ifelse(p < 0.001, "< 0,001", formatC(p, format = "f", digits = 3, decimal.mark = ",")))
}
presenter_table_regression <- function(tableau) {
    tableau |>
        modify_fmt_fun(c(conf.low, conf.high) ~ formater_ic_table) |>
        modify_column_merge(
            pattern = "[{conf.low} ; {conf.high}]",
            rows = !is.na(conf.low) & !is.na(conf.high)
        ) |>
        modify_header(
            label = "**Terme**", estimate = "**Estimation**",
            conf.low = "**IC 95 %**", p.value = "**p-valeur**"
        )
}

load("../../data/birthweight.RData")
birthweight <- data

bw <- birthweight |>
    transmute(
        faible_poids = factor(LOW, levels = c(0, 1), labels = c("Non", "Oui")),
        poids_naissance = BWT,
        age = AGE,
        age10 = AGE / 10,
        poids_mere_lb = LWT,
        poids_mere_10lb = LWT / 10,
        tabagisme = factor(SMOKE, levels = c(0, 1), labels = c("Non-fumeuse", "Fumeuse")),
        hypertension = factor(HT, levels = c(0, 1), labels = c("Non", "Oui")),
        origine = factor(RACE, levels = c(1, 2, 3), labels = c("Caucasienne", "Afro-américaine", "Autre"))
)Et avec R ?
On prépare d’abord les données :
Estimer un modèle
Pour estimer un modèle, rien de plus simple :
# Association brute
modele_brut <- lm(
    poids_naissance ~ tabagisme,
    data = bw
)

# Association ajustée
modele_ajuste <- lm(
    poids_naissance ~ age + poids_mere_lb + tabagisme + origine,
    data = bw
)

# Avec une interaction
## on utilise *
modele_interaction <- lm(
    poids_naissance ~ age * tabagisme,
    data = bw
)

## on écrit entièrement la relation (x1*x2 = x1 + x2 + x1:x2)
modele_interaction <- lm(
    poids_naissance ~ age + tabagisme + age:tabagisme,
    data = bw
)

# Avec une variable quantitative transformée
bw$age10 <- bw$age / 10
modele_transforme <- lm(
    poids_naissance ~ age10,
    data = bw
)
Pour avoir un résumé d’un modèle estimé, on propose trois options :
- via
summary(), qui est la fonction de base de R ;
summary(modele_ajuste)
#>
#> Call:
#> lm(formula = poids_naissance ~ age + poids_mere_lb + tabagisme +
#>     origine, data = bw)
#>
#> Residuals:
#>      Min       1Q   Median       3Q      Max
#> -2281,79  -447,32    22,18   472,27  1747,79
#>
#> Coefficients:
#>                        Estimate Std. Error t value             Pr(>|t|)
#> (Intercept)            2841,961    321,334   8,844 0,000000000000000767 ***
#> age                      -2,036      9,817  -0,207             0,835894
#> poids_mere_lb             3,999      1,737   2,302             0,022480 *
#> tabagismeFumeuse       -400,326    109,207  -3,666             0,000323 ***
#> origineAfro-américaine -511,535    157,028  -3,258             0,001339 **
#> origineAutre           -400,607    119,542  -3,351             0,000978 ***
#> ---
#> Signif. codes:  0 '***' 0,001 '**' 0,01 '*' 0,05 '.' 0,1 ' ' 1
#>
#> Residual standard error: 681,9 on 183 degrees of freedom
#> Multiple R-squared:  0,1484, Adjusted R-squared:  0,1251
#> F-statistic: 6,377 on 5 and 183 DF, p-value: 0,00001744- via la librairie
broomet ses fonctionstidy()etglance()
| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 2841,961445 | 321,334241 | 8,8442534 | 0,0000000 |
| age | -2,036486 | 9,817054 | -0,2074437 | 0,8358940 |
| poids_mere_lb | 3,999113 | 1,737475 | 2,3016806 | 0,0224795 |
| tabagismeFumeuse | -400,326420 | 109,206665 | -3,6657691 | 0,0003230 |
| origineAfro-américaine | -511,535272 | 157,027814 | -3,2576093 | 0,0013392 |
| origineAutre | -400,606590 | 119,541915 | -3,3511810 | 0,0009775 |
| r.squared | adj.r.squared | sigma | statistic | p.value | df | logLik | AIC | BIC | deviance | df.residual | nobs |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0,148382 | 0,1251138 | 681,8937 | 6,377017 | 0,0000174 | 5 | -1498,332 | 3010,664 | 3033,356 | 85091158 | 183 | 189 |
- via la librairie
gtsummaryet sa fonctiontbl_regression()
tableau_lineaire <- modele_ajuste |>
    gtsummary::tbl_regression(
        label = list(
            age ~ "Âge maternel (+1 an)",
            poids_mere_lb ~ "Poids maternel (livres)",
            tabagisme ~ "Tabagisme maternel",
            origine ~ "Origine maternelle"
        ),
        estimate_fun = formater_estimation_table,
        pvalue_fun = formater_p_table
    ) |>
    add_global_p(
        include = c(origine),
        # "II" = modèle sans interaction ; "III" = avec interaction
        type = "II",
        keep = TRUE
    ) |>
    bold_labels() |>
    presenter_table_regression()

tableau_lineaire |> as_gt()| Terme | Estimation | IC 95 % | p-valeur |
|---|---|---|---|
| Âge maternel (+1 an) | -2,04 | [-21,4 ; 17,3] | 0,836 |
| Poids maternel (livres) | 4,00 | [0,6 ; 7,4] | 0,022 |
| Tabagisme maternel | |||
| Non-fumeuse | — | — | |
| Fumeuse | -400,33 | [-615,8 ; -184,9] | < 0,001 |
| Origine maternelle | < 0,001 | ||
| Caucasienne | — | — | |
| Afro-américaine | -511,54 | [-821,4 ; -201,7] | 0,001 |
| Autre | -400,61 | [-636,5 ; -164,7] | < 0,001 |
| Abréviation: IC = intervalle de confiance | |||
Si vous êtes amenés à faire des analyses univariées, sachez que tbl_uvregression() estime automatiquement un modèle séparé pour chaque variable explicative :
tableau_univarie <- bw |>
    tbl_uvregression(
        y = poids_naissance,
        method = lm,
        include = c(age, tabagisme, origine),
        label = list(
            age ~ "Âge maternel (+1 an)",
            tabagisme ~ "Tabagisme maternel",
            origine ~ "Origine maternelle"
        ),
        estimate_fun = formater_estimation_table,
        pvalue_fun = formater_p_table
    ) %>%
    add_global_p(
        include = c(origine),
        keep = TRUE,
        type = "II"
    ) |>
    bold_labels() |>
    presenter_table_regression()

tableau_univarie |> as_gt()| Terme | N | Estimation | IC 95 % | p-valeur |
|---|---|---|---|---|
| Âge maternel (+1 an) | 189 | 12,36 | [-7,4 ; 32,1] | 0,219 |
| Tabagisme maternel | 189 | |||
| Non-fumeuse | — | — | ||
| Fumeuse | -281,71 | [-492,7 ; -70,7] | 0,009 | |
| Origine maternelle | 189 | 0,008 | ||
| Caucasienne | — | — | ||
| Afro-américaine | -384,05 | [-695,5 ; -72,6] | 0,016 | |
| Autre | -299,72 | [-524,0 ; -75,5] | 0,009 | |
| Abréviation: IC = intervalle de confiance | ||||
A la limite, un avantage est de pouvoir construire une table qui compare les coefficients bruts et ajustés, grâce à la fonction tbl_merge() :
| Terme |
Analyse brute
|
Analyse ajustée
|
|||||
|---|---|---|---|---|---|---|---|
| N | Estimation | IC 95 % | p-valeur | Estimation | IC 95 % | p-valeur | |
| Âge maternel (+1 an) | 189 | 12,36 | [-7,4 ; 32,1] | 0,219 | -2,04 | [-21,4 ; 17,3] | 0,836 |
| Tabagisme maternel | 189 | ||||||
| Non-fumeuse | — | — | — | — | |||
| Fumeuse | -281,71 | [-492,7 ; -70,7] | 0,009 | -400,33 | [-615,8 ; -184,9] | < 0,001 | |
| Origine maternelle | 189 | 0,008 | < 0,001 | ||||
| Caucasienne | — | — | — | — | |||
| Afro-américaine | -384,05 | [-695,5 ; -72,6] | 0,016 | -511,54 | [-821,4 ; -201,7] | 0,001 | |
| Autre | -299,72 | [-524,0 ; -75,5] | 0,009 | -400,61 | [-636,5 ; -164,7] | < 0,001 | |
| Poids maternel (livres) | 4,00 | [0,6 ; 7,4] | 0,022 | ||||
| Abréviation: IC = intervalle de confiance | |||||||
Tester les coefficients
On peut être intéressé de tester les coefficients “à la main”. On a présenté dans le cours le test de Student, de Fisher global et de Fisher partiel.
En pratique, le plus simple est de
- regarder le tableau de
summary()du modèle pour les tests d’un seul coefficient ; - faire un test du rapport de vraisemblance pour tester un sous-ensemble de coefficients.
Pour ce second point, on estime deux modèles : un modèle de base (qu’on appelle “complet”) et un modèle où on enlève les variables qu’on souhaite tester (qu’on appelle “réduit”). On compare ensuite les deux modèles avec la fonction anova().
Test d’un coefficient
modele_complet <- lm(
    poids_naissance ~ age + tabagisme * origine,
    data = bw
)

modele_reduit <- lm(
    poids_naissance ~ age + tabagisme + origine,
    data = bw
)

summary(modele_complet)
#>
#> Call:
#> lm(formula = poids_naissance ~ age + tabagisme * origine, data = bw)
#>
#> Residuals:
#>      Min       1Q   Median       3Q      Max
#> -2404,31  -419,69    31,89   464,88  1583,17
#>
#> Coefficients:
#>                                         Estimate Std. Error t value
#> (Intercept)                             3458,802    279,940  12,356
#> age                                       -1,155      9,998  -0,116
#> tabagismeFumeuse                        -603,710    143,963  -4,193
#> origineAfro-américaine                  -581,277    209,109  -2,780
#> origineAutre                            -618,739    143,354  -4,316
#> tabagismeFumeuse:origineAfro-américaine  258,017    318,482   0,810
#> tabagismeFumeuse:origineAutre            546,798    261,703   2,089
#>                                                     Pr(>|t|)
#> (Intercept)                             < 0,0000000000000002 ***
#> age                                                  0,90817
#> tabagismeFumeuse                                   0,0000428 ***
#> origineAfro-américaine                               0,00601 **
#> origineAutre                                       0,0000260 ***
#> tabagismeFumeuse:origineAfro-américaine              0,41891
#> tabagismeFumeuse:origineAutre                        0,03806 *
#> ---
#> Signif. codes:  0 '***' 0,001 '**' 0,01 '*' 0,05 '.' 0,1 ' ' 1
#>
#> Residual standard error: 685,3 on 182 degrees of freedom
#> Multiple R-squared:  0,1446, Adjusted R-squared:  0,1164
#> F-statistic: 5,127 on 6 and 182 DF,  p-value: 0,0000685
Test d’un sous-ensemble de coefficients
Si on veut tester l’interaction, on peut utiliser le test du rapport de vraisemblance, en comparant le modèle complet (avec l’interaction) et le modèle réduit (sans l’interaction) :
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 184 | 87554493 | NA | NA | NA | NA |
| 182 | 85471545 | 2 | 2082948 | 2,217677 | 0,1117953 |
On peut aussi utiliser la librairie car, qui permet notamment de tester toutes les variables d’un modèle sans avoir besoin de créer un modèle réduit ! Le code suivant teste chaque variable, avec un test du rapport de vraisemblance (si test.statistic = "LR") ou un test de Fisher partiel (si test.statistic = "F", par défaut) :
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 71692213,785 | 1 | 152,6587938 | 0,0000000 |
| age | 6265,446 | 1 | 0,0133414 | 0,9081722 |
| tabagisme | 8258535,619 | 1 | 17,5854255 | 0,0000428 |
| origine | 9239265,867 | 2 | 9,8368784 | 0,0000878 |
| tabagisme:origine | 2082948,328 | 2 | 2,2176772 | 0,1117953 |
| Residuals | 85471544,628 | 182 | NA | NA |
Prédire des valeurs
Enfin, pour prédire une valeur à l’aide du modèle de régression, on doit créer un nouveau jeu de données avec les valeurs des variables explicatives, puis utiliser la fonction predict().
Dans l’exemple ci-dessous, on prédit la valeur moyenne du poids de naissance du bébé chez une femme caucasienne non-fumeuse de 20 ans, et chez une femme afro-américaine fumeuse de 30 ans.
# Valeur moyenne prévue et IC pour de nouveaux profils
nouveaux_profils <- data.frame(
    age = c(20, 30),
    tabagisme = factor(c("Non-fumeuse", "Fumeuse"), levels = levels(bw$tabagisme)),
    origine = factor(c("Caucasienne", "Afro-américaine"), levels = levels(bw$origine))
)

predict(
    modele_complet,
    newdata = nouveaux_profils,
    interval = "confidence"
)
On prédit un poids moyen de naissance de 3,325 kg pour la femme caucasienne non-fumeuse de 20 ans, et de 2,475 kg pour la femme afro-américaine fumeuse de 30 ans.
Diagnostics
Pour le cours, nous avons codé les graphiques diagnostiques à la main, et on n’a pas utilisé le package performance. Ainsi, nous avons obscurci certaines choses à vérifier, afin de ne pas rendre plus lourd que nécessaire le cours.
En pratique, le plus simple est d’utiliser le package performance, et nous allons brièvement expliquer ce qu’il faut retenir des graphiques. Côté R, on écrit simplement :
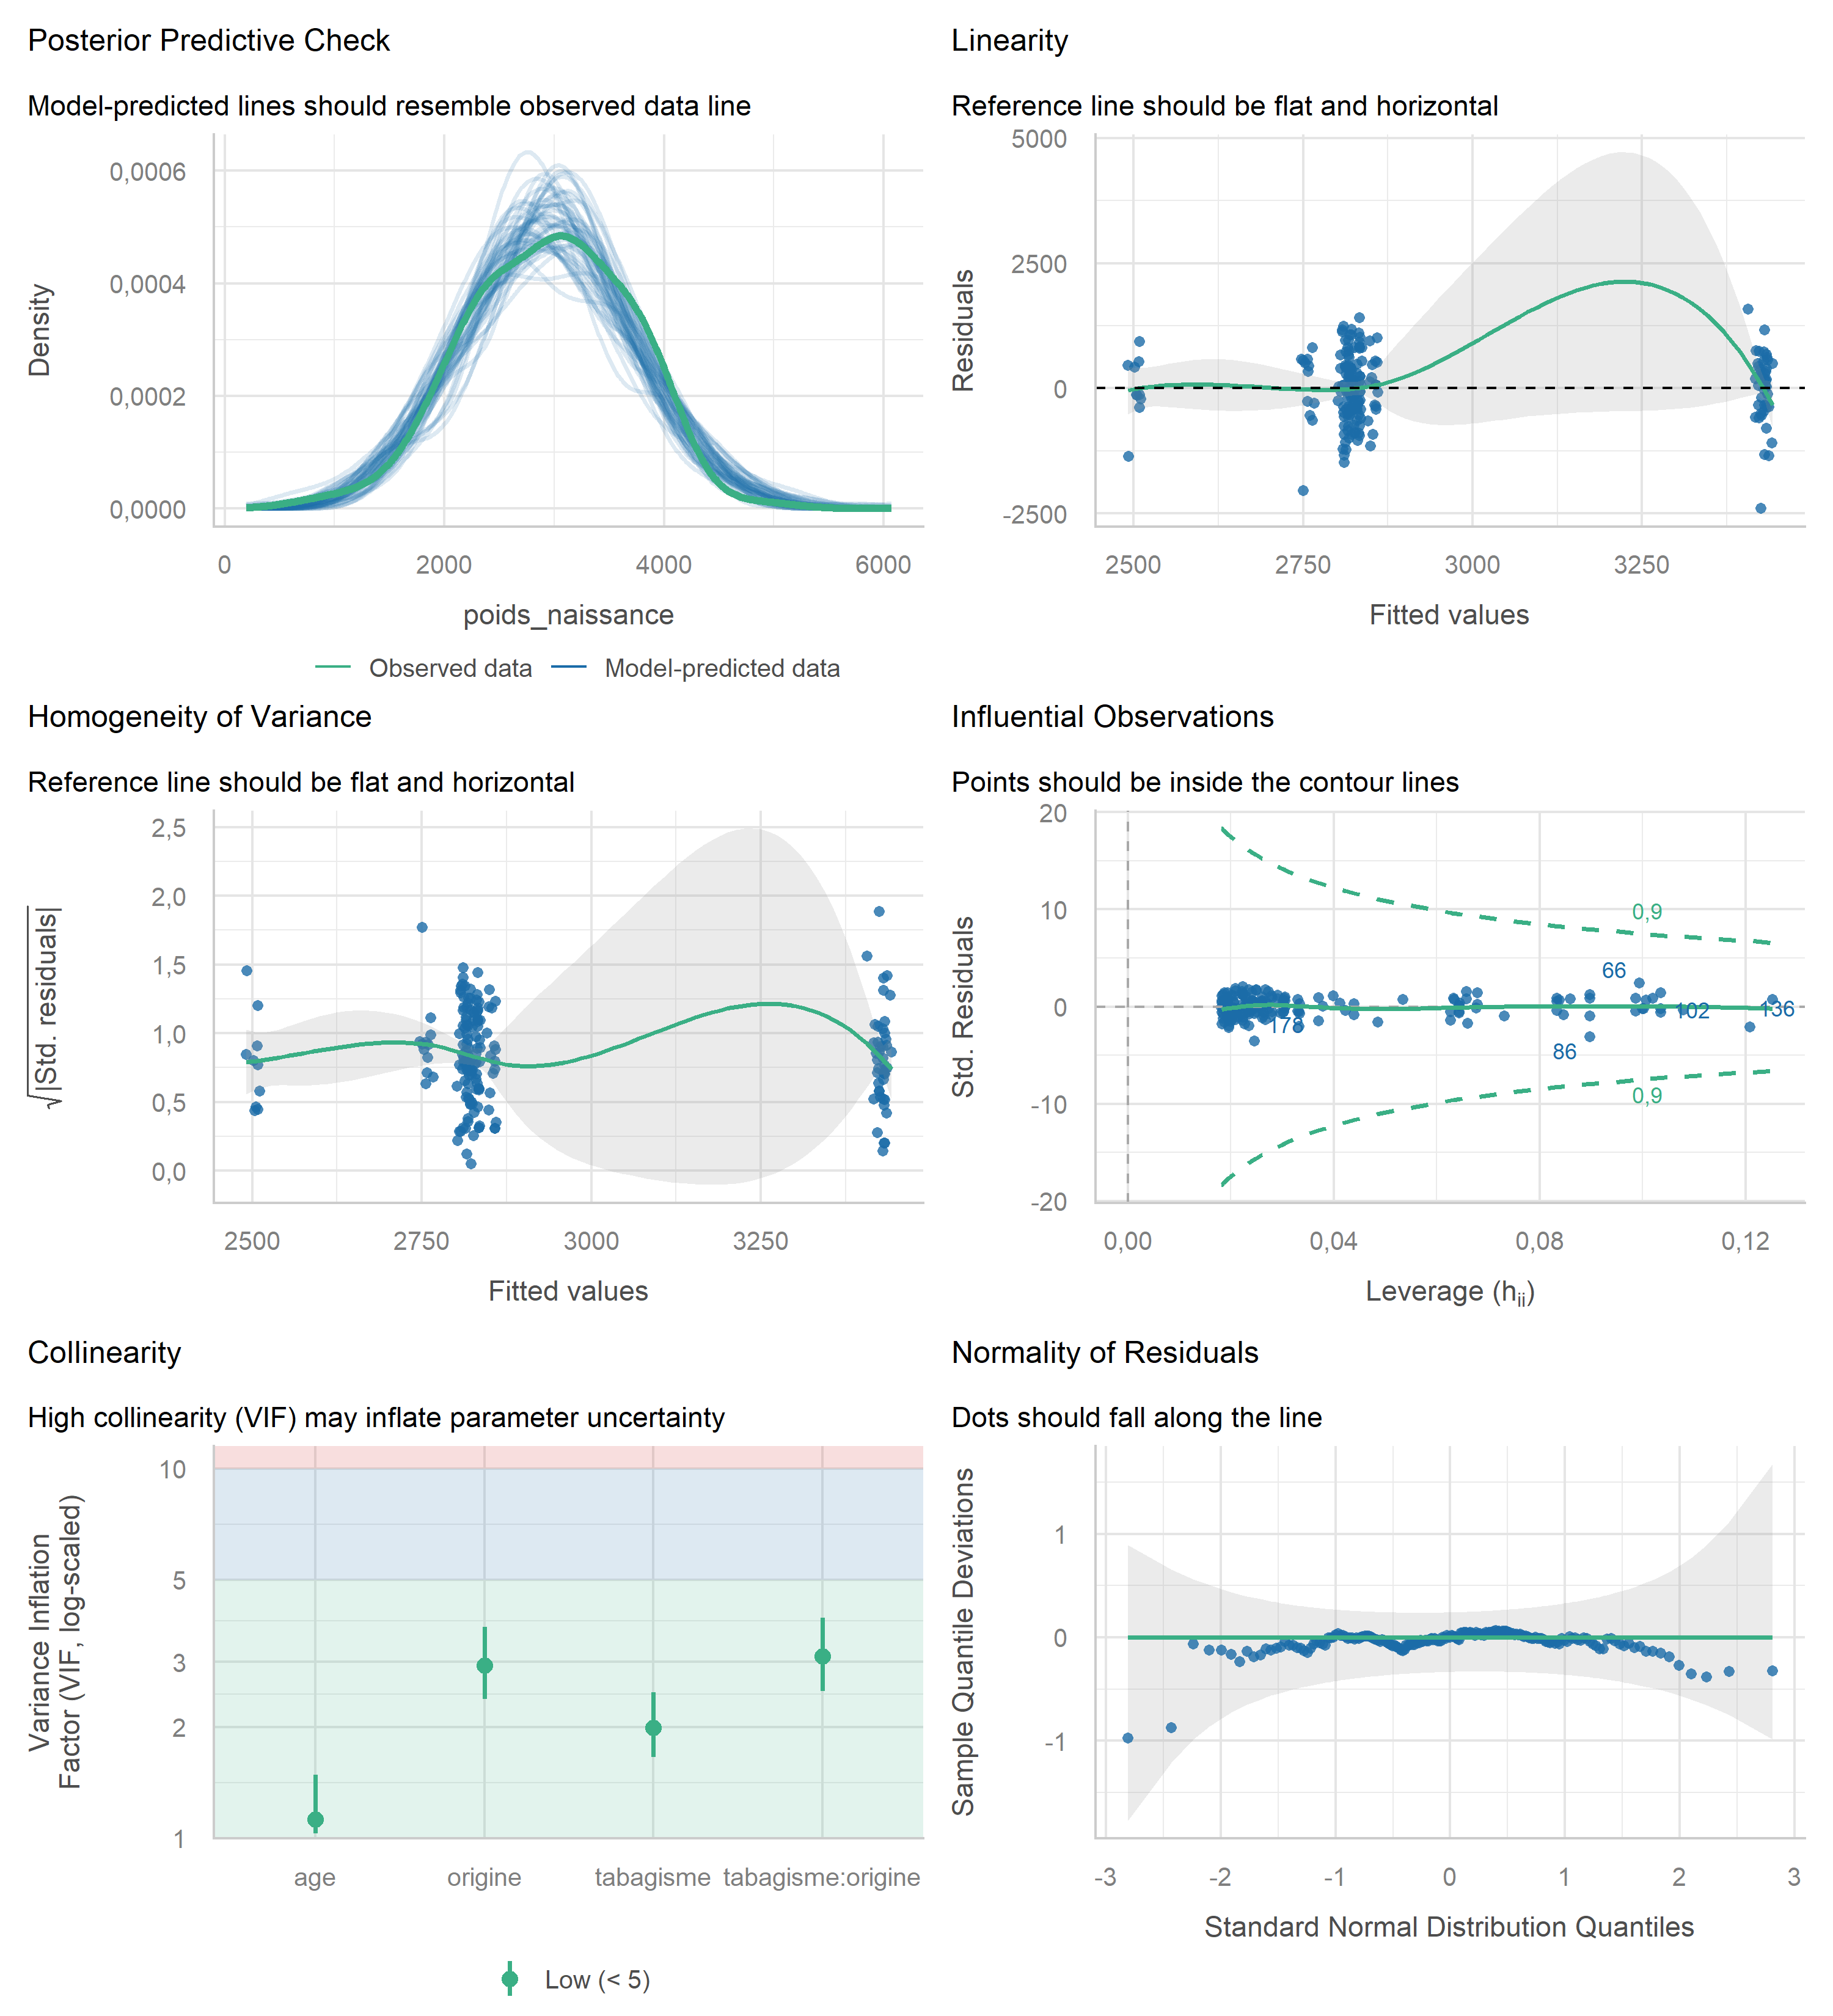
Le modèle étudié est un modèle linéaire multiple : poids_naissance ~ age + tabagisme * origine. Les diagnostics portent sur les résidus après ajustement simultané sur l’âge, le tabagisme, l’origine maternelle et leur interaction. On recherche surtout des motifs systématiques, pas un alignement parfait des points.
- Posterior Predictive Check (distribution de la réponse). Ce panneau compare la distribution observée (courbe verte) à des distributions simulées par le modèle (courbes bleues). Leur recouvrement et leur forme sont proches : le modèle reproduit raisonnablement la distribution globale des poids de naissance.
Entre nous, vous pouvez l’oublier …
Linéarité. La courbe des résidus en fonction des valeurs ajustées devrait rester horizontale autour de zéro. Sa forme apparente entre 2 800 et 3 300 g vient de l’absence de valeurs dans cet intervalle et d’un problème d’interpolation dans R ; la linéarité semble donc vérifiée.
Homogénéité de la variance. La racine de la valeur absolue des résidus standardisés devrait être horizontale, avec une dispersion comparable. La courbe est plus haute entre 2 800 et 3 300 g, mais la dispersion au sein des blocs reste similaire : l’homogénéité paraît raisonnable.
Observations influentes. Le levier et le résidu standardisé repèrent les observations atypiques ; les pointillés indiquent les niveaux de distance de Cook. La plupart des points restent dans les contours, sans observation clairement très influente.
-
Colinéarité. Le VIF (Variance Inflation Factor) détecte une colinéarité potentielle, ce qui peut gonfler fortement les coefficients et leurs erreurs-types. Un VIF < 5 est acceptable, 5-10 indique une colinéarité modérée et > 10 une colinéarité forte. Ici, aucun problème n’est détecté.
NoteOn ne l’a pas abordé dans le cours (il est déjà assez chargé), mais il ne faut jamais avoir de colinéarité quand on estime un modèle de régression.
En bref, la colinéarité apparaît lorsque deux variables explicatives contiennent une information très redondante. Par exemple, si on essaie d’estimer
Y ~ age + 2*age,ageet2*agesont exactement redondantes : le modèle ne pourra pas séparer leurs effets et affichera un message d’erreur. Sans être dans cet extrême, votre modèle peut, à tout moment, présenter une redondance qui rendra les estimations plus instables (coefficient, erreur-type).Le VIF permet alors de mesurer l’inflation de variance : il vaut 1 en l’absence de redondance et augmente lorsque l’effet propre d’une variable devient difficile à distinguer de celui des autres.
Normalité des résidus. Le QQ-plot, horizontal ici, devrait suivre la ligne de référence. Les écarts vers le bas dans les queues signalent quelques poids observés supérieurs aux prédictions, mais ne suffisent pas à conclure à une violation nette de la normalité.
Dans l’ensemble, le modèle semble raisonnablement bien ajusté aux données.
Diagnostics de modèles
-
performancepour des diagnostics généraux de modèles
Bonus - Forest plots avec ggstats
Pour finir, on voulait présenter le package ggstats pour construire des forest plots.
Un modèle
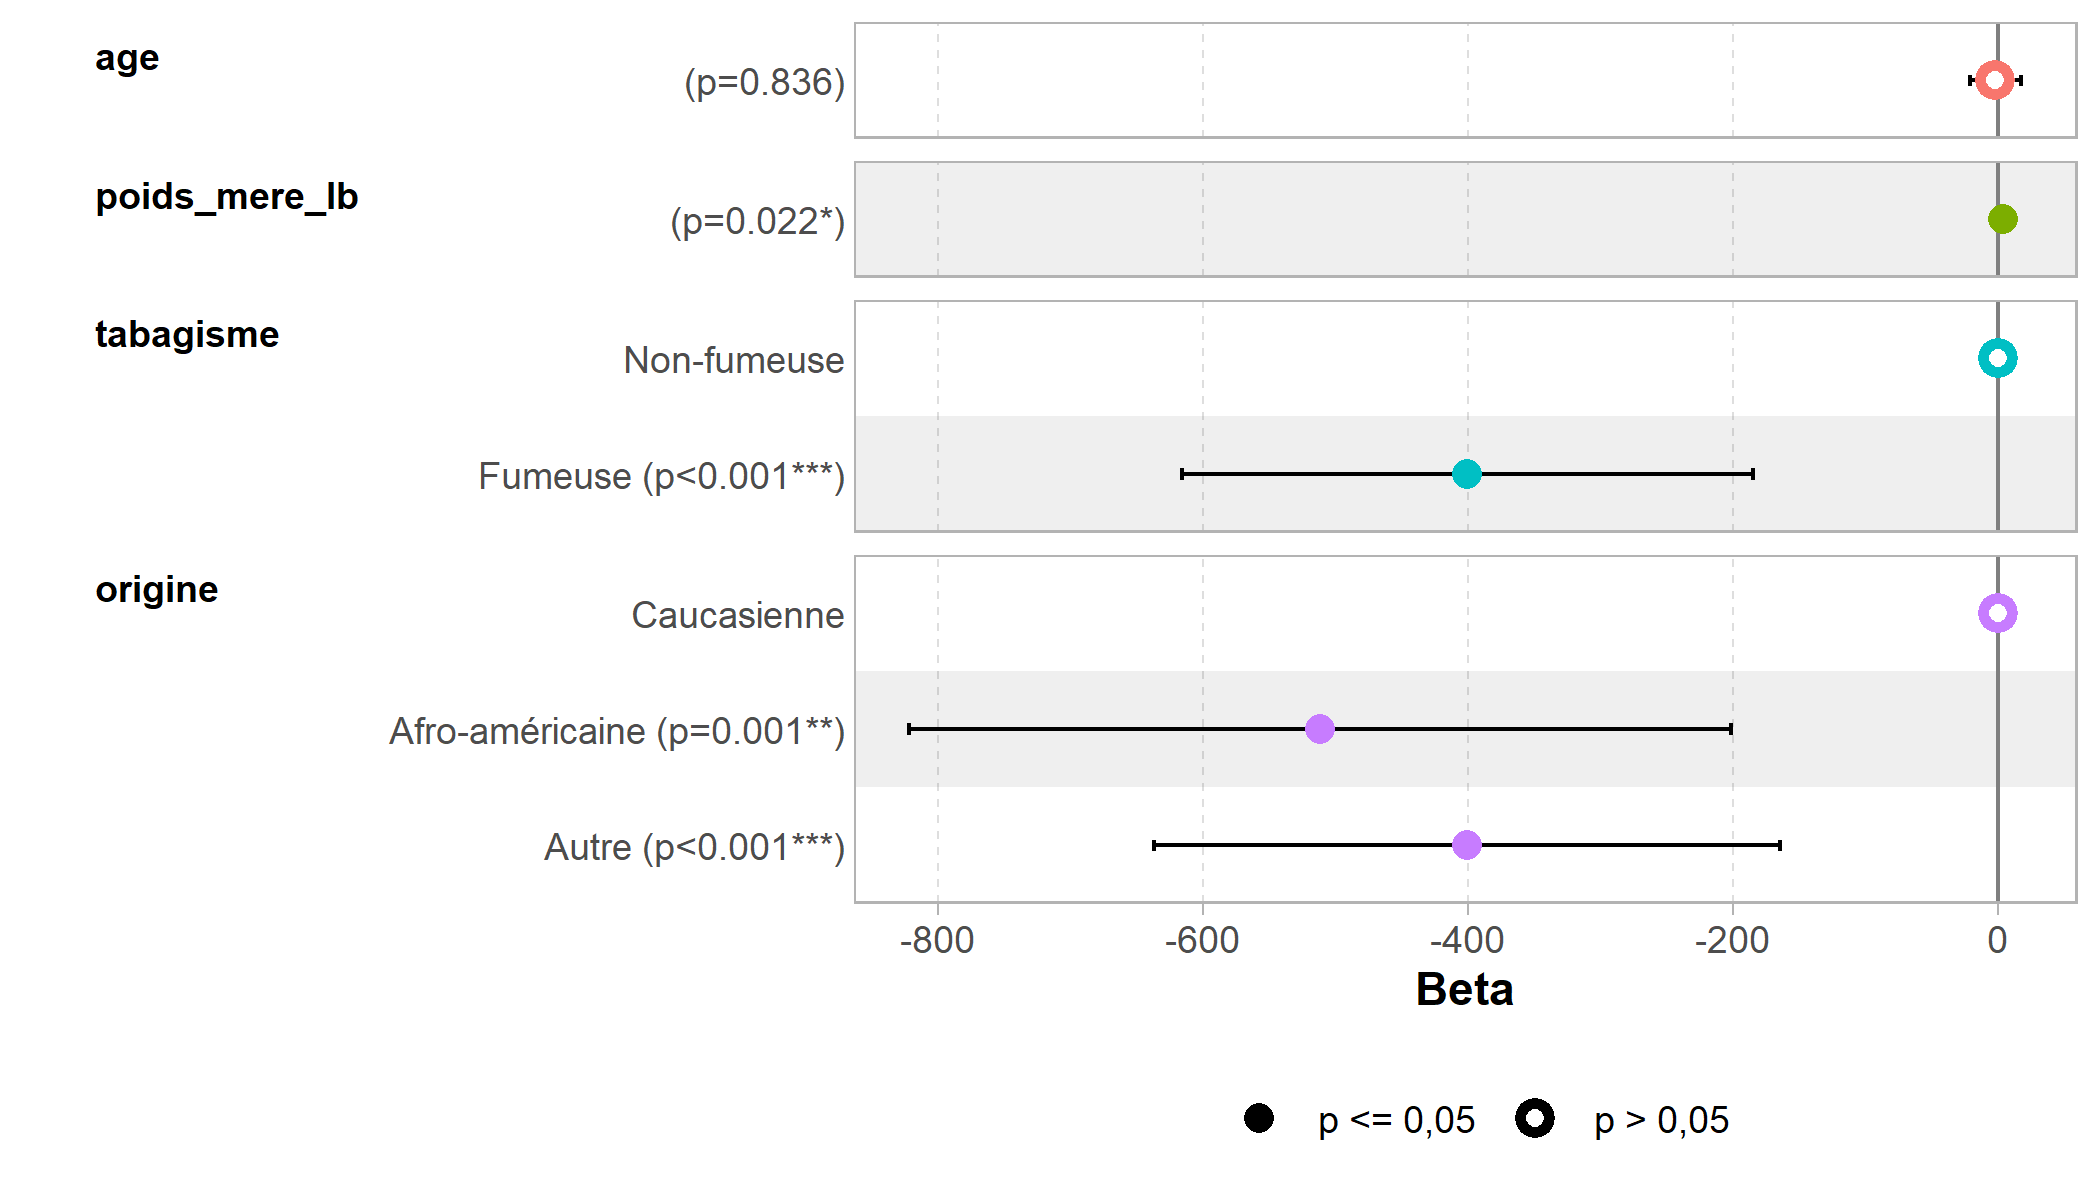
On peut monter en complexité
Si on y passe du temps, voici ce qu’on pourrait obtenir à la fin éventuellement :
formater_estimation <- function(x) {
    valeurs <- scales::label_number(accuracy = 2, decimal.mark = ",")(x)
    valeurs[!is.na(x) & x == 0] <- "Référence"
    valeurs
}

ggstats::ggcoef_table(
    model = modele_ajuste,
    conf.level = 0.95,
    variable_labels = c(
        age = "Âge maternel (+1 an)",
        poids_mere_lb = "Poids maternel (livres)",
        tabagisme = "Tabagisme maternel",
        origine = "Origine maternelle"
    ),
    table_stat = c("estimate", "ci", "p.value"),
    table_header = c("Estimation", "IC 95 %", "p-valeur"),
    table_stat_label = list(
        estimate = formater_estimation,
        conf.low = scales::label_number(accuracy = 2, decimal.mark = ","),
        conf.high = scales::label_number(accuracy = 2, decimal.mark = ","),
        p.value = scales::label_pvalue(accuracy = 0.001, decimal.mark = ",")
    ),
    ci_pattern = "[{conf.low} ; {conf.high}]",
    stripped_rows = FALSE # si TRUE, on a un fond gris une fois sur deux (défaut)
) &
    ggplot2::theme(panel.border = ggplot2::element_blank()) &
    ggplot2::labs(x = "Coefficient (IC 95%)")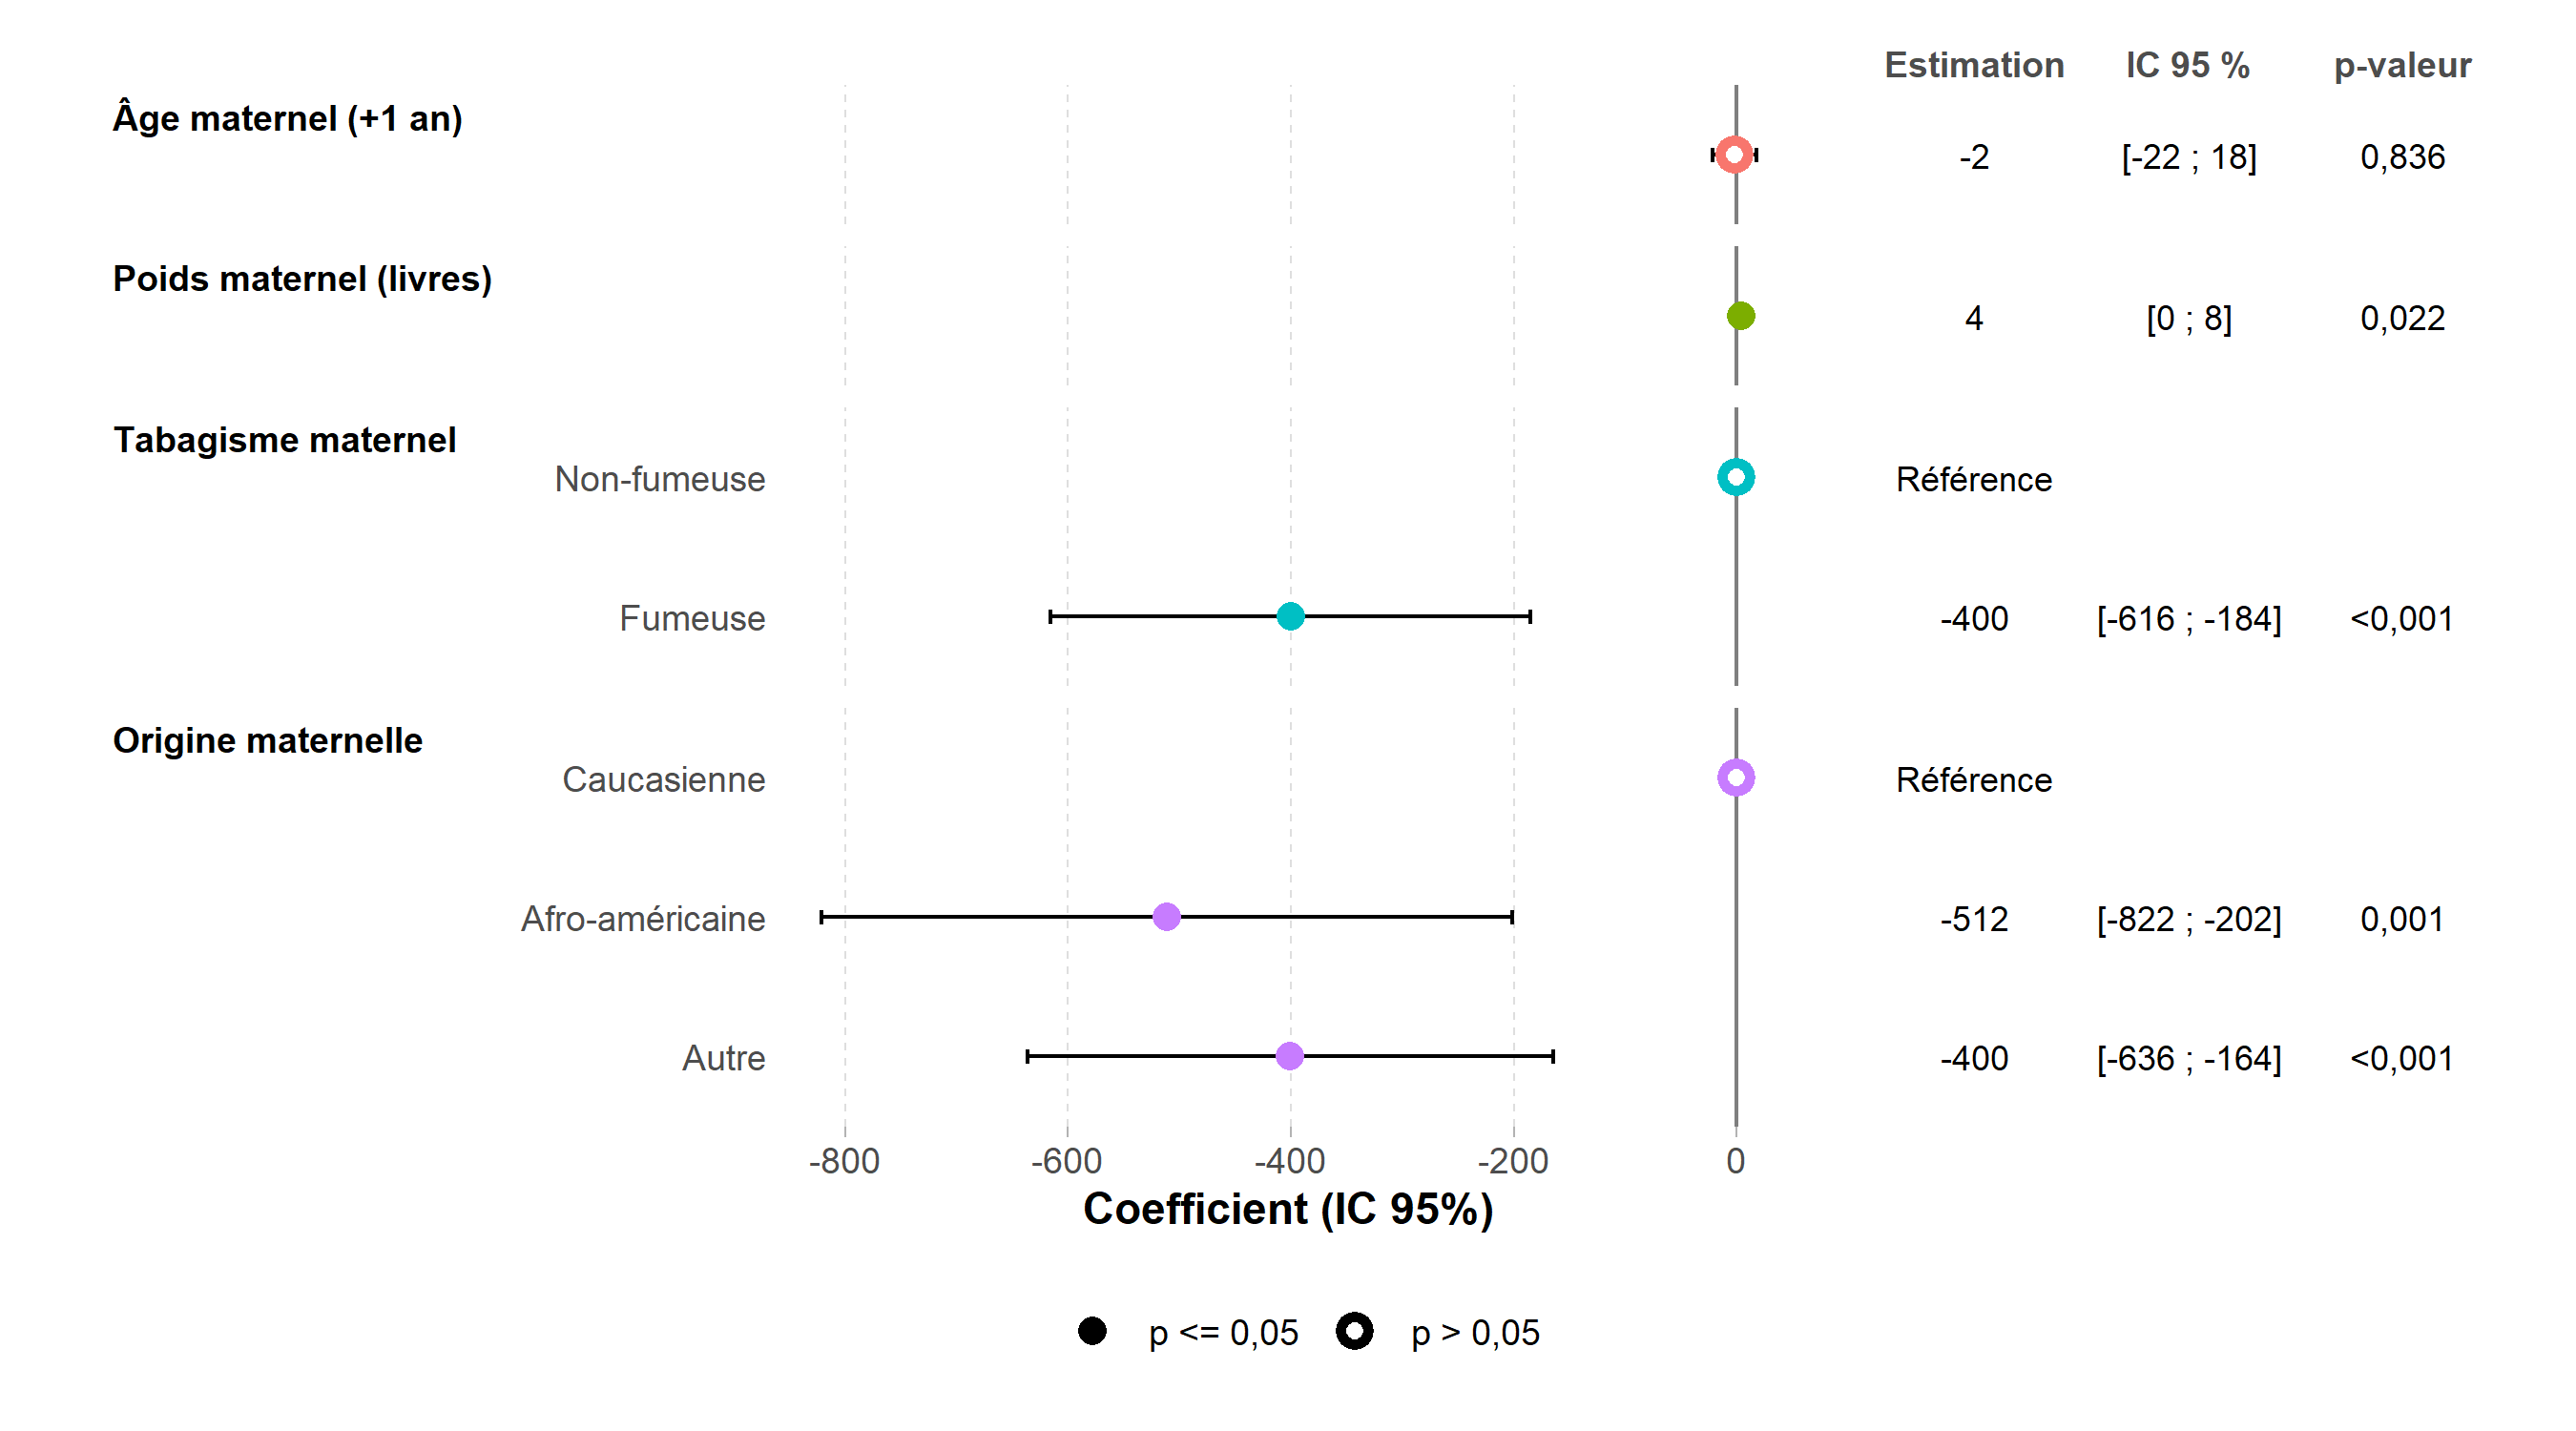
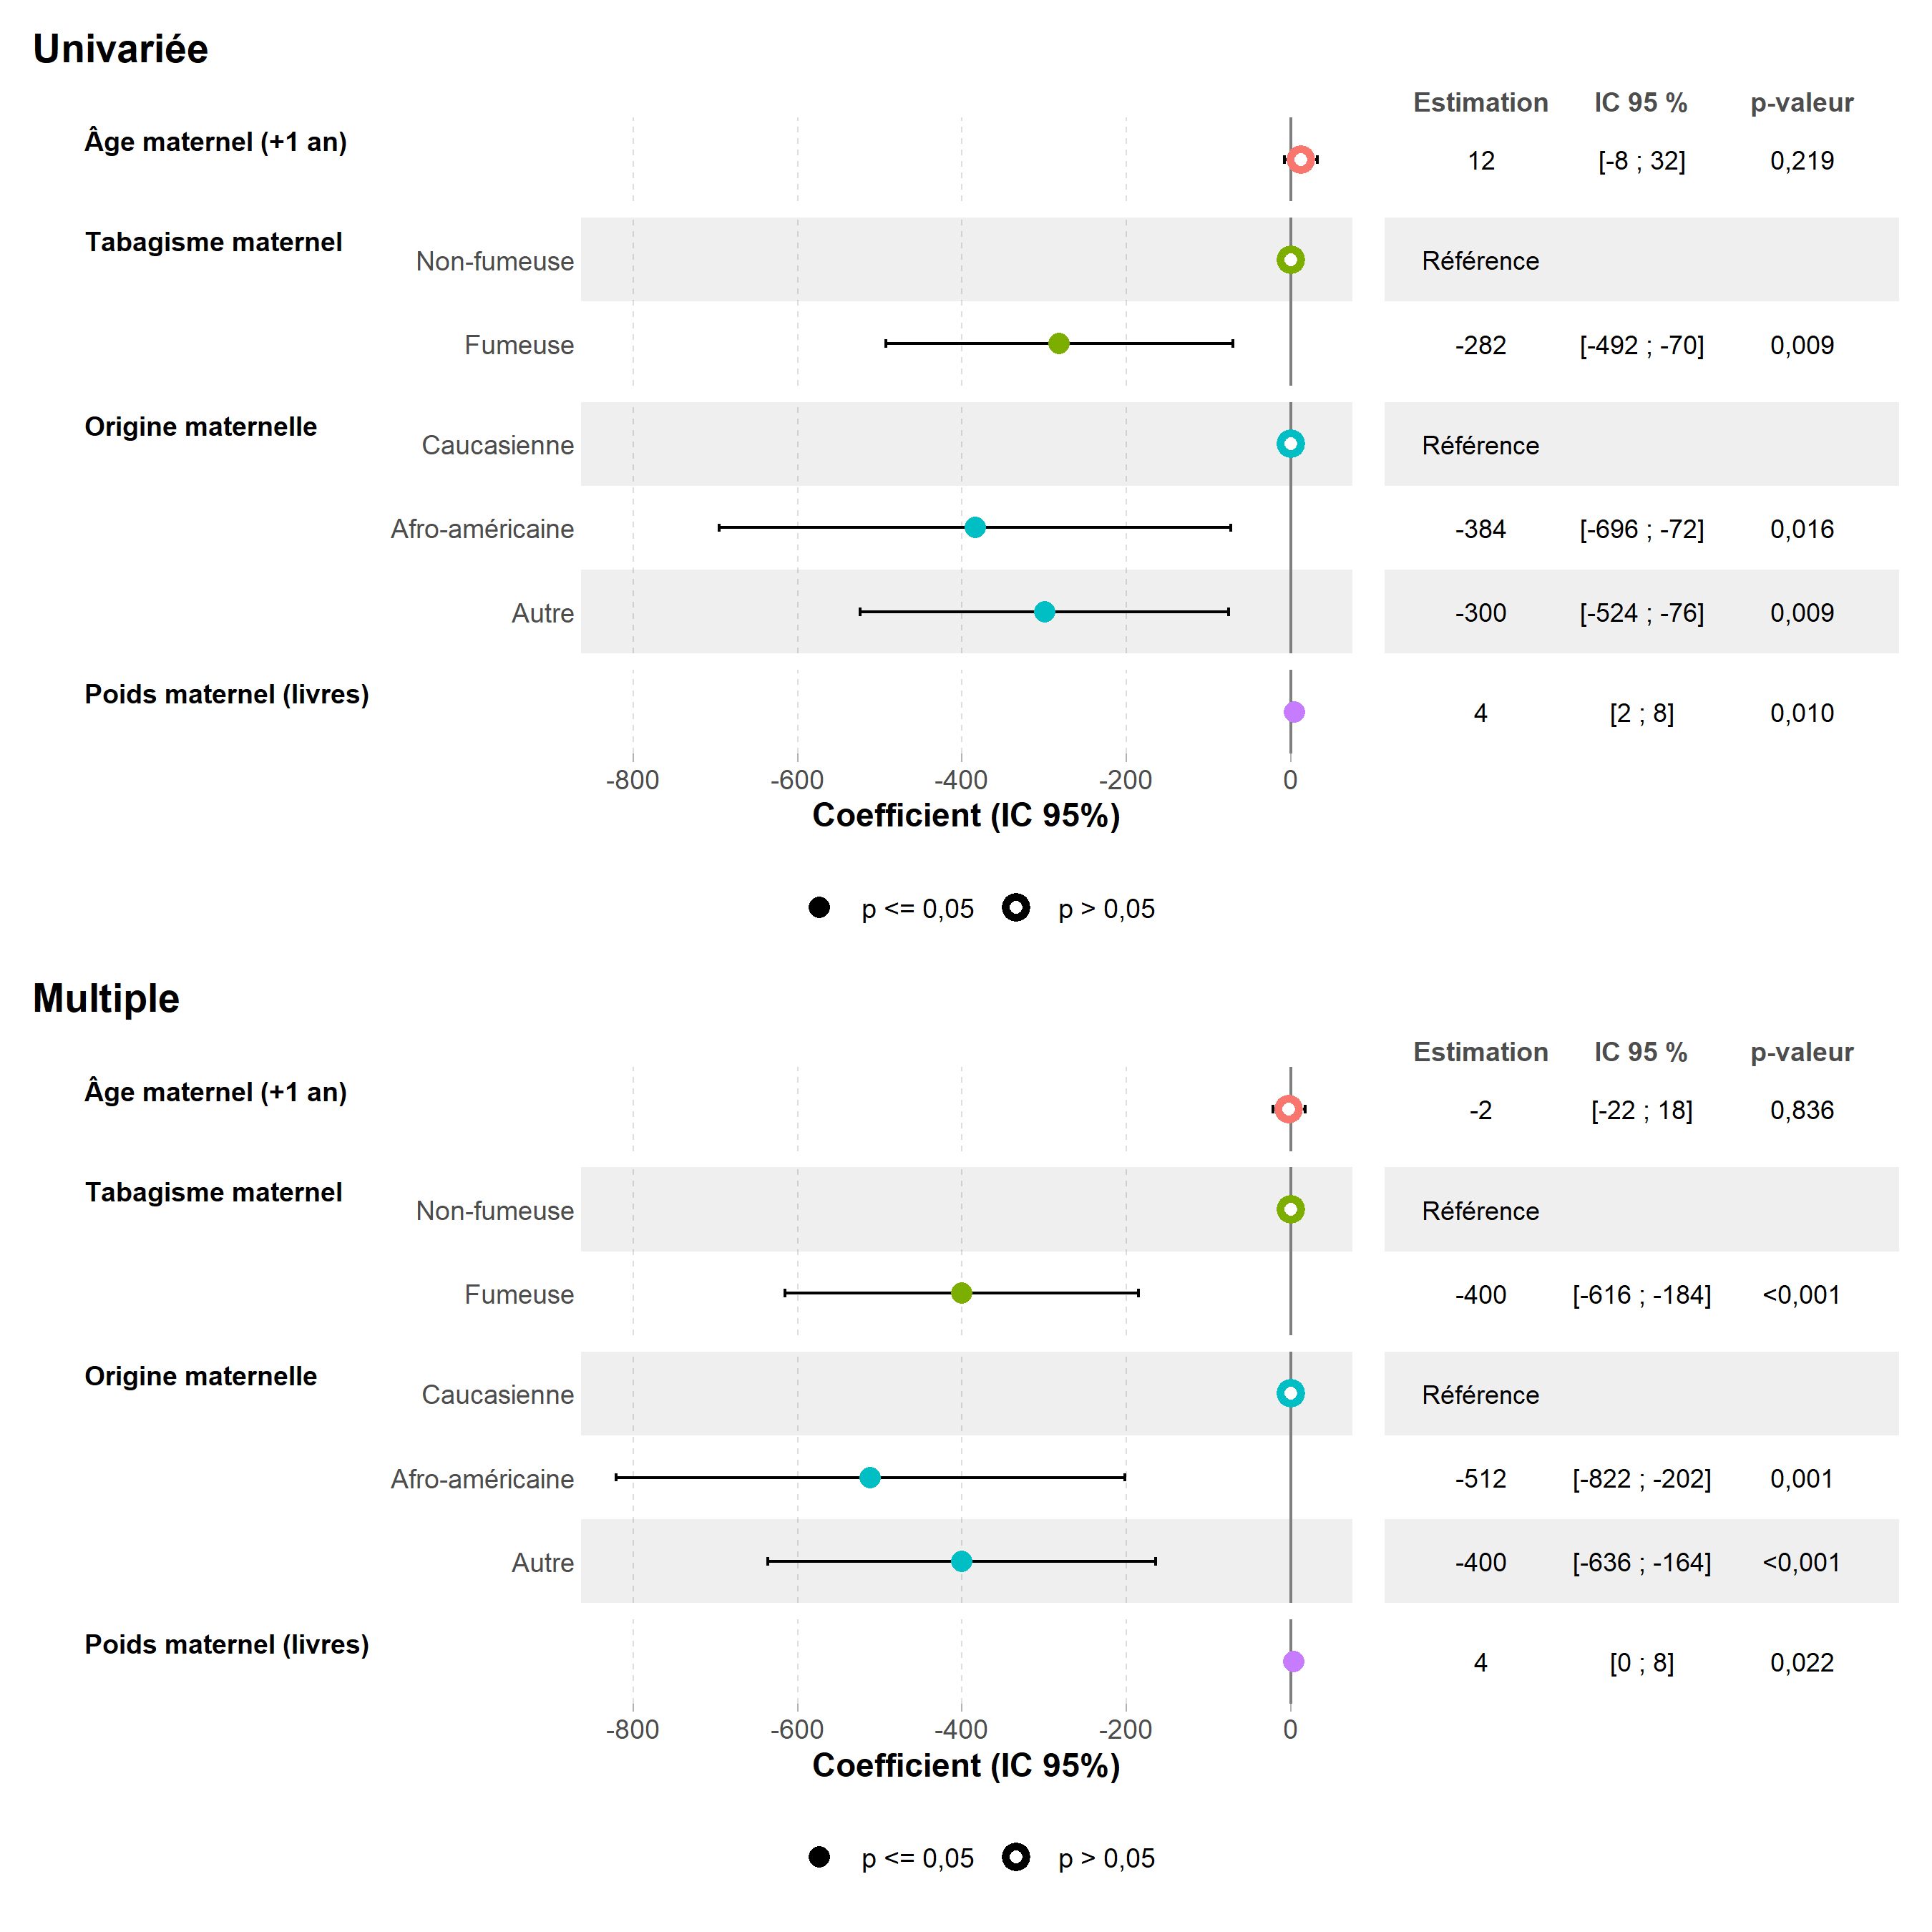
Et rien ne nous empêche d’avoir sur la même figure, les résultats de l’analyse univariée et de l’analyse ajustée :
modeles <- list(
    "Univariée" = lm(poids_naissance ~ age, data = bw),
    "Univariée" = lm(poids_naissance ~ tabagisme, data = bw),
    "Univariée" = lm(poids_naissance ~ origine, data = bw),
    "Univariée" = lm(poids_naissance ~ poids_mere_lb, data = bw),
    "Multiple" = modele_ajuste
)

ggstats::ggcoef_compare(
    models = modeles,
    type = "table",
    variable_labels = c(
        age = "Âge maternel (+1 an)",
        poids_mere_lb = "Poids maternel (livres)",
        tabagisme = "Tabagisme maternel",
        origine = "Origine maternelle"
    ),
    table_stat = c("estimate", "ci", "p.value"),
    table_header = c("Estimation", "IC 95 %", "p-valeur"),
    table_stat_label = list(
        estimate = formater_estimation,
        conf.low = scales::label_number(accuracy = 2, decimal.mark = ","),
        conf.high = scales::label_number(accuracy = 2, decimal.mark = ","),
        p.value = scales::label_pvalue(accuracy = 0.001, decimal.mark = ",")
    ),
    ci_pattern = "[{conf.low} ; {conf.high}]"
) &
    ggplot2::theme(panel.border = ggplot2::element_blank()) &
    ggplot2::labs(x = "Coefficient (IC 95%)")