# Préparation des données
options(OutDec = ",", scipen = 999)
set.seed(67)

library(dplyr)
library(gtsummary)

# pour avoir des virgules comme séparateur décimal et des espaces pour les milliers
theme_gtsummary_language(
    language = "fr",
    decimal.mark = ",",
    # 95% CI separator : " - " à " ; "
    ci.sep = " ; ",
    big.mark = " "
)
theme_gtsummary_compact() # fait un rendu tableau "type article"

pam13 <- read.csv("../../data/pam13.csv")

pam <- pam13 |>
    transmute(
        sexe = factor(
            Gender,
            levels = c("women", "men"),
            labels = c("Femmes", "Hommes")
        ),
        age = Age,
        taille = Length,
        poids = Bodyweight,
        imc = BMI,
        tabagisme = factor(
            Smoking,
            levels = c("never", "former", "current"),
            labels = c("Jamais", "Ancien", "Actuel")
        ),
        pathologie = factor(
            Disease,
            levels = c("DM-II", "COPD", "HF", "CRD"),
            labels = c("Diabète de type 2", "BPCO", "Insuffisance cardiaque", "Maladie rénale")
        ),
        score_pam = activation_score
    ) |>
na.omit()Et avec R ?
Ajouter une comparaison entre groupes
Dans notre tbl_summary(), si on effectue un croisement avec une variable, grâce à l’argument by = nom_de_la_variable, alors on peut être intéressé de faire un test statistique. Pour ajouter une colonne pour la p-valeur, on utilise simplement add_p(), qui, par défaut, fait un test statistique (Wilcoxon-Mann-Whitney pour quanti x quali, test exact de Fisher ou chi² d’indépendance pour quali x quali).
On peut cependant choisir le test à effectuer, pour chaque variable séparément ou pour toutes les variables d’un même type, si l’on souhaite ! Avec la table précédente, voici ce qu’on obtiendrait :
tableau_pam_pval <- pam |>
    select(sexe, age, imc, tabagisme, score_pam) |>
    tbl_summary(
        by = sexe,
        statistic = list(
            all_continuous() ~ "{mean} ({sd})",
            all_categorical() ~ "{n} ({p})"
        )
    ) |>
    add_p(
        test = list(
            age ~ "wilcox.test",
            imc ~ "t.test",
            all_categorical() ~ "fisher.test"
        )
    ) |>
    bold_labels() |>
    # **TEXTE** = gras ; *TEXTE* = italique ; ***TEXTE*** = gras & italique
    modify_caption("**Caractéristiques des patients selon le sexe.**")

tableau_pam_pval| Caractéristique |
Femmes N = 4421 |
Hommes N = 6761 |
Valeur p2 |
|---|---|---|---|
| age | 70 (11) | 69 (11) | 0,8 |
| imc | 27,7 (5,4) | 27,4 (4,0) | 0,3 |
| tabagisme | <0,001 | ||
| Jamais | 165 (37) | 107 (16) | |
| Ancien | 206 (47) | 446 (66) | |
| Actuel | 71 (16) | 123 (18) | |
| score_pam | 54 (11) | 54 (11) | 0,3 |
| 1 Moyenne (ET); n (%) | |||
| 2 test de Wilcoxon-Mann-Whitney; Test t de Welch; test exact de Fisher | |||
Tous les tests disponibles sont présentés ici :
Tests statistiques
En vrac, voici le test et la commande R associée :
| Test statistique | Commande R |
|---|---|
| Test de Student pour un échantillon | t.test(x, mu = valeur) |
| Test de Student | t.test(y ~ groupe, var.equal = TRUE) |
| Test de Welch | t.test(y ~ groupe) |
| Test d’égalité des variances | var.test(y ~ groupe) |
| Test de Levene | car::leveneTest(y ~ groupe) |
| Test d’ANOVA | aov(y ~ groupe) |
| Wilcoxon-Mann-Whitney | wilcox.test(y ~ groupe) |
| Test de Student apparié | t.test(apres, avant, paired = TRUE) |
| Test du chi² d’indépendance | chisq.test(table(x, y)) |
| Test du chi² d’ajustement | chisq.test(effectifs, p = proportions) |
| Test exact de Fisher | fisher.test(table(x, y)) |
| Test de McNemar | mcnemar.test(table(avant, apres)) |
| Test de corrélation de Pearson | cor.test(x, y, method = "pearson") |
| Test de corrélation de Spearman | cor.test(x, y, method = "spearman", exact = FALSE) |
Voici quelques exemples sur l’étude PAM-13 :
- Dans un groupe de référence, le poids moyen est de 75 kg. Est-ce que le poids corporel moyen est différent de 75 kg dans l’étude PAM-13 ?
    One Sample t-test

data:  pam13$Bodyweight
t = 14,191, df = 1139, p-value < 0,00000000000000022
alternative hypothesis: true mean is not equal to 75
95 percent confidence interval:
 80,71622 82,55044
sample estimates:
mean of x
 81,63333
La p-valeur < 0,05 suggère que le poids corporel moyen dans l’étude PAM-13 est différent de 75 kg.
- Le poids moyen diffère-t-il entre les hommes et les femmes ? Pour choisir le “bon” test, on commence par tester l’égalité des variances avec le test de Levene (plus robuste) :
| Df | F value | Pr(>F) | |
|---|---|---|---|
| group | 1 | 1,132654 | 0,2874357 |
| 1138 | NA | NA |
Comme \(p = 0,2874>0,05\), on peut supposer que les variances sont égales entre les deux groupes. On peut donc utiliser le test de Student pour comparer les moyennes.
    Two Sample t-test

data:  Bodyweight by as.factor(Gender)
t = 12,355, df = 1138, p-value < 0,00000000000000022
alternative hypothesis: true difference in means between group men and group women is not equal to 0
95 percent confidence interval:
  9,321955 12,841824
sample estimates:
  mean in group men mean in group women
           86,04665            74,96476
Comme \(p<0,05\), on peut conclure que le poids corporel moyen diffère entre les hommes et les femmes.
- Est-ce que le sexe et le statut tabagique sont associés ? Autrement dit, la proportion de fumeurs diffère-t-elle entre les hommes et les femmes ?
        current former never
  men       123    458   109
  women      73    209   167
          current  former    never
  men   118,73573 404,065 167,1993
  women  77,26427 262,935 108,8007
    Pearson's Chi-squared test

data:  tableau_contingence_observe
X-squared = 70,041, df = 2, p-value = 0,0000000000000006176
Comme \(p<0,05\), on peut conclure que le sexe et le statut tabagique sont associés.
Tester une corrélation
Pour étudier l’association entre deux variables quantitatives, on utilise cor.test() (à ne pas confondre avec cor() ! Ce dernier calcule seulement le coefficient, sans effectuer de test).
Reprenons l’étude PAM-13 : l’âge et le score d’activation à l’autogestion sont-ils associés ? On conserve les patients pour lesquels ces deux mesures sont disponibles, puis on regarde le nuage de points :
[1] 1151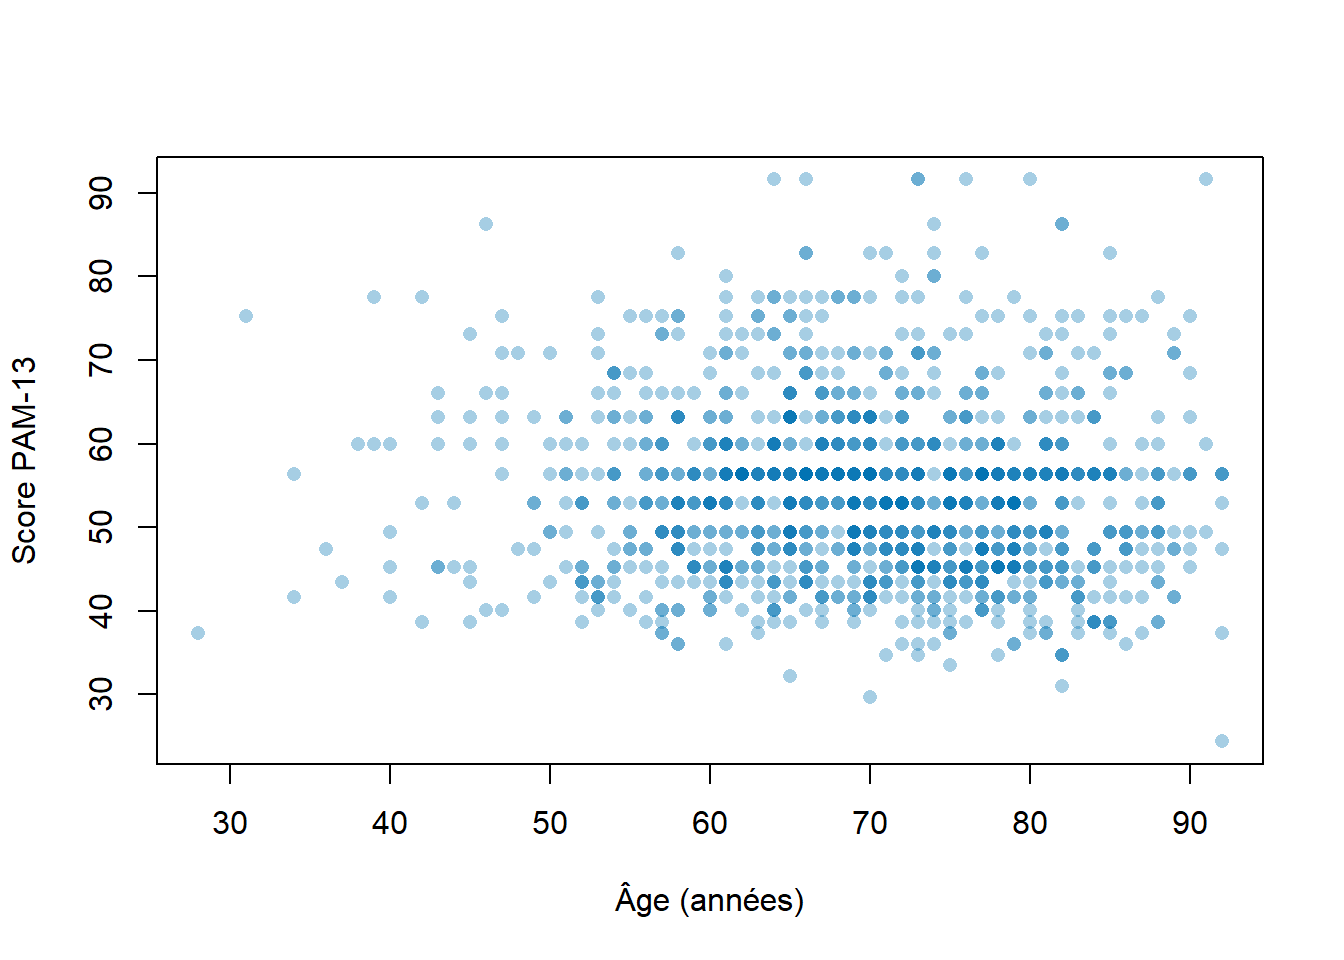
Bon, pas vraiment de tendance, qu’elle soit linéaire ou non … Donc, a priori, on ne devrait pas trouver 1/ une valeur de corrélation éloignée de 0 et 2/ une p-valeur < 0,05. Vérifions cela :
    Pearson's product-moment correlation

data:  donnees_correlation$Age and donnees_correlation$activation_score
t = -2,3284, df = 1149, p-value = 0,02006
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0,12581360 -0,01079037
sample estimates:
        cor
-0,06852972
Ici, sur 1 151 patients, on obtient \(r\approx-0,069\), un IC à 95 % d’environ \([-0,126\,;\,-0,011]\) et \(p\approx0,020\). Au seuil de 5 %, le test est significatif (comme quoi !), mais la corrélation observée est très faible : les patients plus âgés tendent donc à avoir un score légèrement plus bas.
C’est un bon exemple de la différence entre “significatif” et “important” :)
On peut regarder avec Spearman :
    Spearman's rank correlation rho

data:  donnees_correlation$Age and donnees_correlation$activation_score
S = 276241021, p-value = 0,003151
alternative hypothesis: true rho is not equal to 0
sample estimates:
        rho
-0,08696054
L’argument
exact = FALSEdemande ici une p-valeur approchée ; il est adapté à ce grand échantillon comportant des ex æquo.
On obtient \(r_s\approx-0,087\) et \(p\approx0,003\) : l’association observée reste très faible et négative ; ça ne rentre pas en contradiction avec ce qu’on a trouvé avec Pearson.