[1] "French_France.utf8"Et avec R ?
Préparation des données utilisées sur cette page (étude PAM-13) :
options(OutDec = ",", scipen = 999)
set.seed(67)

library(dplyr)
library(ggplot2)
library(gtsummary)
library(patchwork)

theme_gtsummary_language(
    language = "fr",
    decimal.mark = ",",
    # 95% CI separator : " - " à " ; "
    ci.sep = " ; ",
    big.mark = " "
)
theme_gtsummary_compact()

pam13 <- read.csv("../../data/pam13.csv")

pam <- pam13 |>
    transmute(
        sexe = factor(
            Gender,
            levels = c("women", "men"),
            labels = c("Femmes", "Hommes")
        ),
        age = Age,
        taille = Length,
        poids = Bodyweight,
        imc = BMI,
        tabagisme = factor(
            Smoking,
            levels = c("never", "former", "current"),
            labels = c("Jamais", "Ancien", "Actuel")
        ),
        pathologie = factor(
            Disease,
            levels = c("DM-II", "COPD", "HF", "CRD"),
            labels = c("Diabète de type 2", "BPCO", "Insuffisance cardiaque", "Maladie rénale")
        ),
        score_pam = activation_score
    ) |>
    na.omit()
Tableau descriptif
Faire un tableau descriptif, ça peut être pénible. Un moyen “facile” d’en construire est d’utiliser la fonction tbl_summary() du package gtsummary. Il y a pleins d’arguments avec lesquelles on peut jouer pour faire des tableaux directement présentables, mais la version la plus simple est d’écrire :
# pour avoir des virgules comme séparateur décimal et des espaces pour les milliers
theme_gtsummary_language(
    language = "fr",
    decimal.mark = ",",
    # 95% CI separator : " - " à " ; "
    ci.sep = " ; ",
    big.mark = " "
)
theme_gtsummary_compact() # fait un rendu tableau "type article"

donnees |> tbl_summary()
Par défaut,
gtsummary“détecte” le type de variable, présente les variables continues par leur médiane et leurs quartiles, les variables qualitatives par leurs effectifs et pourcentages, et signale les valeurs manquantes.Si vous avez l’impression que quelque chose cloche, il faut probablement toucher aux paramètres de la fonction pour corriger le tout …
A force d’en faire, de regarder les forums ou demander aux modèles de langages, on peut vite arriver à des résultats comme suit, assez “simplement” :
tableau_descriptif <- pam |>
    select(sexe, age, imc, tabagisme, score_pam) |>
    tbl_summary(
        by = sexe, # by = tableau croisé
        statistic = list(
            all_continuous() ~ "{mean} ({sd})", # variables quanti = moyenne (ET)
            all_categorical() ~ "{n} ({p})" # variables quali = effectif (%)
        ),
        digits = all_continuous() ~ 1, # arrondi au dixième
        # pour renommer les variables affichées dans le tableau
        label = list(
            age ~ "Âge (années)",
            imc ~ "Indice de masse corporelle (kg/m²)",
            tabagisme ~ "Statut tabagique",
            score_pam ~ "Score PAM-13"
        ),
        missing_text = "Manquant"
    ) |>
    add_overall(last = FALSE) |> # ajout de la colonne "Total"
    add_n() |> # ajout de la colonne "N", d'effectif total
    bold_labels() # mets en gras les variables à gauche et en en-tête de tableau

tableau_descriptif| Caractéristique | N |
Total N = 1 1181 |
Femmes N = 4421 |
Hommes N = 6761 |
|---|---|---|---|---|
| Âge (années) | 1 118 | 69,5 (10,9) | 69,5 (11,3) | 69,4 (10,6) |
| Indice de masse corporelle (kg/m²) | 1 118 | 27,5 (4,6) | 27,7 (5,4) | 27,4 (4,0) |
| Statut tabagique | 1 118 | |||
| Jamais | 272 (24) | 165 (37) | 107 (16) | |
| Ancien | 652 (58) | 206 (47) | 446 (66) | |
| Actuel | 194 (17) | 71 (16) | 123 (18) | |
| Score PAM-13 | 1 118 | 54,2 (10,8) | 53,7 (10,7) | 54,5 (10,9) |
| 1 Moyenne (ET); n (%) | ||||
Pour l’argument statistic(), on peut avoir :
-
all_continuous() ~ ...: {mean}, {sd}, {pXX} (où {p25} est le premier quartile, {p50} la médiane …), {min} et {max} -
all_categorical() ~ ...: {n}, {N} (effectif total) et {p}.
Graphique (avec ggplot2)
Pour les graphiques, on recommande l’utilisation de ggplot2, qui est une librairie très complète pour répondre à (quasiment) toutes vos envies.
Sachez que si cette librairie ne présente pas le graphique que vous chercher, il est fort probable que quelqu’un en ait crée une pour le faire !
Il existe aussi un site, qui présente pleins de types de graphiques (et le code associée), qu’il est fort recommandé de connaître :
Un graphique ggplot2 superpose des composants reliés par +. Avant d’écrire le code, trois premières questions doivent être posées :
- Quelles sont les données utilisées ?
- Quelles variables sont associées aux axes, à la couleur ou à la forme dans
aes()? - Quelle couche
geom_*()représente le mieux ces variables ?
Le squelette général d’un graphique avec ggplot2 s’écrit alors :
- La liste complète des
geom_*()est disponible ici : https://rstudio.github.io/cheatsheets/html/data-visualization.html#geoms. - On pourra aussi s’intéresser de près à la fiche résumé française, disponible en cliquant ici
Concrètement, c’est assez “logique” : vous voulez un histogram ? geom_histogram() ; un nuage de points ? geom_point() ; un boxplot ? geom_boxplot() …
Il est aussi possible de combiner les geom_*() : vous voulez un nuage de points ET une droite ? Alors vous pouvez faire geom_point() + geom_smooth(method = "lm").
Enfin, on peut customiser “l’apparence” des graphiques, au travers de “thèmes”. Il en existe des déjà tout fait, mais on peut aussi créer le sien. C’est ce qu’on a fait dans ce cours ! (c’est la même chose avec les couleurs utilisées)
okabe_ito <- c(
    noir = "#000000",
    orange = "#E69F00",
    bleu_ciel = "#56B4E9",
    vert = "#009E73",
    jaune = "#F0E442",
    bleu = "#0072B2",
    vermillon = "#D55E00",
    rose = "#CC79A7"
)

couleurs_sexe <- c(
    "Femmes" = okabe_ito[["bleu_ciel"]],
    "Hommes" = okabe_ito[["vermillon"]]
)

couleurs_tabagisme <- c(
    "Jamais" = okabe_ito[["vert"]],
    "Ancien" = okabe_ito[["rose"]],
    "Actuel" = okabe_ito[["jaune"]]
)

theme_ste <- function(base_size = 10) {
    theme_classic(base_size = base_size) +
        theme(
            axis.title = element_text(face = "bold"),
            legend.position = "bottom",
            legend.title = element_text(face = "bold")
        )
}
De plus, on peut facilement organiser les graphiques côte à côte ou l’un au-dessus de l’autre grâce au package patchwork.
- Deux graphiques côte à côte :
figure1 + figure 2 - Deux graphiques l’un au-dessus de l’autre :
figure1 / figure2 - Trois graphiques, avec deux à gauche l’un au-dessus de l’autre, et l’autre à droite :
(figure1 / figure2) + figure3 - Ainsi de suite !
Enfin, quand on est satisfait du graphique, on peut l’enregistrer avec ggsave() :
Donnons maintenant quelques exemples par rapport à ce qui a été présenté en cours. On utilise les données de l’étude PAM-13, où on a enlevé toutes les observations manquantes (pour simplifier le code).
Histogramme
Il faut choisir la largeur de classe (binwidth) en fonction de l’unité de la variable ! Ceci impactera la forme de l’histogramme.
histo1 <- ggplot(pam, aes(x = age)) +
    geom_histogram(
        binwidth = 5,
        fill = okabe_ito[["bleu"]], # couleur de remplissage des rectangles
        colour = "white" # contour des rectangles
    ) +
    labs(x = "Âge (années)", y = "Nombre de patients") +
    theme_ste()

histo2 <- ggplot(pam, aes(x = age)) +
    geom_histogram(
        binwidth = 1,
        fill = okabe_ito[["bleu"]],
        colour = "white"
    ) +
    labs(x = "Âge (années)", y = "Nombre de patients") +
    theme_ste()

histo3 <- ggplot(pam, aes(x = age)) +
    geom_histogram(
        binwidth = 20,
        fill = okabe_ito[["bleu"]],
        colour = "white"
    ) +
    labs(x = "Âge (années)", y = "Nombre de patients") +
    theme_ste()

histo1 + histo2 + histo3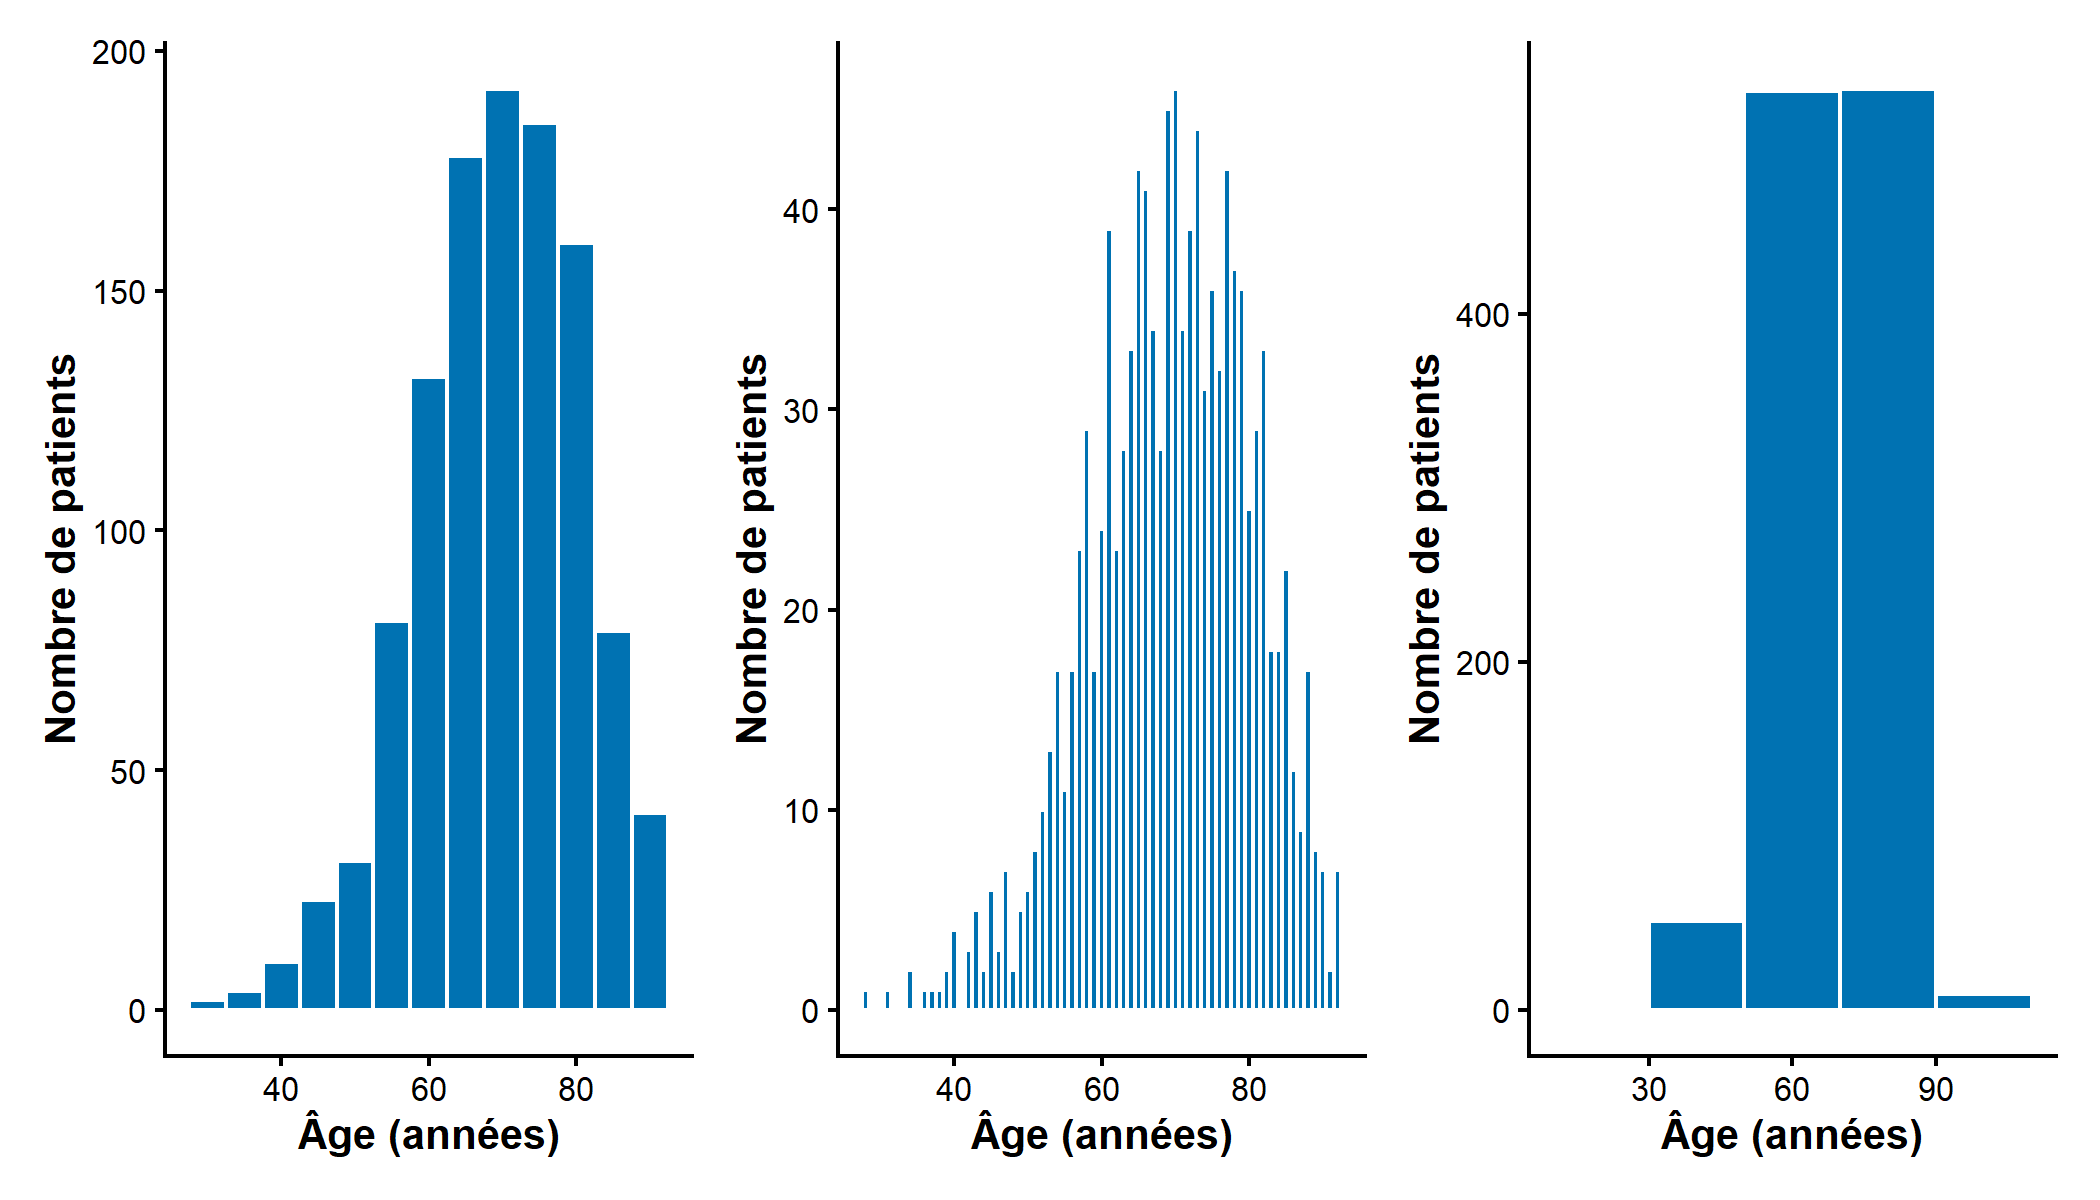
A vous de changer binwidth pour qu’il soit adéquat pour vos données.
Boxplot
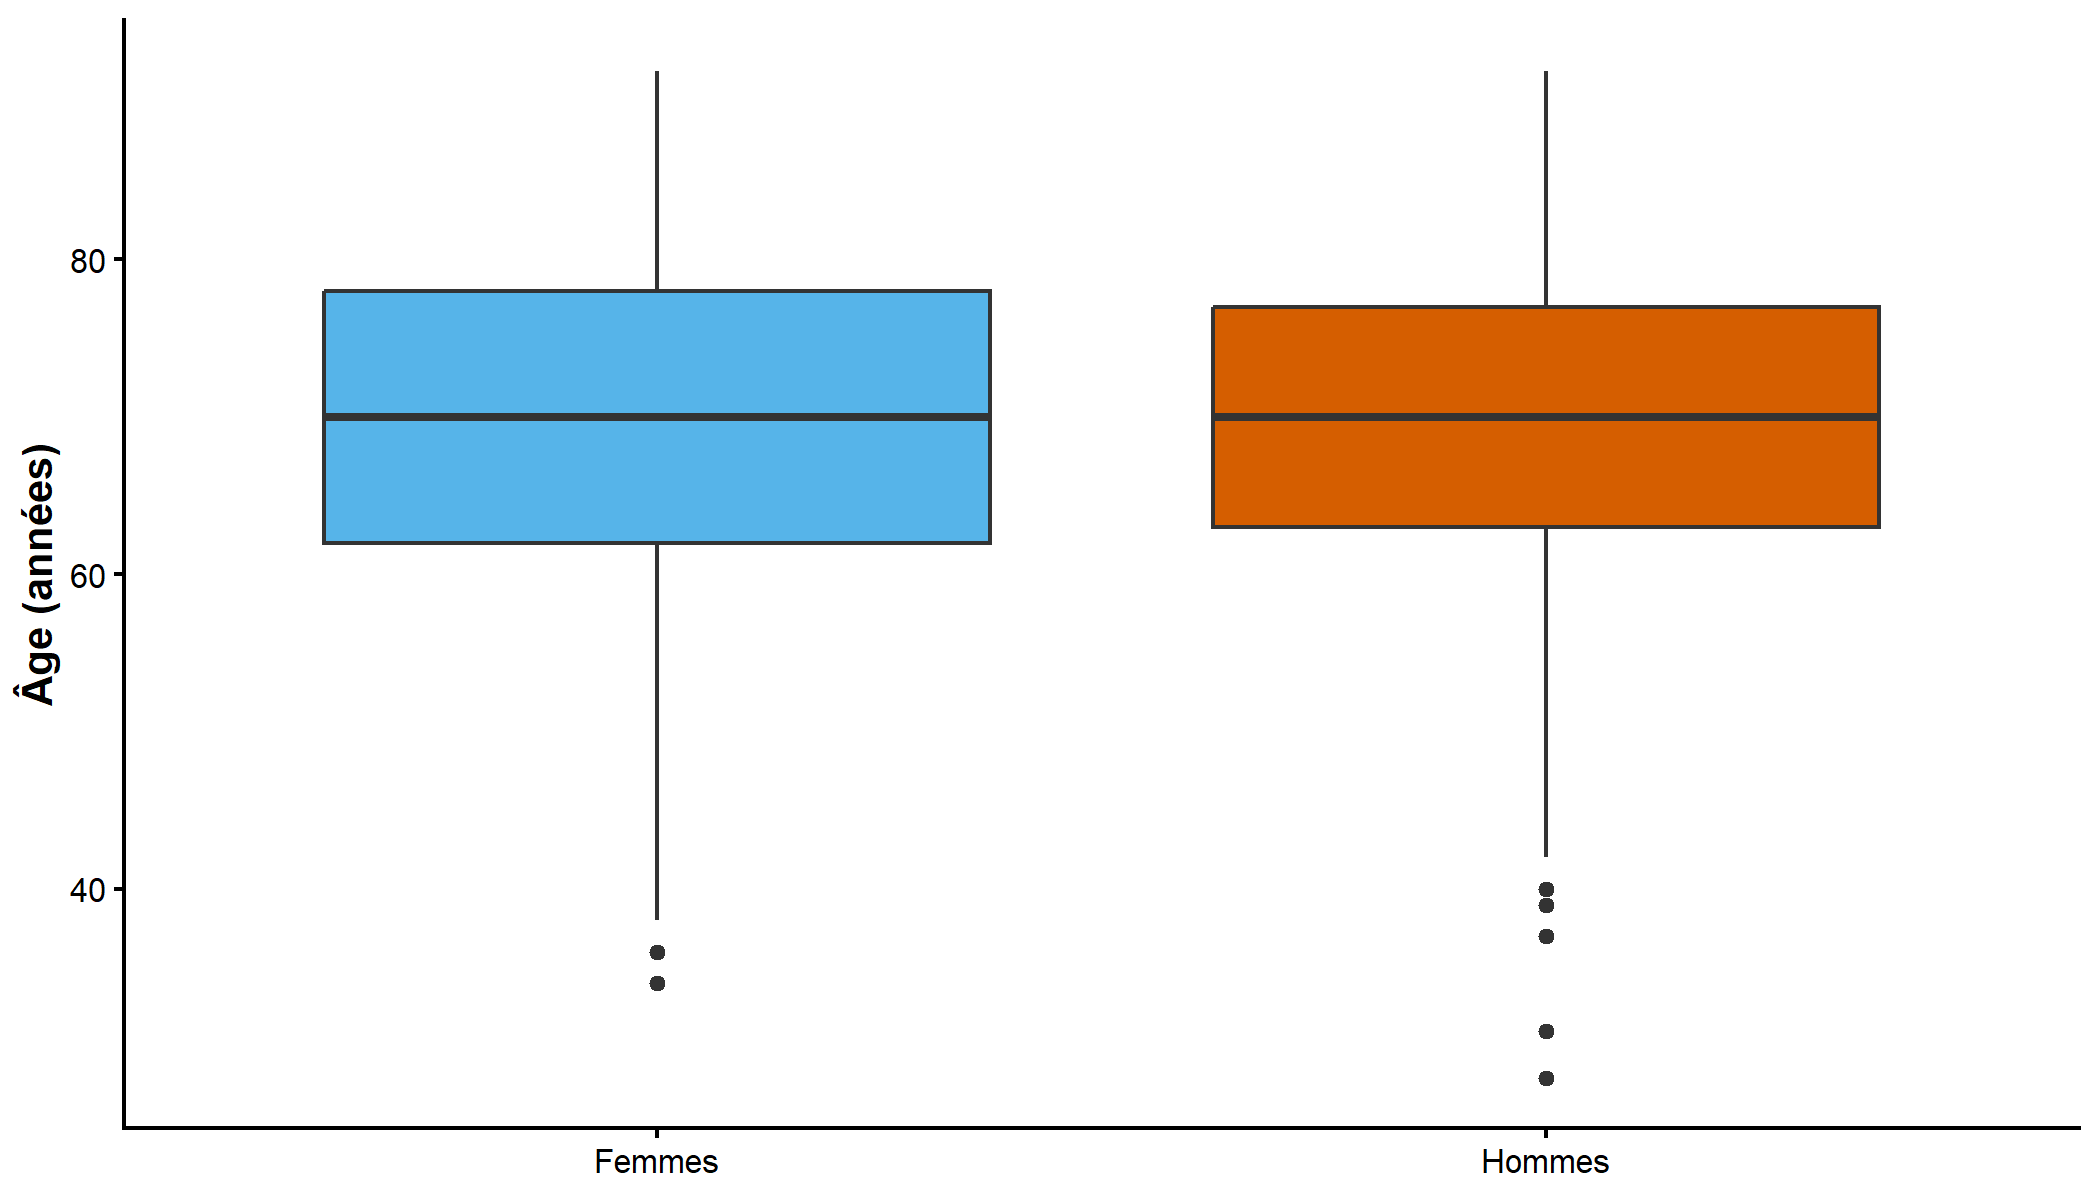
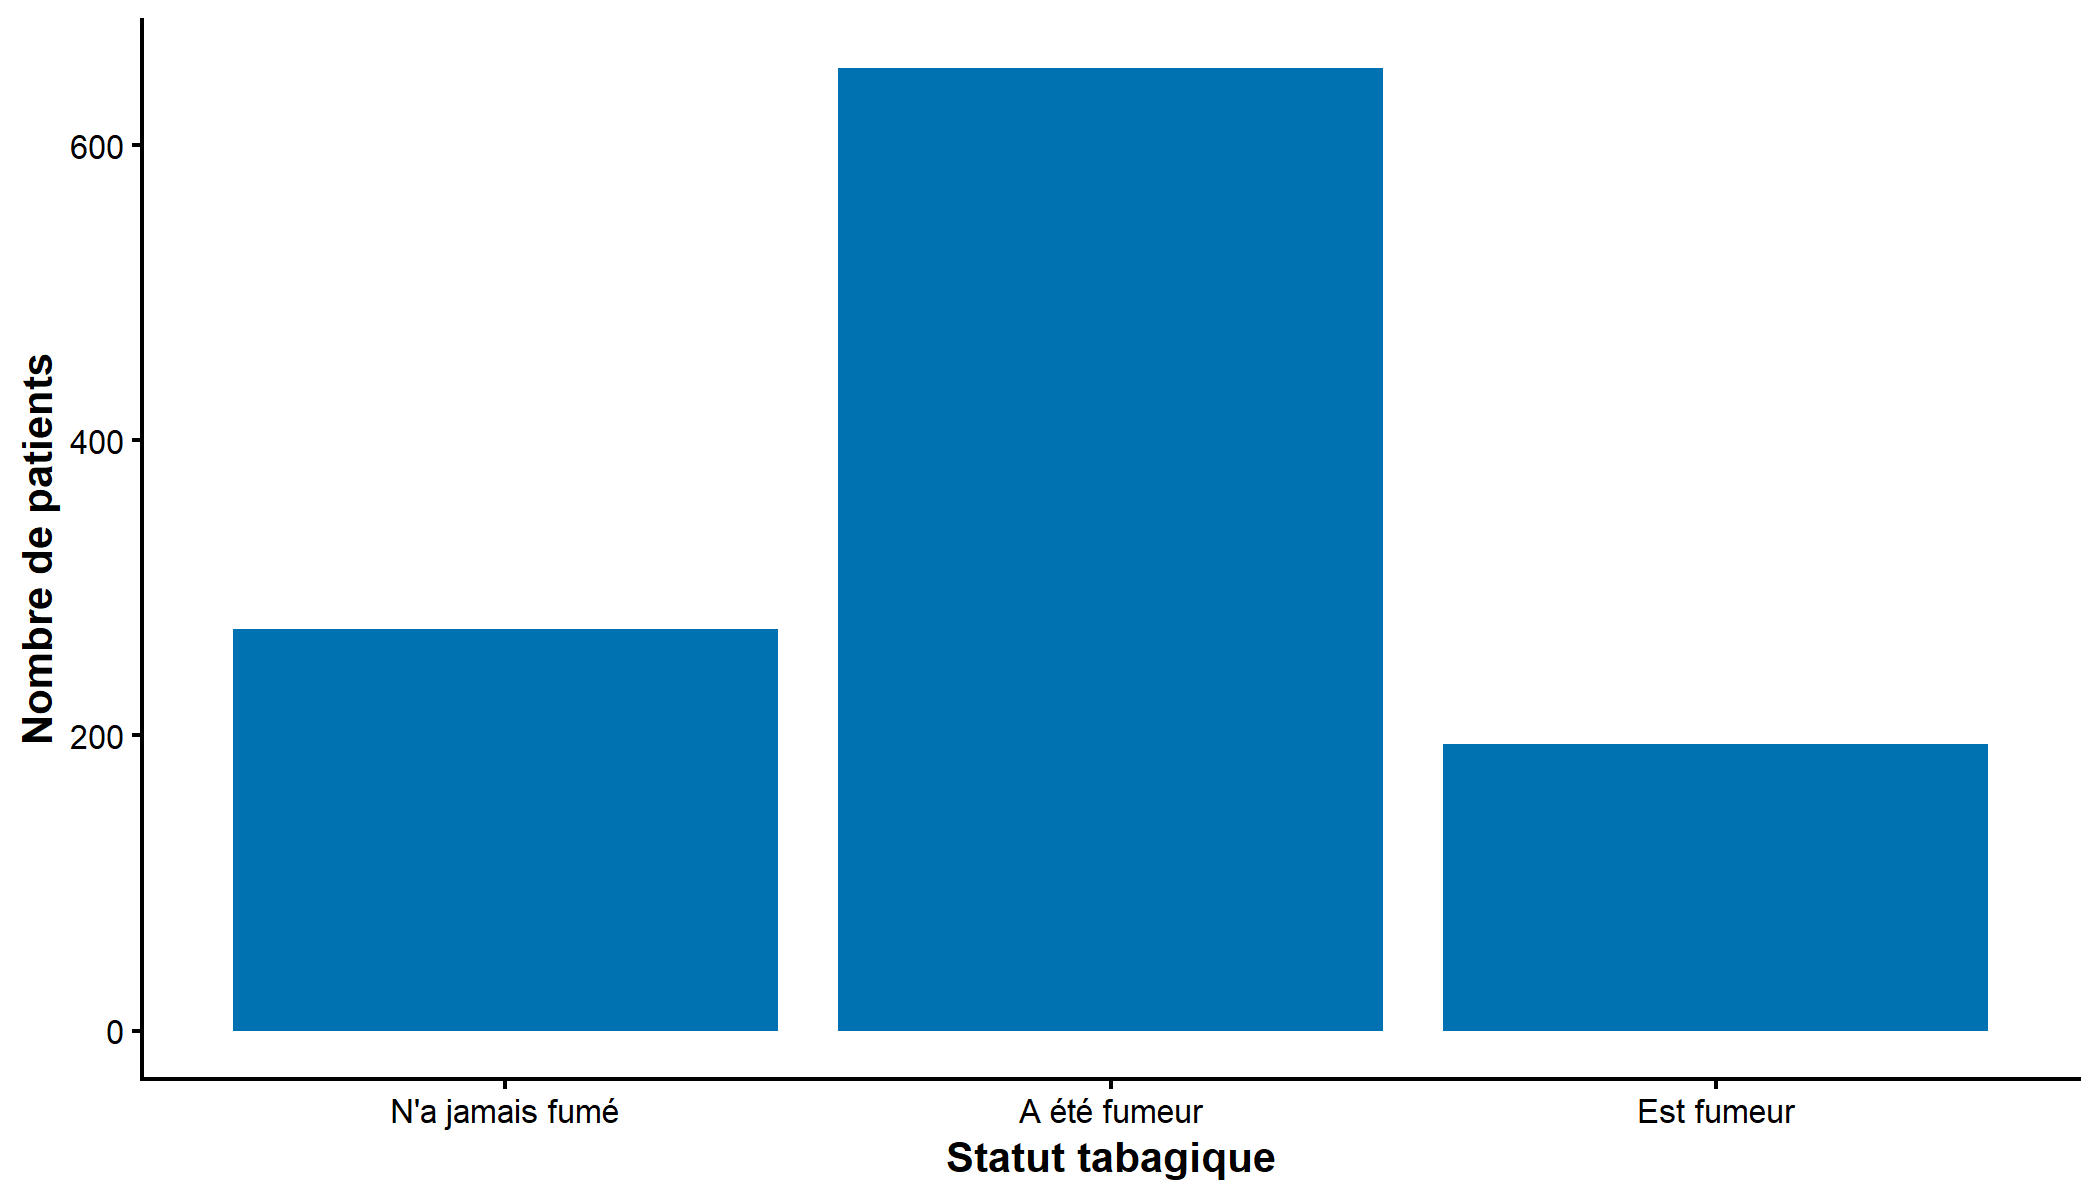
Diagramme en barres
Nuage de points (et droite de tendance)
ggplot(
    pam,
    aes(
        x = taille,
        y = poids,
        colour = sexe,
        shape = sexe,
        linetype = sexe
    )
) +
    # alpha = transparence des points. Plus c'est bas, plus c'est transparent
    geom_point(alpha = 0.3) +
    geom_smooth(
        method = "lm", # lm = linear model ; trace une droite
        se = FALSE, # pour éviter d'avoir la bande de confiance autour
        linewidth = 0.9
    ) +
    scale_colour_manual(values = couleurs_sexe) +
    scale_shape_manual(values = c("Femmes" = 16, "Hommes" = 17)) +
    scale_linetype_manual(values = c("Femmes" = "solid", "Hommes" = "dashed")) +
    labs(
        x = "Taille (cm)",
        y = "Poids (kg)",
        colour = "Sexe",
        shape = "Sexe",
        linetype = "Sexe"
    ) +
    theme_ste()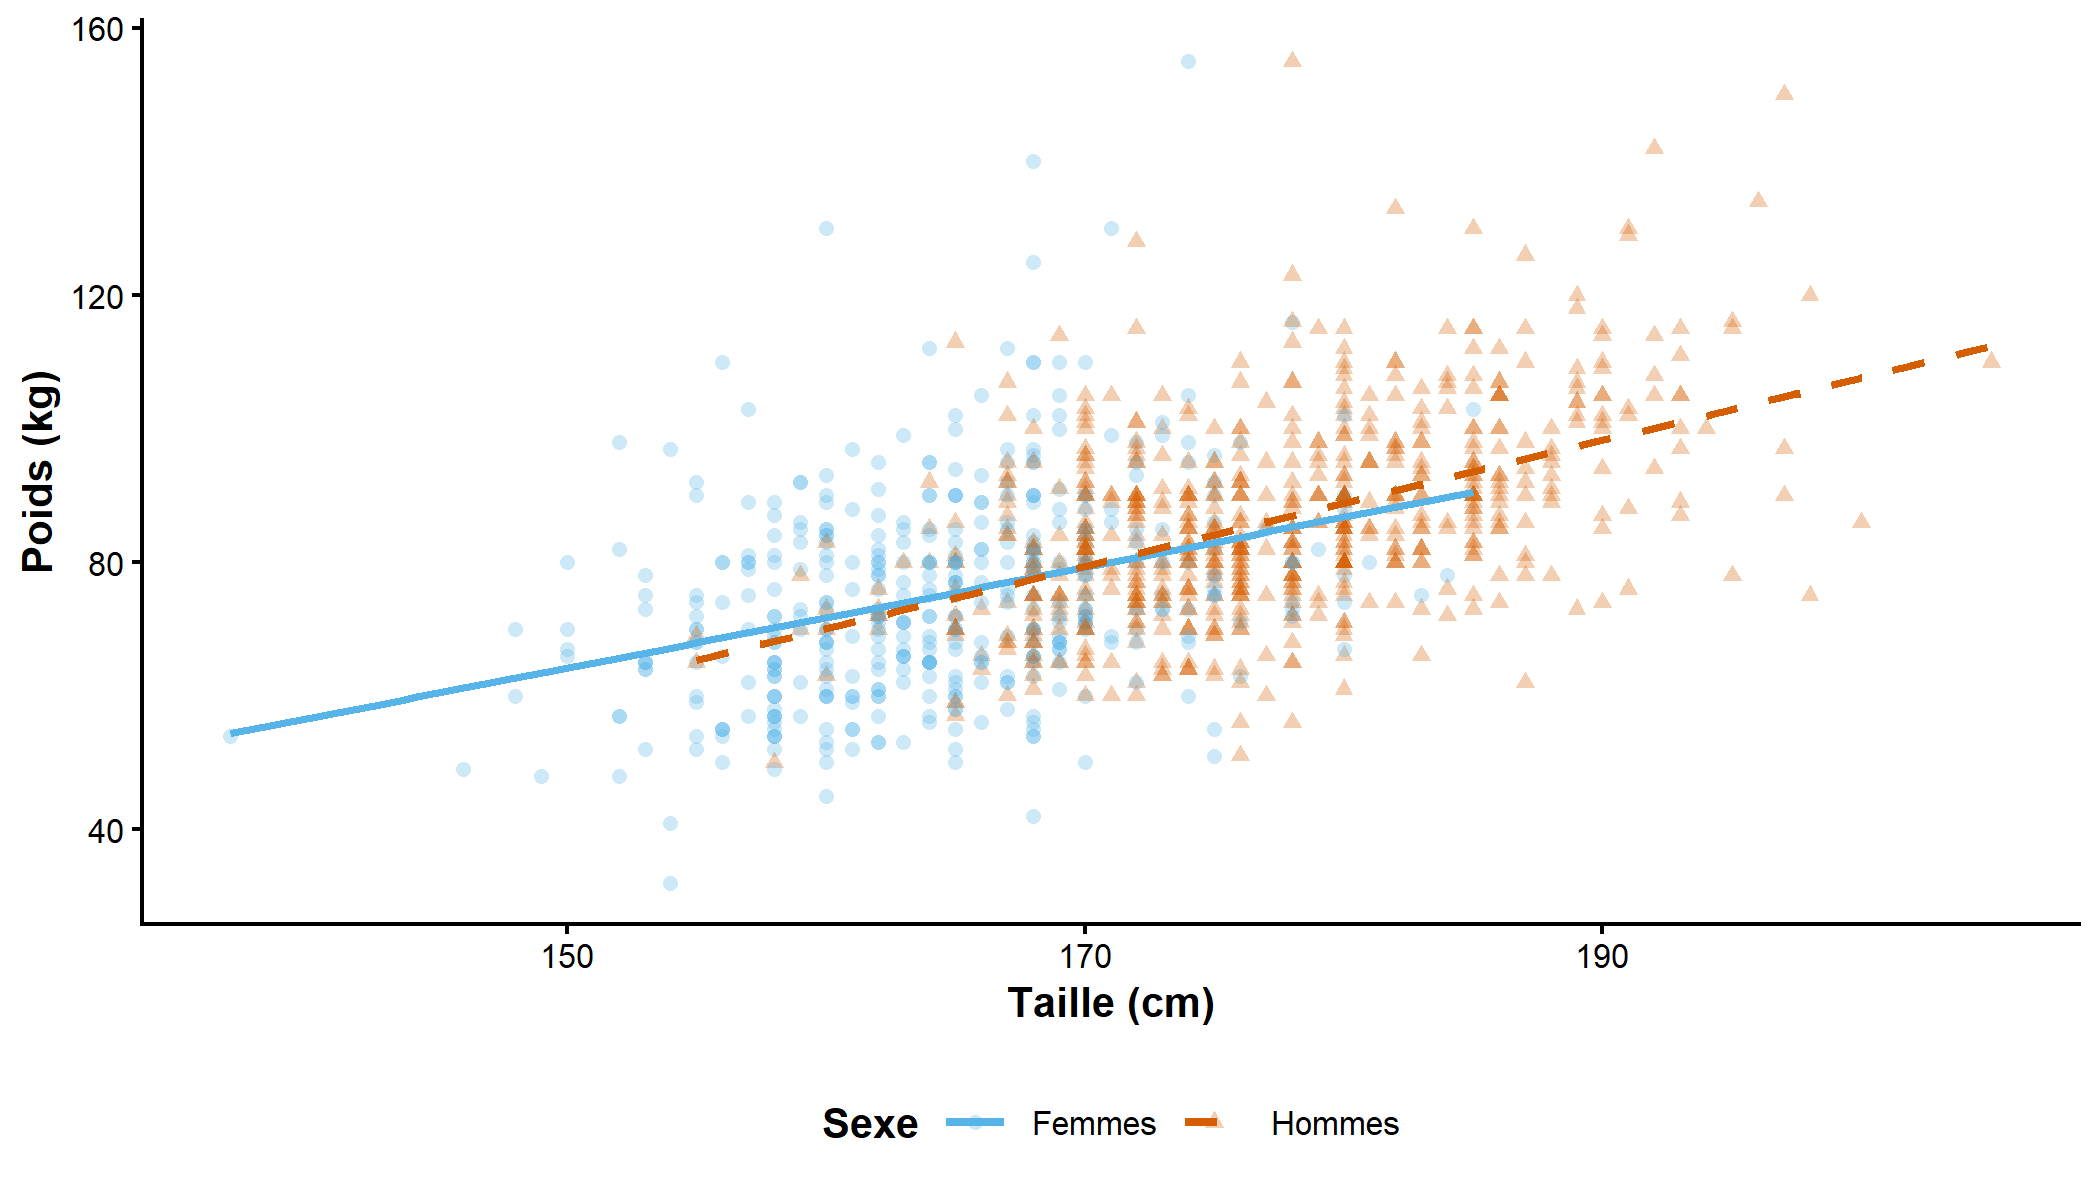
Deux variables qualitatives
# Effectifs juxtaposés
juxtaposees <- ggplot(pam, aes(x = tabagisme, fill = sexe)) +
    geom_bar(position = "dodge") +
    scale_fill_manual(values = couleurs_sexe) +
    labs(x = "Statut tabagique", y = "Effectif", fill = "Sexe") +
    theme_ste()

# Proportions à l'intérieur de chaque statut tabagique
proportions <- ggplot(pam, aes(x = tabagisme, fill = sexe)) +
    geom_bar(position = "fill") +
    scale_fill_manual(values = couleurs_sexe) +
    scale_y_continuous(
        limits = c(0, 1),
        breaks = seq(0, 1, by = 0.25),
        labels = scales::label_number(
            scale = 100,
            accuracy = 1,
            decimal.mark = ","
        )
    ) +
    labs(x = "Statut tabagique", y = "Proportion (%)", fill = "Sexe") +
    theme_ste()

juxtaposees + proportions +
    plot_layout(guides = "collect") & # ça permet de n'avoir qu'une légende
    theme(legend.position = "bottom")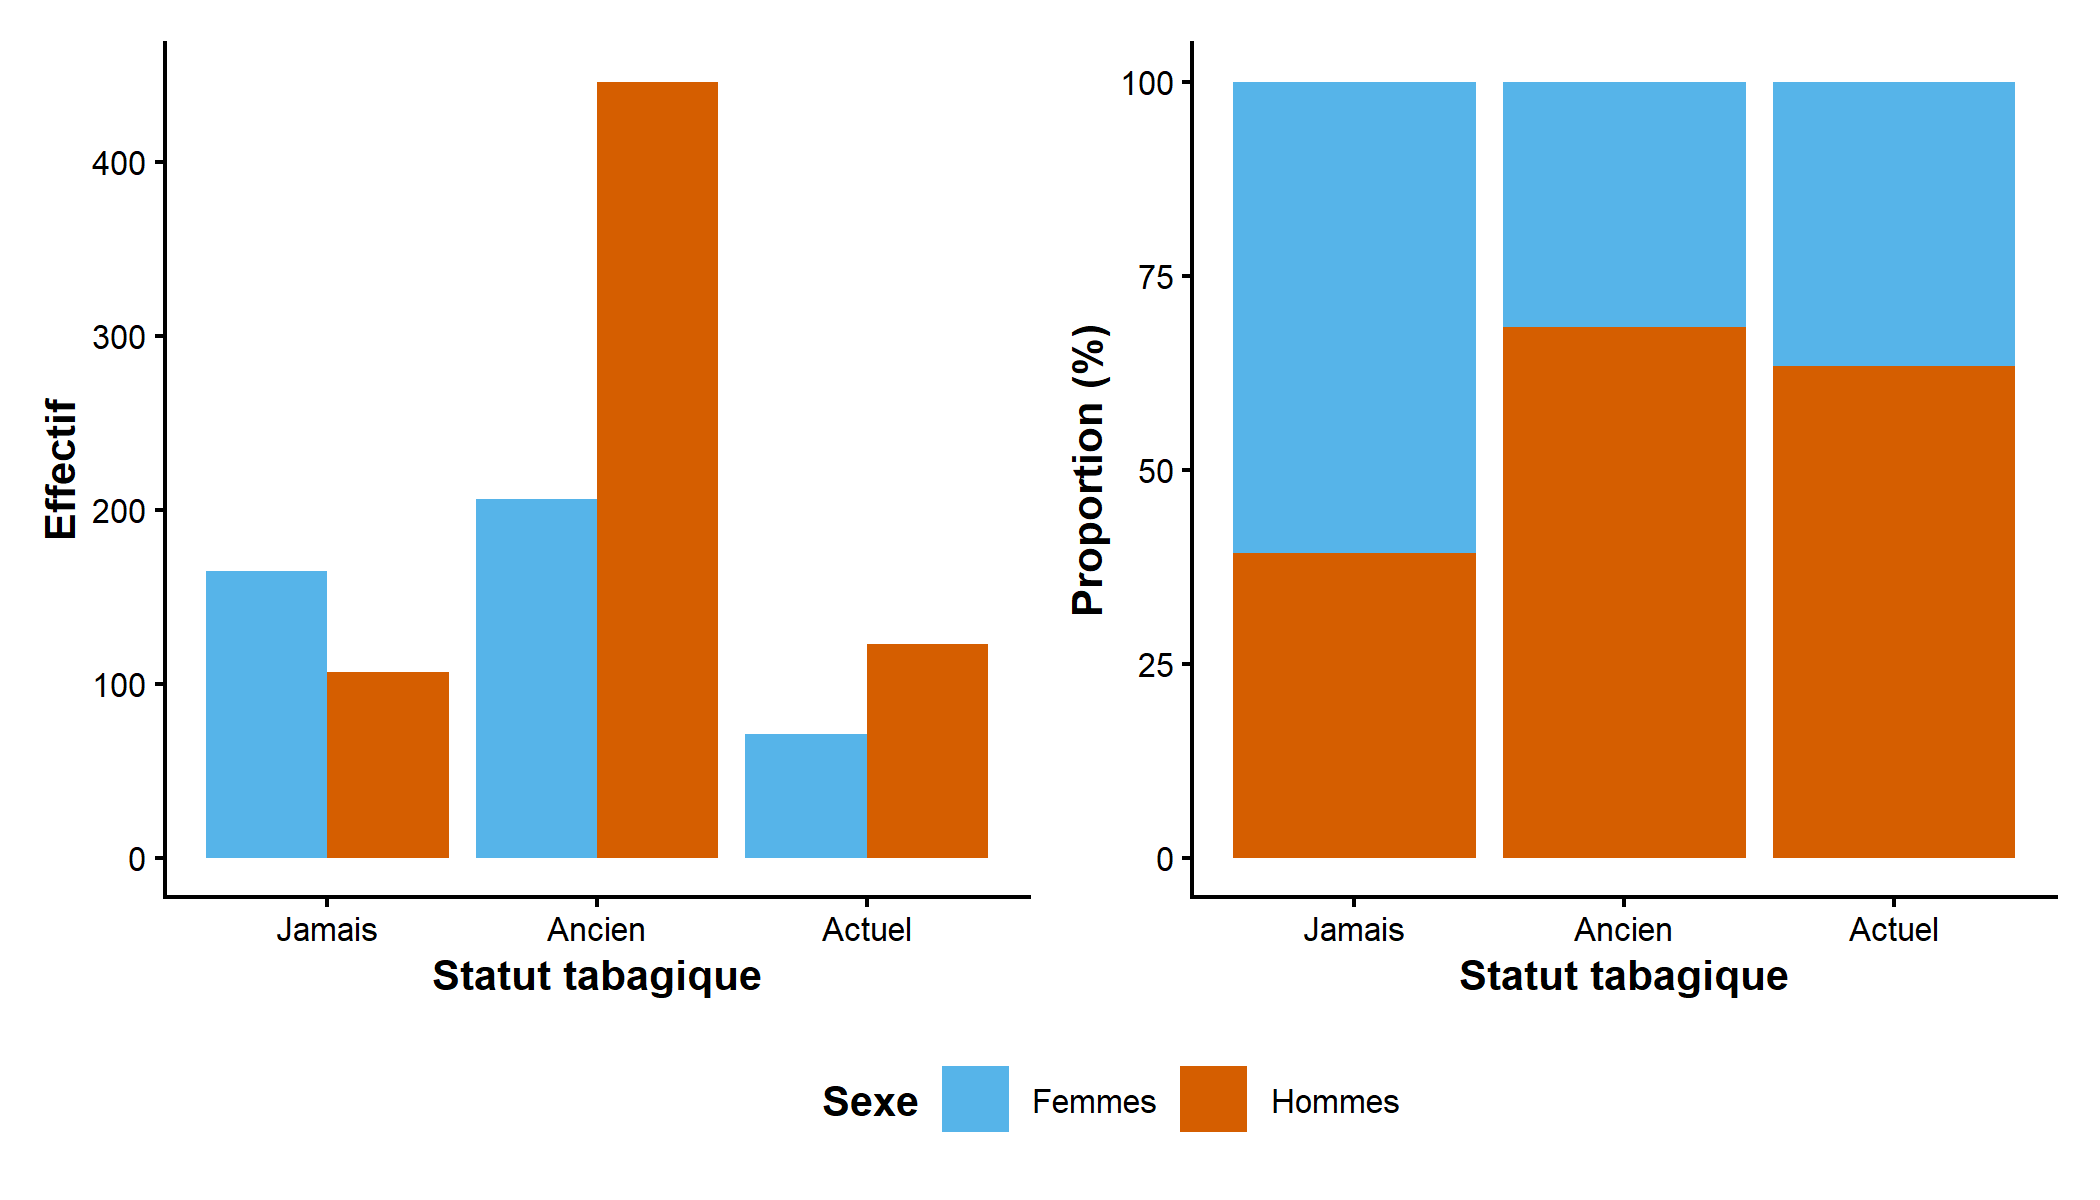
Fréquence cumulée
ggplot(pam, aes(x = age, colour = sexe, linetype = sexe)) +
    stat_ecdf(geom = "step") +
    scale_y_continuous(
        limits = c(0, 1),
        breaks = seq(0, 1, by = 0.25),
        labels = scales::label_number(
            scale = 100,
            accuracy = 1,
            decimal.mark = ","
        )
    ) +
    labs(x = "Âge (années)", y = "Fréquence cumulée (%)") +
    theme_ste()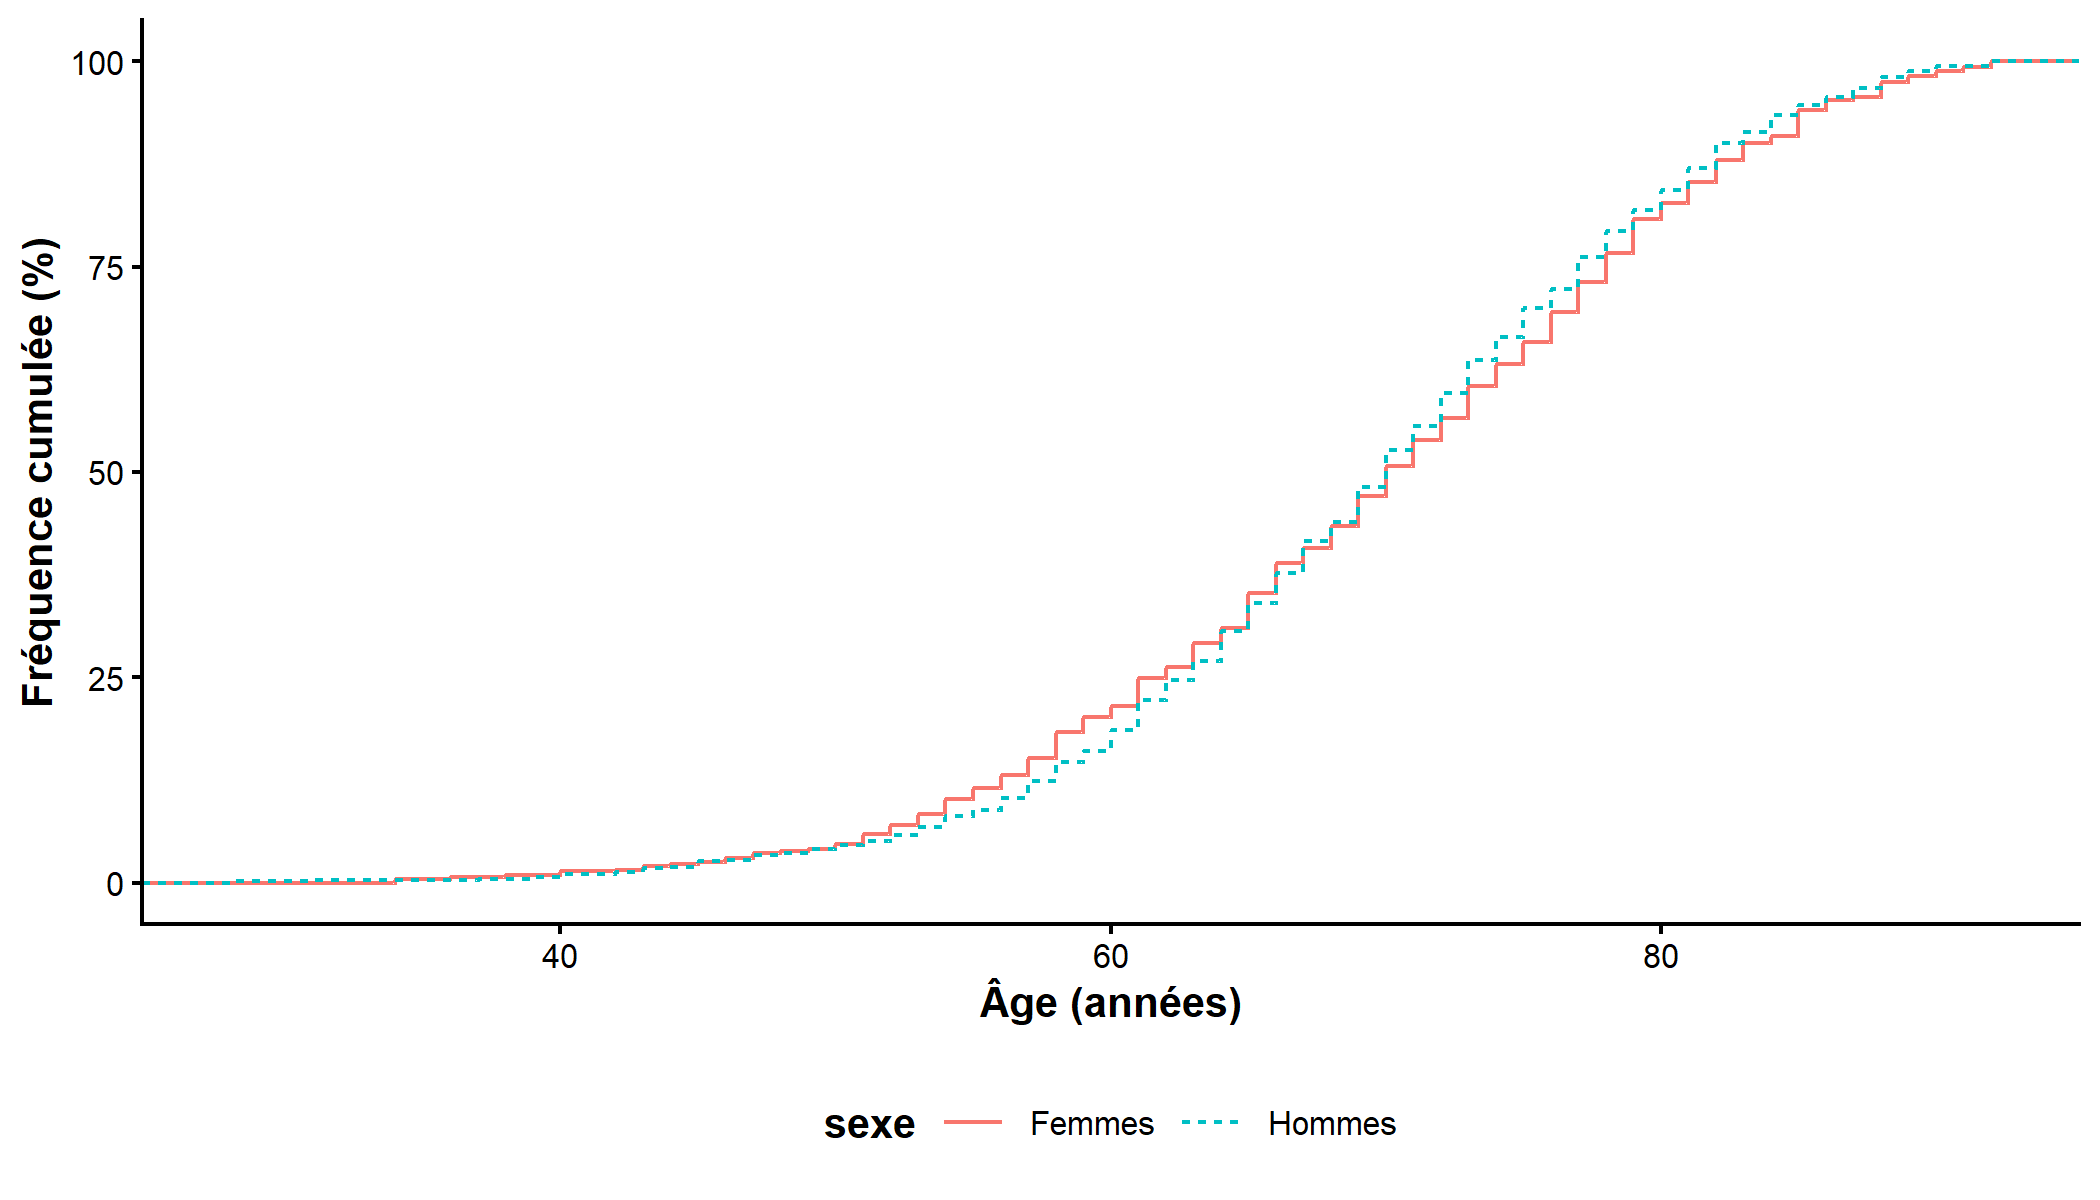
Un graphique par groupe
Pour que vous le sachiez, il est possible, grâce à la fonction facet_wrap(), d’aisément reproduire le même graphique au sein de différents groupes. On va donner un exemple avec le nuage de point précédent, où on en fait un pour les femmes et un pour les hommes. Comme ces graphiques concluent cette section sur ggplot2, on va essayer de tout donner niveau options, histoire que vous ayez un exemple plus complet !
ggplot(pam, aes(x = taille, y = poids)) +
    geom_point(aes(colour = sexe), alpha = 0.2, size = 1) +
    geom_smooth(aes(colour = sexe, fill = sexe), method = "lm", alpha = 0.1) +
    facet_wrap(vars(sexe), nrow = 1) +
    scale_colour_manual(values = couleurs_sexe) +
    scale_fill_manual(values = couleurs_sexe) +
    labs(x = "Taille (cm)", y = "Poids (kg)") +
    theme_ste() +
    theme(
        strip.background = element_rect(fill = "grey95", colour = "grey80"),
        strip.text = element_text(face = "bold", colour = "grey20"),
        panel.spacing = grid::unit(1, "lines") # espace entre les deux plots
    ) +
    # pas besoin de la légende, c'est redondant avec les titres des facettes
    guides(colour = "none", fill = "none")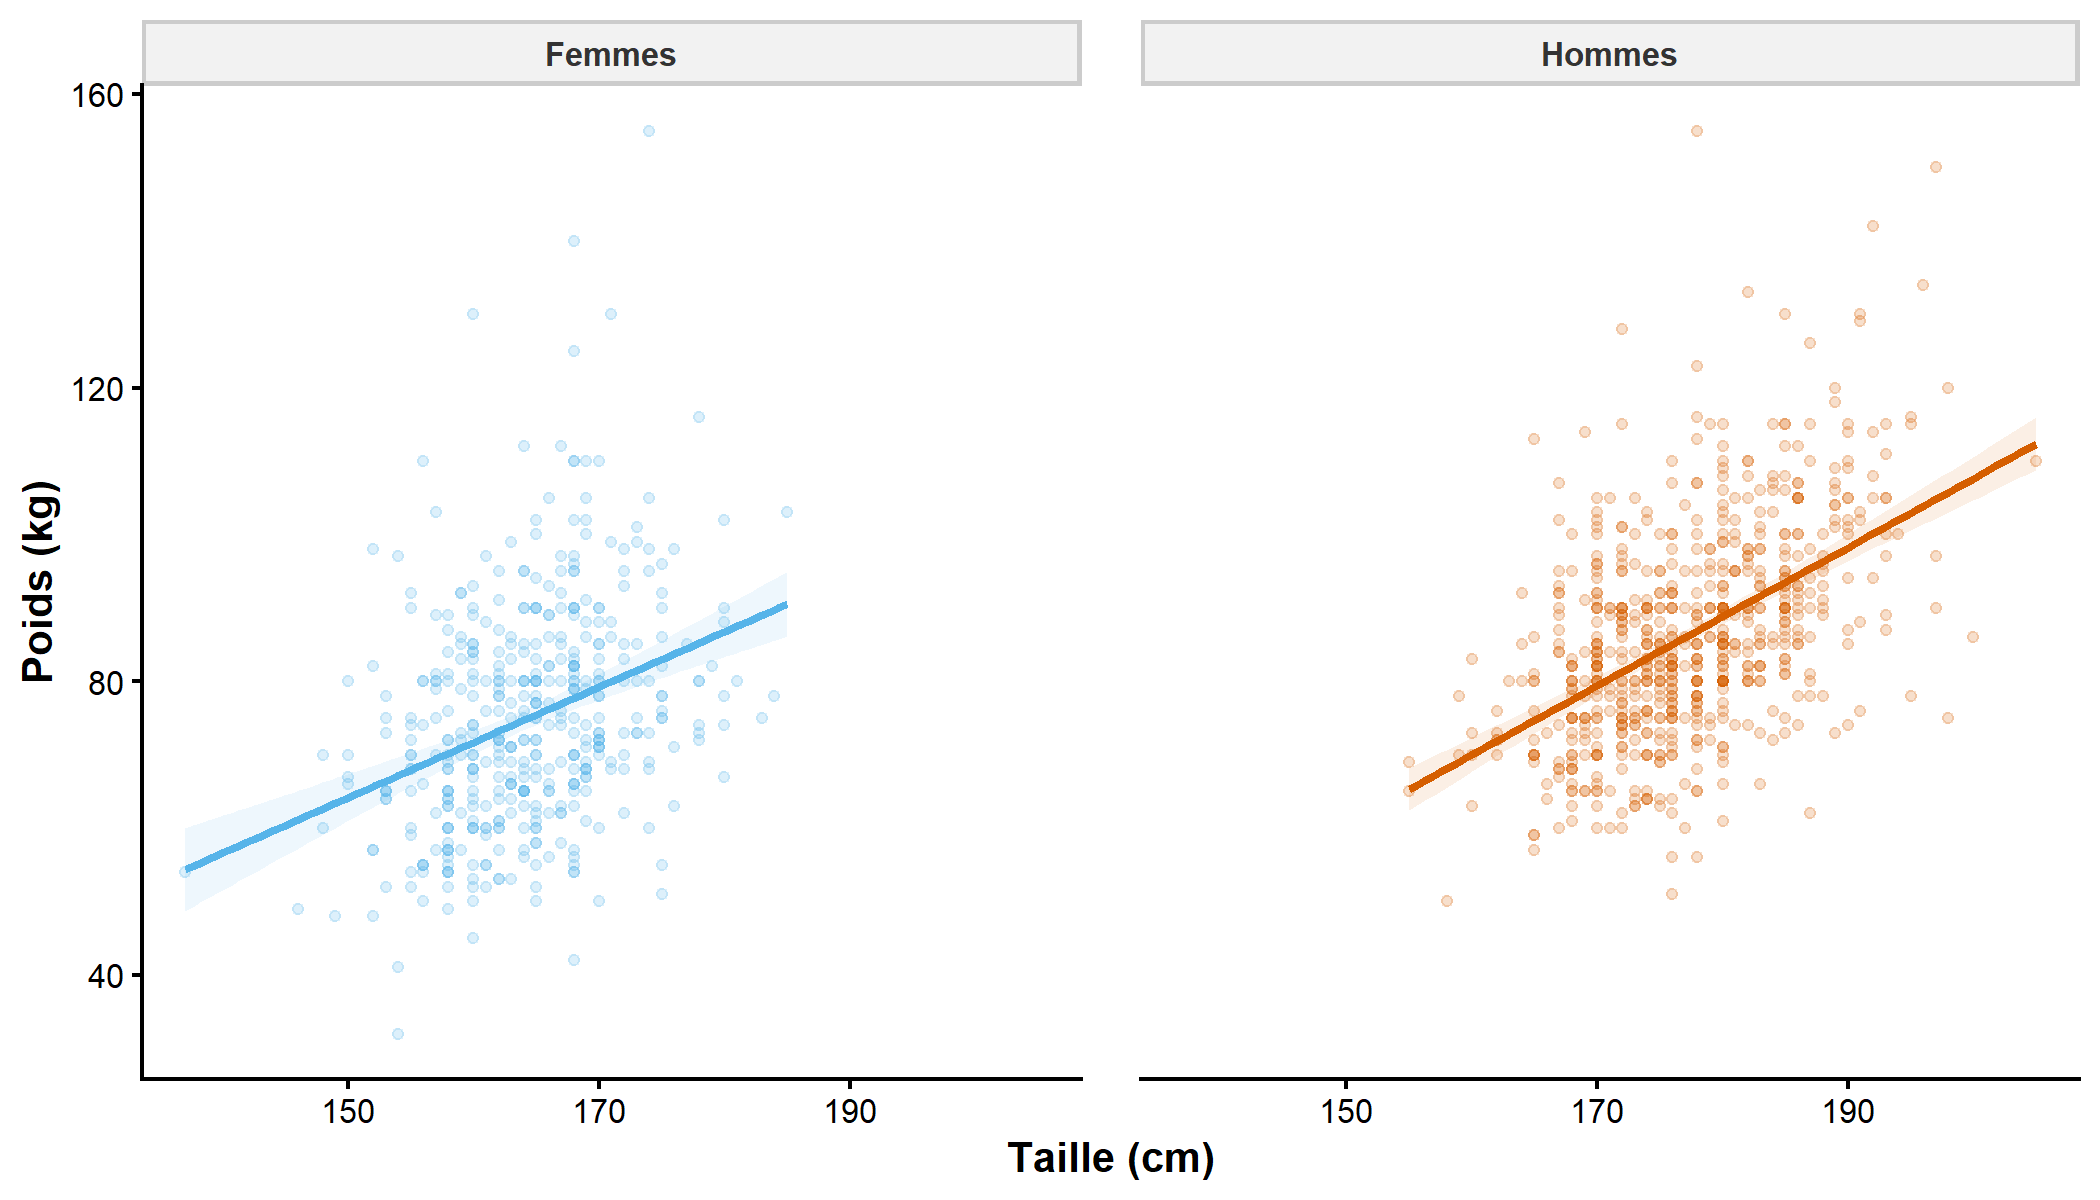
On peut aussi utiliser facet_grid() pour faire des croisements de deux variables qualitatives. Par exemple, si on voulait faire le même graphique que précédemment, mais en croisant le sexe et le statut tabagique. Ce n’est pas le plus lisible du monde (mais au moins vous voyiez l’idée), mais les points sont colorés selon le sexe, et la droite de tendance est tracée selon le statut tabagique.
ggplot(pam, aes(x = taille, y = poids)) +
    geom_point(aes(colour = sexe), alpha = 0.3, size = 1) + # points = sexe
    geom_smooth(
        aes(colour = tabagisme, fill = tabagisme),
        method = "lm", se = TRUE, alpha = 0.1
    ) + # droite et erreur standard = tabagisme
    facet_grid(rows = vars(sexe), cols = vars(tabagisme)) +
    scale_colour_manual(values = c(couleurs_sexe, couleurs_tabagisme)) +
    scale_fill_manual(values = couleurs_tabagisme) +
    labs(x = "Taille (cm)", y = "Poids (kg)") +
    theme_ste() +
    theme(
        strip.background = element_rect(fill = "grey95", colour = "grey80"),
        strip.text = element_text(face = "bold", colour = "grey20"),
        panel.grid.major.y = element_line(colour = "grey90", linewidth = 0.3),
        panel.spacing = grid::unit(0.8, "lines")
    ) +
    guides(colour = "none", fill = "none")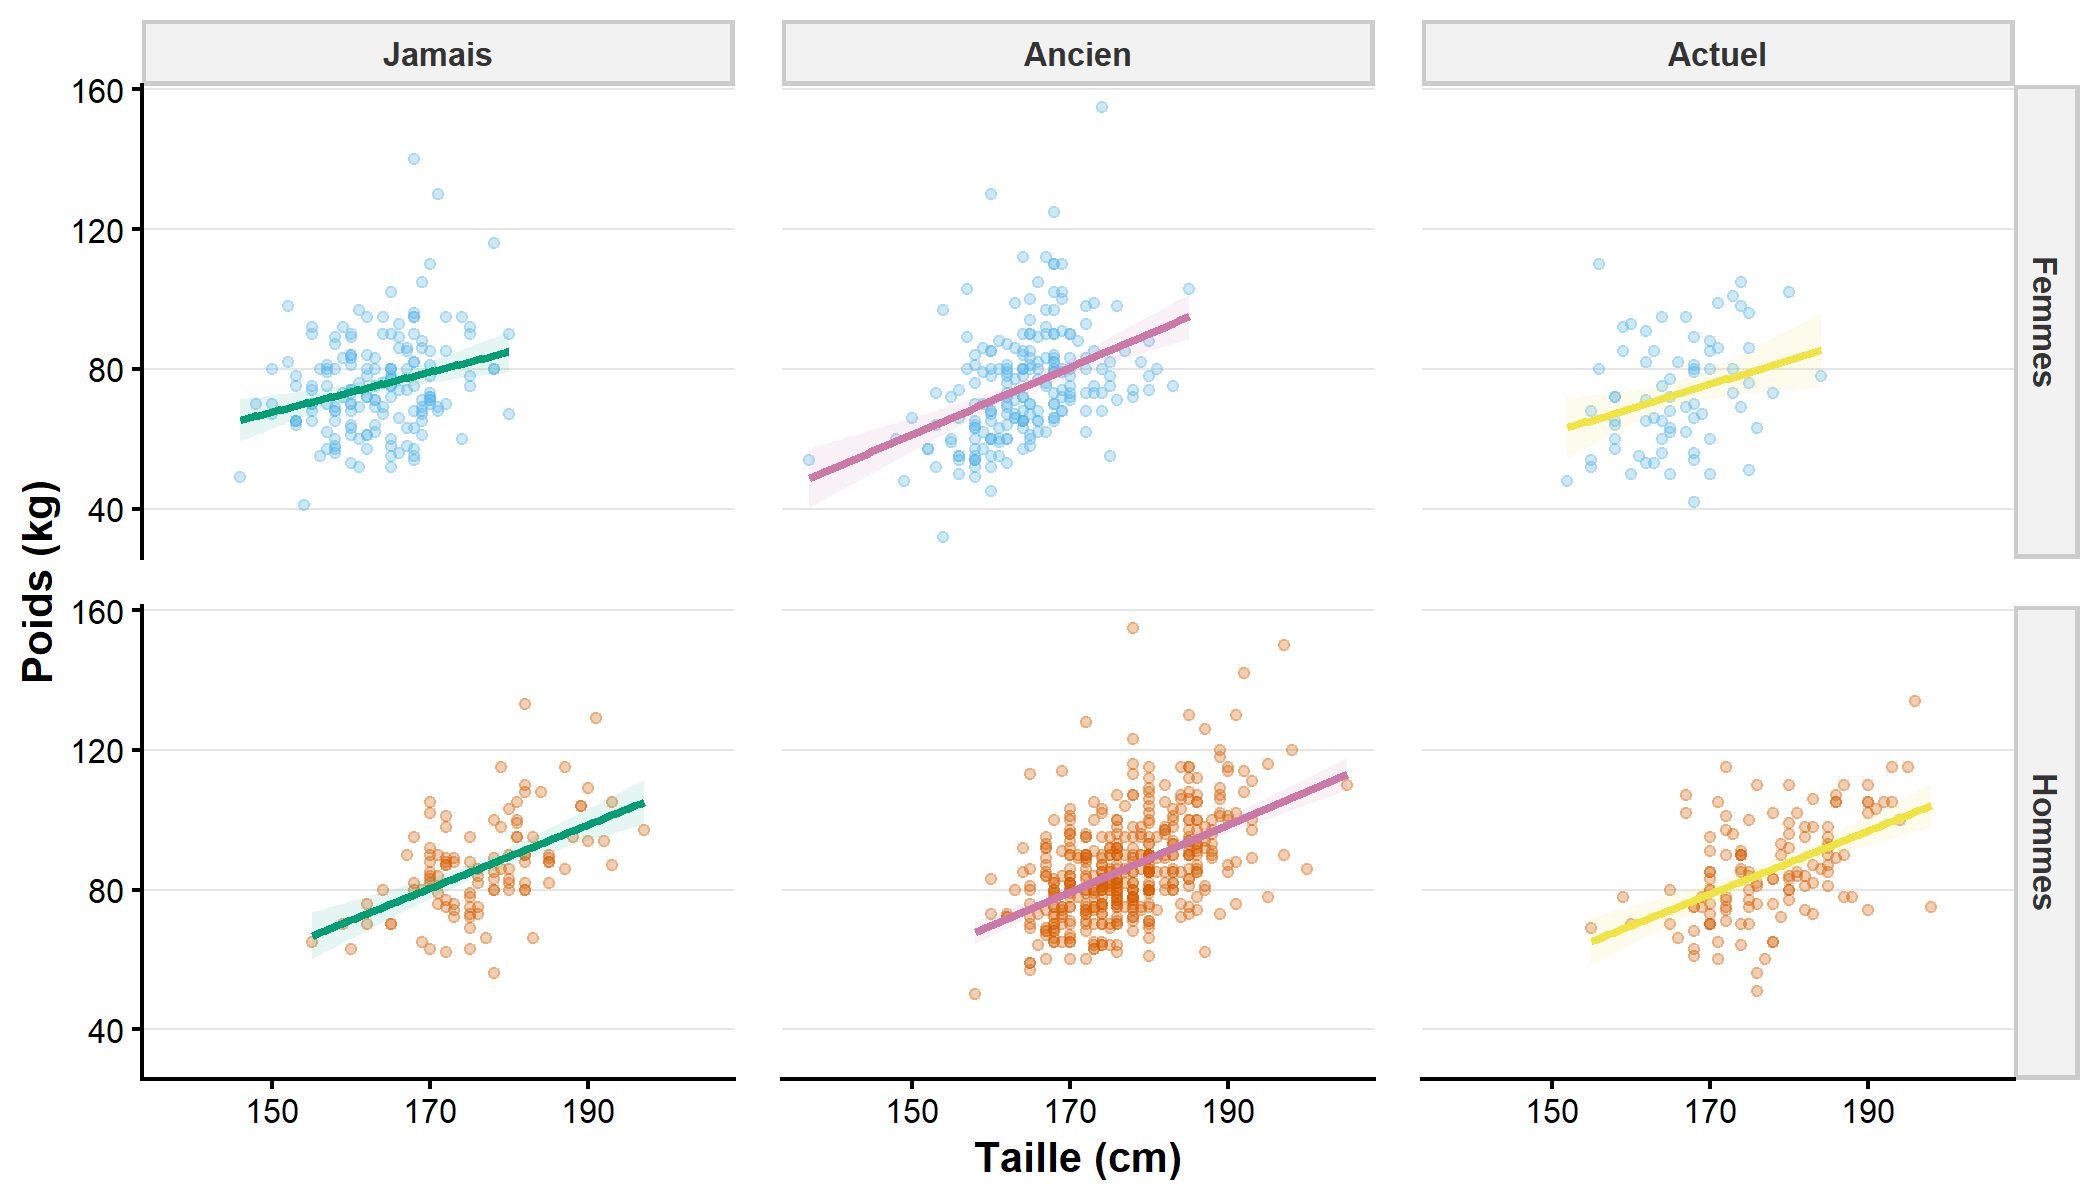
Raincloud plot
On en a parlé dans le cours, et on trouve ça plutôt élégant : le raincloud plot combine une densité, un boxplot et les observations individuelles en une seule figure.
pam_raincloud <- pam |>
    mutate(y_groupe = as.numeric(tabagisme), y_points = y_groupe - 0.28)

ggplot(pam_raincloud, aes(x = age, y = y_groupe, fill = tabagisme)) +
    ggdist::stat_slab( # une densité pour chaque groupe
        aes(group = tabagisme),
        alpha = 0.4,
        colour = NA,
        height = 0.5,
    ) +
    geom_boxplot(
        aes(group = tabagisme),
        width = 0.1,
        position = position_nudge(y = -0.1),
        linewidth = 0.3,
        alpha = 0.7,
        outlier.shape = NA,
        orientation = "y"
    ) +
    geom_jitter(
        aes(y = y_points),
        shape = 21,
        colour = "grey20",
        size = 0.9,
        stroke = 0.2,
        alpha = 0.3,
        width = 0,
        height = 0.05
    ) +
    scale_y_continuous(
        breaks = seq_along(levels(pam_raincloud$tabagisme)),
        labels = levels(pam_raincloud$tabagisme),
        expand = expansion(mult = c(0.08, 0.18))
    ) +
    scale_fill_manual(values = couleurs_tabagisme) +
    labs(x = "Âge (années)", y = "Statut tabagique") +
    guides(fill = "none") +
    theme_ste() +
    theme(axis.line.y = element_blank(), axis.ticks.y = element_blank())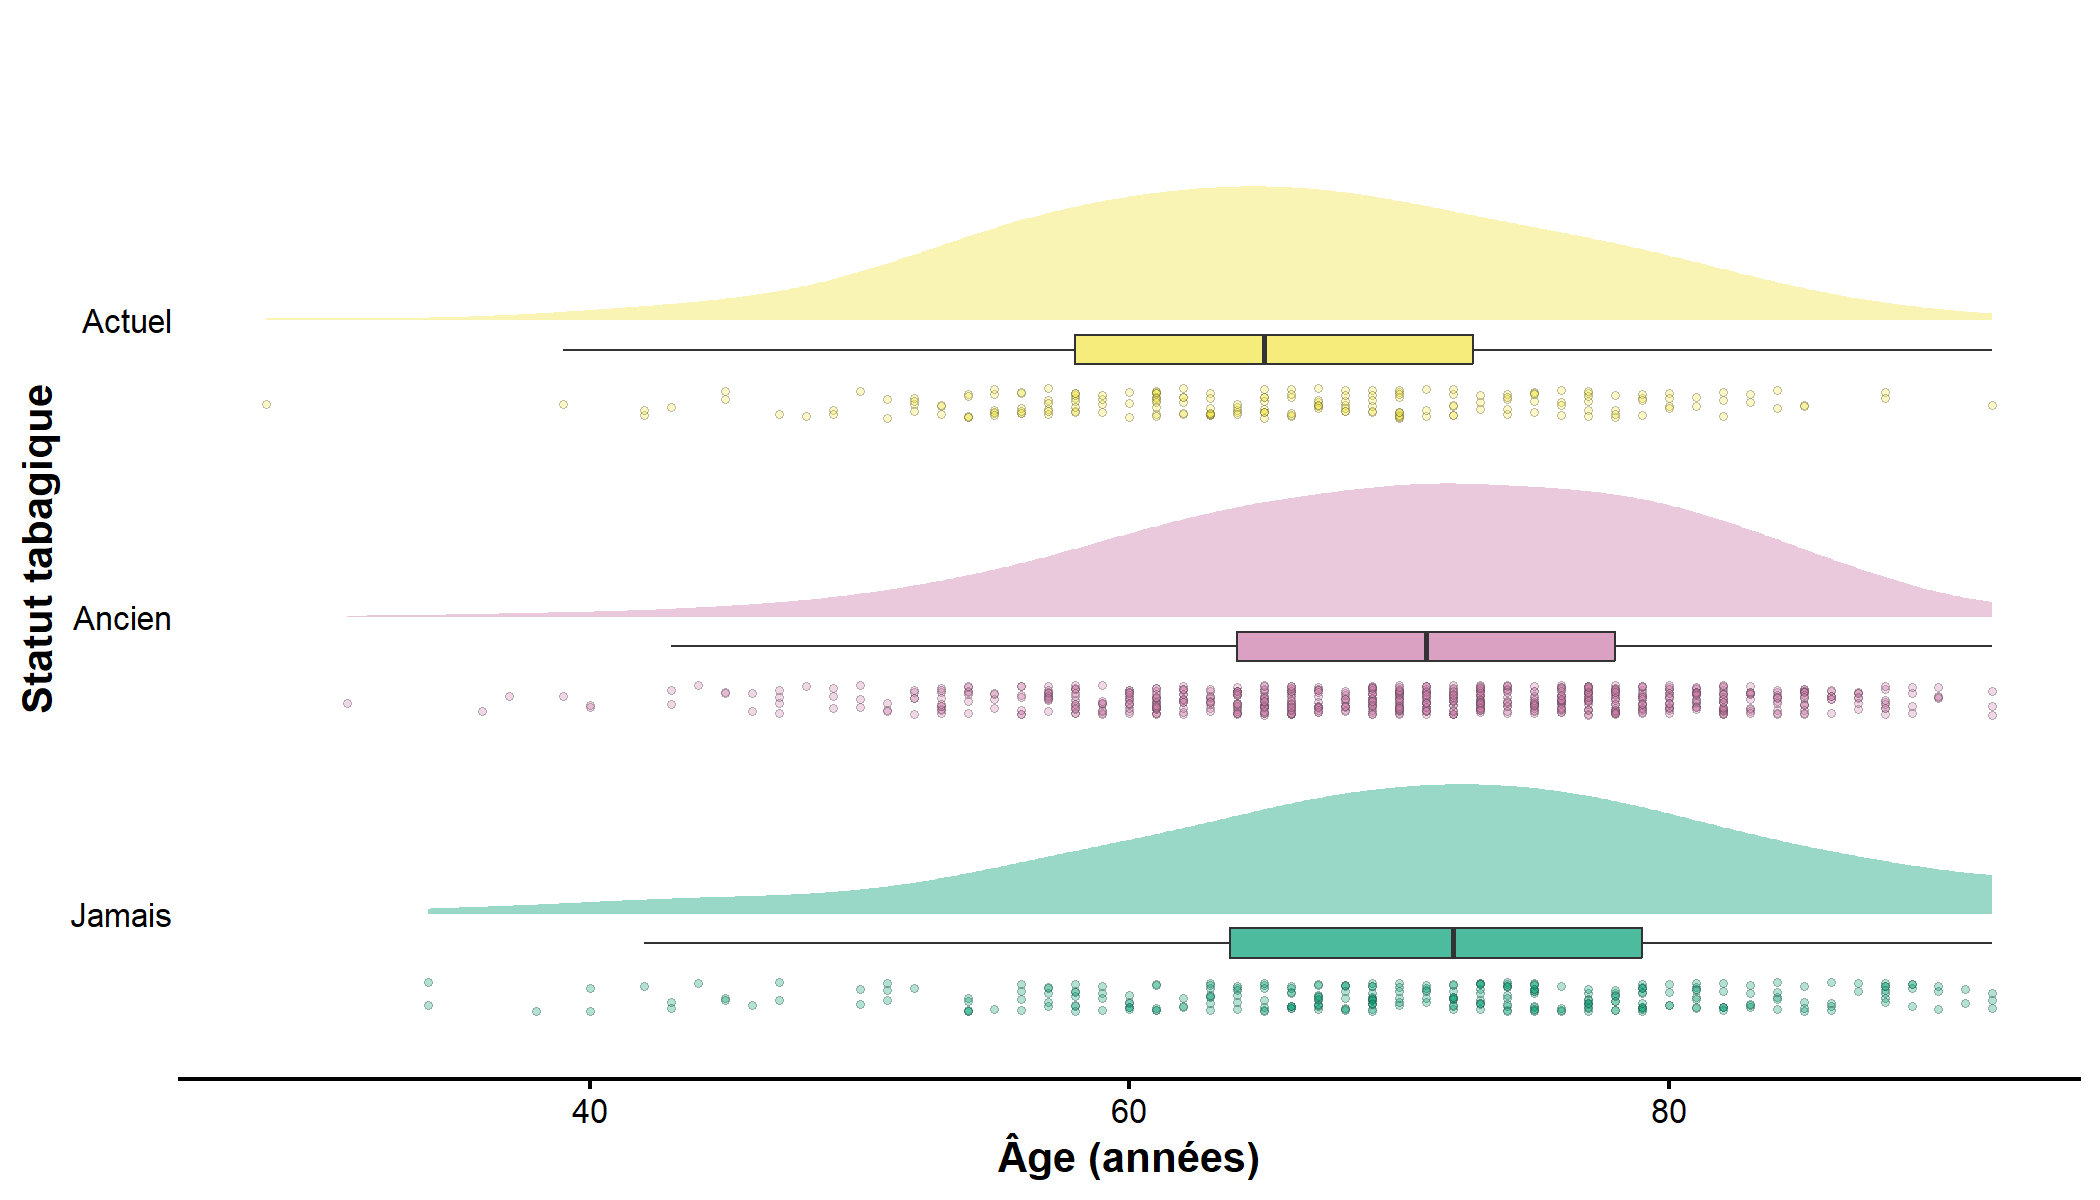
Ressources complémentaires : visualisation des données
-
Packages basés sur
ggplot2-
ggpubretggscipour les graphiques scientifiques -
ggstatsplotpour des graphes avec statistiques intégrées -
ggsurvfitpour l’analyse de survie
-