5 Pour aller plus loin
5.1 Structures de corrélation résiduelle
Jusqu’ici, nous avons supposé qu’une fois les effets aléatoires pris en compte, les résidus étaient indépendants et avaient tous la même variance : \(\mathbf R = \sigma^2 \mathbf I\). Pour des données groupées sans ordre, comme des patients répartis dans des hôpitaux, cette hypothèse peut être raisonnable.
Mais pensons maintenant aux mesures répétées dans le temps de l’étude sur la privation de sommeil. Même après avoir tenu compte de la trajectoire propre de chaque sujet, deux mesures prises à des jours proches peuvent rester plus corrélées que deux mesures éloignées. Comment représenter cette dépendance ? Rappelons la covariance marginale d’un modèle mixte : \[ \mathbf V_i = \underbrace{\mathbf Z_i \mathbf G \mathbf Z_i^\top}_{\text{effets aléatoires}} + \underbrace{\mathbf R_i}_{\text{résidus}} . \] Nous avons donc deux leviers : les effets aléatoires, dont la covariance est décrite par \(\mathbf G\), et la structure des résidus, décrite par \(\mathbf R_i\). Ensemble, ils déterminent la covariance entre les mesures d’un même sujet. Choisir une structure de corrélation revient ainsi à choisir une forme pour \(\mathbf V_i\).
5.1.1 Ce que les effets aléatoires imposent déjà
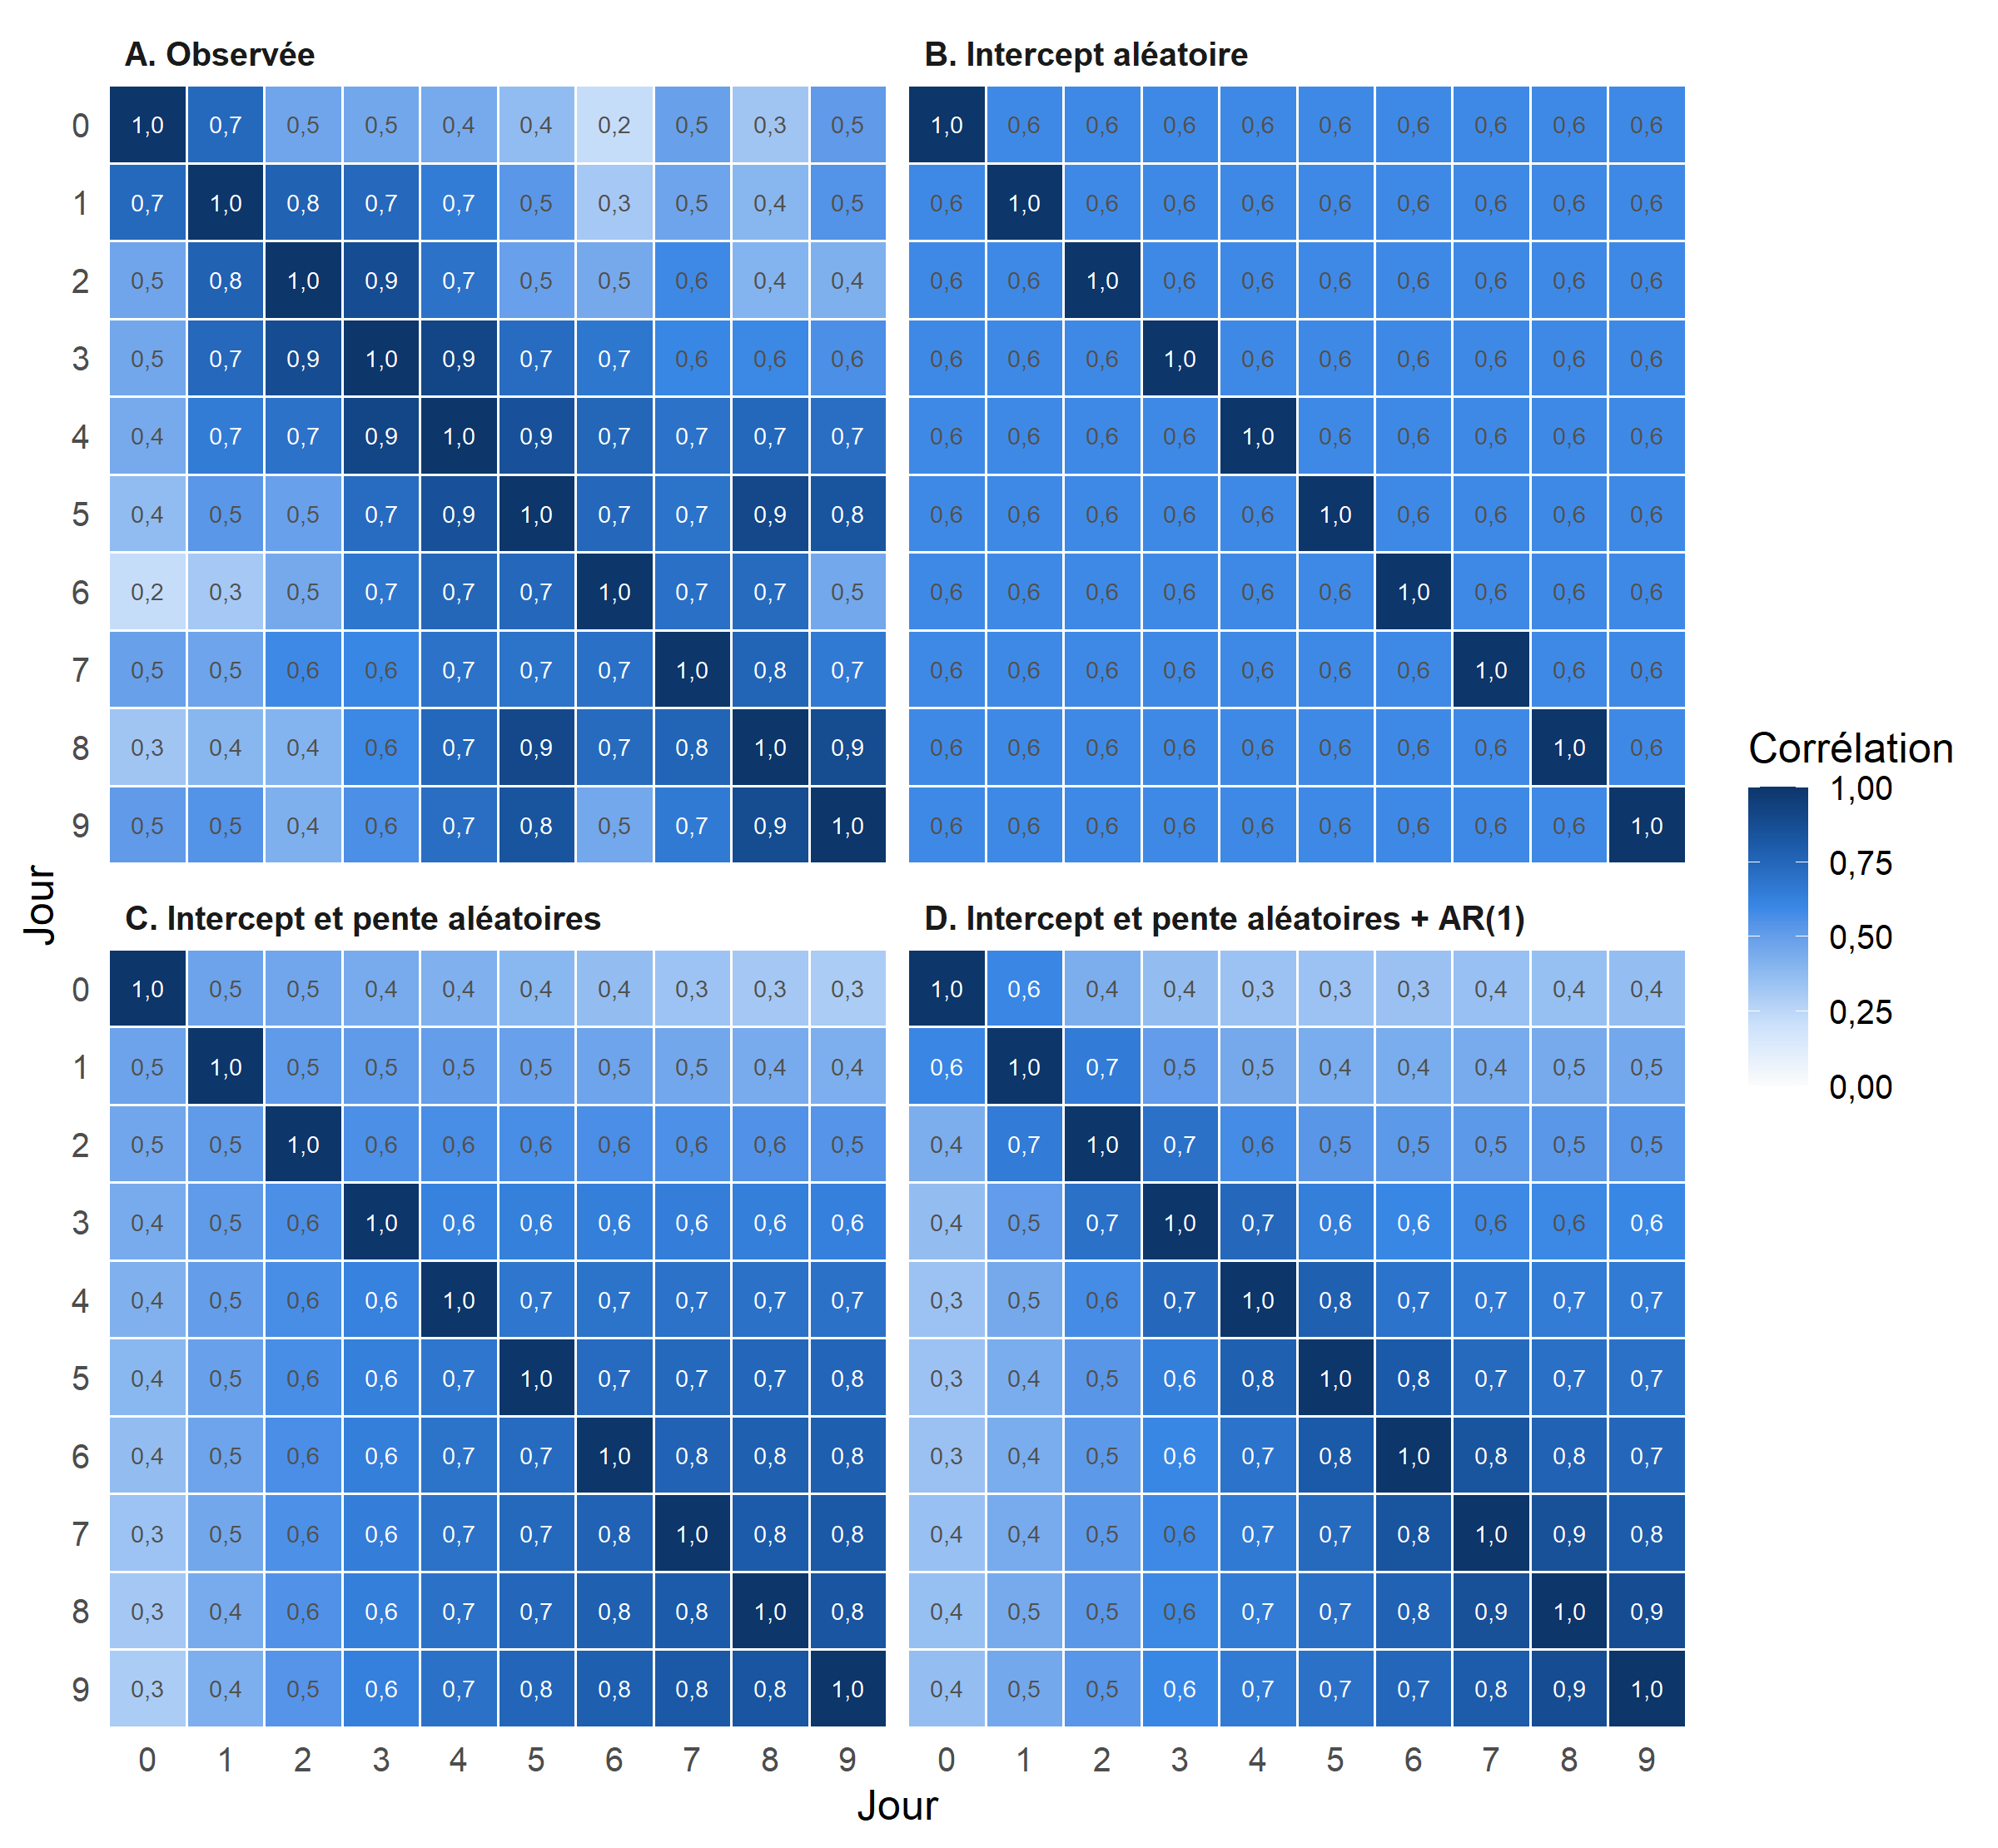
Avant de choisir une structure, regardons ce que les modèles que nous connaissons impliquent déjà. Pour chaque paire de jours, nous calculons la corrélation empirique des temps de réaction sur les 18 sujets, puis nous la comparons à la corrélation prévue par plusieurs modèles.
Commençons par la matrice observée (A). La corrélation tend à diminuer lorsque l’écart entre les jours augmente : elle vaut environ 0,74 entre les jours 0 et 1, contre 0,22 entre les jours 0 et 6. Elle est aussi plus forte entre les jours tardifs.
On observe également que la variance augmente au fil du temps :
| Days | ecart_type |
|---|---|
| 0 | 32.12945 |
| 1 | 33.43033 |
| 2 | 29.47342 |
| 3 | 38.85774 |
| 4 | 42.53789 |
| 5 | 51.76962 |
| 6 | 63.17372 |
| 7 | 50.10396 |
| 8 | 60.19972 |
| 9 | 66.98616 |
En effet, l’écart-type entre sujets passe de 32,1 ms au jour 0 à 67 ms au jour 9. Il nous faudrait alors une structure de corrélation qui permette de modéliser \(\mathbf{V}_i\) afin
- de gérer une corrélation qui diminue avec l’écart entre les jours, et
- de gérer une variance qui change avec le temps.
On l’a dit, le premier levier pour mieux modéliser \(\mathbf{V}_i\) correspond aux effets aléatoires, dont la covariance est décrite par \(\mathbf G\). D’après la Figure 1 :
- Avec un intercept aléatoire seul (B), la corrélation est la même entre tous les jours : elle vaut 0,59. On parle de symétrie composée (ou compound symmetry, CS). Cette structure ne reproduit donc ni la décroissance avec l’écart entre les jours, ni l’augmentation de la variance ;
- Ajouter une pente aléatoire (C) permet d’obtenir une variance qui croît avec le temps et des corrélations plus fortes entre les jours tardifs. Ca semble mieux coller à (A), mais certaines corrélations sont encore trop éloignées de ce qu’on a obtenu en théorie.
Le second levier est la structure de covariance résiduelle \(\mathbf R_i\). Il existe pléthore de structures de corrélation résiduelle, et on en présente juste après que les plus courantes. Pour le modèle (D) de la Figure 1, on a choisi une structure AR(1). Elle est souvent utilisée pour des mesures répétées dans le temps, quand on suspecte que le lien entre les mesures diminue avec le temps. Visuellement, on voit que le gradient de bleu semble plus coller à ce qu’on avait en A !
5.1.2 Les structures de corrélation résiduelle usuelles
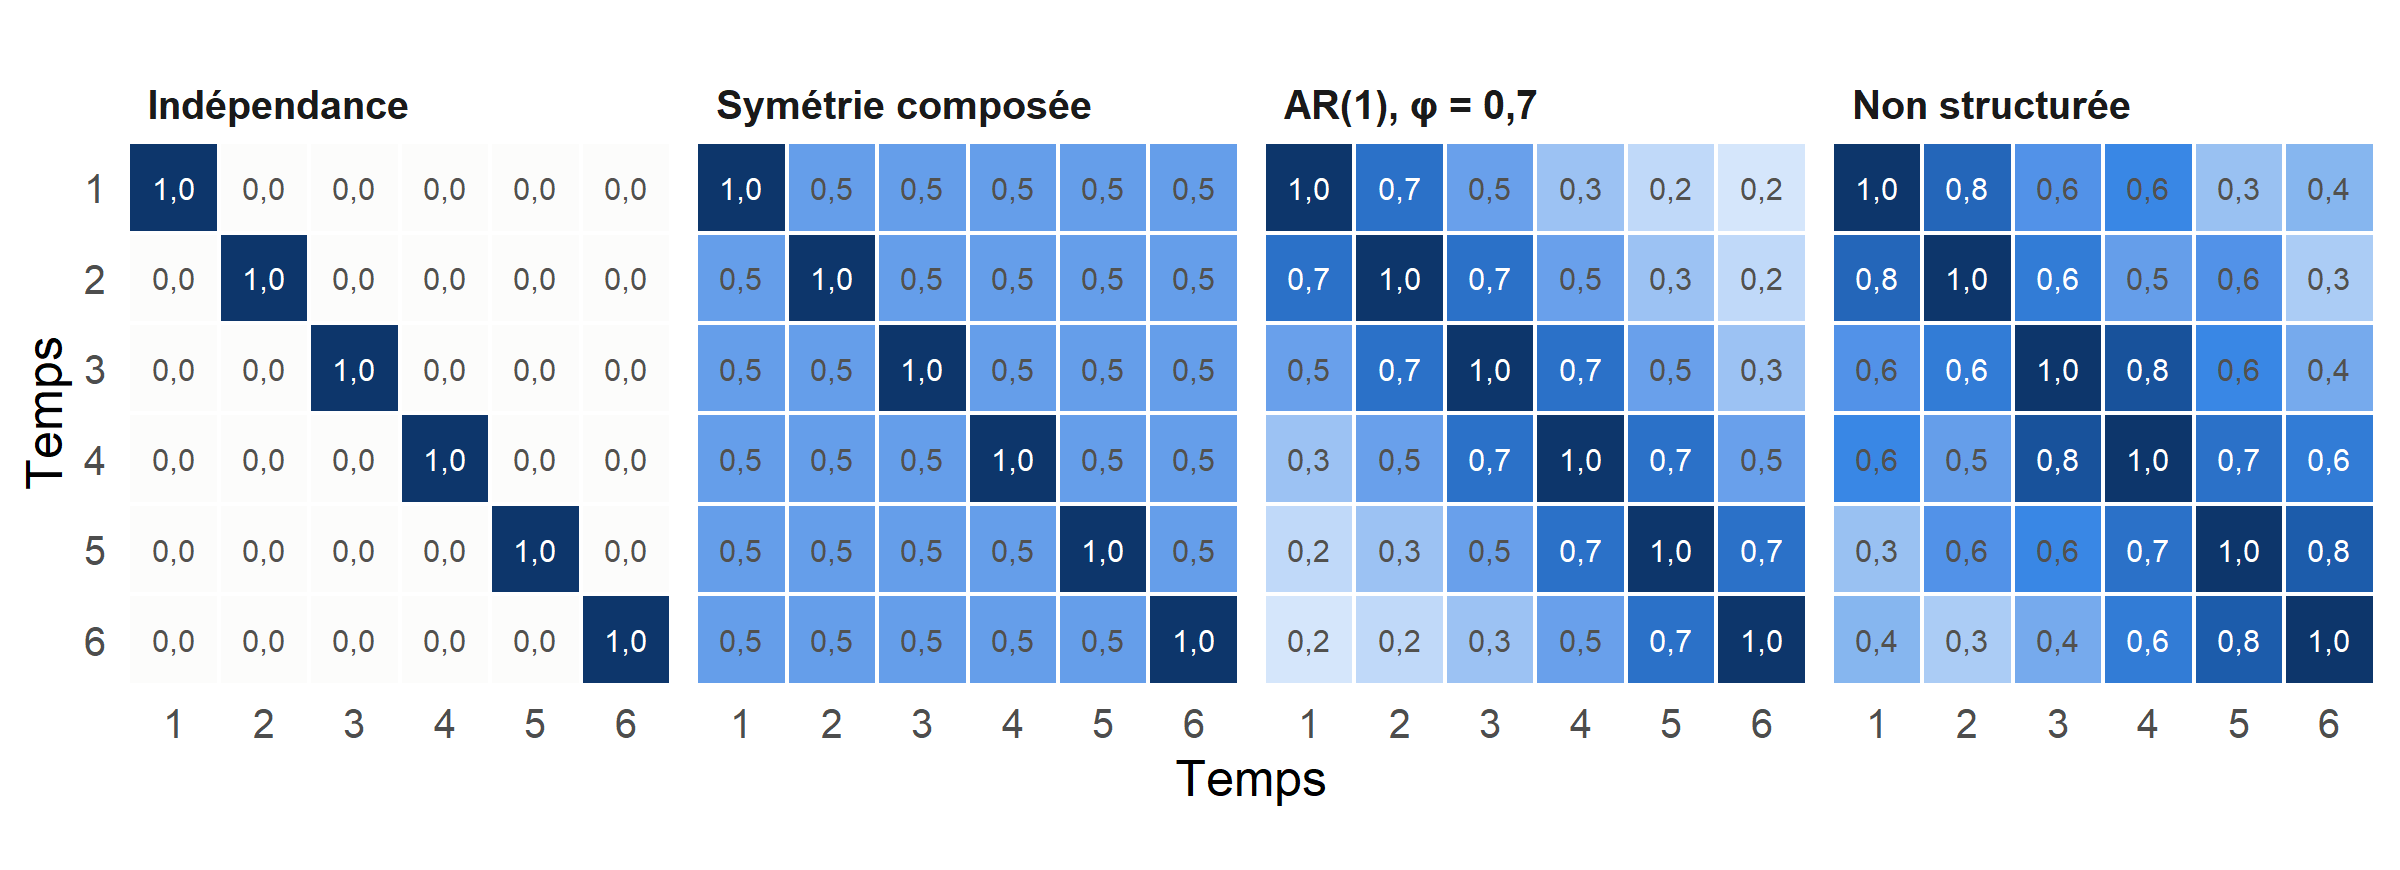
Pour un même sujet mesuré aux temps \(t_1, \dots, t_T\), le tableau suivant présente les structures les plus courantes, leur nombre de paramètres et les situations où elles peuvent être utiles. Elles sont aussi illustrées en Figure 2.
| Structure | \(\mathrm{Corr}(\varepsilon_{ij}, \varepsilon_{ik})\) | Paramètres (pour \(T\) temps) | nlme |
Quand l’envisager |
|---|---|---|---|---|
| Indépendance | \(0\) | 1 (\(\sigma^2\)) | (défaut) | après les effets aléatoires, si les résidus ne montrent plus de corrélation |
| Symétrie composée (CS) | \(\rho\) | 2 | corCompSymm() |
données sans ordre (équivaut à un intercept aléatoire si \(\rho \geq 0\)) |
| Autorégressive d’ordre 1, AR(1) | \(\phi^{\lvert j-k \rvert}\) | 2 | corAR1() |
temps réguliers, corrélation qui décroît avec l’écart |
| AR(1) en temps continu | \(\phi^{\lvert t_j-t_k \rvert}\) | 2 |
corCAR1(), corExp()
|
temps irréguliers ou différents d’un sujet à l’autre |
| Toeplitz / ARMA | dépend seulement de l’écart \(\lvert j-k \rvert\) | jusqu’à \(T\) | corARMA() |
temps réguliers, décroissance non géométrique |
| Non structurée (UN) | libre | \(T(T+1)/2\) avec des variances par temps |
corSymm() + varIdent()
|
peu de temps, beaucoup de sujets (essais cliniques typiquement ?) |
NoteRemarque
Avec lme4, la fonction lmer() ne permet pas de modéliser \(\mathbf R\) : les résidus y sont toujours indépendants. Pour préciser une structure de corrélation résiduelle, on peut utiliser nlme::lme() si l’on souhaite aussi des effets aléatoires, ou nlme::gls() pour une corrélation sans effet aléatoire.
D’autres packages proposent également ces structures. Par exemple, glmmTMB offre ar1(), ou(), toep() ou us(), tandis que mmrm est dédié aux modèles à mesures répétées à structure non structurée (MMRM), courants dans l’analyse des essais cliniques.
Malgré cette présentation, gardez en tête qu’il n’existe pas de solution universelle ! Il faut donc tester plusieurs structure, et pourquoi pas comparer les différents modèles sur 1/ les AIC/BIC, 2/ l’erreur standard de l’effet qui nous intéresse.
5.1.3 Application à l’étude sur la privation de sommeil avec nlme
Mettons cette démarche en pratique avec les mesures de l’étude sur la privation de sommeil. Nous gardons les mêmes effets fixes et ajustons plusieurs structures : certaines utilisent gls() sans effet aléatoire, d’autres lme() avec un intercept, puis éventuellement une pente aléatoire et une corrélation AR(1).
library(nlme, include.only = c(
    "lme", "gls", "corCompSymm", "corAR1", "corSymm",
    "varIdent", "lmeControl", "ACF"
))

modeles <- list(
    "Indépendance (gls)" = gls(Reaction ~ Days, data = sleepstudy),
    "Intercept aléatoire" = lme(Reaction ~ Days, random = ~ 1 | Subject, data = sleepstudy),
    "Intercept aléatoire + AR(1)" = lme(Reaction ~ Days,
        random = ~ 1 | Subject, data = sleepstudy,
        correlation = corAR1(form = ~ Days | Subject)
    ),
    "Intercept et pente aléatoires" = lme(Reaction ~ Days, random = ~ Days | Subject, data = sleepstudy),
    "Intercept et pente aléatoires + AR(1)" = lme(Reaction ~ Days,
        random = ~ Days | Subject, data = sleepstudy,
        correlation = corAR1(form = ~ Days | Subject), control = lmeControl(opt = "optim")
    ),
    "Non structurée + une variance par jour (gls)" = gls(Reaction ~ Days,
        data = sleepstudy,
        correlation = corSymm(form = ~ 1 | Subject),
        weights = varIdent(form = ~ 1 | Days)
    )
)sleepstudy (mêmes effets fixes, ajustement REML). df : nombre de paramètres. Les deux dernières colonnes donnent l’effet estimé de Days et son erreur standard.
| Modèle | df | AIC | BIC | Pente de Days | Erreur standard |
|---|---|---|---|---|---|
| Indépendance (gls) | 3 | 1 899,7 | 1 909,2 | 10,47 | 1,24 |
| Intercept aléatoire | 4 | 1 794,5 | 1 807,2 | 10,47 | 0,80 |
| Intercept aléatoire + AR(1) | 5 | 1 746,2 | 1 762,1 | 10,47 | 1,34 |
| Intercept et pente aléatoires | 6 | 1 755,6 | 1 774,7 | 10,47 | 1,55 |
| Intercept et pente aléatoires + AR(1) | 7 | 1 738,2 | 1 760,5 | 10,47 | 1,53 |
| Non structurée + une variance par jour (gls) | 57 | 1 730,2 | 1 911,6 | 10,02 | 1,12 |
On peut en tirer plusieurs choses :
- Parmi les structures parcimonieuses, le modèle à intercept et pente aléatoires avec AR(1) a le plus petit AIC (1738,2). Le BIC pénalise davantage la complexité : il favorise de justesse l’AR(1) seul (1759,9) devant ce modèle (1760,5).
- La structure non structurée a l’AIC le plus faible (1730,2), mais elle mobilise 57 paramètres pour 18 sujets (ce n’est pas vraiment parcimonieux…). Ce choix n’est pas raisonnable.
- Enfin, regardons l’incertitude sur la pente. Son erreur standard dépend de la structure choisie : elle vaut 0,80 avec la symétrie composée ou l’intercept aléatoire seul, contre 1,12 à 1,55. avec les autres structures de dépendance. Un modèle à intercept aléatoire seul sous-estimerait donc cette incertitude d’un facteur 1,4 à 2,1.
Pour nous aider, on peut aussi regarder comment les résidus se comportent dans le temps d’un modèle à l’autre, en regardant la fonction d’autocorrélation (ACF) des résidus normalisés (on regarde notamment si les autocorrélations restent à l’intérieur des bornes en pointillés) :
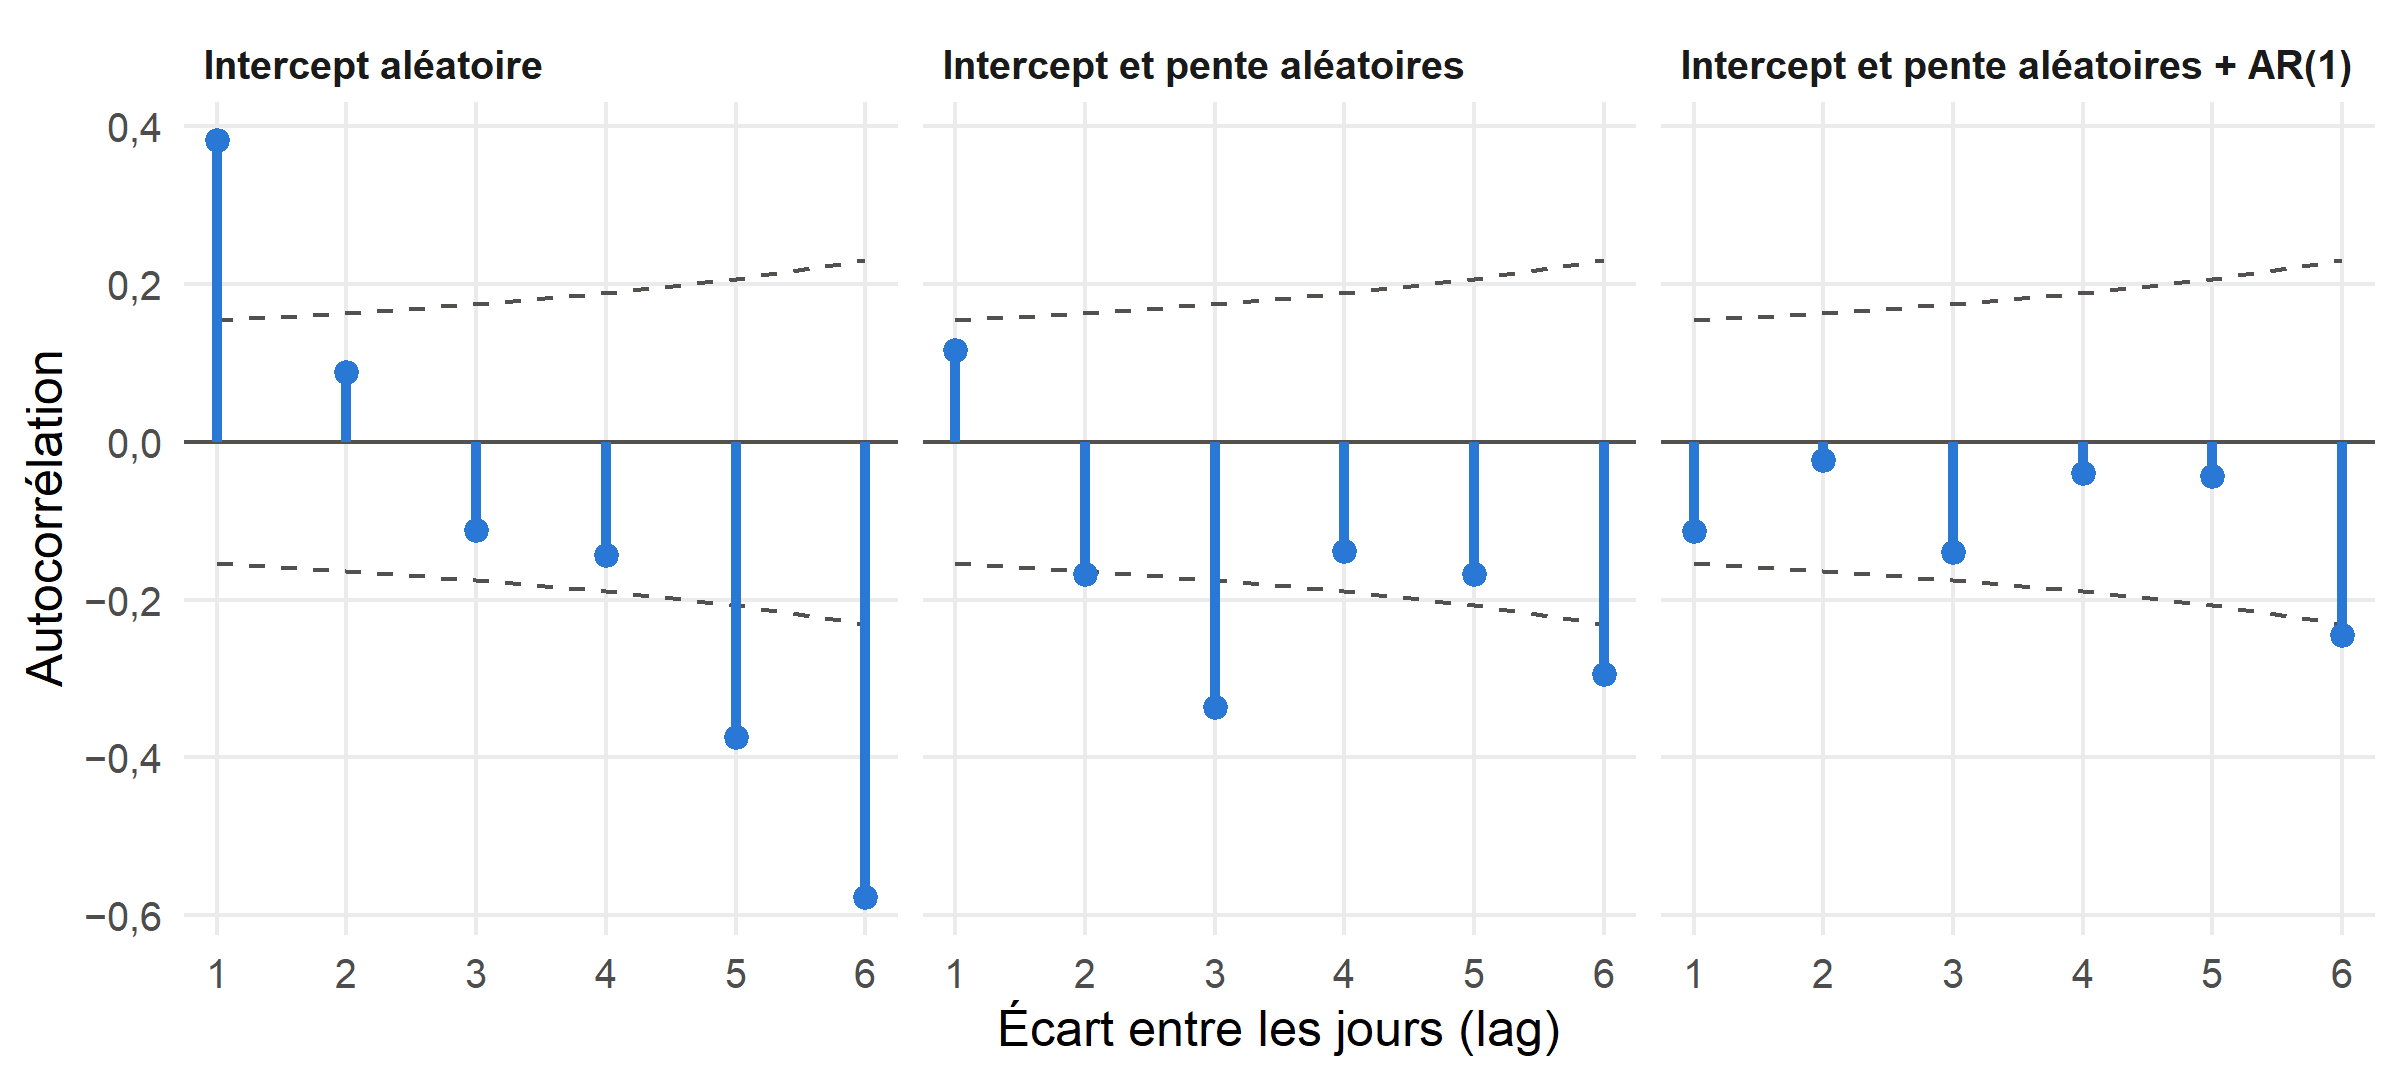
Avec l’intercept aléatoire seul, les résidus restent corrélés : positivement entre jours voisins (0,3/ à un jour d’écart) et négativement entre jours éloignés. Cela indique que les trajectoires individuelles ne sont pas parallèles :
En ajoutant la pente aléatoire, la corrélation entre jours voisins diminue nettement (0,12), même si quelques corrélations négatives subsistent à plus grand écart.
Avec l’AR(1), les autocorrélations sont toutes à l’intérieur des bornes (contrairement à avant), amenant à un argument supplémentaire pour justifier ce choix de structure.
Pour la suite, nous pourrions envisager de garder le modèle à intercept et pente aléatoires avec un AR(1).
Typiquement, dans un rapport, on mentionnerait ces analyses, appelées “analyses de sensibilité”
5.2 Maximum de vraisemblance ou REML ?
Pour estimer les paramètres de notre modèle mixte, nous avons utilisé la vraisemblance. Mais il existe deux façons de le faire, et le choix a notamment des conséquences sur les estimations des variances.
Avec le maximum de vraisemblance (ML), on estime simultanément les effets fixes et les composantes de variance. Le problème est que les variances sont estimées comme si les effets fixes étaient connus, alors qu’ils ont eux-mêmes été estimés sur les données. Elles sont donc sous-estimées, d’autant plus que l’échantillon est petit et que les effets fixes sont nombreux.
Le maximum de vraisemblance restreinte (REML) estime, lui, les variances à partir de combinaisons des données qui ne dépendent plus des effets fixes. Il tient ainsi compte des degrés de liberté utilisés pour estimer ces derniers et donne des composantes de variance moins biaisées.
Desmond Patterson et Robin Thompson ont présenté en 1971 une méthode fondée sur la vraisemblance de contrastes d’erreur pour estimer des composantes de variance (Patterson et Thompson 1971). Elle est à l’origine de la méthode REML utilisée ici.
Revenons à l’étude sur la privation de sommeil et comparons les deux méthodes pour le modèle à intercept et pente aléatoires :
lmer()) et par ML.
| Paramètre | REML | ML |
|---|---|---|
| \(\beta_0\) (intercept) | 251,41 | 251,41 |
| \(\beta_1\) (pente de Days) | 10,47 | 10,47 |
| Erreur standard de \(\hat\beta_1\) | 1,55 | 1,50 |
| \(\tau_0\) | 24,74 | 23,78 |
| \(\tau_1\) | 5,92 | 5,72 |
| \(\rho\) | 0,07 | 0,08 |
| \(\sigma\) | 25,59 | 25,59 |
Dans cet exemple, les écarts-types des effets aléatoires estimés par ML sont plus petits que ceux obtenus par REML ; c’est aussi le cas de l’erreur standard de la pente. Les effets fixes, eux, sont identiques : le plan est équilibré, c’est-à-dire que tous les sujets ont le même nombre de mesures aux mêmes jours. En général, les estimations des effets fixes diffèrent légèrement.
Comment choisir entre les deux méthodes en pratique ?
- Pour estimer et rapporter le modèle final, notamment ses effets fixes et ses composantes de variance, utilisez REML. C’est le choix par défaut de
lmer(). - Pour comparer des modèles qui diffèrent par leurs effets fixes, que ce soit par un test du rapport de vraisemblance, l’AIC ou le BIC, utilisez ML. Les vraisemblances restreintes ne sont alors pas comparables : elles ne portent pas sur les mêmes combinaisons des données. Avec deux modèles
lmer,anova()les réajuste automatiquement par ML et affiche le messagerefitting model(s) with ML. - Si les modèles ont les mêmes effets fixes et diffèrent seulement par leurs effets aléatoires, la comparaison par REML convient : on peut utiliser
anova(m1, m2, refit = FALSE).
Résumé dans un tableaux, on peut retenir les points suivants :
| ML | REML | |
|---|---|---|
| On maximise quoi ? | Vraisemblance complète des effets fixes et des variances | Vraisemblance de combinaisons des données libérées des effets fixes |
| Variance des effets aléatoires | Biaisées vers le bas en petit échantillon | Moins biaisées (sans biais dans certains plans équilibrés) |
| Effets fixes | Parfois identiques à REML, comme ici | Idem |
| Comparer des effets fixes (LRT, AIC, BIC) | oui | non |
| Comparer des effets aléatoires (= mêmes effets fixes) | Oui | Oui |
5.3 Influence d’un sujet
Quelque soit la modélisation statistique qu’on décide de faire, on aura forcément des sujets qui se démarquent des autres. Un moyen de vérifier si les résultats dépendent particulièrement d’un sujet consiste à comparer le modèle avec tous les sujets, et un autre modèle sans ce sujet particulier. On peut alors comparer comment les estimations changent, par exemple la pente. Faisons cela pour nos 18 sujets de l’étude sur la privation de sommeil :
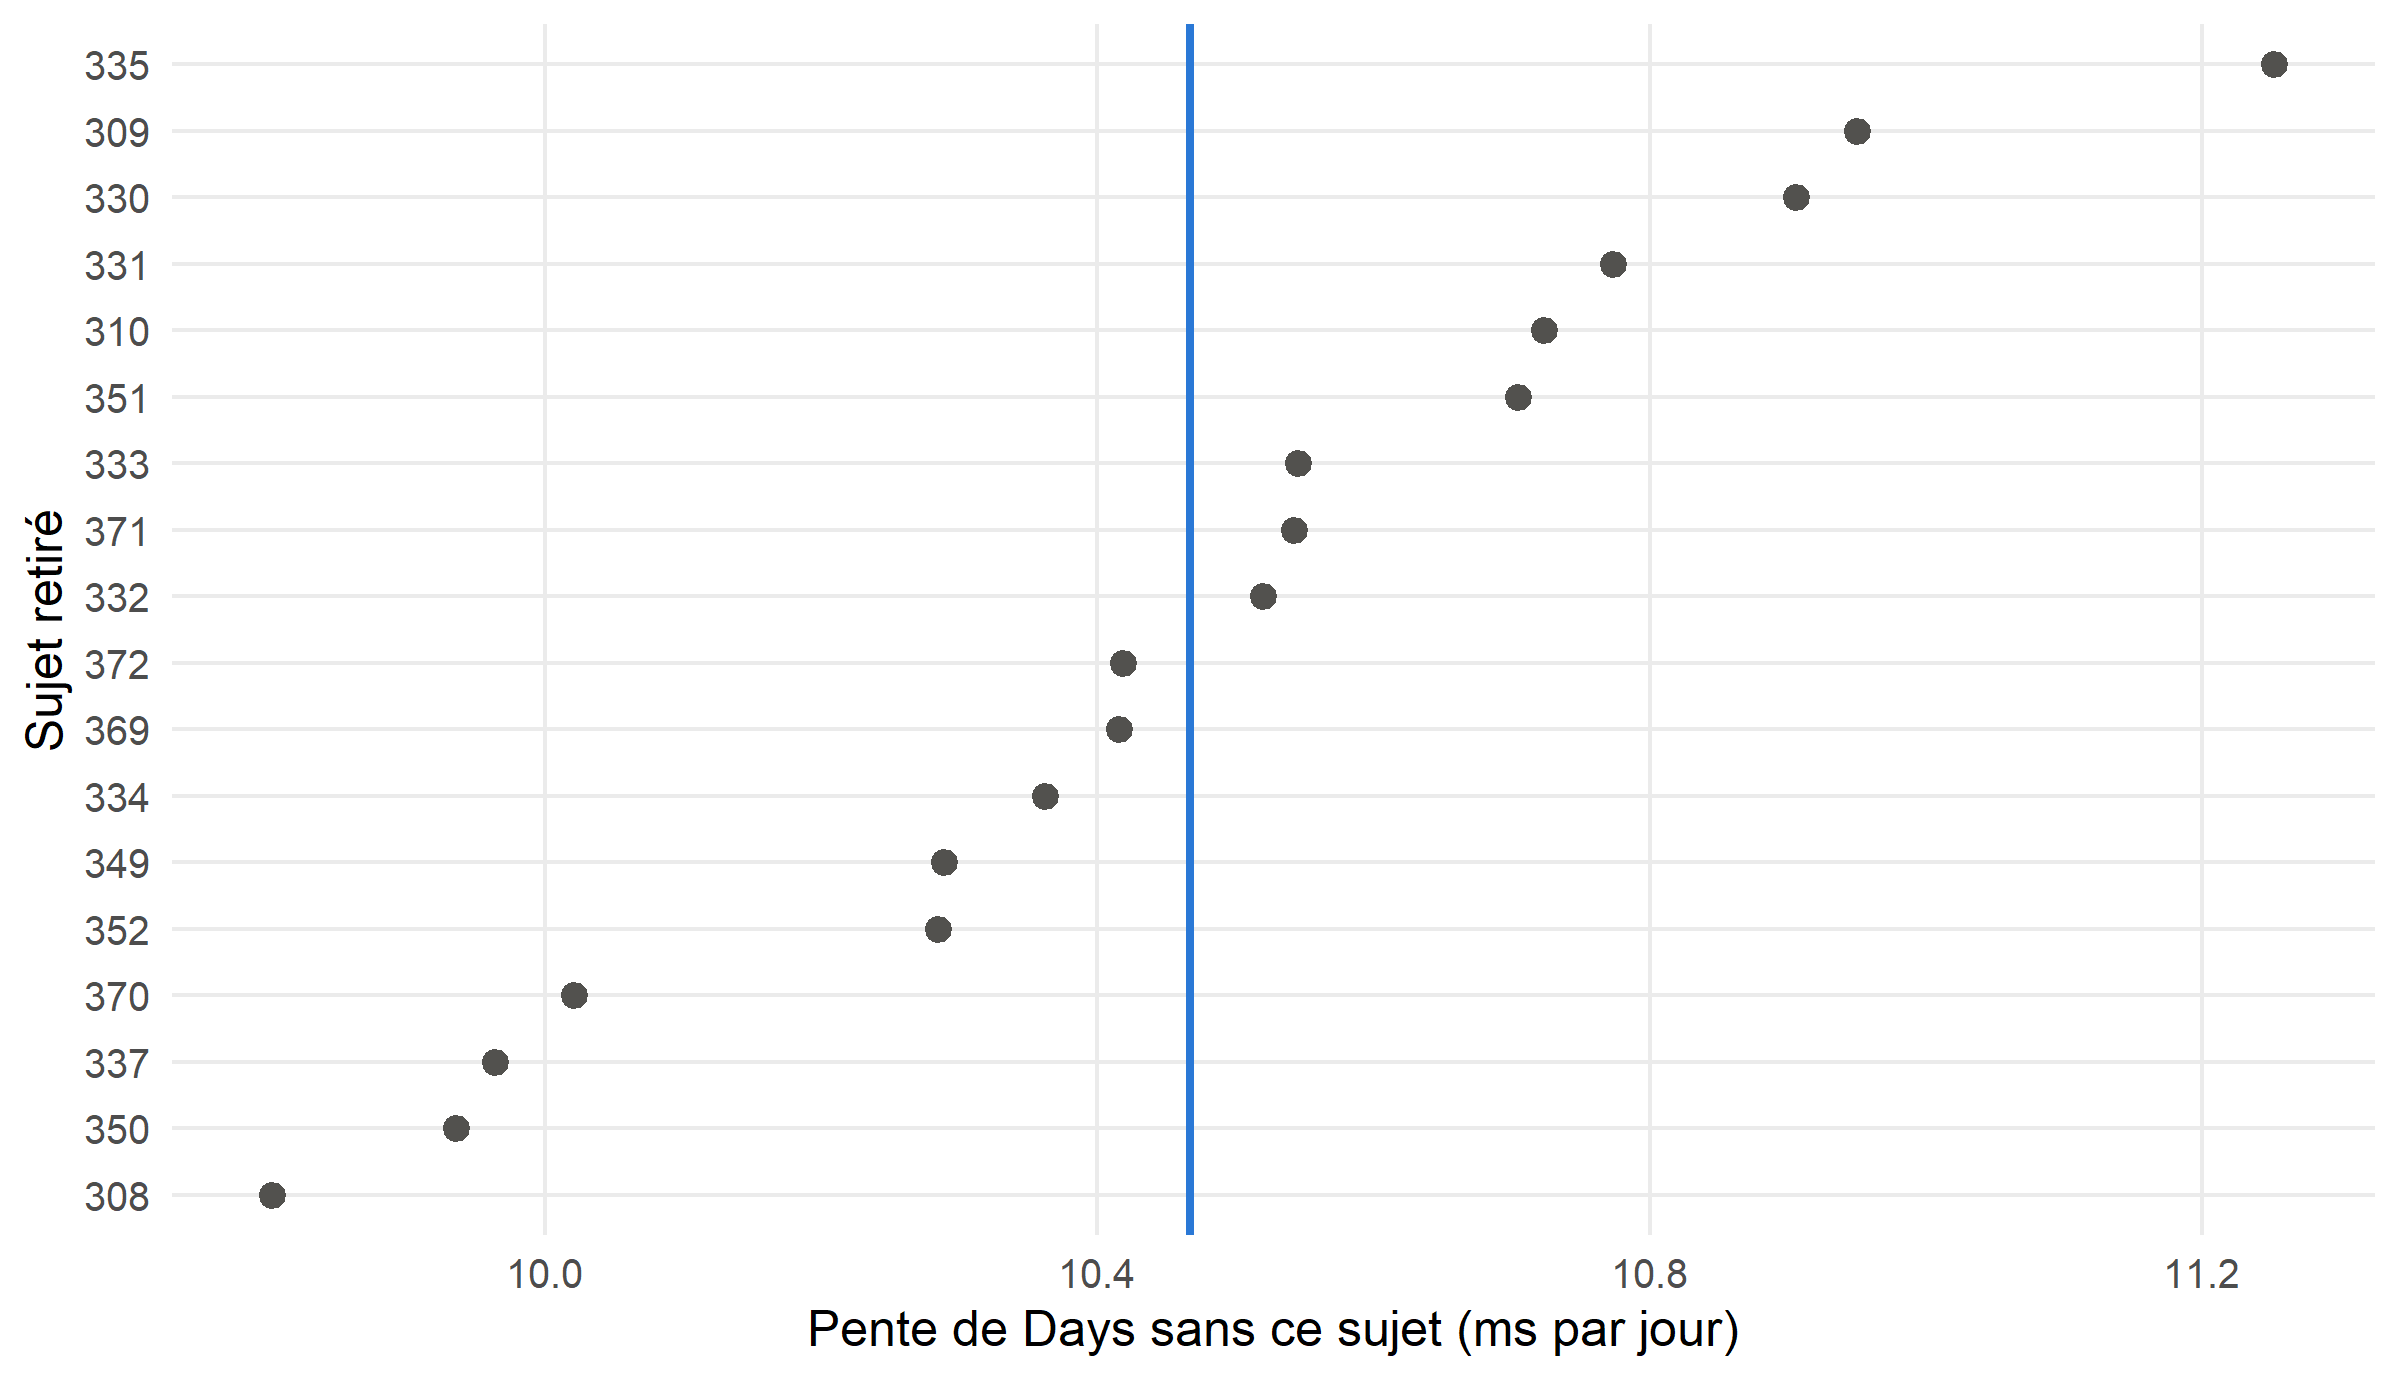
Days estimée en retirant chaque sujet à tour de rôle. La ligne verticale et la bande indiquent l’estimation sur les 18 sujets et son intervalle de confiance à 95 %.
Lorsque nous retirons un sujet, la pente varie entre 9,80 (sans le sujet 308) et 11,25 (sans le sujet 335). Ces valeurs restent dans l’intervalle de confiance obtenu avec les 18 sujets : l’estimation de la pente varie donc assez peu lorsque l’on retire un sujet. Pour vérifier si les conclusions des tests restent les mêmes, il faudrait aussi examiner les erreurs standards et les intervalles de confiance de chaque réajustement.
Pour automatiser ce type d’analyse, lme4 propose influence(m_randInterceptSlope, groups = "Subject"). On peut ensuite en tirer, par exemple, une distance de Cook par sujet avec cooks.distance().
Les références
Patterson, H. D., et Robin Thompson. 1971. « Recovery of Inter-Block Information when Block Sizes Are Unequal ». Biometrika 58 (3): 545‑54. https://doi.org/10.1093/biomet/58.3.545.