2 Intervalles de fluctuation et intervalles de confiance
Une loi statistique permet de comprendre ce qui peut varier d’un échantillon à l’autre. Cette variabilité est appelée fluctuation d’échantillonnage : même si la population ne change pas, les résultats observés dans deux échantillons ne sont pas identiques.
Ces fluctuations sont inévitables, dès lors qu’on mène une étude sur un échantillon. Le constat est alors le suivant : quitte à avoir de l’incertitude, ne pourrait-on pas la quantifier ? La solution consiste à construire des intervalles, c’est-à-dire des ensembles de valeurs plausibles pour la quantité étudiée.
Supposons que l’on s’intéresse à la proportion de personnes ayant un animal de compagnie à la maison en France. On interroge 200 personnes et 40 % répondent “oui”. On a alors deux grandes situations :
- Supposons que l’on sache, grâce à une source de référence, que 60 % des personnes ont un animal de compagnie. On peut alors se demander : les 40 % observés sont-ils compatibles avec cette proportion de référence ? Pour répondre à cette question, on peut construire un intervalle de fluctuation sous l’hypothèse \(\pi=60\,\%\).
- On ne connaît pas la proportion dans la population. On peut alors se demander : compte tenu des 40 % observés auprès de 200 personnes, quelles valeurs de la proportion vraie sont compatibles avec nos données ? Pour répondre à cette question, on peut construire un intervalle de confiance.
Cette distinction est importante, car les intervalles de fluctuation et les intervalles de confiance utilisent des formules proches et cela peut prêter à confusion. La différence tient à la question posée : l’intervalle de fluctuation est construit à partir d’une valeur supposée vraie (p. ex., 60 %) ; l’intervalle de confiance est construit à partir de notre estimation (p. ex., 40 %).
2.1 Intervalle de fluctuation (ou de pari)
2.1.1 Fréquence / proportion
Pour une proportion, l’intervalle de fluctuation (ou de pari) décrit les valeurs plausibles de la fréquence observée \(\hat p\) lorsque la proportion \(\pi\) de population est supposée connue.
Pour une proportion, une approximation à 95 % est : \[ \pi \pm 1,96\sqrt{\frac{\pi(1-\pi)}{n}} = \left[\pi - 1,96\sqrt{\frac{\pi(1-\pi)}{n}}, \pi + 1,96\sqrt{\frac{\pi(1-\pi)}{n}}\right] \]
Cet intervalle est centré sur le paramètre supposé \(\pi\). Le terme \(\sqrt{\pi(1-\pi)/n}\) mesure la variabilité attendue de la fréquence observée : plus \(n\) est grand, plus cette variabilité diminue.
Cette approximation normale est raisonnable lorsque \(n \ge 30\), \(n\pi \ge 5\) et \(n(1-\pi) \ge 5\). Sinon, on préfère calculer un intervalle binomial exact, qu’on ne détaillera pas ici.
Pour l’exemple précédent : \[ 0,25 \pm 1,96\sqrt{\frac{0,25(1-0,25)}{100}} =0,25 \pm 0,085 =[0,165 \, ; \, 0,335]. \] Si la vraie proportion de fumeurs était 25 %, on s’attendrait donc à observer le plus souvent une proportion comprise entre 16,5 % et 33,5 % dans des échantillons de 100 personnes.
2.1.2 Moyenne
Pour une variable quantitative de moyenne supposée connue \(\mu\) et d’écart-type supposé connu \(\sigma\), la moyenne observée \(\bar X\) fluctue d’un échantillon à l’autre.
Si l’échantillon est de taille \(n\) et si l’approximation normale est raisonnable, un intervalle de fluctuation à 95 % pour la moyenne observée est : \[ \mu \pm 1,96\frac{\sigma}{\sqrt n} = \left[\mu - 1,96\frac{\sigma}{\sqrt n}, \mu + 1,96\frac{\sigma}{\sqrt n}\right] \]
L’intervalle est centré sur la moyenne supposée \(\mu\). Le terme \(\sigma/\sqrt n\) est l’erreur standard de la moyenne : il diminue quand la taille d’échantillon augmente.
L’erreur standard (ou “standard error” en anglais) ne correspond pas à l’écart-type ! On en discute en section 3.2.
2.2 Intervalle de confiance
La construction des intervalles de confiance a été formalisée par Jerzy Neyman, notamment dans son article de référence de 1937 (Neyman 1937). L’idée est de contrôler la fréquence avec laquelle notre méthode couvre la vraie valeur lorsque l’on répète l’échantillonnage ; nous retrouverons cette interprétation un peu plus loin.
2.2.1 Fréquence / proportion
Pour une proportion, on observe une fréquence \(\hat p\) dans un échantillon de taille \(n\). On cherche ensuite les valeurs plausibles de la proportion vraie \(\pi\).
Pour une proportion observée \(\hat p\), une approximation à 95 % est : \[ \hat p \pm 1,96\sqrt{\frac{\hat p(1-\hat p)}{n}} = \left[\hat p - 1,96\sqrt{\frac{\hat p(1-\hat p)}{n}}, \hat p + 1,96\sqrt{\frac{\hat p(1-\hat p)}{n}}\right] \]
Cet intervalle est centré sur l’estimation observée \(\hat p\). Le terme \(\sqrt{\hat p(1-\hat p)/n}\) est l’erreur standard estimée de la proportion.
Note
- Cette formule est l’intervalle de Wald. C’est une approximation, qui fonctionne surtout quand \(n \ge 30\), \(n\hat p \ge 5\) et \(n(1-\hat p) \ge 5\). Pour de petits effectifs ou des proportions proches de 0 ou 1, l’intervalle risque de contenir des valeurs négatives ou supérieures à 1, ce qui n’a pas de sens… Il existe d’autres méthodes (p. ex., l’intervalle de Wilson), mais on n’en parle pas ici.
- Dans l’exemple précédent, \(n = 200 > 30\), \(n\hat p = 200 \times 0,27 = 54 \ge 5\) et \(n(1-\hat p) = 200 \times 0,73 = 146 \ge 5\), donc l’approximation est raisonnable !
2.2.2 Moyenne
Dans la plupart des études, la moyenne vraie \(\mu\) et l’écart-type de la population \(\sigma\) sont inconnus. On observe une moyenne \(\bar x\) et un écart-type empirique \(s\).
Un intervalle de confiance à 95 % pour une moyenne est alors : \[ \bar x \pm t_{0,975\, ; \,n-1}\frac{s}{\sqrt n} = \left[\bar x - t_{0,975\, ; \,n-1}\frac{s}{\sqrt n}, \bar x + t_{0,975\, ; \,n-1}\frac{s}{\sqrt n}\right], \] où \(t_{0,975\, ; \,n-1}\) est le quantile de la loi de Student à \(n-1\) degrés de liberté. Ici :
- \(\bar x\) est la moyenne observée dans l’échantillon ;
- \(s\) est l’écart-type empirique observé dans l’échantillon ;
- \(s/\sqrt n\) est l’erreur standard de la moyenne.
Pour les grands échantillons, \(t_{0,975\, ; \,n-1}\) est proche de 1,96, ce qui donne l’approximation : \[ \bar x \pm 1,96\frac{s}{\sqrt n} \]
2.2.3 Ce que n’est pas un intervalle de confiance
Avertissement
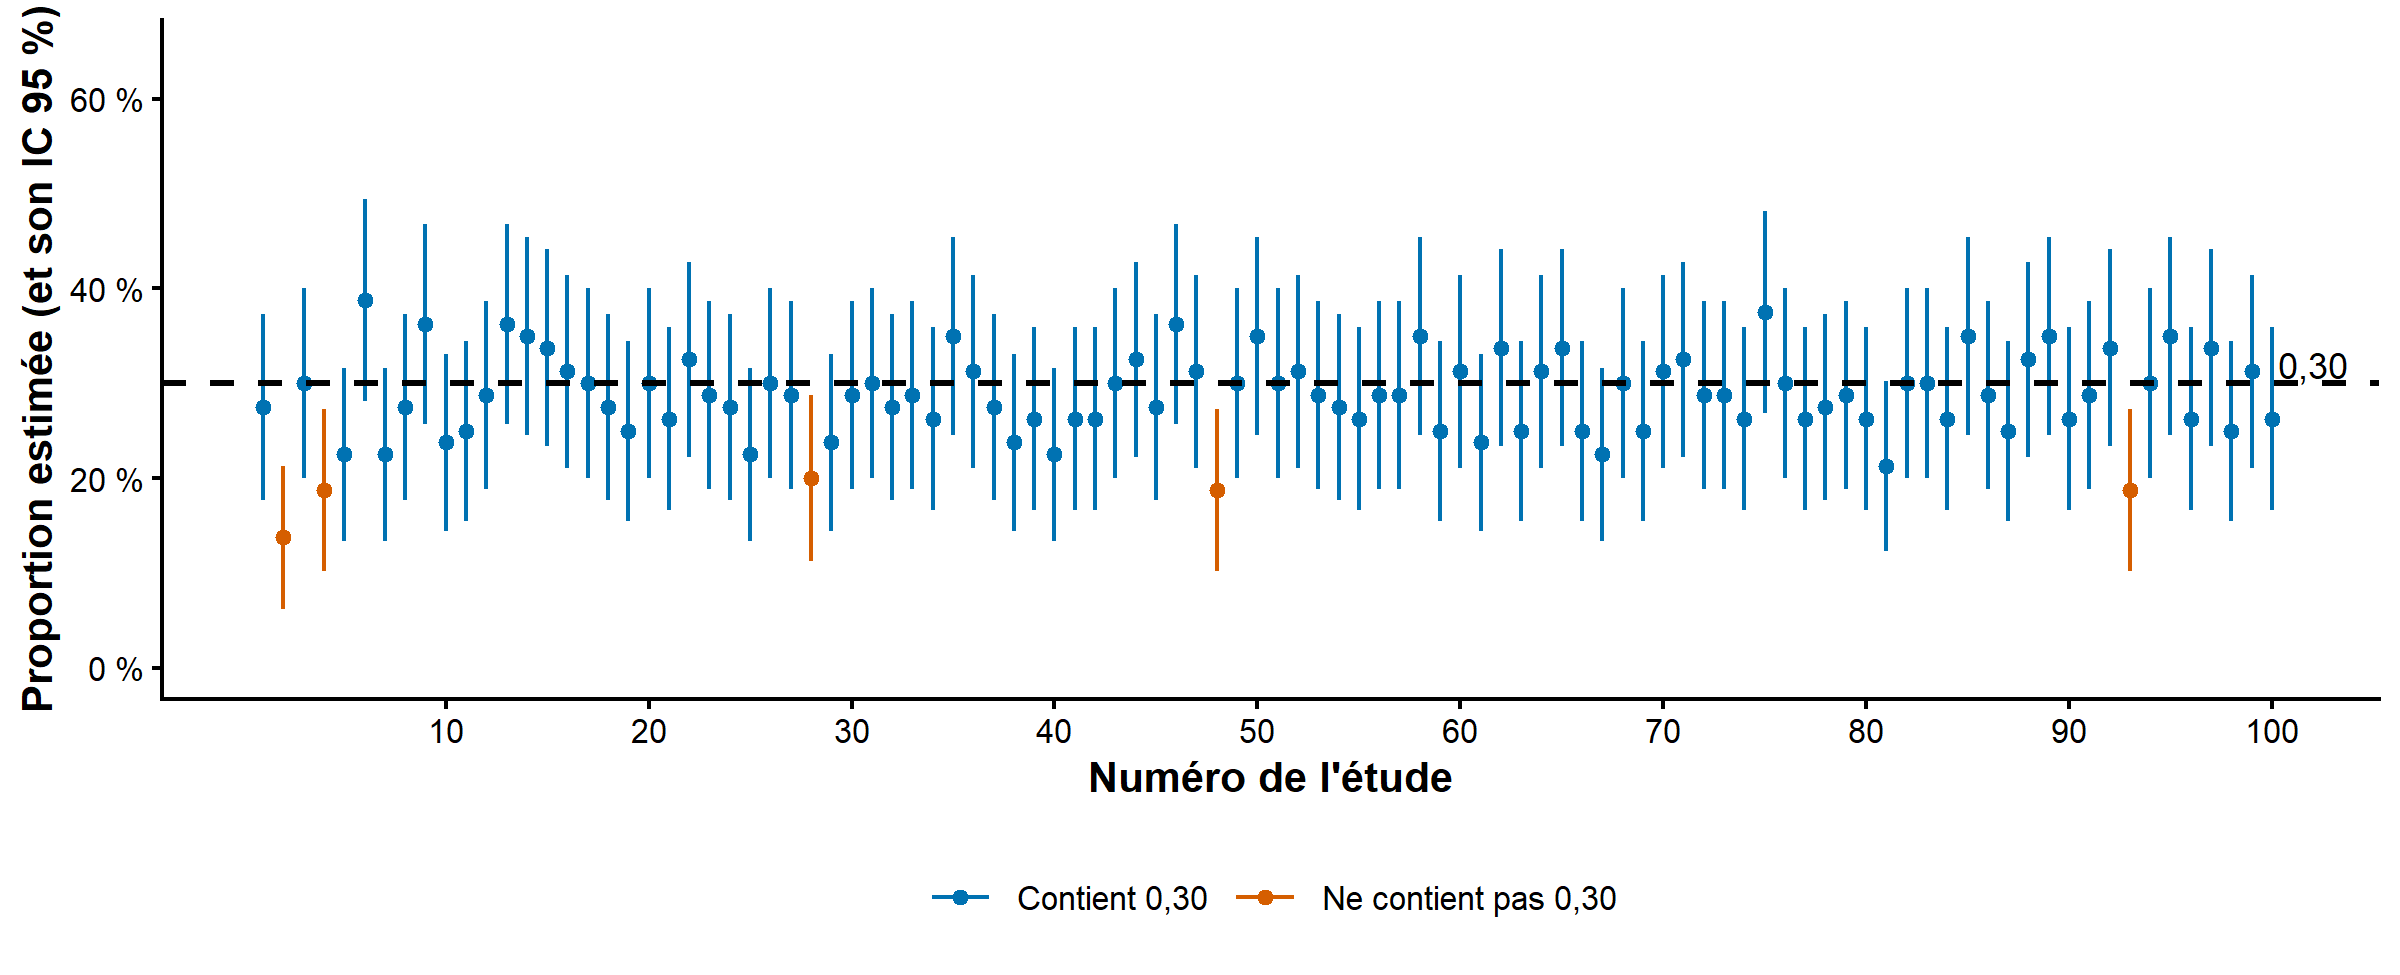
Un intervalle de confiance à 95 % ne signifie pas qu’il y a 95 % de probabilité que le paramètre soit dans l’intervalle calculé. Le “95 %” signifie que, si l’on répétait un très grand nombre d’études comparables, environ 95 % des intervalles construits par cette méthode contiendraient le paramètre inconnu.
Les références
Neyman, Jerzy. 1937. « Outline of a Theory of Statistical Estimation Based on the Classical Theory of Probability ». Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences 236 (767): 333‑80. https://doi.org/10.1098/rsta.1937.0005.