3 Pour aller plus loin
3.1 Table de loi et quantiles
Savoir lire une table de loi relève plus de la curiosité qu’autre chose : dans la pratique, on utilise un logiciel (p. ex., R) pour faire cela. Mais comprendre le principe peut aider à mieux voir ce que représente une probabilité ou un quantile.
Le principe est globalement le même pour toutes les tables de lois.
Une table de loi répond toujours à la même question : “quelle proportion de la courbe se trouve avant telle valeur ?”. Dans la version la plus fréquente, chaque case du tableau donne cette proportion, notée \(\Phi(z)\) : \[ \Phi(z)=P(Z\le z), \] c’est-à-dire l’aire située à gauche de la valeur \(z\) sous la courbe en cloche.
Pour illustrer, nous prendrons la table de l’écart réduit, construite à partir de la loi normale centrée réduite \(Z\sim\mathcal N(0,1)\) et dont un extrait est présenté dans le Tableau 1.
| z | 0,00 | 0,01 | 0,02 | 0,03 | 0,04 | 0,05 | 0,06 | 0,07 | 0,08 | 0,09 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1,5 | 0,9332 | 0,9345 | 0,9357 | 0,9370 | 0,9382 | 0,9394 | 0,9406 | 0,9418 | 0,9429 | 0,9441 |
| 1,6 | 0,9452 | 0,9463 | 0,9474 | 0,9484 | 0,9495 | 0,9505 | 0,9515 | 0,9525 | 0,9535 | 0,9545 |
| 1,7 | 0,9554 | 0,9564 | 0,9573 | 0,9582 | 0,9591 | 0,9599 | 0,9608 | 0,9616 | 0,9625 | 0,9633 |
| 1,8 | 0,9641 | 0,9649 | 0,9656 | 0,9664 | 0,9671 | 0,9678 | 0,9686 | 0,9693 | 0,9699 | 0,9706 |
| 1,9 | 0,9713 | 0,9719 | 0,9726 | 0,9732 | 0,9738 | 0,9744 | 0,9750 | 0,9756 | 0,9761 | 0,9767 |
| 2,0 | 0,9772 | 0,9778 | 0,9783 | 0,9788 | 0,9793 | 0,9798 | 0,9803 | 0,9808 | 0,9812 | 0,9817 |
Avec des intervalles de confiance, ou encore dans les tests statistiques, deux valeurs reviennent presque tout le temps : 1,96 et 5 %. Essayons alors de comprendre d’où elles sortent !
3.1.1 Trouver un quantile à partir d’un risque \(\alpha\)
On se demande quelle valeur \(z\) (= quantile) permet de placer 5 % de l’aire sous la courbe dans une région extrême. Ce “5 %” est communément appelé le risque \(\alpha\), et \(z\) est la valeur critique.
Dans notre exemple, il s’agit de la queue droite de la loi normale centrée réduite. On cherche donc \(z\) tel que : \[ \mathbb{P}(Z>z)=\alpha=0{,}05 \]
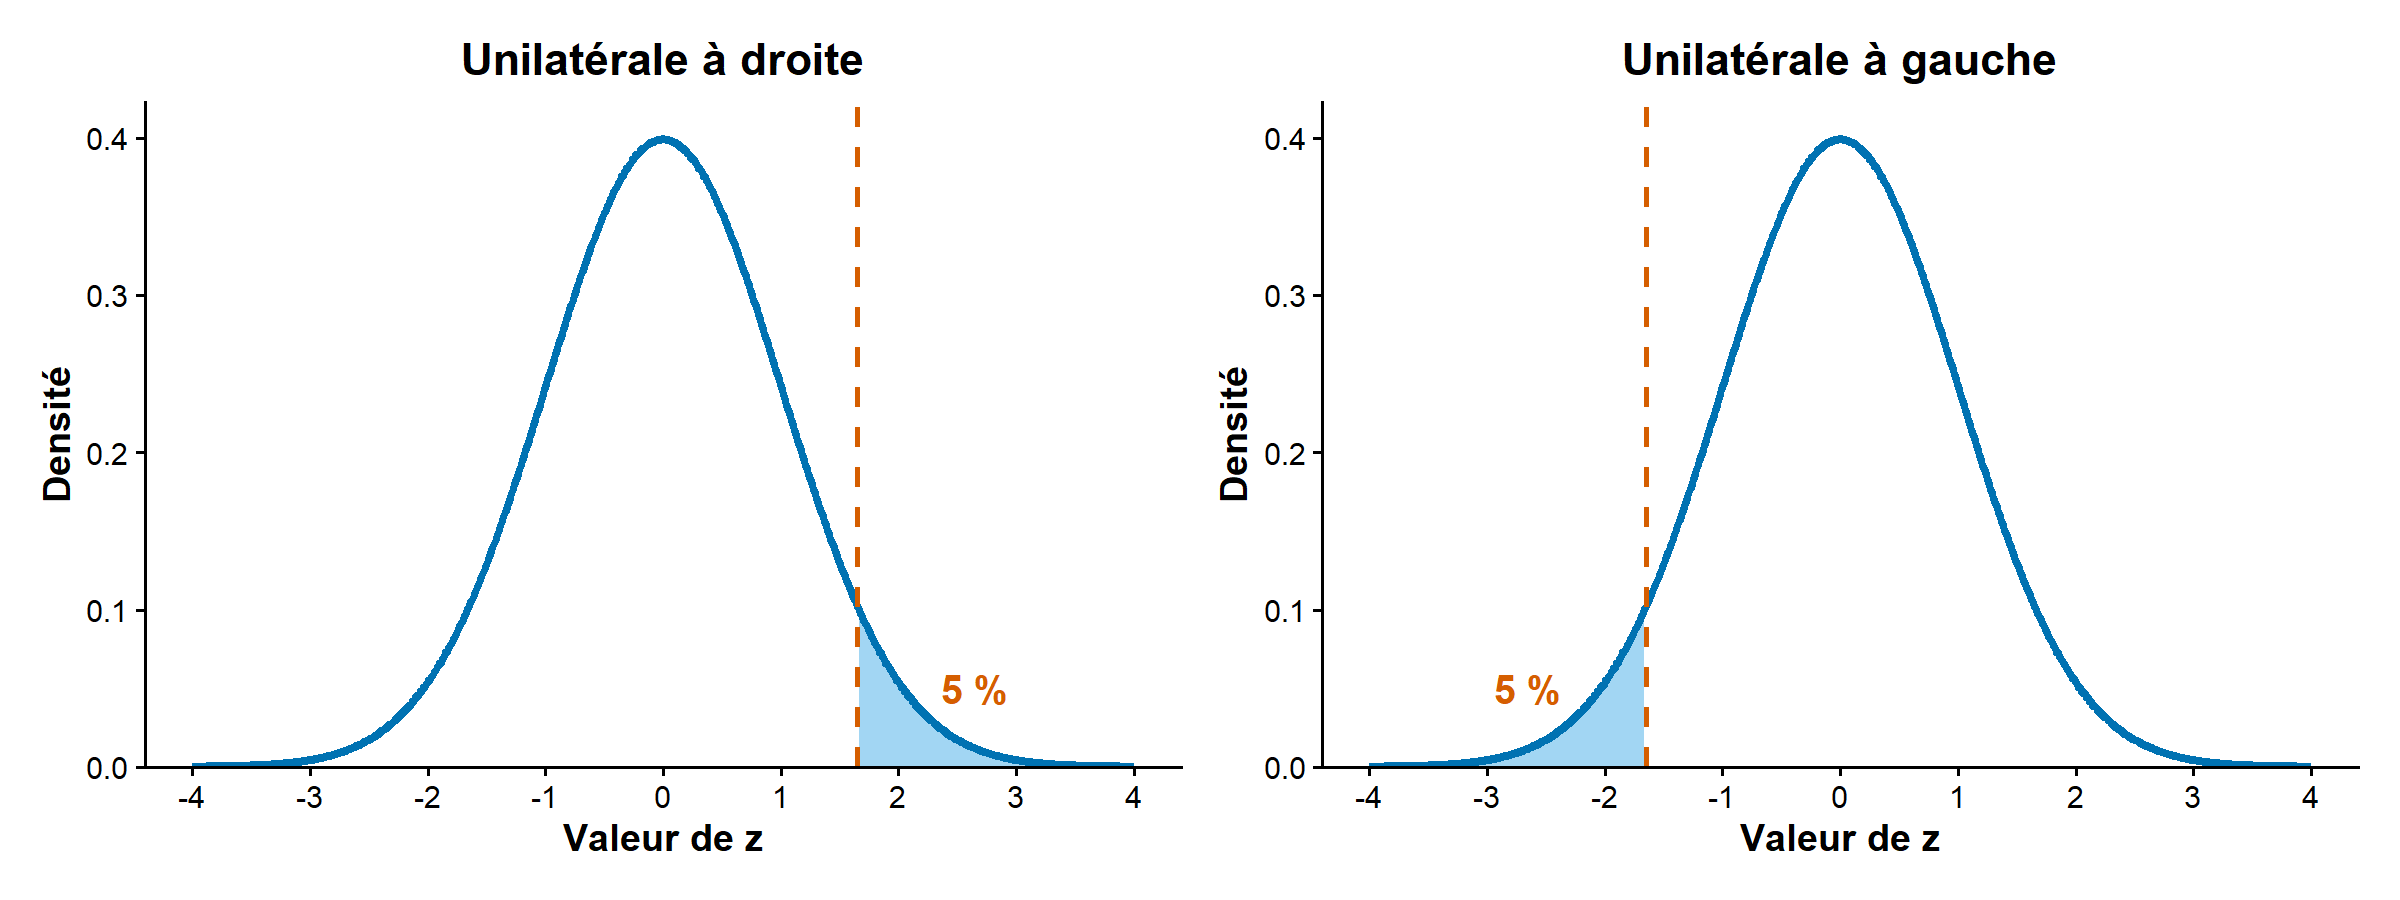
Cas unilatéral. Avec une hypothèse alternative unilatérale, tout le risque \(\alpha\) est placé d’un seul côté de la distribution : à droite si l’on cherche une valeur anormalement grande, à gauche si l’on cherche une valeur anormalement petite (voir Figure 1).
Pour une alternative à droite, on laisse 5 % de l’aire dans la queue droite, donc 95 % à gauche : \[ P(Z\le z)=1-\alpha=0{,}95 \] On cherche alors, dans le Tableau 1, quelle combinaison de ligne et colonne donne la valeur la plus proche de \(0{,}95\). On voit qu’à la ligne \(1{,}6\) et colonne \(0{,}05\), on obtient \(0{,}9505\), ce qui est très proche de \(0{,}95\). La valeur critique est donc : \(z\approx 1{,}65\).
Pour une alternative à gauche, on place les 5 % dans la queue gauche. Comme la loi normale est symétrique, la valeur critique correspondante est donc la même qu’avant, mais à gauche ; soit \(z\approx -1{,}65\).
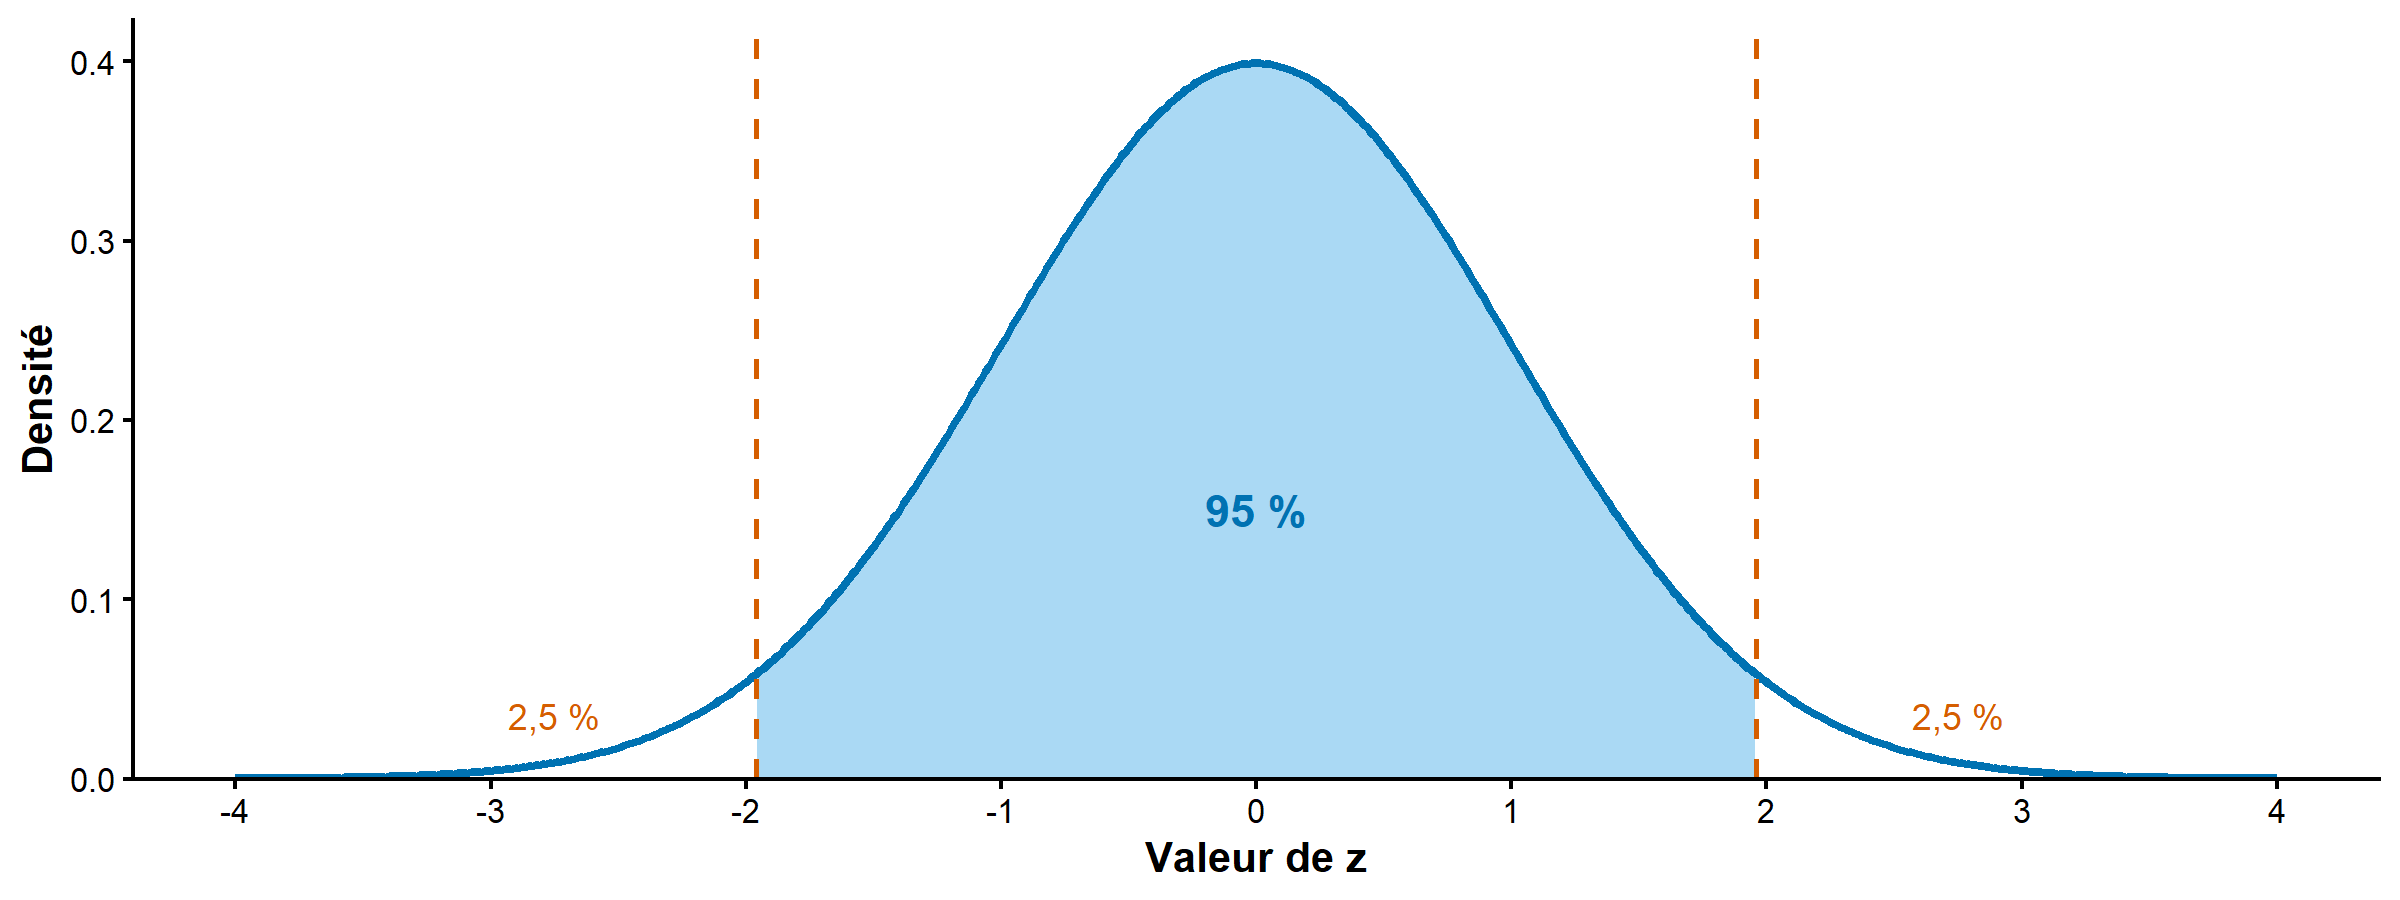
Cas bilatéral. Ici, on répartit le risque \(\alpha = 5 \%\) entre les deux extrémités de la distribution : \(\alpha/2 = 2{,}5 \%\) à gauche et \(\alpha/2 = 2{,}5 \%\) à droite (voir Figure 2). Formellement, cela s’écrit : \[ \mathbb{P}(-z\le Z\le z)=1-\alpha=0{,}95 \]
Or, la table ne nous fournit que la probabilité d’avoir une valeur inférieure ou égale à \(z\). Sans rentrer (encore plus) dans les détails, la symétrie de la loi normale nous permet d’écrire que : \[ \mathbb{P}(-z\le Z\le z) = \mathbb{P}(Z\le z) - \mathbb{P}(Z\le -z) = \mathbb{P}(Z\le z) - (1-\mathbb{P}(Z\le z)) = 2\mathbb{P}(Z\le z)-1 \] Ainsi, il “suffit” de chercher la valeur de \(z\), telle que : \[ \mathbb{P}(-z\le Z\le z) = 2\mathbb{P}(Z\le z)-1 = 1-\alpha = 0{,}95 \iff \mathbb{P}(Z\le z) = \frac{1-\alpha+1}{2} = 0{,}975 \] À la ligne \(1{,}9\) et la colonne \(0{,}06\) de la table, on obtient que \(\mathbb{P}(Z\le z) = 0{,}975\) et donc \(z\approx 1{,}96\).
3.1.2 Trouver une probabilité à partir d’un quantile
On fait le cheminement contraire à ce qui vient d’être exposé : on connaît la valeur de \(z\) et on cherche à savoir quelle proportion de l’aire sous la courbe se trouve à gauche ou à droite de cette valeur. Pour la suite, prenons le quantile \(z=1{,}96\) et cherchons la probabilité correspondante.
Pour calculer \(\mathbb{P}(Z\le1{,}96)\), on regarde la valeur à l’intersection entre la ligne \(1{,}9\) et la colonne \(0{,}06\) de la table. On obtient alors “\(0{,}9750\)”.
Pour calculer \(\mathbb{P}(Z>1{,}96)\), on va (encore) ruser. Toute l’aire sous la courbe vaut 100 %. Donc, si l’aire située à gauche de 1,96 représente 97,5 %, l’aire située à droite représente forcément ce qu’il manque pour arriver à 100 % ! Ainsi, \(\mathbb{P}(Z>1{,}96)=1-\mathbb{P}(Z\le1{,}96)=1-0{,}9750=0{,}0250\), ce qui est cohérent avec la Figure 2 !
Retenez surtout l’idée, plus que la formule : notre table donne une aire “à gauche”. Pour avoir l’aire “à droite”, il suffit de faire \(1\) moins la proportion lue (ou \(100\,\%\) moins le pourcentage correspondant).
3.2 Écart-type vs. erreur standard
L’écart-type (ou standard deviation en anglais) mesure la dispersion des valeurs individuelles autour de leur moyenne. Dans la population, il est noté \(\sigma\) ; on l’estime à partir d’un échantillon par l’écart-type \(s\).
Quant à elle, l’erreur standard (ou standard error, notée \(\mathrm{SE}\)) est l’écart-type de la distribution d’échantillonnage d’une statistique. Pour la moyenne, elle décrit à quel point la moyenne calculée varierait si l’on répétait le tirage d’échantillons de même taille dans la même population.
Ainsi, l’écart-type décrit la variabilité entre les individus, tandis que l’erreur standard de la moyenne décrit la variabilité entre les moyennes d’échantillons. Cette dernière renseigne sur la précision avec laquelle on estime la moyenne de la population.
3.2.1 Pourquoi l’erreur standard de la moyenne vaut-elle \(\sqrt{\sigma^2/n}\) ?
Considérons \(n\) variables aléatoires \(X_1,\dots,X_n\) indépendantes et de même loi, de moyenne \(\mu\) et de variance finie \(\sigma^2\). La moyenne de l’échantillon est : \[ \bar X=\frac{1}{n}\sum_{i=1}^n X_i \] Son espérance vaut \(\mathbb{E}(\bar X)=\mu\) : les moyennes d’échantillons sont donc centrées sur la moyenne de la population. Pour connaître leur dispersion, calculons la variance de \(\bar X\) à l’aide de deux propriétés :
- multiplier une variable par une constante \(a\) multiplie sa variance par \(a^2\) ;
- la variance d’une somme de variables indépendantes est la somme de leurs variances.
On obtient alors : \[ \begin{aligned} \operatorname{Var}(\bar X) =\operatorname{Var}\left(\frac{1}{n}\sum_{i=1}^n X_i\right) =\frac{1}{n^2}\operatorname{Var}\left(\sum_{i=1}^n X_i\right) =\frac{1}{n^2}\sum_{i=1}^n\operatorname{Var}(X_i) =\frac{1}{n^2}\times n\sigma^2 =\frac{\sigma^2}{n} \end{aligned} \] L’erreur standard étant un écart-type, on prend la racine carrée de cette variance : \[ \mathrm{SE}(\bar X)=\sqrt{\operatorname{Var}(\bar X)}=\sqrt{\frac{\sigma^2}{n}}=\frac{\sigma}{\sqrt n} \] La division par \(n\) provient donc du calcul de la variance de la moyenne ; la racine carrée permet ensuite de revenir à un écart-type, exprimé dans la même unité que les observations.