2 Comparaisons de moyennes
On compare des moyennes lorsque la variable réponse est quantitative. On peut comparer cette variable à une valeur de référence (Student à un échantillon, Student apparié) ou selon plusieurs groupes (Student, Welch, ANOVA).
2.1 Test de Student à un échantillon
Le test de Student à un échantillon compare la moyenne d’une variable quantitative dans une population à une valeur de référence connue ou fixée à l’avance. Pour l’utiliser, il faut que les observations soient indépendantes et que la variable soit approximativement normale (OU que l’échantillon soit suffisamment grand).
William Sealy Gosset publie en 1908, sous le pseudonyme “Student”, une étude de la distribution à l’origine de ce test (Student 1908).
La règle “\(n\ge30\)” est seulement un repère. La taille nécessaire dépend de l’asymétrie de la distribution et de la présence de valeurs extrêmes : un grand échantillon ne dispense jamais de regarder les données.
On note :
- \(n\) la taille de l’échantillon ;
- \(\bar X\) la moyenne observée ;
- \(S^2\) la variance empirique corrigée ;
- \(\mu\) la moyenne théorique inconnue ;
- \(\mu_0\) la valeur de référence.
En statistiques, les lettres grecques (p. ex., \(\mu\), \(\sigma\)) sont souvent utilisées pour les paramètres théoriques, et les lettres latines pour les quantités observées dans l’échantillon.
Pour un test bilatéral, les hypothèses sont : \[ H_0:\mu=\mu_0 \;\text{contre}\; H_1:\mu\neq\mu_0 \]
La statistique de test est : \[ T=\frac{\bar X-\mu_0}{S/\sqrt n} \underset{H_0}{\sim} \text{Student}_{n-1} \] Autrement dit, si les observations sont indépendantes et viennent d’une population normale (au sens statistique du terme), alors cette statistique suit une loi de Student à \(n-1\) degrés de liberté sous \(H_0\).
Au seuil \(\alpha\), pour un test bilatéral, la région critique est : \[ |T|>t_{1-\alpha/2,n-1} \] ou, écrit différemment : \[ T < -t_{1-\alpha/2,n-1} \quad\text{ou}\quad T > t_{1-\alpha/2,n-1} \] Pour un test unilatéral à droite, elle devient \(T>t_{1-\alpha,n-1}\) ; pour un test unilatéral à gauche, elle devient \(T<t_{\alpha,n-1}\).
Si le test est significatif, on peut mentionner le sens de la différence observée.
Note
- Une différence statistiquement significative ne dit pas encore si l’écart est important en pratique (on parle de “significativité statistique” vs. “importance clinique”). Ici, on observe une différence de 2,75 cm. Est-ce important ? Minime ? Il faut trancher suivant le contexte !
- La valeur “1,97” ne sort pas de nulle part : c’est le quantile de la loi de Student à 151 degrés de liberté qui correspond à un seuil de 5 % pour un test bilatéral. Pour l’obtenir, il faut soit un logiciel (p. ex., R), soit savoir lire une table. On explique brièvement dans la section “Table de loi et quantiles” du chapitre Lois statistiques et intervalles comment en lire une.
2.2 Comparaison de deux groupes indépendants
On est vite amené à vouloir évaluer l’efficacité d’un médicament ou d’une intervention en santé. Pour cela, le plus fréquent est de constituer deux groupes : l’un reçoit le médicament ou subit l’intervention, et l’autre reçoit le médicament de référence (ou un placebo) ou ne subit aucune intervention.
Nous présentons ici deux tests courants pour comparer deux moyennes : le test de Student (si les variances entre les deux populations sont égales) et le test de Welch (si les variances sont différentes).
Bien que nous présentions ces trois tests, nous ne sommes pas fans de la démarche “test de Student si variances égales, test de Welch si variances différentes”. En effet, comparer deux moyennes nous demande alors de 1/ faire deux tests et 2/ avoir des hypothèses fortes (notamment l’hypothèse de normalité pour le test F). En pratique, le test de Welch est souvent un bon choix par défaut pour deux groupes indépendants.
On note :
- \(n_1\) et \(n_2\) les tailles des deux échantillons ;
- \(\bar X_1\) et \(\bar X_2\) les moyennes observées ;
- \(S_1^2\) et \(S_2^2\) les variances empiriques corrigées ;
- \(\mu_1\) et \(\mu_2\) les moyennes théoriques.
2.2.1 Test F de comparaison des variances
Le test F de comparaison des variances évalue si deux populations peuvent être considérées comme ayant la même variance. Pour l’appliquer, il faut que les observations soient indépendantes et que les deux variables soient approximativement normales.
En 1934, George Snedecor a présenté et tabulé le rapport F, nommé ainsi en hommage à Ronald Fisher (Snedecor 1934).
Les hypothèses sont : \[ H_0:\sigma_1^2=\sigma_2^2 \;\text{contre}\; H_1:\sigma_1^2\neq\sigma_2^2 \]
Note
On parle d’homoscédasticité lorsque les variances des deux populations sont égales, et d’hétéroscédasticité lorsqu’elles ne le sont pas.
Ici, l’hypothèse nulle correspond à l’homoscédasticité, et l’hypothèse alternative à l’hétéroscédasticité. Si on rejette \(H_0\), les données ne sont pas compatibles avec l’hypothèse d’égalité des variances.
Sans perte de généralité, on note \(S_1^2\) la plus grande variance empirique et \(S_2^2\) la plus petite. On a alors : \[ F=\frac{S_1^2}{S_2^2} \] telle que \(F\ge 1\). Sous \(H_0\), si les deux échantillons sont indépendants et issus de populations normales, \[ F\sim F_{n_1-1,n_2-1} \] Au seuil \(\alpha\), avec la plus grande variance au numérateur, on rejette \(H_0\) si : \[ F>F_{1-\alpha/2,n_1-1,n_2-1} \]
Note
Le test F de comparaison des variances est sensible à l’hypothèse de normalité. En cas de doute, le test de Levene est une alternative plus robuste pour tester l’égalité des variances entre groupes.
Howard Levene a présenté ce test en 1960 (Levene 1960).
2.2.2 Test de Student
Le test de Student à deux échantillons compare la moyenne d’une variable quantitative entre deux groupes indépendants, lorsque les variances des deux populations peuvent être considérées comme comparables. Pour l’appliquer, il faut que les observations soient indépendantes, que la variable soit approximativement normale dans chaque groupe (OU que les tailles d’échantillon soient suffisamment grandes), et qu’on ait homoscédasticité (i.e., variances comparables ; voir test précédent).
Pour un test bilatéral, les hypothèses usuelles sont : \[ H_0:\mu_1=\mu_2 \;\text{contre}\; H_1:\mu_1\neq\mu_2 \]
Si les variances théoriques sont supposées égales, on utilise une variance commune : \[ S_p^2=\frac{(n_1-1)S_1^2+(n_2-1)S_2^2}{n_1+n_2-2} \]
Cette variance commune est une estimation de la dispersion dans les deux populations, sous l’hypothèse qu’elles ont la même variance. Si cette hypothèse est peu crédible, le dénominateur de la statistique de Student devient mal calibré, surtout lorsque les tailles de groupes sont différentes.
La statistique de test est : \[ T=\frac{\bar X_1-\bar X_2}{S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}} \underset{H_0}{\sim} \text{Student}_{n_1+n_2-2} \]
Sous \(H_0\), elle suit une loi de Student à \(n_1+n_2-2\) degrés de liberté.
Au seuil \(\alpha\), pour un test bilatéral, la région critique est : \[ |T|>t_{1-\alpha/2,n_1+n_2-2} \]
2.2.3 Test de Welch
Le test de Welch répond à la même question générale que le test de Student : comparer deux moyennes entre deux groupes indépendants. Les conditions d’application sont les mêmes (indépendance, normalité/\(n>30\)), mais il ne suppose pas l’égalité des variances.
Bernard Welch étudie ce problème dès 1938 (Welch 1938), puis généralise l’approche en 1947 (Welch 1947). L’approximation des degrés de liberté porte aussi le nom de Franklin Satterthwaite, qui étudie la distribution de composantes de variance en 1946 (Satterthwaite 1946).
La statistique de test est : \[ T=\frac{\bar X_1-\bar X_2}{\sqrt{\frac{S_1^2}{n_1}+\frac{S_2^2}{n_2}}} {\overset{\mathrm{approx.}}{\sim}} \text{Student}_{\nu} \] où \(\nu\) est le nombre de degrés de liberté (généralement non entier). Ce dernier est approché par la formule de Welch-Satterthwaite : \[ \nu= \frac{ \left(\frac{S_1^2}{n_1}+\frac{S_2^2}{n_2}\right)^2 }{ \frac{(S_1^2/n_1)^2}{n_1-1}+ \frac{(S_2^2/n_2)^2}{n_2-1} } \]
Au seuil \(\alpha\), pour un test bilatéral, la région critique est : \[ |T|>t_{1-\alpha/2,\nu} \]
2.3 ANOVA pour trois moyennes ou plus
Lorsque l’on compare trois moyennes ou plus, répéter des tests deux à deux augmente le risque de faux positifs. Avec \(k\) groupes, il y a \(k(k-1)/2\) comparaisons deux à deux (p. ex., groupe 1 vs. groupe 2, groupe 1 vs. groupe 3, etc.). Pour cinq traitements, cela fait dix tests. Si aucune différence n’existe réellement et si l’on réalisait naïvement dix tests au seuil de 5 %, la probabilité d’obtenir au moins un résultat significatif par hasard grandit à chaque fois que l’on ajoute un test (cela s’appelle l’inflation du risque de première espèce, lié à la notion de multiplicité de tests).
Au lieu de faire beaucoup de tests deux à deux, on peut faire un test global qui compare toutes les moyennes en même temps. C’est l’analyse de variance, ou ANOVA (de “ANalysis Of VAriance”).
Ronald Fisher a développé l’analyse de variance et l’a présentée dans son ouvrage de 1925 (Fisher 1925), qui a contribué à diffuser cette méthode.
Pour l’appliquer, il faut que les observations soient indépendantes, que la variable soit approximativement normale dans chaque groupe (OU que les tailles d’échantillon soient suffisamment grandes), et qu’on ait homoscédasticité (i.e., variances comparables).
Les hypothèses sont : \[ H_0:\mu_1=\mu_2=\cdots=\mu_k\;\text{ (toutes les moyennes sont égales) } \] contre \[ H_1:\exists i,j, \,\mu_i\neq\mu_j\; \text{ (au moins deux moyennes sont différentes) } \]
On ne cherche pas encore à savoir quel groupe est différent des autres, mais à savoir si au moins un semble sortir du lot.
Autrement dit, rejeter \(H_0\) ne signifie pas que TOUS les groupes sont différents, mais qu’au moins un est différent des autres.
L’ANOVA compare deux sources de variabilité :
- inter-groupes : les moyennes de groupes sont-elles éloignées les unes des autres ?
- intra-groupe : les observations varient-elles beaucoup au sein de chaque groupe ?
Pour calculer la statistique de test, on a besoin de plusieurs quantités qui décrivent la variabilité des données.
2.3.1 Sommes des carrés
On note \(N\) le nombre total d’observations, \(k\) le nombre de groupes, \(y_{ij}\) la valeur du sujet \(j\) dans le groupe \(i\), \(\bar y_i\) la moyenne du groupe \(i\) et \(\bar y\) la moyenne générale.
La première quantité est la somme des carrés totale (SCT) : \[ SCT=\sum_{i=1}^k\sum_{j=1}^{n_i}(y_{ij}-\bar y)^2, \] elle correspond à toute la variabilité de nos données, indépendamment des groupes qu’on a à disposition.
On ne dirait peut-être pas comme ça, mais cette formule ressemble grandement à la formule de la variance empirique vue dans la section “Indicateurs de dispersion” du chapitre Introduction à la statistique ! En fait, si on divise la SCT par \(N-1\), on obtient exactement la variance empirique de toutes les observations …
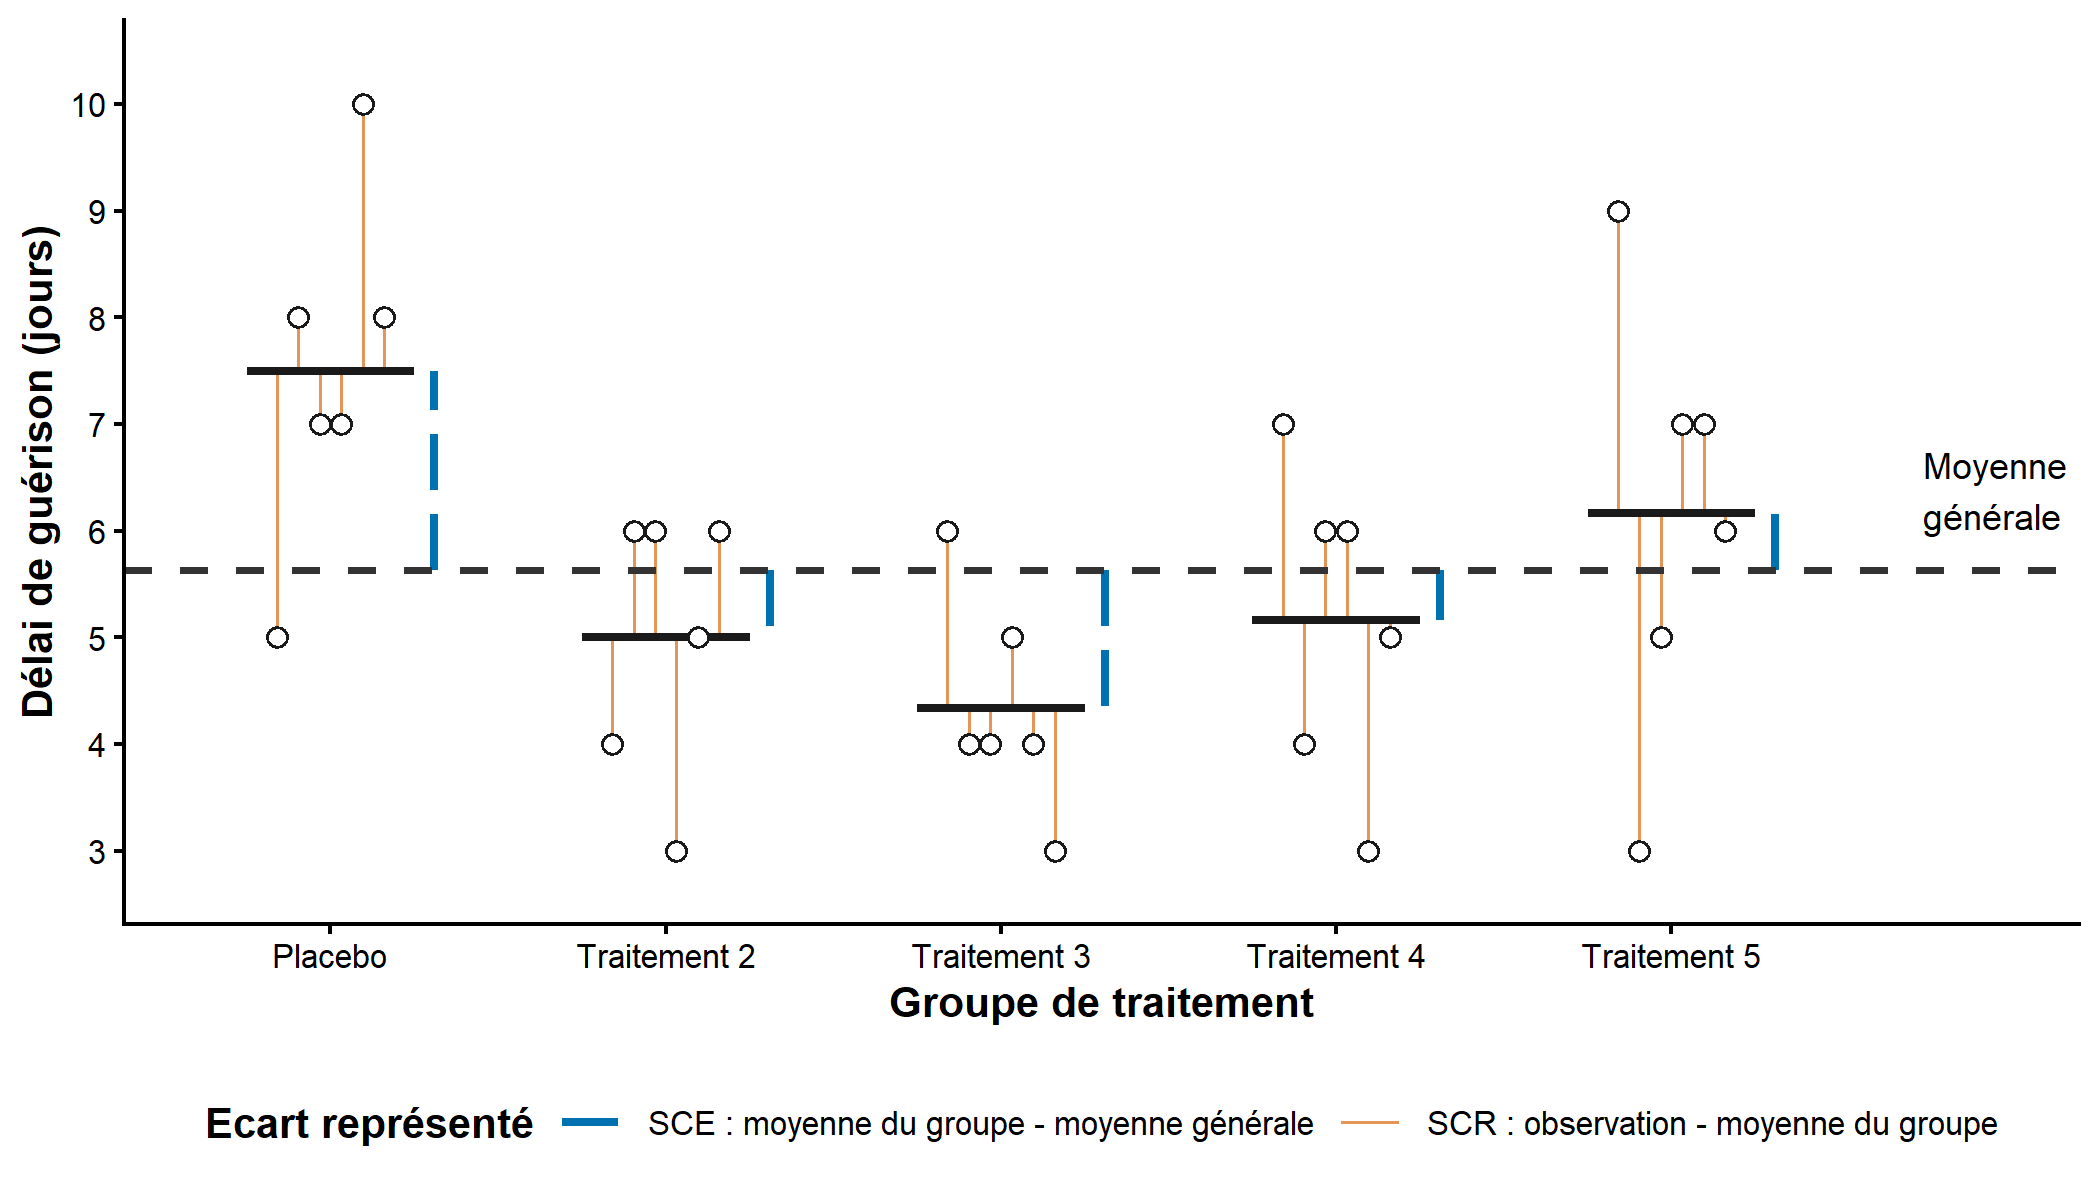
Cette variabilité totale est en partie expliquée par les différents groupes qu’on étudie. Cette variabilité s’obtient en calculant la somme des carrés expliquée (SCE) : \[ SCE=\sum_{i=1}^k n_i(\bar y_i-\bar y)^2, \]
On appelle aussi “variabilité inter-groupe” la SCE, car elle mesure la variabilité entre les moyennes de groupes.
En pratique, les groupes n’expliquent généralement pas, à eux seuls, toute la variabilité des données ! Cette part restante est appelée somme des carrés résiduelle (SCR) : \[ SCR=\sum_{i=1}^k\sum_{j=1}^{n_i}(y_{ij}-\bar y_i)^2 \]
On l’appelle aussi “variabilité intra-groupe”, car elle mesure la variabilité à l’intérieur de chaque groupe.
Il se trouve que ces formules sont liées par une relation fondamentale : \[ SCT=SCE+SCR \]
La figure ci-dessous illustre visuellement ce que sont la SCE et la SCR, dans un exemple où on compare cinq traitements contre l’herpès labial.
2.3.2 Statistique de test et tableau d’ANOVA
La statistique de test est le rapport entre la variabilité expliquée par les groupes et la variabilité résiduelle à l’intérieur des groupes. Sous les hypothèses d’indépendance, de normalité et d’égalité des variances : \[ F=\frac{CME}{CMR}=\frac{SCE/(k-1)}{SCR/(N-k)} \underset{H_0}{\sim} F_{k-1,N-k} \]
Au seuil \(\alpha\), la région critique est située dans la queue droite de la loi de Fisher : \[ F>F_{1-\alpha,k-1,N-k} \]
On peut résumer tout ce qui a été présenté à l’aide du “tableau d’ANOVA”.
| Source de variation | Somme des carrés | Degrés de liberté | Carré moyen | Statistique |
|---|---|---|---|---|
| Expliquée | \(SCE\) | \(k-1\) | \(CME=\frac{SCE}{k-1}\) | \(F=\frac{CME}{CMR}\) |
| Résiduelle | \(SCR\) | \(N-k\) | \(CMR=\frac{SCR}{N-k}\) | |
| Total | \(SCT\) | \(N-1\) |
Avertissement
Ici, rejeter \(H_0\) ne dit pas quelles moyennes diffèrent, seulement qu’au moins deux diffèrent.
Les références
Fisher, Ronald A. 1925. Statistical Methods for Research Workers. Oliver; Boyd. https://www.yorku.ca/pclassic/Fisher/Methods/.
Levene, Howard. 1960. « Robust Tests for Equality of Variances ». In Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling, édité par Ingram Olkin. Stanford University Press. https://books.google.com/books/about/Contributions_to_Probability_and_Statist.html?id=ZUSsAAAAIAAJ.
Satterthwaite, Franklin E. 1946. « An Approximate Distribution of Estimates of Variance Components ». Biometrics Bulletin 2 (6): 110‑14. https://doi.org/10.2307/3002019.
Snedecor, George W. 1934. Calculation and Interpretation of Analysis of Variance and Covariance. Collegiate Press. https://books.google.com/books/about/Calculation_and_Interpretation_of_Analys.html?id=QYJNAAAAMAAJ.
Student. 1908. « The Probable Error of a Mean ». Biometrika 6 (1): 1‑25. https://doi.org/10.1093/biomet/6.1.1.
Welch, Bernard L. 1938. « The Significance of the Difference between Two Means when the Population Variances Are Unequal ». Biometrika 29 (3–4): 350‑62. https://doi.org/10.1093/biomet/29.3-4.350.
Welch, Bernard L. 1947. « The Generalization of Student’s Problem when Several Different Population Variances Are Involved ». Biometrika 34 (1–2): 28‑35. https://doi.org/10.1093/biomet/34.1-2.28.