4 Autres tests
Les tests précédents couvrent les situations les plus fréquentes, mais il existe d’autres cas importants : tenir compte d’un appariement, comparer des rangs, comparer une distribution observée à une distribution attendue, ou tester une corrélation entre deux variables quantitatives.
4.1 Tests pour échantillons appariés
Deux échantillons sont appariés lorsque les observations vont par paires : deux mesures chez le même sujet, ou deux sujets associés par construction (par exemple deux jumeaux, ou un cas et son témoin apparié). Dans ce cas, on ne doit pas analyser les deux séries comme deux groupes indépendants. Pour chaque test ici, on suppose que la donnée est appariée sur un même sujet, et que les paires sont indépendantes les unes des autres.
4.1.1 Comparaison de moyennes appariées
Lorsque deux mesures quantitatives sont prises chez les mêmes sujets, la bonne unité de comparaison devient la différence intra-sujet.
Pour chaque paire, on calcule : \[ D_i=\text{pression après traitement}-\text{pression avant traitement} \]
La question n’est plus de comparer deux groupes indépendants, mais de tester si la moyenne théorique des différences est compatible avec 0. Un test de Student apparié est donc un test de Student à un échantillon appliqué aux différences. Pour l’appliquer, il faut vérifier les conditions précédentes, et que les différences intra-sujet \(D_i\) soient approximativement normales (ou nombre de paires suffisamment grand).
Pour un test bilatéral, les hypothèses sont : \[ H_0:\mu_D=0 \;\text{contre}\; H_1:\mu_D\neq0, \] où \(\mu_D\) est la moyenne théorique des différences.
On note :
- \(n\) le nombre de paires ;
- \(\bar D\) la moyenne observée des différences ;
- \(S_D\) l’écart-type empirique corrigé des différences.
La statistique de test est : \[ T=\frac{\bar D-0}{S_D/\sqrt n}\underset{H_0}{\overset{\mathrm{approx.}}{\sim}}\text{Student}_{n-1} \]
On l’a écrit comme ça, pour montrer qu’elle ressemble très grandement à la statistique de test pour un échantillon unique.
Au seuil \(\alpha\), pour un test bilatéral, la région critique est : \[ |T|>t_{1-\alpha/2,n-1} \]
4.1.2 Test de McNemar
Le test de McNemar est l’analogue du test du \(\chi^2\) pour deux mesures qualitatives binaires appariées - typiquement, quand on mesure quelque chose avant et après une intervention. En plus des conditions précédentes, il faut que le nombre de paires discordantes - c’est-à-dire le nombre de personnes qui changent de statut entre les deux mesures - soit suffisant pour que l’approximation par le \(\chi^2\) soit valable (typiquement, \(b+c\ge10\)).
Quinn McNemar a présenté cette méthode en 1947 pour comparer des proportions issues de données appariées (McNemar 1947).
On représente ceci dans le tableau de contingence suivant :
| Après : Positif | Après : Négatif | Total | |
|---|---|---|---|
| Avant : Positif | \(a\) | \(b\) | \(a+b\) |
| Avant : Négatif | \(c\) | \(d\) | \(c+d\) |
| Total | \(a+c\) | \(b+d\) | \(n\) |
On appelle “positif” et “négatif” les deux catégories possibles pour chaque mesure. Ç’aurait pu être “oui” et “non”, ou “malade” et “sain”, etc.
Les cellules \(a\) et \(d\) sont les paires concordantes : elles ne changent pas de statut. Le test porte uniquement sur les paires discordantes : \(b\) correspond aux sujets positifs avant et négatifs après, tandis que \(c\) correspond aux sujets négatifs avant et positifs après.
Les hypothèses sont : \[ H_0:\pi_{+-}=\pi_{-+} \;\text{contre}\; H_1:\pi_{+-}\neq\pi_{-+} \] où \(\pi_{+-}\) est la probabilité de passer de positif à négatif, et \(\pi_{-+}\) la probabilité de passer de négatif à positif.
La statistique de test est : \[ \chi^2_{\mathrm{McNemar}}=\frac{(b-c)^2}{b+c}\underset{H_0}{\overset{\mathrm{approx.}}{\sim}}\chi^2_1 \]
Au seuil \(\alpha\), la région critique est : \[ \chi^2_{\mathrm{McNemar}}>\chi^2_{1-\alpha,1} \]
4.2 Test de Wilcoxon-Mann-Whitney
Un test de comparaison de moyennes n’est pas adapté si la question porte surtout sur une distribution très asymétrique ou des rangs par exemple. Dans ce cas, un test comme Wilcoxon-Mann-Whitney peut être plus pertinent.
Frank Wilcoxon a proposé un test de rangs en 1945 (Wilcoxon 1945). Henry Mann et Donald Whitney en ont développé une formulation équivalente en 1947 (Mann et Whitney 1947).
Ce test compare deux groupes indépendants au travers de leur distribution. De plus, c’est un test non paramétrique : il n’impose aucune hypothèse pour l’utiliser, si ce n’est l’indépendance des observations. Il est souvent présenté comme une alternative au test de Student si \(n<30\) et l’hypothèse de normalité n’est pas vérifiée, mais il ne teste pas la même chose !
Mise en garde
Sur internet ou en demandant à des modèles de langage, on peut lire que le test de Wilcoxon-Mann-Whitney est “un test des médianes”. C’est FAUX ! C’est un test portant sur la distribution (ou de “domination stochastique” si on veut se la péter). Cependant, sous certaines conditions, il peut s’interpréter comme un test de médianes.
Une manière assez simple (mais forte) de formuler les hypothèses est : \[ H_0:\text{les deux distributions sont identiques} \;\text{ vs. }\; H_1:\text{les deux distributions diffèrent.} \]
Le principe du test est alors le suivant :
- on mélange les valeurs des deux groupes ;
- on les classe de la plus petite à la plus grande ;
- on attribue un rang à chaque valeur, avec des rangs moyens en cas d’égalité ;
Avec ces rangs, on va se demander si les rangs du groupe 1 sont plus petits que ceux du groupe 2 (ou inversement) : c’est ça, comparer deux distributions.
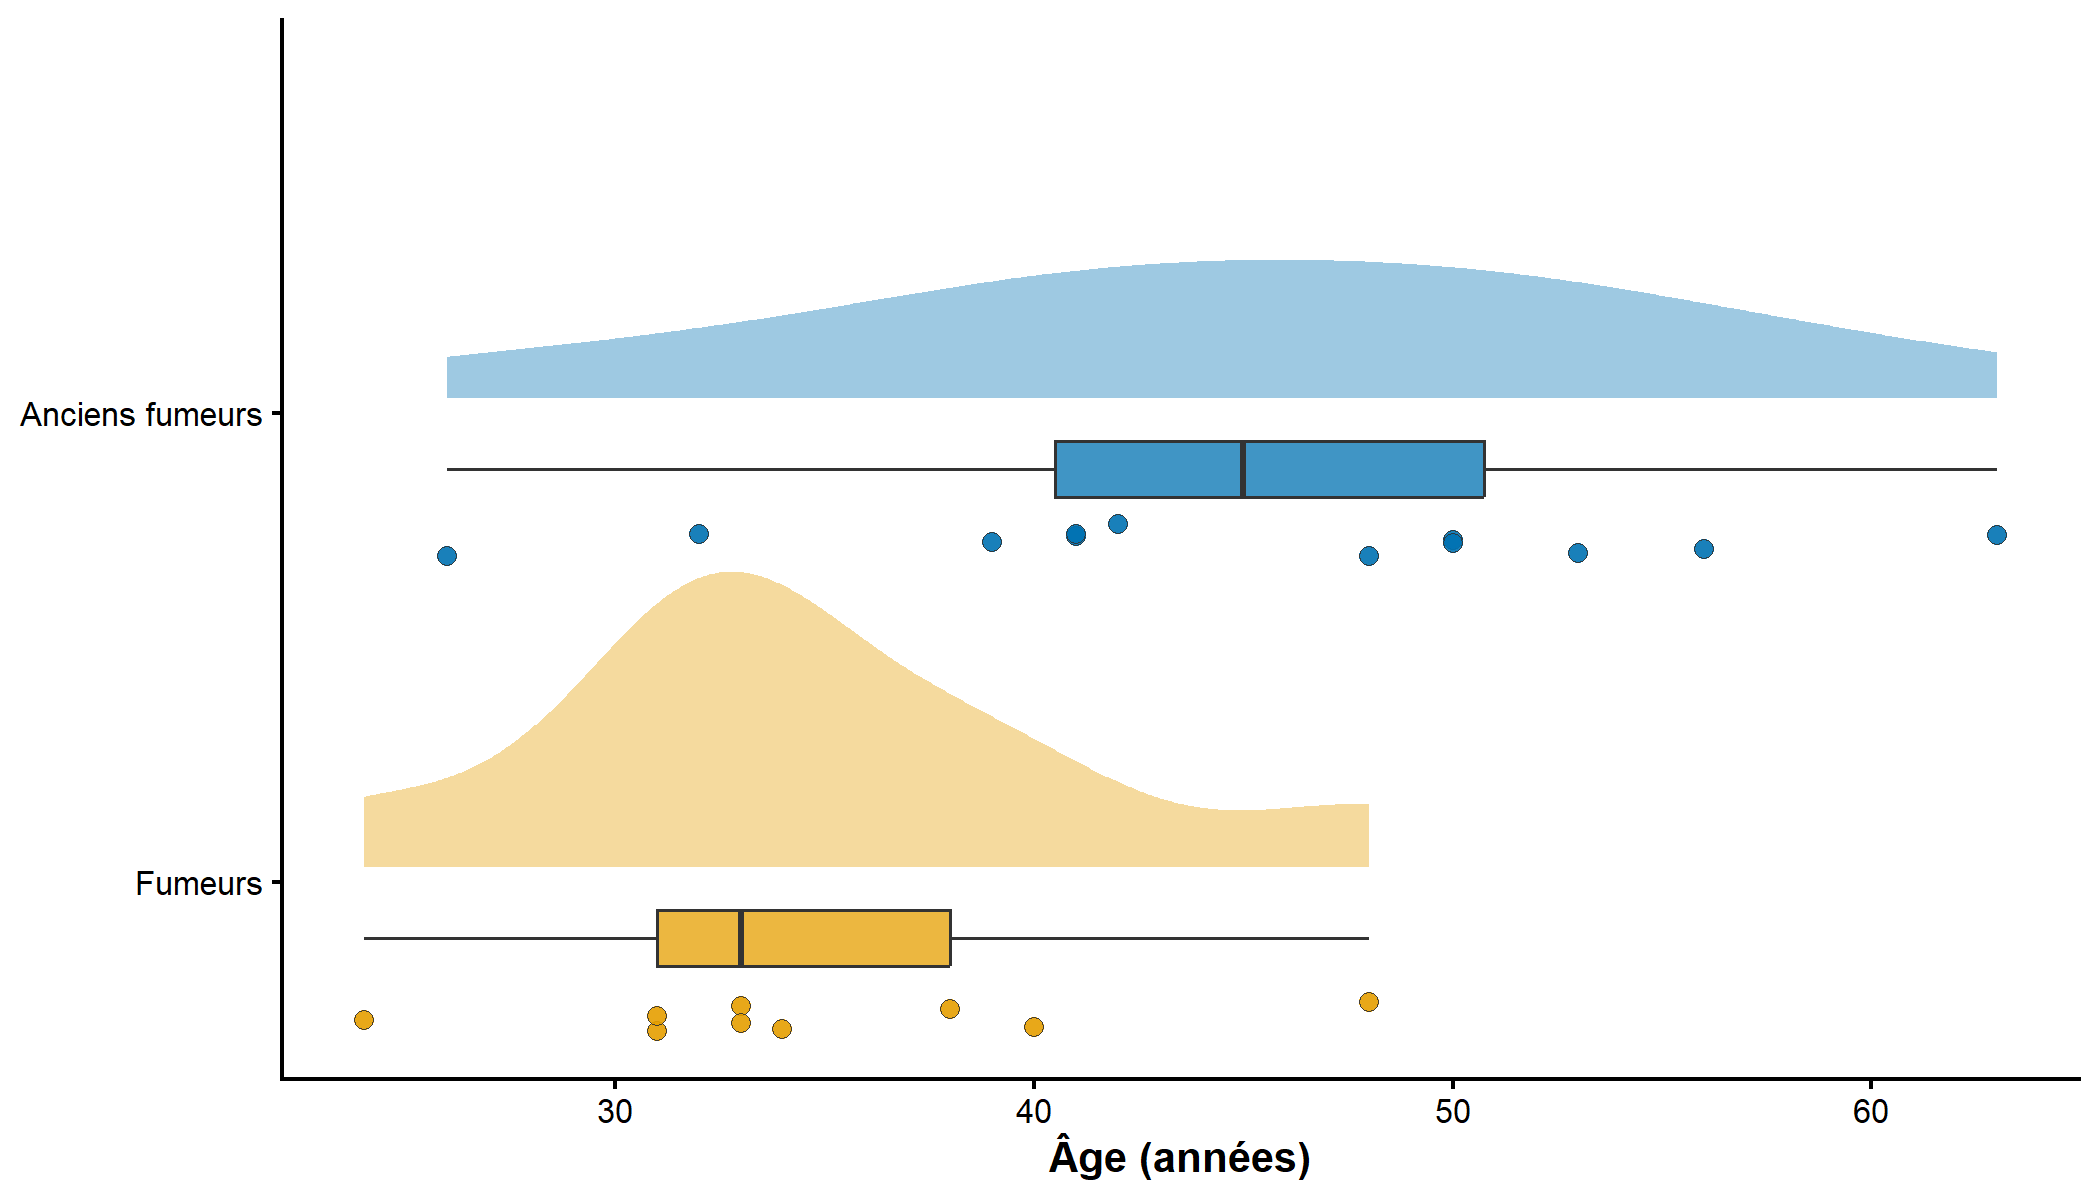
Le calcul de la variance de la statistique est adapté lorsqu’il existe des ex æquo (des valeurs identiques recevant le même rang moyen). Nous ne trouvons pas intéressant de présenter ces formules ici ni de les utiliser à la main. À la place, voici comment interpréter le résultat d’un logiciel statistique, ainsi qu’une représentation graphique de la situation.
NoteExemple
La question ayant été formulée dans le sens “les fumeurs sont-ils plus jeunes ?”, on utilise ici un test unilatéral à gauche. Avec notre logiciel préféré, la statistique vaut \(W=19,5\) et la p-valeur asymptotique unilatérale, corrigée pour les ex æquo, est d’environ \(0,0078\) : on rejette donc \(H_0\) au seuil de 5 %. Dans cet échantillon, les fumeurs tendent à avoir des âges plus faibles que les anciens fumeurs. Pour le test bilatéral correspondant aux hypothèses écrites plus haut, la p-valeur serait environ \(0,0155\) ; la conclusion au seuil de 5 % resterait la même.
Le graphe précédent s’appelle un “raincloud plot” : il combine un demi-violon (la densité estimée), une boîte (les quartiles et la médiane) et les points (les observations individuelles). En plus, c’est plutôt mignon.
4.3 Test du \(\chi^2\) d’ajustement
Le test du \(\chi^2\) d’ajustement ne compare pas deux variables qualitatives. Il compare la distribution observée d’une seule variable qualitative à une distribution théorique ou de référence fixée à l’avance. Pour l’utiliser, il faut aussi que les effectifs attendus soient suffisants (typiquement, au moins 5 par modalité).
Les hypothèses sont : \[ H_0:P(Y=1)=p_1,\ldots,P(Y=k)=p_k \] contre \[ H_1:\text{au moins une proportion diffère de la distribution de référence.} \]
Si les probabilités de référence sont \(p_1,\ldots,p_k\) et que l’effectif total est \(n\), les effectifs attendus sont : \[ E_j=np_j. \]
La statistique repose ensuite sur la même idée que le \(\chi^2\) d’indépendance : \[ \chi^2=\sum_{j=1}^k\frac{(O_j-E_j)^2}{E_j} \underset{H_0}{\overset{\mathrm{approx.}}{\sim}}\chi^2_{k-1} \] où \(O_j\) est l’effectif observé et \(E_j\) l’effectif attendu dans la modalité \(j\). Le nombre de degrés de liberté est \(k-1\).
Au seuil \(\alpha\), la région critique est : \[ \chi^2>\chi^2_{1-\alpha,k-1} \]
4.4 Test de corrélation entre deux variables quantitatives
On a vu dans le chapitre sur la représentation des données qu’un coefficient de corrélation résume la force et le sens d’une association entre deux variables quantitatives. Mais observer un coefficient différent de 0 dans un échantillon ne suffit pas pour conclure : les fluctuations d’échantillonnage peuvent aussi produire une corrélation. C’est là qu’intervient le test.
4.4.1 Test de corrélation de Pearson
Karl Pearson développe la théorie de la corrélation linéaire dans ses travaux de 1896 (Pearson 1896). On retrouve donc son nom ici, comme pour le \(\chi^2\), mais les deux tests ne répondent pas à la même question !
On mesure deux variables \(X\) et \(Y\) chez \(n\) individus. On note \(r\) le coefficient de corrélation observé dans l’échantillon et \(\rho\) (la lettre grecque “rhô”) celui de la population. Pour un test bilatéral, les hypothèses sont : \[ H_0:\rho=0 \;\text{contre}\; H_1:\rho\neq0 \]
Autrement dit, on cherche à savoir s’il existe une association linéaire entre \(X\) et \(Y\) dans la population, dans un sens ou dans l’autre.
Avant de calculer quoi que ce soit, on commence par regarder le nuage de points. Si les points dessinent autre chose qu’une tendance qui peut se résumer via une droite (p. ex., une courbe en U), ce coefficient ne résume probablement pas bien la situation.
Pour le test présenté ici, on suppose que :
- les individus sont indépendants les uns des autres. Chaque individu fournit un couple de mesures \((X_i,Y_i)\) : ce sont les couples qui doivent être indépendants, pas les deux variables à l’intérieur d’un couple ;
- les couples \((X,Y)\) suivent une loi normale bivariée. Sans entrer dans les détails, on cherche à vérifier si le nuage de points a une forme globalement elliptique (vérifier séparément que \(X\) et \(Y\) ont chacun une distribution normale n’est donc pas utile !).
Cette hypothèse de normalité sert à justifier la loi du test ci-dessous. On peut calculer un coefficient de Pearson sans elle, mais cela ne rend pas automatiquement sa p-valeur valide.
Sous ces hypothèses, la statistique de test est : \[ T=r\sqrt{\frac{n-2}{1-r^2}}\underset{H_0}{\sim}\text{Student}_{n-2} \]
On retrouve une loi de Student, cette fois avec \(n-2\) degrés de liberté. Au seuil \(\alpha\), pour un test bilatéral, la région critique est : \[ |T|>t_{1-\alpha/2,n-2} \]
AvertissementUne corrélation significative n’est pas forcément une forte corrélation
La p-valeur dépend à la fois du coefficient observé et de l’effectif. Avec beaucoup de sujets, une corrélation très faible peut être significative ; avec peu de sujets, une corrélation plus marquée peut ne pas l’être. On rapporte donc le coefficient, et pas seulement la p-valeur, ainsi que l’effectif et, si possible, un intervalle de confiance.
Et si le test n’est pas significatif, on ne conclut pas que les variables sont indépendantes : on n’a pas mis en évidence de corrélation linéaire. Une relation d’une autre forme peut parfaitement exister.
4.4.2 Et si la relation n’est pas linéaire ?
Si la relation est monotone, c’est-à-dire globalement croissante ou décroissante (sans forcément suivre une droite), on peut utiliser le test de corrélation de Spearman. Son coefficient correspond à une corrélation de Pearson calculée sur les rangs des valeurs. En cas d’ex æquo, on attribue des rangs moyens (comme ce qu’on a fait avec Wilcoxon-Mann-Whitney).
Charles Spearman a proposé cette approche par les rangs en 1904 (Spearman 1904).
On note \(r_s\) le coefficient observé et \(\rho_s\) celui de la population. Le test bilatéral porte alors sur : \[ H_0:\rho_s=0 \;\text{contre}\; H_1:\rho_s\neq0 \]
Ce test ne nécessite pas l’hypothèse de normalité bivariée, mais les individus doivent toujours être indépendants.
NoteRemarque
Spearman ne détecte pas toutes les relations non linéaires ! Si la relation est en U, elle descend puis remonte : elle n’est pas monotone, et les deux coefficients peuvent être proches de 0. Le nuage de points reste donc indispensable pour choisir ce que l’on veut mesurer :)
Les références
Mann, Henry B., et Donald R. Whitney. 1947. « On a Test of Whether One of Two Random Variables Is Stochastically Larger than the Other ». The Annals of Mathematical Statistics 18 (1): 50‑60. https://doi.org/10.1214/aoms/1177730491.
McNemar, Quinn. 1947. « Note on the Sampling Error of the Difference between Correlated Proportions or Percentages ». Psychometrika 12 (2): 153‑57. https://doi.org/10.1007/BF02295996.
Pearson, Karl. 1896. « Mathematical Contributions to the Theory of Evolution. III. Regression, Heredity, and Panmixia ». Philosophical Transactions of the Royal Society of London. Series A 187: 253‑318. https://doi.org/10.1098/rsta.1896.0007.
Spearman, Charles. 1904. « The Proof and Measurement of Association between Two Things ». The American Journal of Psychology 15 (1): 72‑101. https://doi.org/10.2307/1412159.
Wilcoxon, Frank. 1945. « Individual Comparisons by Ranking Methods ». Biometrics Bulletin 1 (6): 80‑83. https://doi.org/10.2307/3001968.