Exercices

Exercice 1 - À vos modèles, prêts, ajustez !

Une équipe suit 160 adultes traités pour hypertension artérielle. Elle souhaite étudier l’association entre la consommation quotidienne de sodium et la pression artérielle systolique. Pour chaque participant, elle mesure :

  • la pression artérielle systolique PAS, en mmHg ;
  • la consommation de sodium SODIUM, en g/jour ;
  • l’âge AGE, en années ;
  • la prise d’un traitement antihypertenseur TRAITEMENT, codée 0 pour non et 1 pour oui.
  1. Précisez l’unité statistique, la variable réponse, la variable explicative principale, les deux autres covariables disponibles et le type de chacune de ces variables.
  2. Expliquez pourquoi une régression linéaire peut être envisagée pour répondre à la question principale.
  3. Écrivez un modèle linéaire simple reliant la pression artérielle systolique à la consommation de sodium.
  4. Interprétez, avec leurs unités, l’intercept et la pente de ce modèle. Indiquez si l’intercept a nécessairement un sens clinique.
  5. Indiquez quel graphique vous examineriez avant l’ajustement pour évaluer la forme de la relation.
  6. On définit SODIUM_c = SODIUM - 6. Réécrivez le modèle avec cette variable centrée et expliquez ce que devient l’interprétation de l’intercept. L’estimation de la pente sera-t-elle modifiée ?

1. Éléments de l’analyse

L’unité statistique est un adulte traité pour hypertension artérielle.

Tableau 1: Rôle et nature des variables mesurées chez 160 adultes traités pour hypertension artérielle.
Rôle Variable Type
Réponse PAS, en mmHg Quantitative continue
Variable explicative principale SODIUM, en g/jour Quantitative continue
Covariable AGE, en années Quantitative continue sur le plan conceptuel
Covariable TRAITEMENT, non/oui Qualitative binaire malgré le codage 0/1

La question principale porte sur l’association entre la consommation de sodium et la moyenne de la PAS. L’âge et le traitement sont disponibles pour un éventuel ajustement, mais leur présence dans le fichier ne suffit pas à imposer automatiquement leur inclusion : on ajuste sur celles-ci si elles peuvent créer un biais de confusion.

2. Pourquoi envisager une régression linéaire ?

La variable réponse PAS est quantitative continue. Une régression linéaire permet de modéliser sa moyenne conditionnelle selon une variable quantitative, la consommation de sodium. Elle fournit notamment une différence moyenne de PAS associée à une augmentation d’un gramme de sodium par jour.

Ainsi, si la relation entre PAS et SODIUM semble linéaire, la régression linéaire est un outil approprié pour quantifier cette association.

3. Modèle simple

Pour le patient \(i\) : \[ \mathrm{PAS}_i=\beta_0+\beta_1\mathrm{SODIUM}_i+\varepsilon_i, \; \boldsymbol\varepsilon\mid\mathbf X\sim \mathcal N_n(\mathbf0,\sigma^2\mathbf I_n) \] ou, de manière équivalente avec pour la moyenne conditionnelle : \[ \mathbb E(\mathrm{PAS}\mid\mathrm{SODIUM}=x) =\beta_0+\beta_1x \]

4. Interprétation

  • \(\beta_0\) est la PAS moyenne attendue, en mmHg, pour une consommation de sodium égale à 0 g/jour ;
  • \(\beta_1\) est la différence moyenne de PAS, en mmHg, associée à une augmentation de 1 g/jour de la consommation de sodium.

Ici, l’intercept est peu pertinent à interpréter, car une consommation de 0 g/jour est probablement impossible ou très éloignée des données. Il serait préférable de centrer la variable sur une valeur cliniquement pertinente, par exemple 6 g/jour comme dans la question suivante, ou sur sa moyenne.

5. Graphique préalable

On examinerait un nuage de points de PAS selon SODIUM, avec éventuellement une droite et une courbe de lissage. Il permet de repérer :

  • la direction de l’association ;
  • si la relation semble linéaire ;
  • des zones de dispersion différente ;
  • des observations isolées.

6. Centrage à 6 g/jour

On définit : \[ \mathrm{SODIUM}_c=\mathrm{SODIUM}-6. \]

Le modèle peut s’écrire : \[ \mathrm{PAS}_i=\alpha_0+\alpha_1\mathrm{SODIUM}_{c,i}+\varepsilon_i. \]

Comme \(\mathrm{SODIUM}_c=0\) lorsque la consommation vaut 6 g/jour, \(\alpha_0\) est la PAS moyenne attendue à 6 g/jour.

En remplaçant \(\mathrm{SODIUM}=\mathrm{SODIUM}_c+6\) dans le modèle initial : \[ \beta_0+\beta_1(\mathrm{SODIUM}_c+6) = \beta_0 + \beta_1\mathrm{SODIUM}_c + 6\beta_1 =(\beta_0+6\beta_1)+\beta_1\mathrm{SODIUM}_c \] Ainsi : \[ \alpha_0=\beta_0+6\beta_1 \text{ et } \alpha_1=\beta_1. \] Le centrage change l’intercept mais pas la pente !

Exercice 2 - Les coefficients passent à table

Chez 240 personnes atteintes de maladie rénale chronique, on modélise le débit de filtration glomérulaire estimé (DFGe, en mL/min/1,73 m²). On définit :

\[ A_{10}=\frac{\mathrm{AGE}-50}{10},\; \text{ et }\; P_{10}=\frac{\mathrm{PAS}-120}{10}, \]

et DIABETE = 1 pour une personne diabétique, 0 sinon. Hadrien Aurüé a estimé un modèle linéaire multiple, dont les résultats sont présentés dans le tableau ci-dessous.

Tableau 2: Résultats du modèle linéaire multiple expliquant le débit de filtration glomérulaire estimé (DFGe).
Terme Estimation Erreur standard IC 95 % p-valeur
Intercept 92,4 2,1 [88,3 ; 96,5] \(< 0{,}001\)
Âge -4,8 0,8 ? \(< 0{,}001\)
Diabète (oui vs non) -7,5 2,2 [-11,8 ; -3,2] 0,001
PAS -1,2 0,5 [-2,2 ; -0,2] ?
  1. Écrivez le modèle estimé en utilisant \(A_{10}\), \(P_{10}\) et DIABETE.
  2. Pourquoi Hadrien a-t-il choisi de créer \(A_{10}\) et \(P_{10}\) plutôt que d’utiliser directement l’âge et la PAS ?
  3. Interprétez les coefficients estimés du tableau.
  4. Calculez le DFGe moyen prédit pour une personne de 70 ans, diabétique, dont la pression artérielle systolique est de 140 mmHg.
  5. L’effet du diabète est-il significativement différent de zéro ? Vous y répondrez en réalisant le test statistique adapté et en utilisant la p-valeur fournie.
  6. Hadrien Aurüé a oublié de calculer l’intervalle de confiance à 95 % du coefficient de l’âge. Calculez-le, en sachant que \(t_{0{,}975;236}=1{,}97\).
  7. Hadrien Aurüé est décidément tête en l’air, et a aussi perdu la p-valeur du coefficient de la PAS. Savez-vous si elle est inférieure ou supérieure à 0,05 ?

1. Modèle estimé

Avec : \[ A_{10}=\frac{\mathrm{AGE}-50}{10} \text{ et } P_{10}=\frac{\mathrm{PAS}-120}{10} \] le modèle estimé est : \[ \mathbb{E}(\mathrm{DFGe}\mid A_{10},P_{10},\mathrm{DIABETE}) = \beta_0 + \beta_1 A_{10} + \beta_2 P_{10} + \beta_3 \mathrm{DIABETE}, \] En remplaçant par les estimations du modèle, on obtient : \[ \widehat{\mathbb E}(\mathrm{DFGe}\mid A_{10},P_{10},\mathrm{DIABETE}) =92{,}4-4{,}8A_{10}-7{,}5\mathrm{DIABETE}-1{,}2P_{10}. \]

2. Intérêt des transformations

Le centrage fixe des valeurs de référence cliniquement parlantes : 50 ans et 120 mmHg. La division par 10 exprime les effets pour une augmentation de 10 ans ou de 10 mmHg, plutôt que pour une seule unité.

Ainsi, l’intercept a maintenant un sens clinique, et les coefficients s’interprètent pour une augmentation de 10 unités.

3. Interprétation des coefficients

  • Intercept = 92,4. C’est le DFGe moyen prédit pour une personne de 50 ans, non diabétique, avec une PAS de 120 mmHg. Son unité est le mL/min/1,73 m².
  • Âge =-4,8. À statut diabétique et PAS identiques, dix années supplémentaires sont associées à un DFGe moyen inférieur de 4,8 mL/min/1,73 m².
  • Diabète = -7,5. À âge et PAS identiques, une personne diabétique a un DFGe moyen inférieur de 7,5 mL/min/1,73 m² à celui d’une personne non diabétique.
  • PAS = -1,2. À âge et statut diabétique identiques, une augmentation de 10 mmHg est associée à un DFGe moyen inférieur de 1,2 mL/min/1,73 m².

On aurait aussi pu interpréter les coefficients, en disant “toutes choses égales par ailleurs”.

4. Prédiction pour le profil demandé

Pour “70 ans” : \[ A_{10}=\frac{70-50}{10}=2. \] Pour “140 mmHg” : \[ P_{10}=\frac{140-120}{10}=2. \] La personne est diabétique, donc \(\mathrm{DIABETE}=1\). On remplace dans le modèle : \[ \widehat{\mathrm{DFGe}} =92{,}4-4{,}8\times2-7{,}5\times1-1{,}2\times2 =72{,}9\text{ mL/min/1,73 m}^2 \]

5. Test du coefficient du diabète

On teste : \[ H_0:\beta_{\mathrm{DIABETE}}=0 \text{ vs. } H_1:\beta_{\mathrm{DIABETE}}\neq0 \]

Le test de Wald fourni par le modèle donne \(p=0{,}001<0{,}05\), donc on rejette \(H_0\). Le coefficient du diabète est statistiquement différent de zéro. L’intervalle \([-11{,}8\, ; \,-3{,}2]\) confirme la même décision puisqu’il n’inclut pas zéro.

Dans le contexte, le diabète est associé à un DFGe moyen plus faible après ajustement sur l’âge et la PAS.

6. Intervalle de confiance du coefficient de l’âge

La formule est : \[ \widehat\beta\pm t_{0{,}975\, ; \,236}\times SE(\widehat\beta) \] Donc : \[ IC_{95\,\%}=-4{,}8\pm1{,}97\times0{,}8 =-4{,}8\pm1{,}576 \approx[-6{,}38\, ; \,-3{,}22]\text{ mL/min/1,73 m}^2 \] pour dix années supplémentaires.

7. P-valeur du coefficient de la PAS

On peut raisonner de deux façons.

Premièrement, l’intervalle \([-2{,}2\, ; \,-0{,}2]\) n’inclut pas zéro : la p-valeur bilatérale est donc inférieure à 0,05.

Deuxièmement, la statistique de Wald vaut en valeur absolue : \[ \left|\frac{-1{,}2}{0{,}5}\right|=2{,}4 \] ce qui dépasse la valeur critique d’environ 1,97. On rejette donc \(H_0:\beta_{\mathrm{PAS}}=0\) au seuil de 5 %, soit \(p<0{,}05\).

Exercice 3 - Et un, et deux, et trois traitements

Dans un essai portant sur 180 patients, la diminution de l’hémoglobine après un traitement anticoagulant est mesurée en g/dL. Le schéma thérapeutique comporte trois modalités : A, B et C. Le modèle est ajusté sur l’âge, exprimé par tranche de 10 ans, et sur une insuffisance rénale binaire.

Tableau 3: Coefficients du modèle linéaire multiple de la diminution de l’hémoglobine selon le schéma thérapeutique, l’âge et l’insuffisance rénale.
Terme Estimation IC 95 % p-valeur
Schéma (ref. A)
 Schéma B 0,28 [0,05 ; 0,51] 0,018
 Schéma C 0,10 [-0,15 ; 0,35] 0,428
Âge (+10 ans) 0,06 [0,01 ; 0,11] 0,019
Insuffisance rénale (oui vs non) 0,42 [0,16 ; 0,68] 0,002

On dispose des sommes des carrés résiduelles (SCR) de trois modèles emboîtés :

Tableau 4: Sommes des carrés résiduelles (SCR) de trois modèles emboîtés.
Modèle Variables explicatives Coefficients hors intercept ddl résiduels SCR
\(\mathcal M_0\) Aucune 0 179 207,0
\(\mathcal M_R\) Âge et insuffisance rénale 2 177 182,5
\(\mathcal M_C\) Schéma, âge et insuffisance rénale 4 175 175,0

Comme \(\mathcal M_0\) ne contient que l’intercept, sa SCR correspond à la somme des carrés totale (SCT) de la variable réponse. Enfin, on donne les valeurs critiques suivantes : \[ F_{0{,}95\, ; \,2\, ; \,175}=3{,}05 \quad\text{et}\quad F_{0{,}95\, ; \,4\, ; \,175}=2{,}42 \]

  1. À combien est le \(SCE\) dans le modèle \(\mathcal M_R\) ? Et dans le modèle \(\mathcal M_C\) ?
  2. Calculer le \(R^2\) dans le modèle \(\mathcal M_R\) et dans le modèle \(\mathcal M_C\). Que peut-on en conclure ?
  3. Écrivez le modèle linéaire multiple.
  4. Interprétez les coefficients des schémas B et C.
  5. Expliquez pourquoi le codage A = 1, B = 2 et C = 3 serait inadapté.
  6. On souhaite tester si l’âge, l’insuffisance rénale ou le schéma thérapeutique sont associés à la diminution de l’hémoglobine. Comment y répondre ? Le réaliser et conclure.
  7. On souhaite tester l’effet du schéma thérapeutique sur la diminution de l’hémoglobine après ajustement sur l’âge et l’insuffisance rénale. Comment y répondre ? Le réaliser et conclure.

1. Sommes des carrés expliquées

Le modèle nul ne contient que l’intercept, donc sa somme des carrés résiduelle est la somme des carrés totale : \[ SCT=207{,}0 \]

Pour un modèle donné : \[ SCT = SCR + SCE \iff SCE=SCT-SCR, \] d’où : \[ SCE_{\mathcal M_R}=207{,}0-182{,}5=24{,}5 \] et \[ SCE_{\mathcal M_C}=207{,}0-175{,}0=32{,}0 \]

2. Coefficients de détermination

D’une part, \[ R^2_{\mathcal M_R} =1-\frac{182{,}5}{207{,}0} =0{,}118, \] soit environ 11,8 % de la variabilité de la diminution d’hémoglobine expliquée par l’âge et l’insuffisance rénale.

D’autre part, \[ R^2_{\mathcal M_C} =1-\frac{175{,}0}{207{,}0} =0{,}155, \] soit environ 15,5 % expliqués par le schéma, l’âge et l’insuffisance rénale.

L’ajout du schéma augmente le \(R^2\) d’environ \(15{,}5-11{,}8=3{,}7\) points.

3. Écriture du modèle

Avec A comme catégorie de référence, on crée deux indicatrices : \[ I_B=\mathbb 1(\mathrm{schéma}=B) \text{ et } I_C=\mathbb 1(\mathrm{schéma}=C) \]

Si \(\mathrm{AGE}_{10}\) est l’âge exprimé par tranches de 10 ans et \(\mathrm{IR}=1\) en cas d’insuffisance rénale, alors le modèle s’écrit : \[ \mathbb E(Y\mid I_B,I_C,\mathrm{AGE}_{10},\mathrm{IR}) =\beta_0+\beta_BI_B+\beta_CI_C +\beta_A\mathrm{AGE}_{10}+\beta_R\mathrm{IR} \]

4. Coefficients des schémas

  • À âge et statut rénal identiques, le schéma B est associé à une diminution moyenne d’hémoglobine supérieure1 de 0,28 g/dL à celle du schéma A. L’IC 95 % \([0{,}05\, ; \,0{,}51]\) exclut zéro, donc \(p<0{,}05\).
  • Toutes choses égales par ailleurs, le schéma C est associé à une diminution moyenne supérieure2 de 0,10 g/dL à celle du schéma A. L’IC \([-0{,}15\, ; \,0{,}35]\) contient zéro, donc \(p>0{,}05\).

5. Pourquoi ne pas coder A = 1, B = 2 et C = 3 ?

Utiliser ce code comme une variable quantitative imposerait deux hypothèses injustifiées :

  • un ordre naturel A \(<\) B \(<\) C ;
  • des écarts égaux, de sorte que la différence C-B serait contrainte à être identique à la différence B-A.

Les schémas sont des catégories nominales. Nos deux indicatrices nous permettent alors d’estimer séparément B-A et C-A sans imposer cette structure artificielle.

6. Test global de tous les prédicteurs

On compare le modèle complet \(\mathcal M_C\) au modèle nul \(\mathcal M_0\) : \[ H_0:\beta_B=\beta_C=\beta_A=\beta_R=0, \] contre l’alternative qu’au moins un de ces coefficients est non nul.

La statistique de Fisher est : \[ F =\frac{(SCR_0-SCR_C)/(ddl_0-ddl_C)} {SCR_C/ddl_C} =\frac{(207{,}0-175{,}0)/(179-175)} {175{,}0/175} =8 \]

Avec 4 et 175 degrés de liberté, \(8{,}00>F_{0{,}95\, ; \,4\, ; \,175}=2{,}42\). On rejette \(H_0\) au seuil de 5 %, donc \(p<0{,}05\). L’ensemble formé par le schéma, l’âge et l’insuffisance rénale apporte une information associée à la diminution d’hémoglobine.

7. Test global du schéma après ajustement

On compare le modèle réduit \(\mathcal M_R\), contenant l’âge et l’insuffisance rénale, au modèle complet \(\mathcal M_C\), qui ajoute les deux indicatrices de schéma : \[ H_0:\beta_B=\beta_C=0, \] contre \[ H_1:\text{au moins un des deux coefficients est non nul} \]

La statistique partielle vaut : \[ F=\frac{(182{,}5-175{,}0)/(177-175)}{175{,}0/175} =\frac{7{,}5/2}{1} =3{,}75 \]

Comme \(3{,}75>F_{0{,}95\, ; \,2\, ; \,175}=3{,}05\), on rejette \(H_0\), donc \(p<0{,}05\). Après ajustement sur l’âge et l’insuffisance rénale, le schéma thérapeutique est globalement associé à la diminution d’hémoglobine.

Exercice 4 - L’âge brouille-t-il les pistes ?

Une cohorte de 500 adultes est utilisée pour étudier l’association entre les déplacements actifs domicile-travail (ACTIF = 1) et l’indice de masse corporelle (IMC, en kg/m²). L’âge est envisagé comme facteur de confusion. Les chercheurs disposent des informations suivantes :

  • les participants se déplaçant activement sont, en moyenne, plus jeunes ;
  • l’IMC est plus faible chez les participants plus jeunes, et plus élevé chez les participants plus âgés.
Modèle Coefficient de ACTIF IC 95 %
Brut -1,8 [-2,4 ; -1,2]
Ajusté sur l’âge -1,1 [-1,7 ; -0,5]
  1. L’âge pourrait-il être un facteur de confusion ? Justifiez.
  2. Écrivez le modèle brut puis le modèle ajusté sur l’âge.
  3. Calculez la variation relative du coefficient de ACTIF.
  4. D’après cette variation, que pourrait-on conclure sur l’âge ?

1. Critères de confusion

Pour rappel, une variable peut être un facteur de confusion si elle est associée à l’exposition, à la variable réponse, sans être sur le chemin causal entre l’exposition et la réponse.

L’âge remplit ces trois critères :

  1. d’après ce que les chercheurs savent, il est associé à l’exposition (les participants en déplacement actif sont plus jeunes)…
  2. … et l’âge est associé à l’IMC (IMC plus faible chez les jeunes, plus élevé chez les plus âgés) ;
  3. de plus, le fait de se faire le trajet domicile-travail n’a aucun effet sur l’âge (on ne va pas rajeunir ou vieillir suivant si l’on fait ce trajet, ou non). Autrement dit, l’âge ne peut pas être causé par le déplacement actif, et n’est donc pas médiateur / sur le chemin causal entre déplacement actif et IMC.

Il est donc plausible que l’âge confonde l’association entre déplacement actif et IMC.

2. Modèles brut et ajusté

Le modèle brut est : \[ \mathbb E(\mathrm{IMC}\mid\mathrm{ACTIF}) =\beta_{0,b}+\beta_{1,b}\mathrm{ACTIF}, \] avec \(\widehat\beta_{1,b}=-1{,}8\) kg/m².

Le modèle ajusté est : \[ \mathbb E(\mathrm{IMC}\mid\mathrm{ACTIF},\mathrm{AGE}) =\beta_{0,a}+\beta_{1,a}\mathrm{ACTIF} +\beta_2\mathrm{AGE}, \] avec \(\widehat\beta_{1,a}=-1{,}1\) kg/m².

3. Variation relative

En utilisant la formule de variation relative (voir équation 1 de la section 4), on obtient : \[ VR =\frac{|\widehat\beta_{1,a}-\widehat\beta_{1,b}|} {|\widehat\beta_{1,b}|} =\frac{|-1{,}1-(-1{,}8)|}{|-1{,}8|} =\frac{0{,}7}{1{,}8} =0{,}389, \] soit 38,9 %. L’ajustement a changé de 38,9 % l’estimation du coefficient associant le déplacement actif à l’IMC.

4. Conclusion

La variation dépasse largement les seuils exploratoires de 10 % ou 20 % parfois employés, et renforce donc l’idée que l’âge serait un facteur de confusion de cette association.

On rappelle que cette règle de variation relève plus d’un indicateur empirique qu’autre chose : l’âge vérifie notre définition d’un facteur, et on doit donc ajuster dessus quoi qu’il en soit.

Exercice 5 - Courez, courez, vous ne m’attraperez pas

Chez 185 patients, un programme de réadaptation respiratoire est évalué sur la variation de distance parcourue au test de marche de six minutes, en mètres. On note :

  • \(Y\) : la variation de distance parcourue ;
  • \(P=1\) pour le programme et \(P=0\) pour les soins usuels ;
  • \(S=1\) pour une maladie respiratoire sévère et \(S=0\) sinon ;
  • \(A\) : l’âge centré à 60 ans.

Le modèle avec interaction, ajusté sur l’âge, s’écrit alors simplement : \[ \mathbb E(Y\mid P,S,A) =\beta_0+\beta_1P+\beta_2S+\beta_3PS+\gamma A. \]

Notre logiciel préféré nous a fourni les estimations \(\widehat\beta_0=120\) m, \(\widehat\beta_1=34\) m, \(\widehat\beta_2=12\) m et \(\widehat\beta_3=-26\) m. On a aussi la matrice variance-covariance suivante :

Tableau 5: Matrice variance-covariance estimée des coefficients du modèle avec interaction.
Terme Intercept \(P\) \(S\) \(P\times S\) \(A\)
Intercept 64,00 -12,00 -10,00 8,00 -0,80
\(P\) -12,00 51,00 8,00 -57,00 0,40
\(S\) -10,00 8,00 49,00 -14,00 0,30
\(P\times S\) 8,00 -57,00 -14,00 94,00 -0,50
\(A\) -0,80 0,40 0,30 -0,50 0,25

P : programme de réadaptation respiratoire ; S : maladie respiratoire sévère ; A : âge centré à 60 ans.

Enfin, on donne la valeur critique \(t_{0{,}975, 180}=1{,}97\).

  1. Écrivez la moyenne attendue dans chacun des quatre groupes définis par \(P\) et \(S\), pour un âge fixé.
  2. Exprimez l’effet du programme chez les patients non sévères puis chez les patients sévères à partir des coefficients du modèle.
  3. Calculez les IC 95 % de l’effet du programme chez les patients non sévères puis chez les patients sévères.
  4. L’effet du programme est-il modifié par la sévérité de la maladie respiratoire ?
  5. Construisez ensuite un tableau destiné à un article pour présenter les résultats de l’effet du programme selon la sévérité de la maladie respiratoire.

1. Moyennes attendues dans les quatre groupes

On fixe l’âge centré \(A\) à la même valeur dans les quatre groupes.

  • Soins usuels, maladie non sévère (\(P=0,S=0\)) : \[ \mu_{00}(A)=\beta_0+\gamma A \]
  • Programme, maladie non sévère (\(P=1,S=0\)) : \[ \mu_{10}(A)=\beta_0+\beta_1+\gamma A \]
  • Soins usuels, maladie sévère (\(P=0,S=1\)) : \[ \mu_{01}(A)=\beta_0+\beta_2+\gamma A \]
  • Programme, maladie sévère (\(P=1,S=1\)) : \[ \mu_{11}(A)=\beta_0+\beta_1+\beta_2+\beta_3+\gamma A \]

2. Effet du programme selon la sévérité

Chez les patients non sévères, l’effet du programme est : \[ \mu_{10}(A)-\mu_{00}(A)=\beta_1, \] donc l’effet estimé est de 34 m.

Chez les patients sévères, il est de : \[ \mu_{11}(A)-\mu_{01}(A)=\beta_1+\beta_3, \] donc de \(34-26=8\) m.

L’effet estimé du programme est ainsi plus faible de 26 m chez les patients sévères, à âge identique.

3. Intervalles de confiance des effets

Chez les patients non sévères : \[ \operatorname{Var}(\widehat\beta_1)=51 \implies SE(\widehat\beta_1)=\sqrt{51}=7{,}14 \] Ainsi : \[ IC_{95\,\%} =34\pm1{,}97\times7{,}14 =[19{,}93\, ; \,48{,}07]\text{ m} \]

Chez les patients sévères, il faut tenir compte de la covariance : \[ \operatorname{Var}(\widehat\beta_1+\widehat\beta_3) =\operatorname{Var}(\widehat\beta_1) +\operatorname{Var}(\widehat\beta_3) +2\operatorname{Cov}(\widehat\beta_1,\widehat\beta_3) =51+94+2(-57) =31 \]

Ainsi, l’écart-type est de : \[ SE(\widehat\beta_1+\widehat\beta_3)=\sqrt{31}=5{,}57 \] d’où \[ IC_{95\,\%} =8\pm1{,}97\times5{,}57 =[-2{,}97\, ; \,18{,}97]\text{ m} \]

4. Test de l’interaction

La modification d’effet est portée par \(\beta_3\) : \[ H_0:\beta_3=0 \text{ vs. } H_1:\beta_3\neq0 \]

Son erreur standard vaut : \[ SE(\widehat\beta_3)=\sqrt{94}=9{,}70 \]

La statistique de test est : \[ t=\frac{-26}{9{,}70}=-2{,}68 \]

Le modèle estime cinq coefficients au total (intercept compris), donc il reste \(n-5=185-5=180\) degrés de liberté. Comme \(|-2{,}68|>t_{0{,}975,180}=1{,}97\), on rejette \(H_0\) au seuil de 5 %, donc \(p<0{,}05\). L’effet du programme est statistiquement modifié par la sévérité. L’interaction estimée est négative : le bénéfice moyen du programme est plus faible chez les patients sévères.

5. Tableau pour un article

Tableau 6: Effet ajusté du programme de réadaptation respiratoire sur la variation de distance au test de marche chez 185 patients, selon la sévérité de la maladie.
Sévérité Effet ajusté (mètres) IC 95 % p-valeur
Non sévère 34,0 [19,9 ; 48,1] \(<0{,}05\)
Sévère 8,0 [-3,0 ; 19,0] \(>0{,}05\)

Note : Effets ajustés sur l’âge, exprimés comme différence moyenne programme moins soins usuels. L’interaction entre le programme et la sévérité est statistiquement significative (\(p<0{,}05\)).

Exercice 6 - Les résidus mènent l’enquête

Un modèle linéaire explique une durée de récupération, en jours, à partir de quatre covariables. Il est estimé sur \(n=200\) patients et comporte \(k=5\) coefficients en comptant l’intercept. Les graphiques de diagnostic obtenus sont présentés ci-dessous.

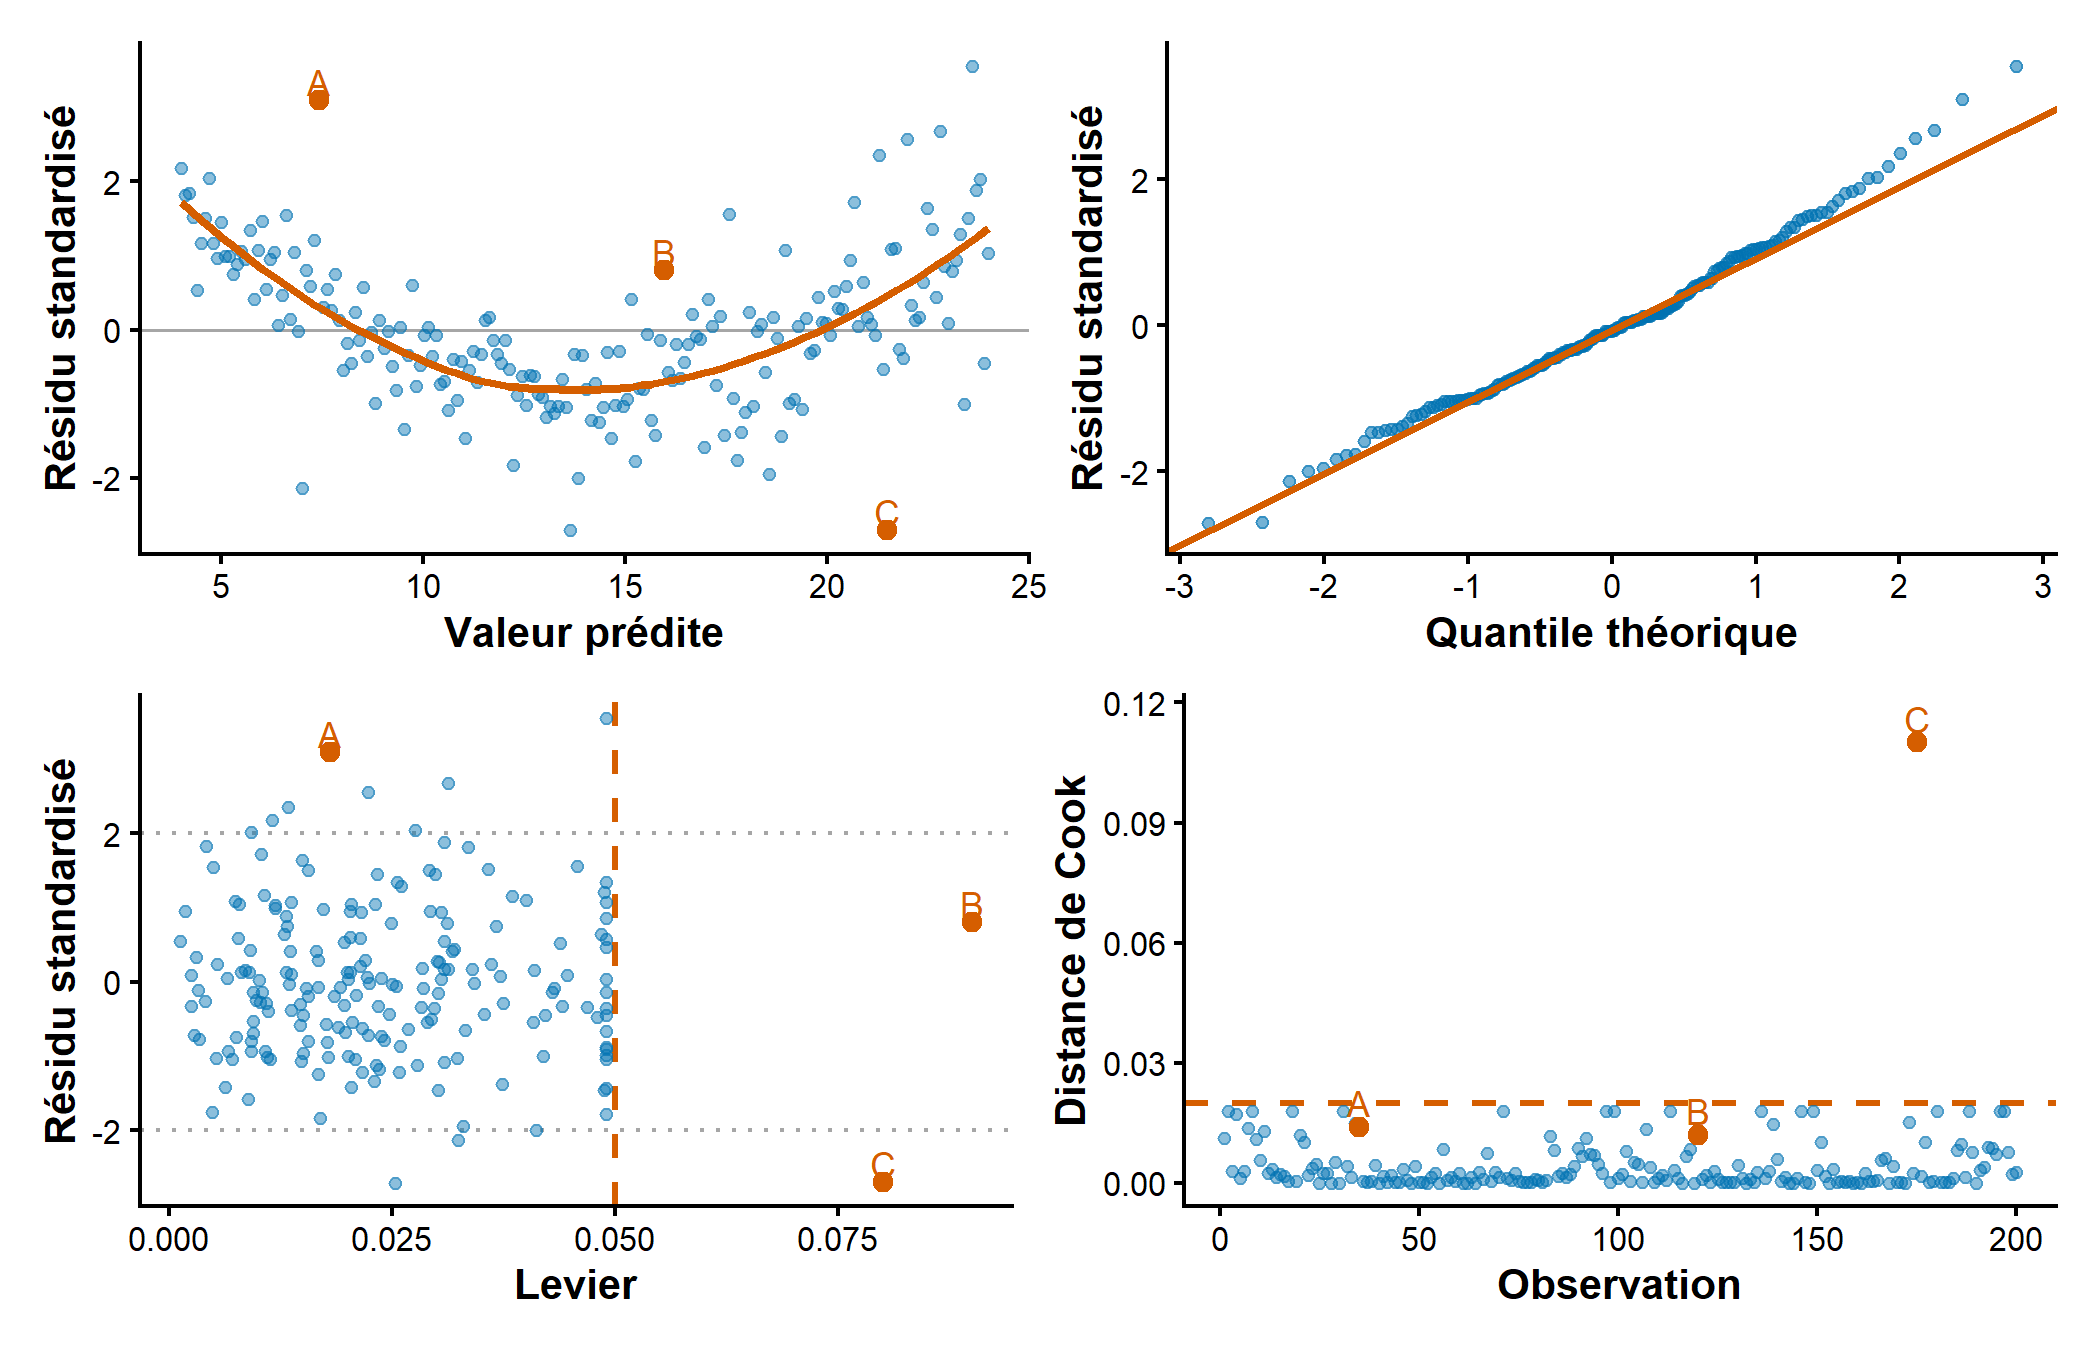
Figure 1: Graphiques de diagnostic du modèle de durée de récupération. Les observations A, B et C sont repérées en orange.

De plus, trois observations nous semblent suspectes :

Observation Résidu standardisé Levier Distance de Cook
A 3,1 0,018 0,014
B 0,8 0,090 0,012
C -2,7 0,080 0,110
  1. Sur quoi nous renseigne chacun des quatre graphiques ?
  2. Indiquez si le modèle de régression linéaire paraît adéquat pour ces données.
  3. Calculez les repères \(2k/n\) pour le levier et \(4/n\) pour la distance de Cook.
  4. Pour chaque observation, indiquez si elle est surtout atypique en \(Y\), atypique en \(X\), potentiellement influente, ou si elle cumule plusieurs de ces caractéristiques.
  5. Proposez une analyse de sensibilité permettant d’évaluer l’influence de l’observation C.

1. Rôle des quatre graphiques

  • Résidus standardisés selon les valeurs prédites. Il renseigne sur la forme de la relation et sur l’homoscédasticité. On souhaite un nuage sans structure, centré autour de zéro et d’épaisseur approximativement constante.
  • Graphique quantile-quantile. Il compare les quantiles des résidus à ceux d’une loi normale. Un alignement approximatif sur la droite soutient l’hypothèse de normalité ; des écarts dans les extrémités signalent des queues différentes ou des observations atypiques.
  • Résidus selon le levier. Le résidu repère une valeur inhabituelle en \(Y\) ; le levier repère un profil inhabituel en \(X\). Ce graphique permet d’identifier des observations atypiques en \(X\) ou en \(Y\). On considère qu’un levier supérieur à \(2k/n\) est élevé, avec \(k\) le nombre de coefficients et \(n\) le nombre d’observations.
  • Distance de Cook selon le numéro d’observation. Elle synthétise l’effet potentiel de chaque observation sur l’ensemble des coefficients. Un pic au-dessus du repère \(4/n\) correspond à une observation qui change fortement les coefficients estimés si on la retire.

2. Adéquation du modèle

  • Le graphique résidus-valeurs prédites présente une courbure en U très nette : les résidus sont positifs aux faibles et fortes valeurs prédites et négatifs au centre. La moyenne n’est donc pas correctement décrite par la forme linéaire choisie. En revanche, rien ne semble trop à redire sur la dispersion, qui semble plutôt homogène autour de la courbe orange ;

  • Le graphique quantile-quantile semble plutôt aligné avec la première bissectrice, la normalité semble donc bien respectée.

Ainsi, il faudrait changer la forme de la relation, car elle n’est pas linéaire. Pour repérer quelle variable semble problématique, il faut examiner la relation entre les résidus et chacune des covariables. Par exemple, si la non-linéarité concerne la première covariable, on peut ajouter un terme quadratique : \[ Y_i = \beta_0 + \beta_1 X_{1i} + \beta_{11}X_{1i}^2 + \beta_2X_{2i} + \beta_3X_{3i} + \beta_4X_{4i} + \varepsilon_i, \; \boldsymbol\varepsilon\mid\mathbf X\sim\mathcal N_n(\mathbf0,\sigma^2\mathbf I_n) \] où \(Y_i\) est la durée de récupération du patient \(i\) et \(X_{ki}\) est la valeur de la covariable \(k\) pour le patient \(i\).

3. Repères numériques

Avec \(k=5\) coefficients et \(n=200\) : \[ \frac{2k}{n}=\frac{2\times5}{200}=0{,}05 \] pour le levier, et : \[ \frac4n=\frac4{200}=0{,}02 \] pour la distance de Cook.

Ce sont ces repères qui sont tracés sur les graphiques (voir les traits gris) !

4. Classement des observations

Tableau 7: Diagnostic de trois observations parmi 200 patients dans le modèle de durée de récupération.
Observation Lecture détaillée Classement principal
A \(\lvert r\rvert=3{,}1>2\) ; levier \(0{,}018<0{,}05\) ; Cook \(0{,}014<0{,}02\). Très atypique en \(Y\), mais pas en \(X\) et non signalée comme influente par Cook
B \(\lvert r\rvert=0{,}8<2\) ; levier \(0{,}090>0{,}05\) ; Cook \(0{,}012<0{,}02\). Atypique en \(X\) avec fort levier, mais bien prédite et peu influente selon le repère
C \(\lvert r\rvert=2{,}7>2\) ; levier \(0{,}080>0{,}05\) ; Cook \(0{,}110>0{,}02\). Atypique en \(Y\) et en \(X\), et potentiellement très influente

5. Analyse de sensibilité pour C

De manière générale, une analyse de sensibilité consiste à vérifier si les résultats et les conclusions d’une analyse restent similaires lorsque l’on modifie certaines hypothèses ou décisions. Elle complète l’analyse principale, sans la remplacer.

Dans notre cas, une démarche possible serait :

  1. vérifier que les données de l’observation C ont été correctement saisies ;
  2. si aucune erreur n’est détectée, estimer deux modèles : l’un avec tous les patients et l’autre sans l’observation C ;
  3. comparer les estimations, les diagnostics et les conclusions obtenus avec les deux modèles ;
  4. si les résultats diffèrent sensiblement, présenter les deux analyses et discuter l’influence de l’observation C.

Notes de bas de page

  1. “Supérieure” concerne ici la variable définie comme une diminution : une valeur plus grande correspond à une perte d’hémoglobine plus importante.↩︎

  2. “Supérieure” concerne ici la variable définie comme une diminution : une valeur plus grande correspond à une perte d’hémoglobine plus importante.↩︎