2 Régression logistique binaire
On sait très bien étudier et mesurer l’association entre une exposition et un événement, alors à quoi bon s’incommoder d’un autre modèle de régression ? En outre :
- la stratification est impraticable dès lors qu’on souhaite plusieurs variables : le nombre de strates explose et certaines deviennent presque vides ;
- l’OR de Mantel-Haenszel ne permet pas d’étudier directement l’association avec une variable explicative continue (p. ex., âge), à moins de la transformer en variable catégorielle (p. ex., âge \(<50\) ans vs âge \(\geq50\) ans), ce qui entraîne une perte d’information.
2.1 Pourquoi ne pas modéliser directement la probabilité ?
Si \(Y\) vaut seulement 0 ou 1, alors : \[ \mathbb E(Y\mid X=x)=\mathbb P(Y=1\mid X=x)=p(x) \] On pourrait donc être tenté d’utiliser une régression linéaire : \[ p(x)=\beta_0+\beta_1x \]
Cette idée simple conduit au modèle de probabilité linéaire, mais elle présente trois problèmes.
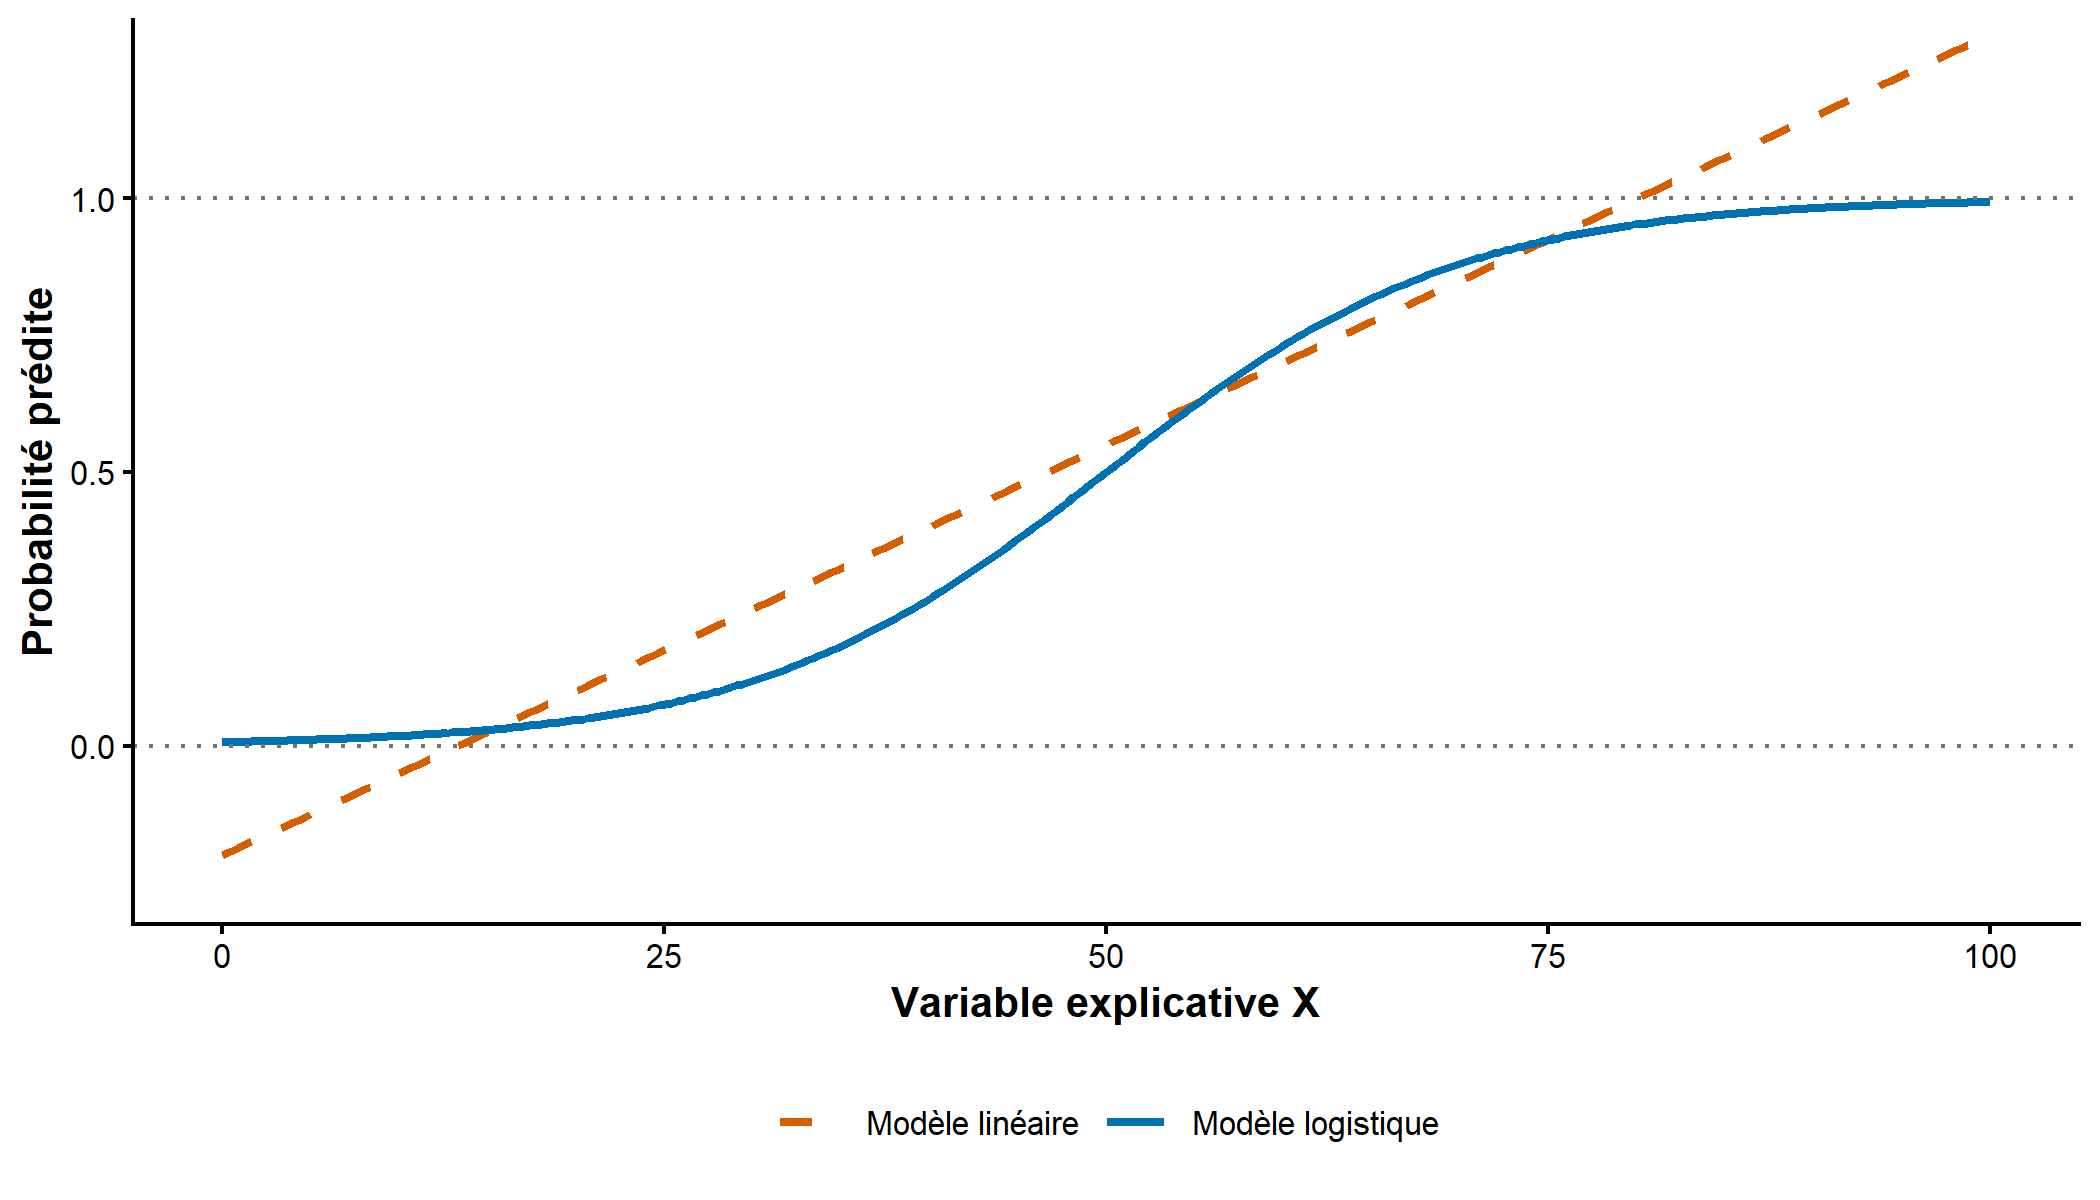
D’abord, une droite peut produire des valeurs négatives ou supérieures à 1, qui ne sont pas des probabilités. Ensuite, la variance d’une variable binaire n’est pas constante : \[ \operatorname{Var}(Y\mid X=x)=p(x)[1-p(x)], \] ce qui est incompatible avec l’hypothèse d’homoscédasticité de la régression linéaire. Enfin, une relation linéaire entre \(X\) et \(p(x)\) impose une variation absolue constante de la probabilité et ne peut pas rester valide sur une étendue illimitée de \(X\).
Malgré tout, on souhaiterait bien modéliser quelque chose qui ressemble à une probabilité, en fonction de variables explicatives \(X_1, \dots, X_p\).
Afin de motiver les prochaines notations, prenons un exemple où nous souhaitons étudier l’association entre un événement (avoir un enfant de faible poids de naissance) et une variable explicative (un score prénatal).
2.2 Dans ce cas, comment faire ?
Les illustrations qui vont suivre seront uniquement valables pour un \(X\) quantitatif ; nous présenterons le cas avec \(X\) catégoriel plus tard.
Nous avons précédemment dit qu’une droite était une mauvaise manière de modéliser le lien entre notre probabilité et une variable explicative. Malgré tout, on aimerait bien écrire le lien entre notre probabilité et notre variable, d’une façon proche de : \[ \textit{"Un truc qui ressemble à une proba"} = \beta_0 + \beta_1X_1 + \dots + \beta_pX_p \]
Pour transformer \(\textit{"Un truc qui ressemble à une proba"}\) en une quantité que l’on peut relier à une droite, on va faire deux modifications.
La première est de passer de la probabilité à la cote \(p/(1-p)\), qui varie entre 0 et \(+\infty\)
-
La seconde est de prendre le logarithme de cette cote. On obtient alors la fonction logit, définie par : \[ \operatorname{logit}(p)=\log\left(\frac{p}{1-p}\right) \] La fonction logit transforme une probabilité strictement comprise entre 0 et 1 en une valeur comprise entre \(-\infty\) et \(+\infty\), que l’on peut relier à un prédicteur linéaire. Sa fonction inverse ramènera ensuite ce prédicteur entre 0 et 1.
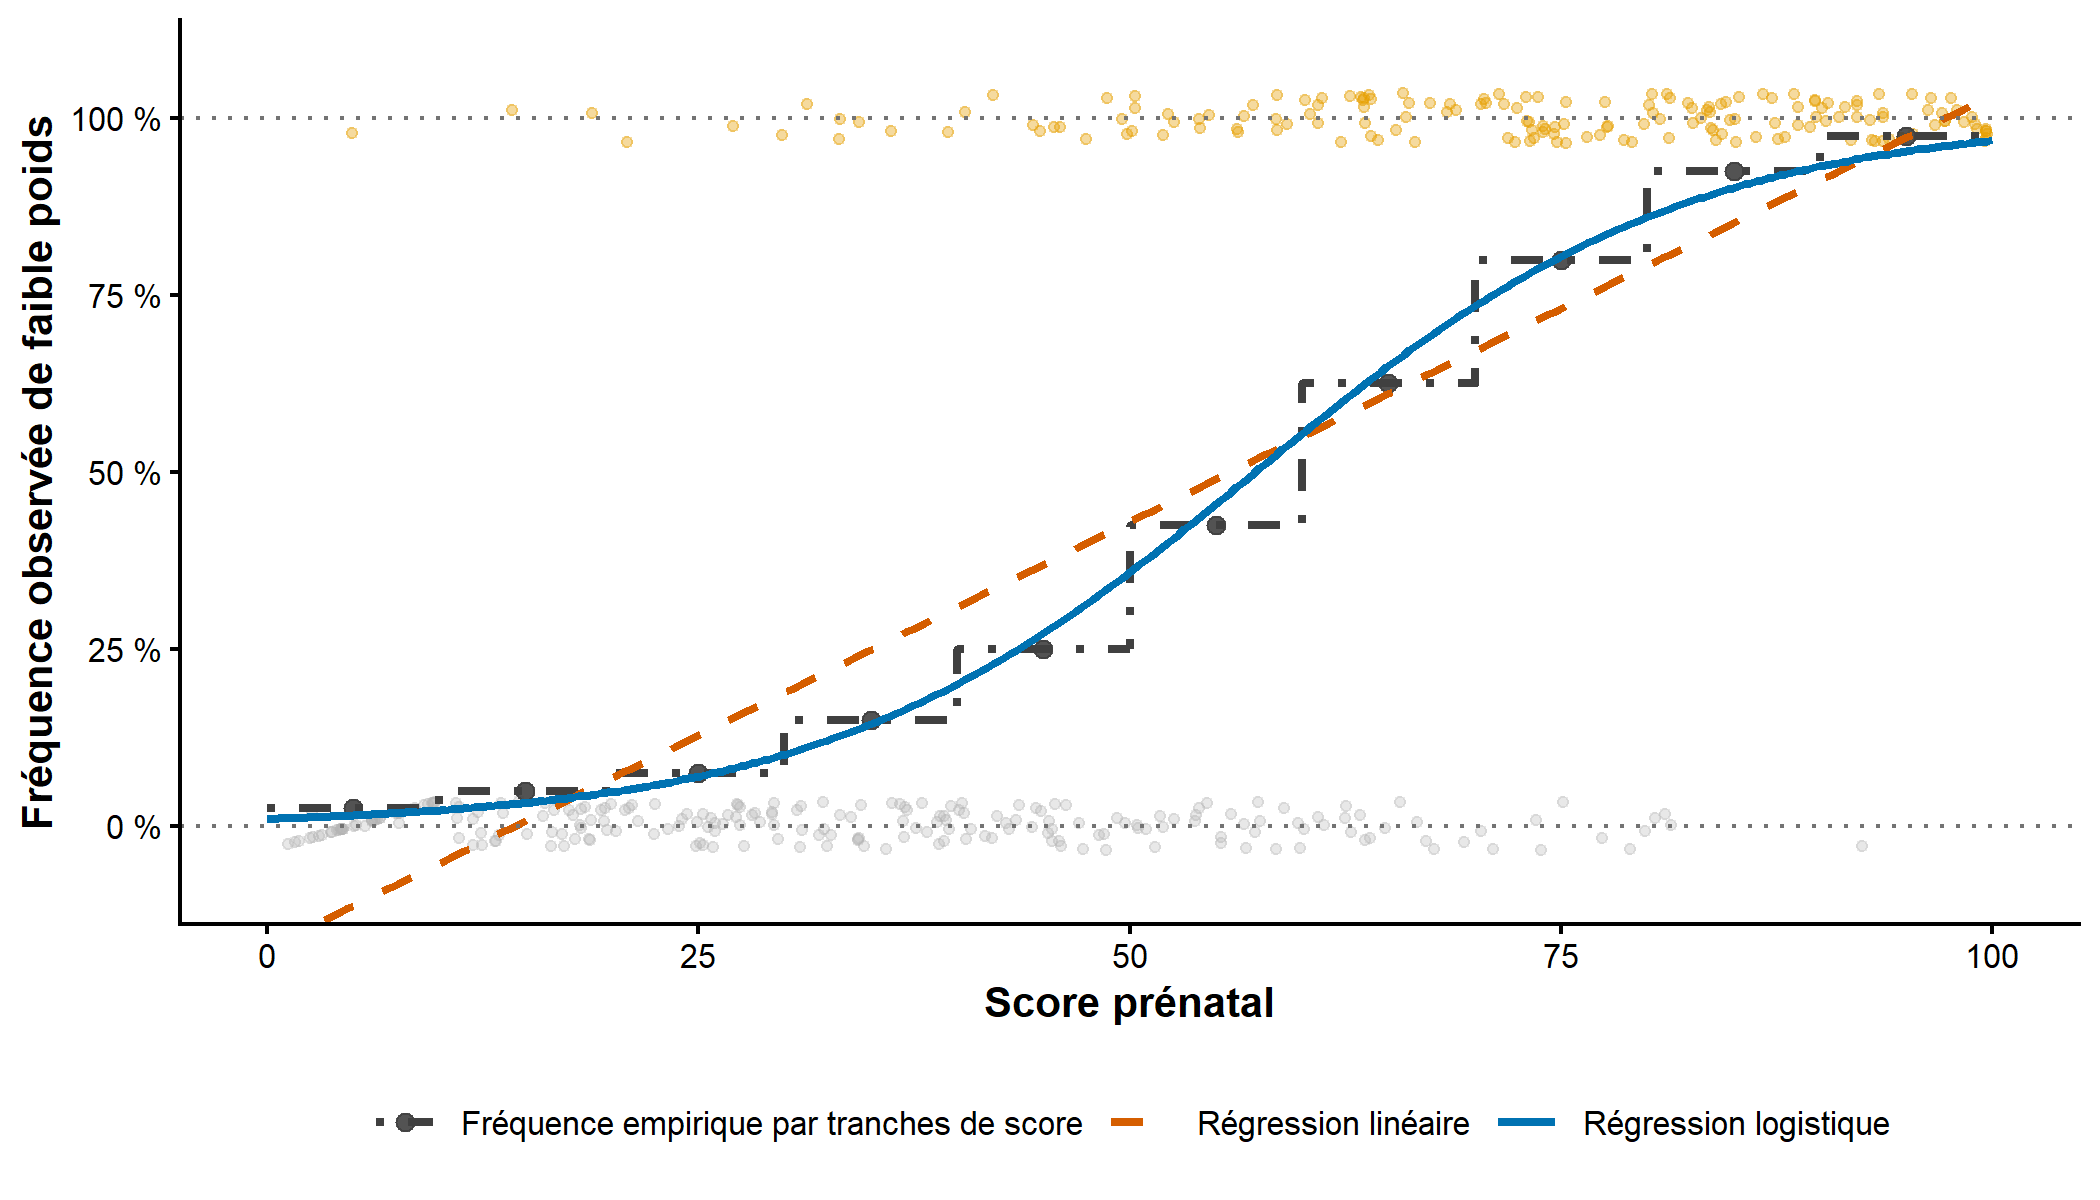
Pour illustrer cela, on présente dans la Figure 2 comment la régression logistique et la fonction linéaire se comportent sur notre exemple. On a regroupé les individus par tranches du score prénatal afin de calculer la fréquence d’événement dans chaque tranche (\(=\tfrac{\text{nombre d'événements } Y=1}{\text{nombre de personnes dans la tranche}}\)). Un modèle adéquat doit décrire raisonnablement cette tendance empirique, sans produire de probabilités impossibles.
On a donc transformé la probabilité en cote, puis la cote en log-cote. Cette dernière peut prendre n’importe quelle valeur réelle, comme… le prédicteur d’une régression linéaire !
La courbe logistique a notamment été étudiée par Pierre-François Verhulst en 1845 pour décrire la croissance d’une population (Verhulst 1845). Joseph Berkson a ensuite proposé le nom “logit” pour le logarithme de la cote en 1944 (Berkson 1944).
Ces deux points mis ensemble, \(\textit{"Un truc qui ressemble à une proba"}\) devient : \[ \textit{"Un truc qui ressemble à une proba"} = \mathrm{logit}(p) = \log{\left(\frac{p}{1-p}\right)} = \beta_0 + \beta_1 X_1 + \dots + \beta_p X_p \]
Ainsi, en régression logistique, on ne modélise pas directement la probabilité, mais le logarithme de la cote. Cependant, on peut passer de la cote vers la probabilité ! En notant \(o\) la cote : \[ o = \frac{p}{1-p} \iff o(1-p) = p \iff o = p + op \iff o = p(1+o) \iff p=\frac{o}{1+o} \] Si on note \(\eta = \mathrm{logit}(p) = \log\left(\tfrac{p}{1-p}\right)= \beta_0 + \beta_1X_1 + \dots + \beta_p X_p\), alors \(o=e^\eta\) et donc : \[ p=\frac{e^\eta}{1+e^\eta} \] Cette dernière formule est la fonction logistique, qui transforme une valeur quelconque de \(\eta\) en une probabilité strictement comprise entre 0 et 1 !
Enfin, si on note \(p_1=\mathbb P(Y=1\mid E=1)\) la probabilité d’avoir l’événement si on est exposé, et \(p_0=\mathbb P(Y=1\mid E=0)\) la probabilité d’avoir l’événement si on est non-exposé, alors : \[ \log(OR) =\log\left(\frac{p_1 / (1-p_1)}{p_0 / (1-p_0)}\right) =\log\left(\frac{p_1}{1-p_1}\right)-\log\left(\frac{p_0}{1-p_0}\right) =\operatorname{logit}(p_1)-\operatorname{logit}(p_0) \]
Ainsi, on peut retrouver l’odds ratio présenté au début grâce à notre modèle !
On espère que ce qui a été présenté juste avant est clair ; sinon, à partir de maintenant, il faudra nous faire confiance.
2.3 Écriture du modèle logistique simple
David Cox publie en 1958 un article de référence sur la régression pour des réponses binaires, en revenant aussi sur les travaux antérieurs (Cox 1958).
Les références
Berkson, Joseph. 1944. « Application of the Logistic Function to Bio-Assay ». Journal of the American Statistical Association 39 (227): 357‑65. https://doi.org/10.1080/01621459.1944.10500699.
Cox, David R. 1958. « The Regression Analysis of Binary Sequences ». Journal of the Royal Statistical Society: Series B (Methodological) 20 (2): 215‑32. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x.
Verhulst, Pierre-François. 1845. « Recherches mathématiques sur la loi d’accroissement de la population ». Nouveaux mémoires de l’Académie royale des sciences et belles-lettres de Bruxelles 18: 1‑40. https://doi.org/10.3406/marb.1845.3438.