6 Adéquation du modèle
Pour conclure, présentons brièvement les différents outils que nous avons à disposition pour vérifier que notre modèle de régression logistique est adéquat.
6.1 Hypothèses du modèle logistique
En régression linéaire, on parlait de linéarité, d’indépendance, d’homoscédasticité et de normalité des erreurs. Or, ici, la variable réponse est binaire. Ainsi, si \(Y_i\mid \mathbf X_i \sim \mathcal{B}(p_i)\) : \[ \operatorname{Var}(Y_i\mid \mathbf X_i)=p_i(1-p_i) \] La variance dépend donc de \(p_i\) et l’homoscédasticité ne peut pas être supposée. De plus, la distribution de \(Y_i\) étant binomiale, l’hypothèse de normalité ne fait pas sens. Il nous reste alors les hypothèses d’indépendance et de linéarité (du logit).
6.2 Linéarité du logit pour les variables quantitatives
Pour les variables quantitatives (ceci n’ayant pas de sens pour les variables qualitatives), on doit vérifier la linéarité du logit. Le plus simple est d’utiliser des polynômes fractionnaires ou des splines pour modéliser la relation entre la variable quantitative et le logit, et de regarder si les coefficients des termes non linéaires sont significatifs avec un test statistique.
Ces notions seront abordées dans un chapitre ultérieur, donc nous n’y reviendrons pas ici. Ainsi, si ça paraît obscur dit comme ça, passez à la suite…
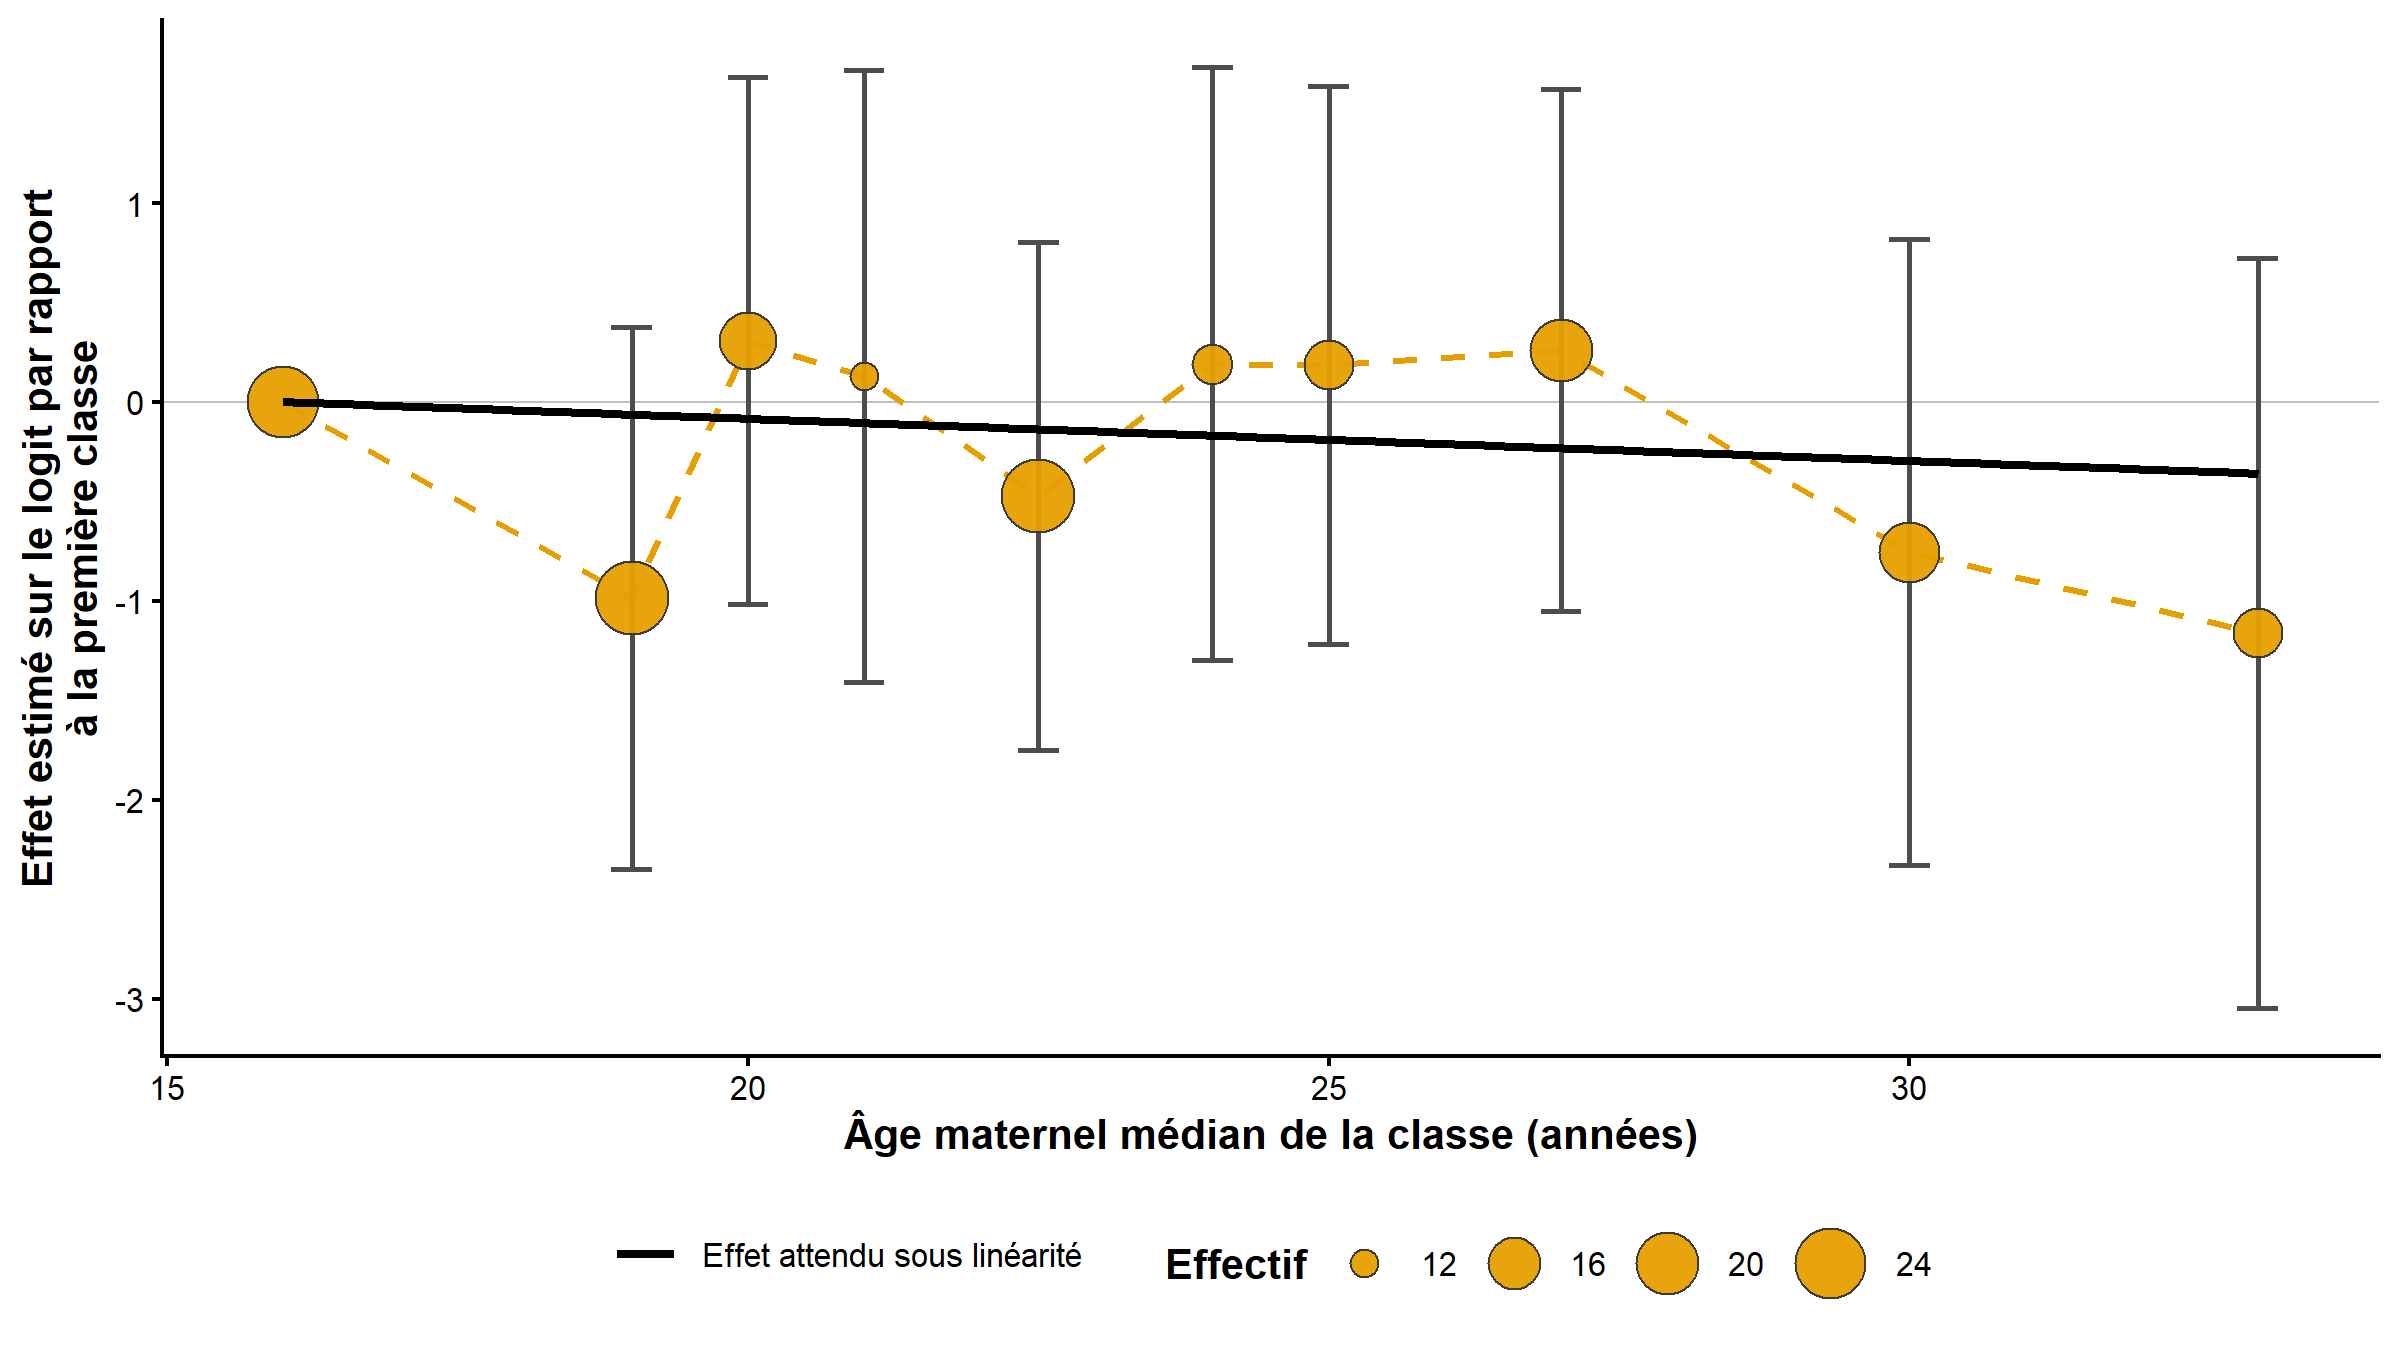
Une autre façon de faire consiste à vérifier graphiquement la linéarité du logit. L’idée est de comparer les log-odds estimés pour chaque classe d’une variable quantitative avec les log-odds estimés par le modèle avec la variable continue. Si le logit est linéaire, les points devraient suivre approximativement une droite. C’est assez fastidieux, mais si on souhaite le faire, on procède comme suit :
- On divise la variable quantitative en classes (par exemple, en quartiles ou quintiles) ;
- On estime le modèle logistique avec la nouvelle variable, en classes ;
- On récupère les log-odds estimés pour chaque classe ;
- Graphiquement, on compare ces log-odds aux log-odds du modèle avec \(X\) continu ;
- On vérifie alors que les points suivent approximativement une droite.
Note
En cas de problème, on a deux solutions. La première est de catégoriser notre variable quantitative, mais cela fait perdre de l’information. La seconde est d’utiliser des polynômes fractionnaires ou des splines.
6.3 Résidus, levier et valeurs influentes
On peut aussi regarder les trois grandes choses après avoir estimé un modèle de régression logistique :
- Les résidus de déviance sont l’équivalent des résidus mentionnés en section “Diagnostics du modèle” du chapitre Régression linéaire. Dans l’idée, un résidu éloigné de 0 est celui d’une observation que le modèle prédit mal. En pratique, ils nous seront utiles pour les deux graphiques suivants ;
- Le levier repère les profils de covariables inhabituels. Un levier élevé (>\(2k/n\), \(k\) le nombre de coefficients) signifie que l’observation est éloignée de la moyenne des covariables ;
- La distance de Cook combine le résidu et le levier. Une distance de Cook élevée (> \(4/n\)) signifie que l’observation est potentiellement influente sur les coefficients du modèle.
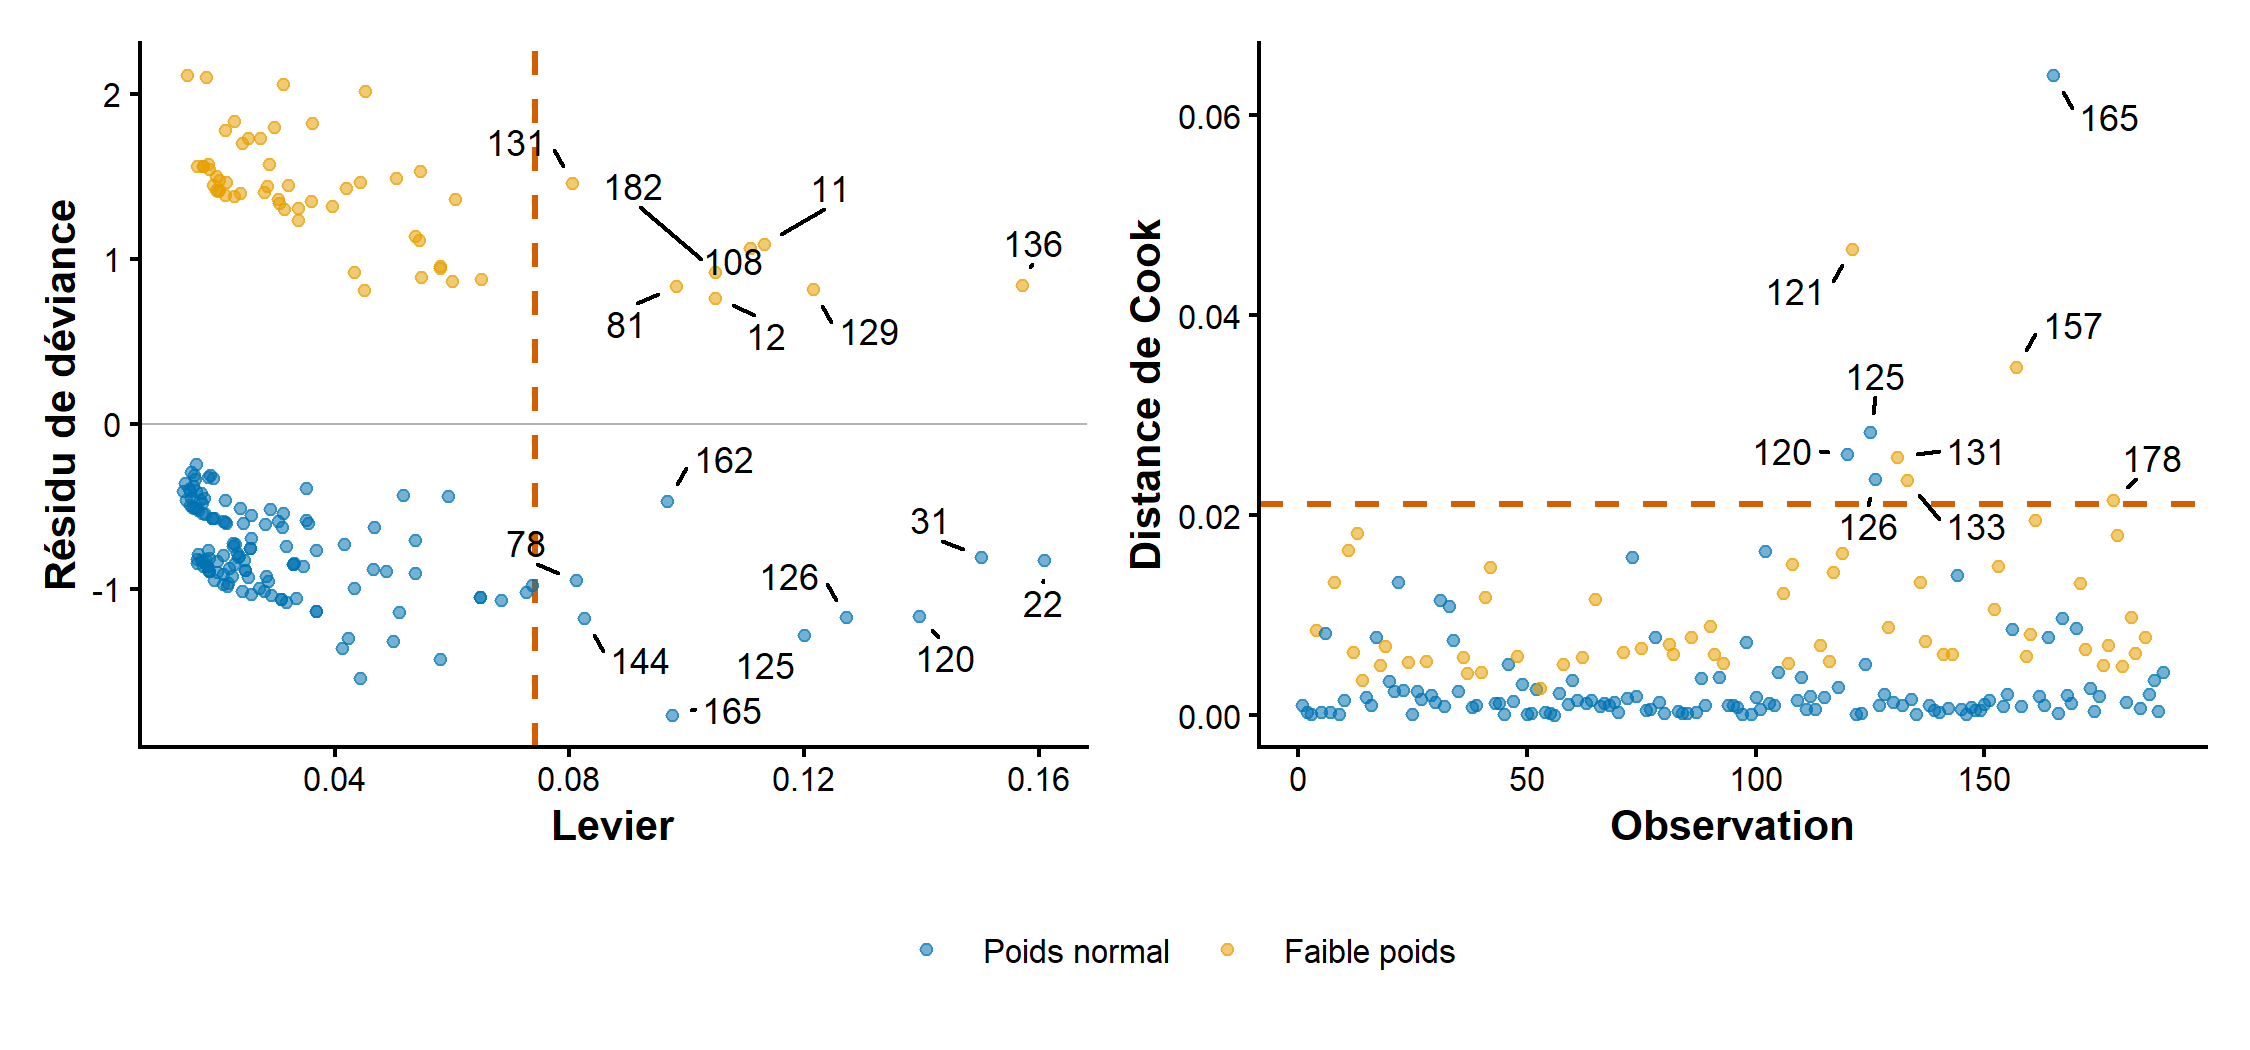
LOW ~ SMOKE + age10 + lwt10 + HT + origine. À gauche, le levier repère les profils de covariables inhabituels ; la ligne verticale pointillée indique le seuil usuel \(2k/n\), où \(k\) est le nombre de coefficients estimés. À droite, la distance de Cook aide à identifier les observations potentiellement influentes ; la ligne horizontale pointillée indique le seuil \(4/n\). On affiche les observations qui dépassent ce seuil.
- Ici, beaucoup d’observations ont un levier élevé et/ou une distance de Cook élevée. Il faudrait vérifier que ces observations ne sont pas des erreurs de saisie ou des valeurs aberrantes. Si ce n’est pas le cas, il faut se demander si elles sont représentatives de la population cible et si elles doivent être conservées dans l’analyse.
- Dans l’étude, “faible poids” est défini par un poids de naissance inférieur à 2,5 kg. On pourrait questionner ce seuil : les résultats seraient-ils différents avec un autre seuil ?
- On peut aussi se demander si des variables importantes ont été omises, et/ou si certaines variables incluses ne sont pas pertinentes !