Et avec R ?

Code
options(OutDec = ",", scipen = 999)
set.seed(67)

library(dplyr)
library(ggplot2)
library(gtsummary)
library(patchwork)

theme_gtsummary_language(
    language = "fr",
    decimal.mark = ",",
    # 95% CI separator : " - " à " ; "
    ci.sep = " ; ",
    big.mark = " "
)
theme_gtsummary_compact()

# Présentation commune des tableaux de régression
formater_estimation_table <- function(x) {
    gtsummary::style_number(x, digits = 2, decimal.mark = ",", big.mark = " ")
}
formater_ic_table <- function(x) {
    gtsummary::style_number(x, digits = 2, decimal.mark = ",", big.mark = " ")
}
formater_p_table <- function(p) {
    ifelse(is.na(p), NA_character_,
        ifelse(p < 0.001, "< 0,001", formatC(p, format = "f", digits = 3, decimal.mark = ",")))
}
presenter_table_regression <- function(tableau) {
    tableau |>
        modify_fmt_fun(c(conf.low, conf.high) ~ formater_ic_table) |>
        modify_column_merge(
            pattern = "[{conf.low} ; {conf.high}]",
            rows = !is.na(conf.low) & !is.na(conf.high)
        ) |>
        modify_header(
            label = "**Terme**", estimate = "**OR**",
            conf.low = "**IC 95 %**", p.value = "**p-valeur**"
        )
}

load("../../data/birthweight.RData")
birthweight <- data

bw <- birthweight |>
    transmute(
        faible_poids = factor(LOW, levels = c(0, 1), labels = c("Non", "Oui")),
        poids_naissance = BWT,
        age = AGE,
        age10 = AGE / 10,
        poids_mere_lb = LWT,
        poids_mere_10lb = LWT / 10,
        tabagisme = factor(SMOKE, levels = c(0, 1), labels = c("Non-fumeuse", "Fumeuse")),
        hypertension = factor(HT, levels = c(0, 1), labels = c("Non", "Oui")),
        origine = factor(RACE, levels = c(1, 2, 3), labels = c("Caucasienne", "Afro-américaine", "Autre"))
    )

# Couleurs et thème graphique
okabe_ito <- c(
    noir = "#000000",
    orange = "#E69F00",
    bleu_ciel = "#56B4E9",
    vert = "#009E73",
    jaune = "#F0E442",
    bleu = "#0072B2",
    vermillon = "#D55E00",
    rose = "#CC79A7"
)

theme_ste <- function(base_size = 10) {
    theme_classic(base_size = base_size) +
        theme(
            axis.title = element_text(face = "bold"),
            legend.position = "bottom",
            legend.title = element_text(face = "bold")
        )
}
C’est les mêmes fonctions qu’avant ! À une exception près : on doit préciser qu’on fait une régression logistique, en ajoutant family = binomial dans la fonction glm(). Dans tbl_regression(), exponentiate = TRUE transforme les coefficients de log-cotes en odds ratios (OR) et transforme aussi leurs intervalles de confiance.

Estimer un modèle

modele_logistique_complet <- glm(
    faible_poids ~ age + tabagisme + origine,
    data = bw,
    family = binomial
)

summary(modele_logistique_complet)

Call:
glm(formula = faible_poids ~ age + tabagisme + origine, family = binomial, 
    data = bw)

Coefficients:
                       Estimate Std. Error z value Pr(>|z|)   
(Intercept)            -1,00755    0,86166  -1,169  0,24228   
age                    -0,03488    0,03340  -1,044  0,29634   
tabagismeFumeuse        1,10055    0,37195   2,959  0,00309 **
origineAfro-américaine  1,01141    0,49342   2,050  0,04039 * 
origineAutre            1,05673    0,40596   2,603  0,00924 **
---
Signif. codes:  0 '***' 0,001 '**' 0,01 '*' 0,05 '.' 0,1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 234,67  on 188  degrees of freedom
Residual deviance: 218,86  on 184  degrees of freedom
AIC: 228,86

Number of Fisher Scoring iterations: 4
tbl_regression(
    modele_logistique_complet,
    exponentiate = TRUE,
    label = list(
        age ~ "Âge maternel (+1 an)",
        tabagisme ~ "Tabagisme maternel",
        origine ~ "Origine maternelle"
    ),
    estimate_fun = formater_estimation_table,
    pvalue_fun = formater_p_table
) %>%
    add_global_p(
        include = c(origine),
        type = "II",
        keep = TRUE
    ) |>
    bold_labels() |>
    presenter_table_regression() |>
    as_gt()
Odds ratios ajustés du faible poids de naissance selon les caractéristiques maternelles, étude ‘poids de naissance’.
Terme OR IC 95 % p-valeur
Âge maternel (+1 an) 0,97 [0,90 ; 1,03] 0,296
Tabagisme maternel


    Non-fumeuse — —
    Fumeuse 3,01 [1,47 ; 6,38] 0,003
Origine maternelle

0,015
    Caucasienne — —
    Afro-américaine 2,75 [1,04 ; 7,31] 0,040
    Autre 2,88 [1,32 ; 6,53] 0,009
Abréviations: IC = intervalle de confiance, OR = rapport de cotes
bw |>
    tbl_uvregression(
        y = faible_poids,
        method = glm,
        method.args = list(family = binomial),
        exponentiate = TRUE,
        include = c(age, tabagisme, origine),
        label = list(
            age ~ "Âge maternel (+1 an)",
            tabagisme ~ "Tabagisme maternel",
            origine ~ "Origine maternelle"
        ),
        estimate_fun = formater_estimation_table,
        pvalue_fun = formater_p_table
    ) %>%
    add_global_p(
        include = c(origine),
        keep = TRUE,
        type = "II"
    ) |>
    bold_labels() |>
    presenter_table_regression() |>
    as_gt()
Odds ratios bruts du faible poids de naissance selon les caractéristiques maternelles, étude ‘poids de naissance’.
Terme N OR IC 95 % p-valeur
Âge maternel (+1 an) 189 0,95 [0,89 ; 1,01] 0,105
Tabagisme maternel 189


    Non-fumeuse
— —
    Fumeuse
2,02 [1,08 ; 3,80] 0,028
Origine maternelle 189

0,082
    Caucasienne
— —
    Afro-américaine
2,33 [0,93 ; 5,77] 0,068
    Autre
1,89 [0,96 ; 3,76] 0,067
Abréviations: IC = intervalle de confiance, OR = rapport de cotes

Tester les coefficients

car::Anova(modele_logistique_complet, type = "II", test.statistic = "F")
Sum Sq Df F value Pr(>F)
age 1,112513 1 1,118811 0,2915612
tabagisme 9,265308 1 9,317761 0,0026056
origine 8,414094 2 4,230864 0,0159793
Residuals 182,964208 184 NA NA

Calculer des probabilités

Pour calculer des probabilités, le plus simple est de faire des prédictions (avec predict()), avec l’argument type = "response". L’autre solution serait de le calculer à la main, comme on a pu faire dans le cours.

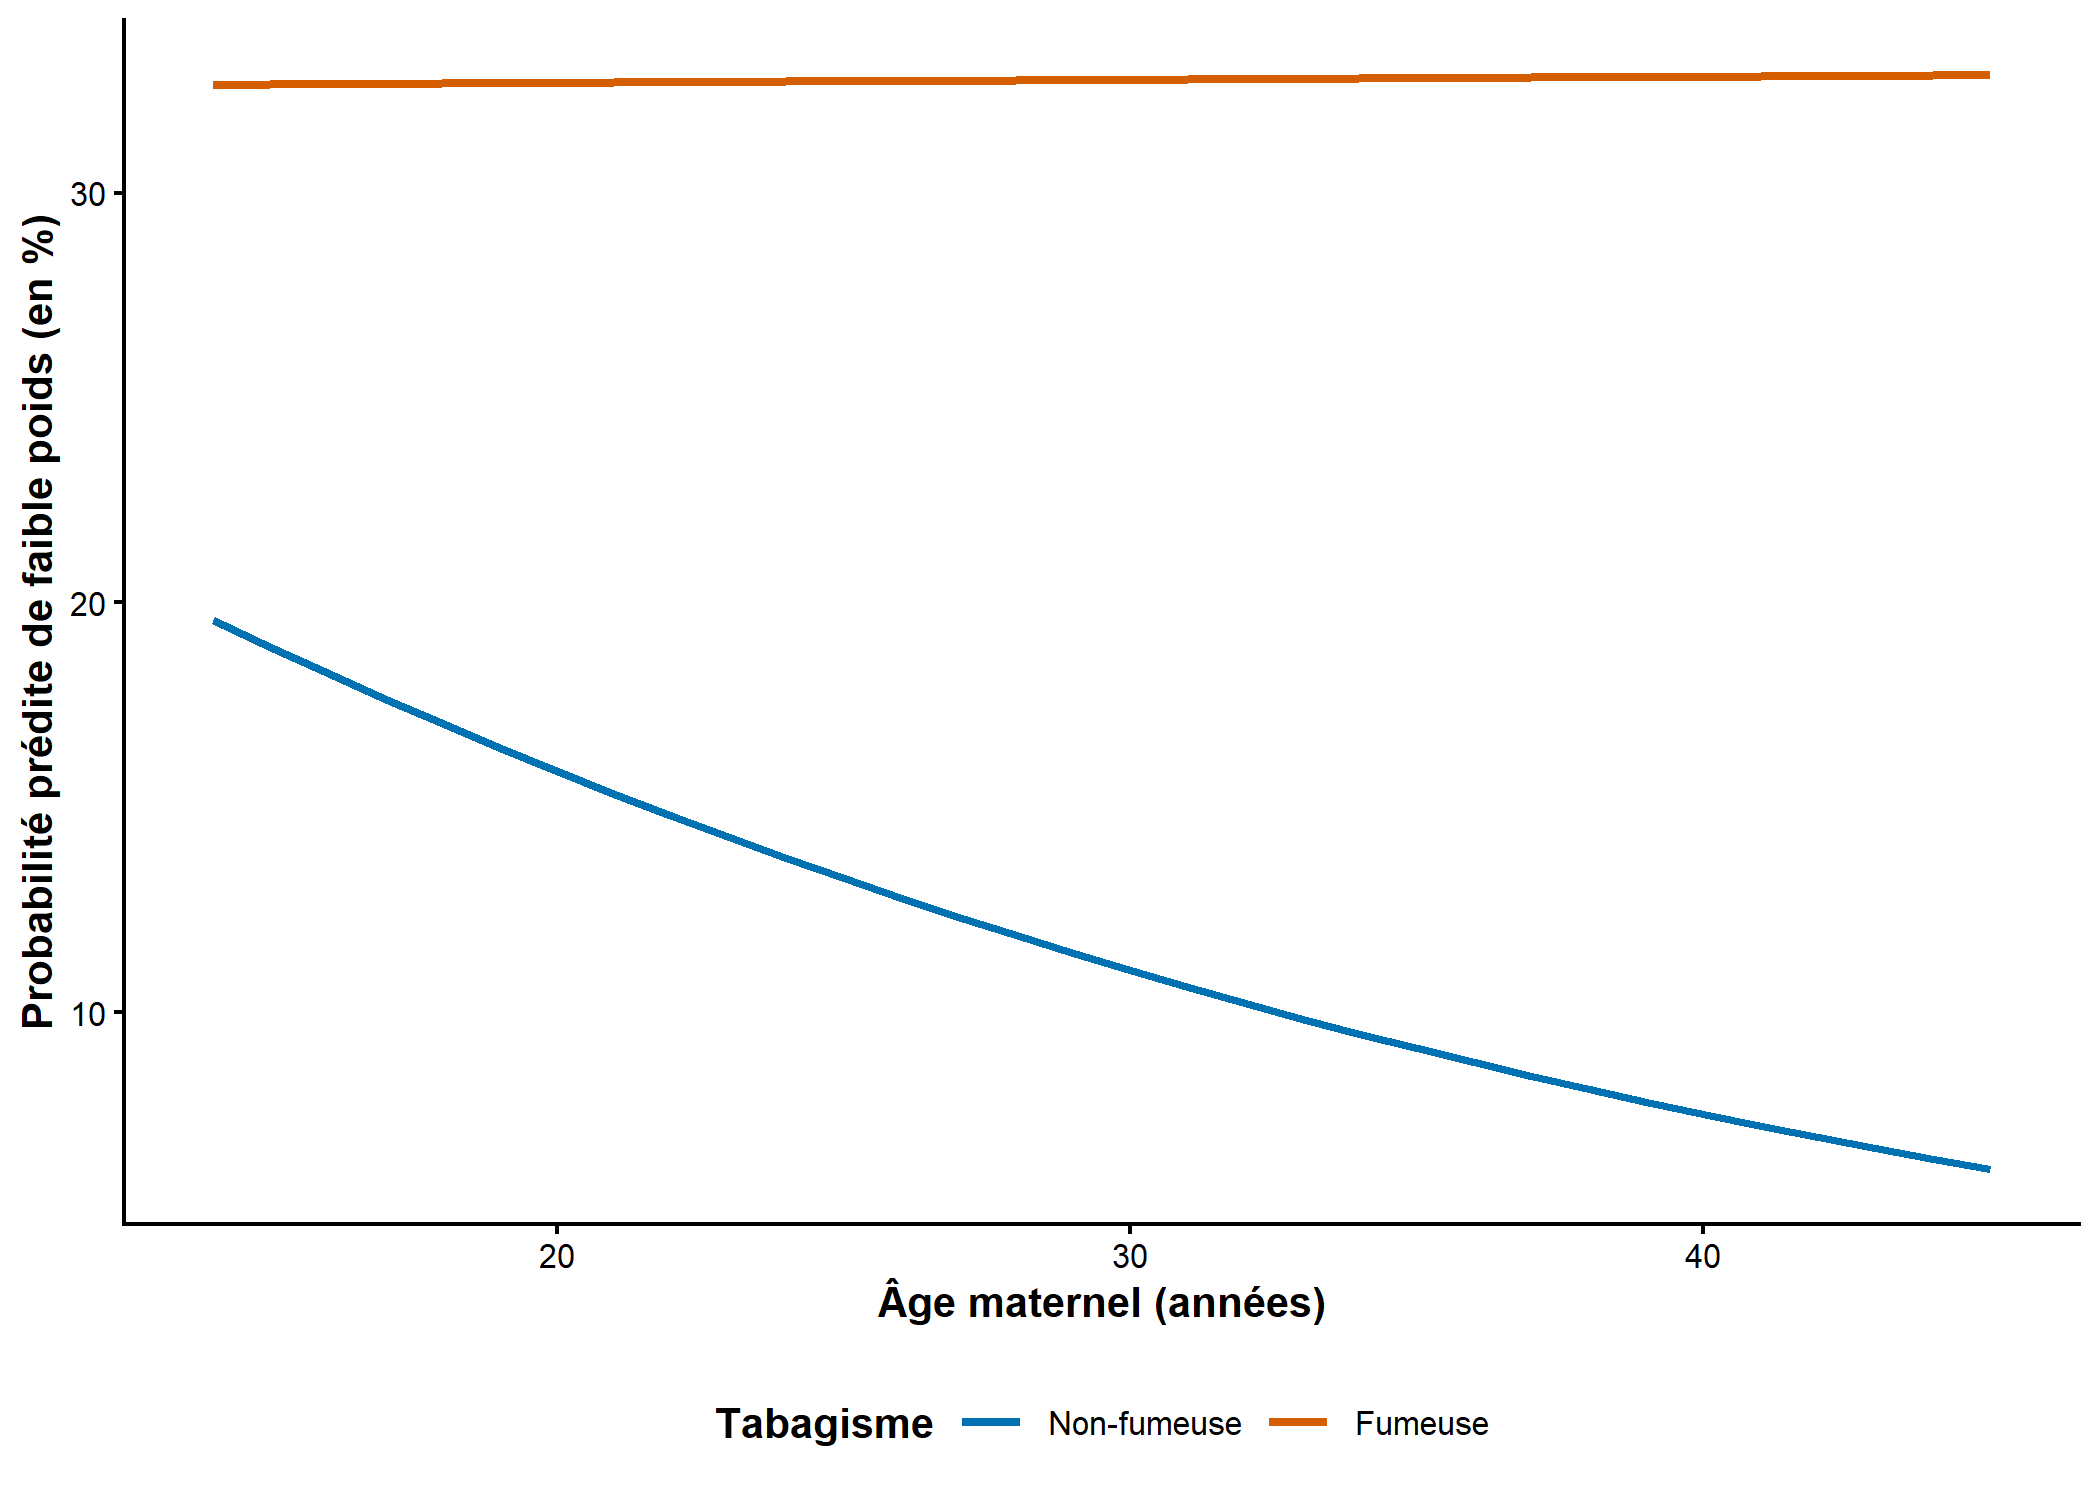
Pour l’exemple suivant, calculons la probabilité d’avoir un bébé de faible poids pour une femme caucasienne, sans hypertension, et de poids médian (donc 121 livres ici), d’âge variant de 14 ans à 45 ans (le min et le max dans notre jeu de données), séparément chez les non-fumeuses (en bleu) et les fumeuses (en vermillon).

# Modèle ajusté
modele_interaction_ajuste <- glm(
    faible_poids ~ age * tabagisme + poids_mere_lb + hypertension + origine,
    data = bw,
    family = binomial
)

profils <- expand.grid(
    age = seq(14, 45, by = 1),
    poids_mere_lb = median(bw$poids_mere_lb),
    tabagisme = levels(bw$tabagisme),
    hypertension = "Non",
    origine = "Caucasienne"
)

profils$probabilite <- predict(
    modele_interaction_ajuste,
    newdata = profils,
    type = "response"
) * 100

head(profils[, c("age", "tabagisme", "probabilite")])
age tabagisme probabilite
14 Non-fumeuse 19,56734
15 Non-fumeuse 18,91163
16 Non-fumeuse 18,27291
17 Non-fumeuse 17,65106
18 Non-fumeuse 17,04596
19 Non-fumeuse 16,45746

On peut afficher ça graphiquement :

ggplot(
    profils,
    aes(x = age, y = probabilite, colour = tabagisme)
) +
    geom_line(linewidth = 1) +
    scale_colour_manual(
        values = c(
            "Non-fumeuse" = okabe_ito[["bleu"]],
            "Fumeuse" = okabe_ito[["vermillon"]]
        )
    ) +
    labs(
        x = "Âge maternel (années)",
        y = "Probabilité prédite de faible poids (en %)",
        colour = "Tabagisme"
    ) +
    theme_ste()

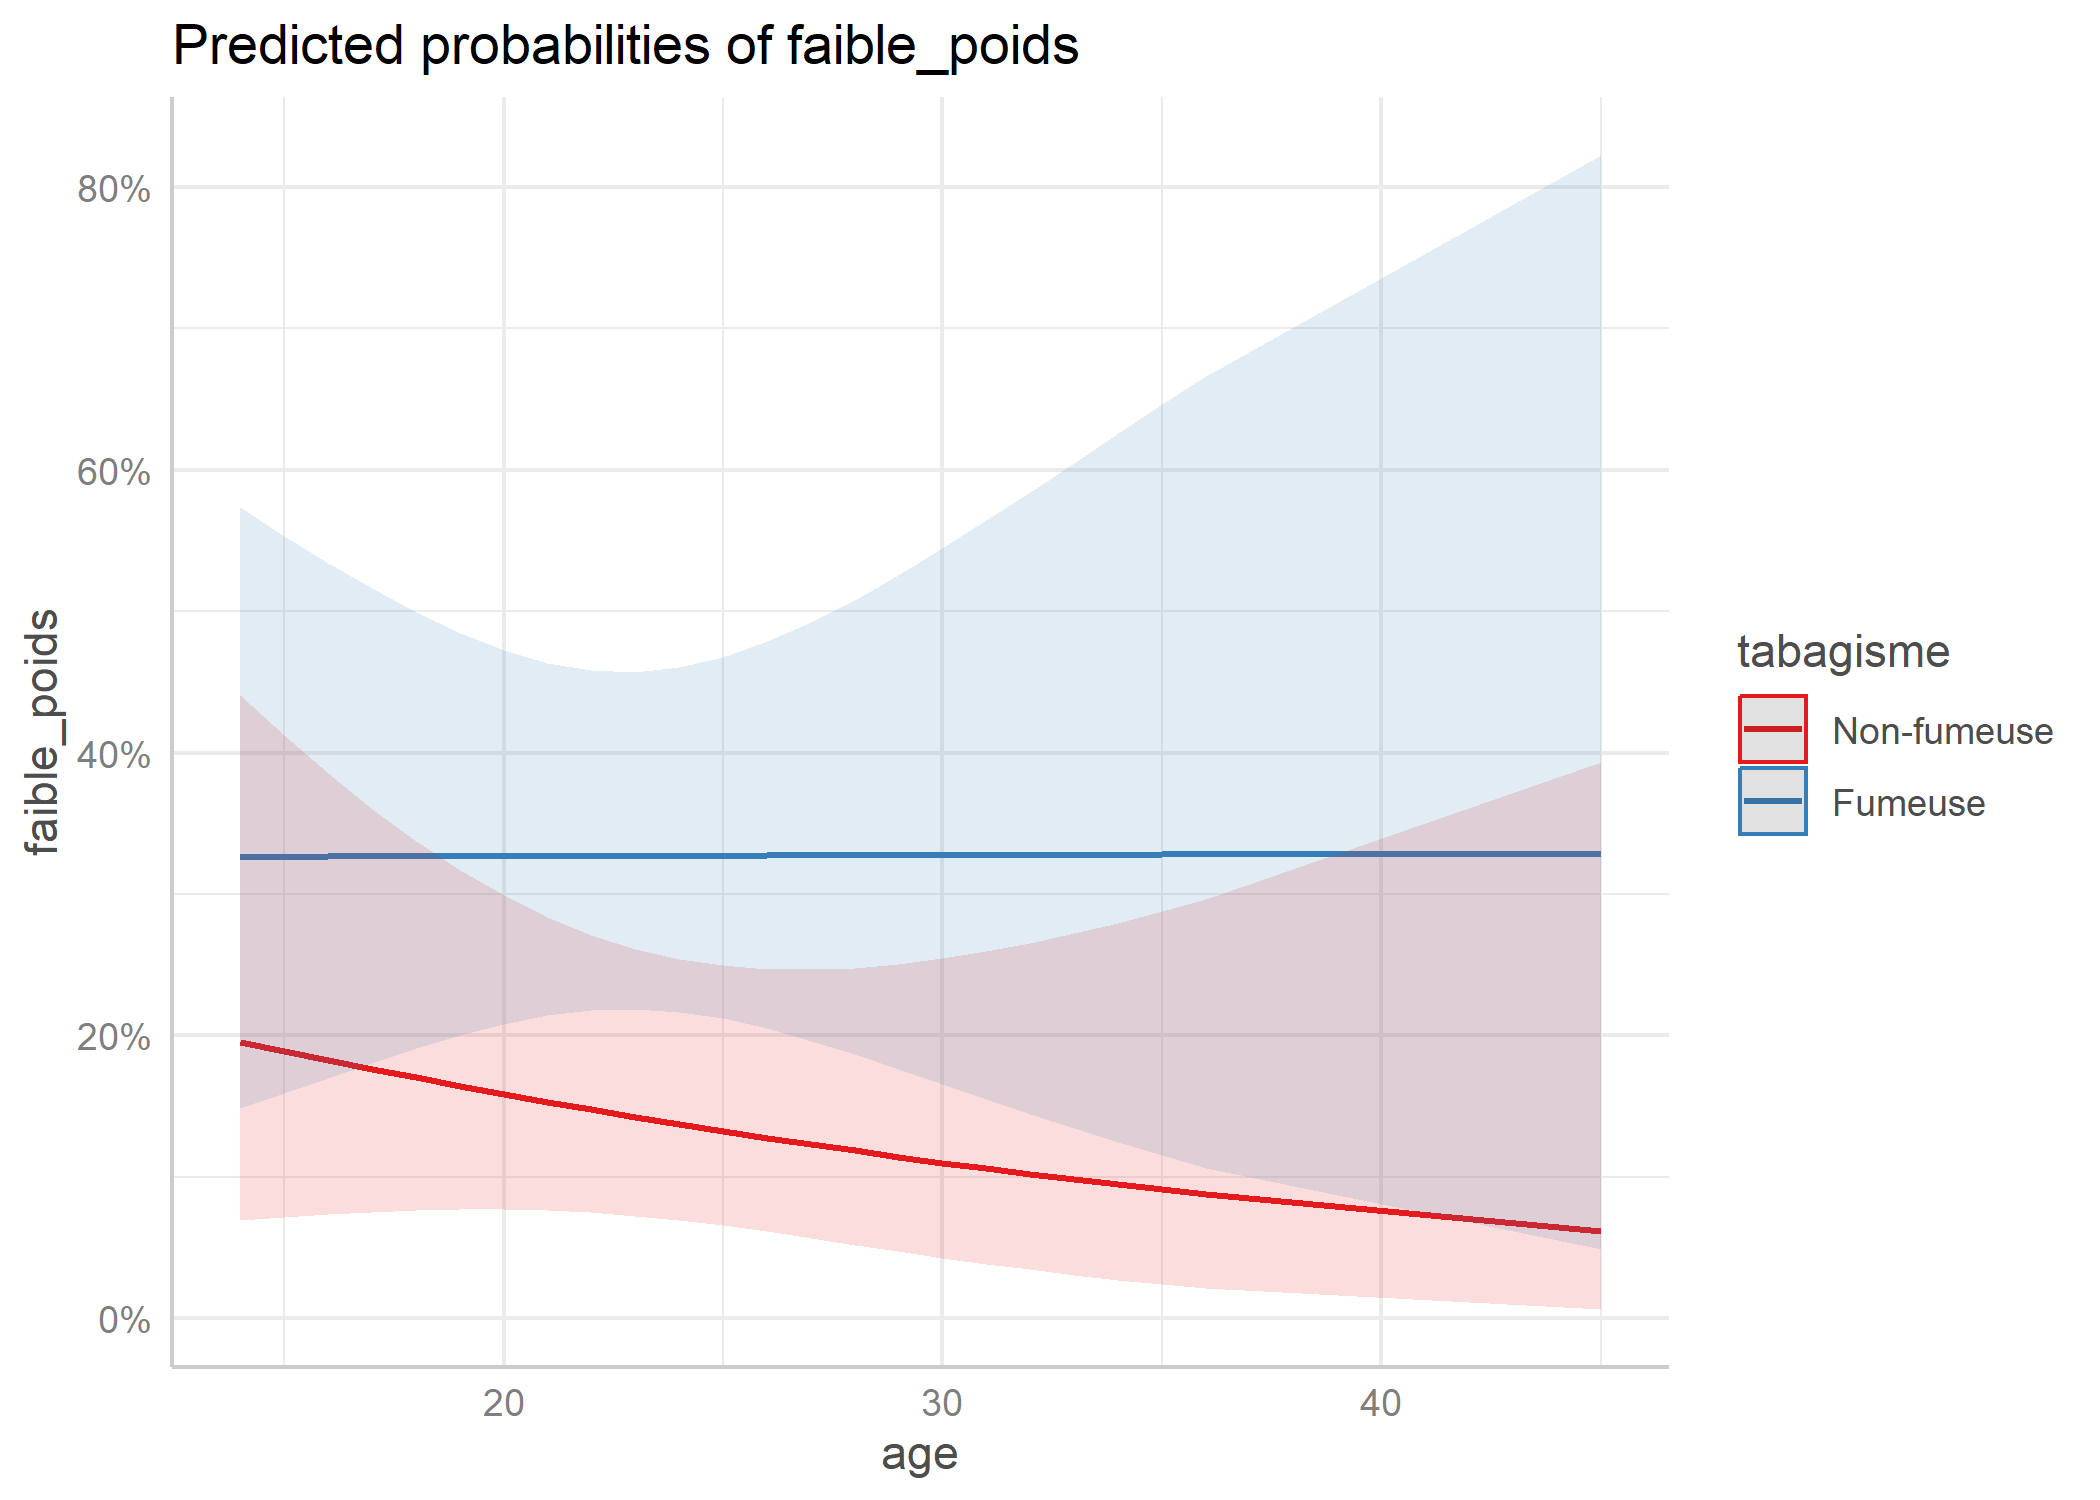
Comme tout, on peut utiliser un package pour faire cela à notre place. En l’occurrence, le package ggeffects automatise la création de profils ajustés et de leurs intervalles de confiance (ici, ce n’est pas très beau, mais au moins vous voyez l’idée) :

predictions <- ggeffects::ggpredict(
    modele_interaction_ajuste,
    # on met "nom_variable [valeur voulue]".
    # - [all] = toutes les valeurs de la variable
    # - [valeur] = valeur spécifique de la variable
    # - si rien pour var. quali., toutes les modalités sont utilisées
    terms = c("age [all]", "tabagisme")
)

plot(predictions)

Diagnostics

Selon nous, le package performance est peu pertinent pour un modèle logistique. Ainsi, on propose de regarder “à la main” les diagnostics les plus importants, à savoir la multicolinéarité, les observations influentes et la linéarité du logit.

  1. Pour la multicolinéarité (avec le VIF), on peut utiliser la fonction vif() du package car :
car::vif(modele_logistique_complet)
              GVIF Df GVIF^(1/(2*Df))
age       1,019383  1        1,009645
tabagisme 1,277382  1        1,130213
origine   1,300123  2        1,067815

Un VIF proche de 1 indique que la variable n’est pas redondante avec les autres ; un VIF inférieur à 5 est généralement rassurant, entre 5 et 10 appelle à la prudence ; et supérieur à 10 indique une colinéarité forte. Pour une variable qualitative à plusieurs degrés de liberté, on lit plutôt la colonne GVIF^(1/(2*Df)). Ici, tout semble aller.

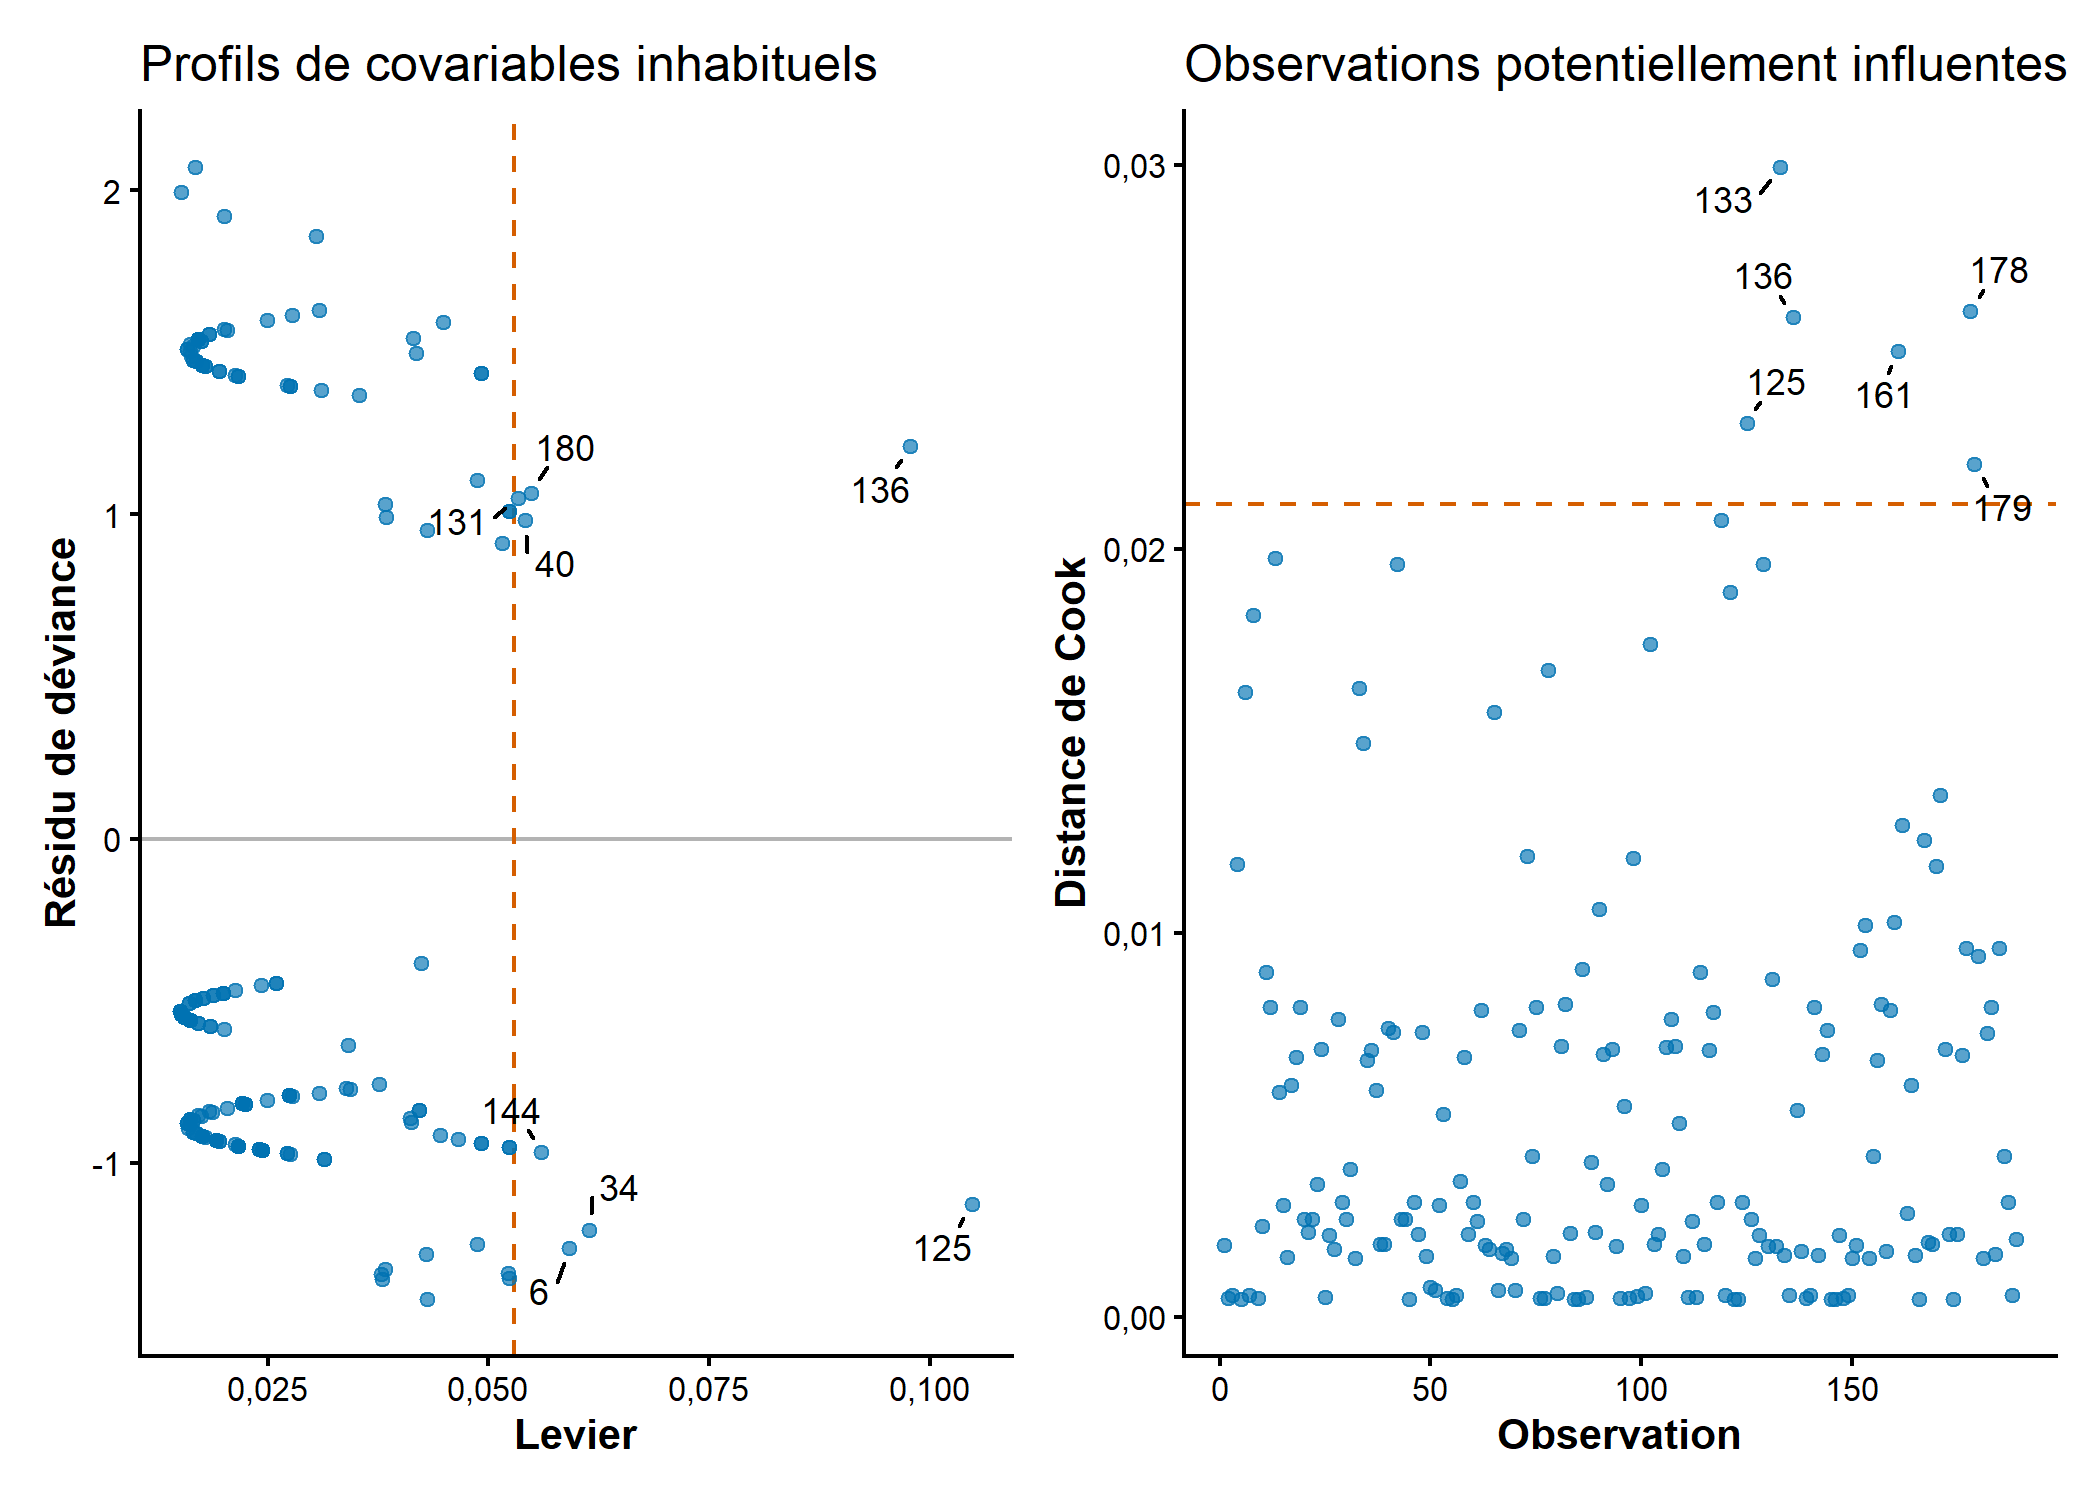
  1. Pour les observations influentes, on regarde la distance de Cook (avec le seuil \(4/n\)) et le levier (avec le seuil \(2p/n\), où \(p\) est le nombre de paramètres du modèle). Pour facilement retrouver les individus qui dépassent ces seuils, on a affiché l’indice de l’observation sur le graphique.
diag_logistique <- model.frame(modele_logistique_complet) |>
    dplyr::mutate(
        observation = dplyr::row_number(),
        probabilite_predite = fitted(modele_logistique_complet),
        residu_deviance = residuals(modele_logistique_complet, type = "deviance"),
        levier = hatvalues(modele_logistique_complet),
        distance_cook = cooks.distance(modele_logistique_complet)
    )

seuil_levier <- 2 * length(coef(modele_logistique_complet)) / nrow(diag_logistique)
seuil_cook <- 4 / nrow(diag_logistique)

p_levier <- ggplot(diag_logistique, aes(x = levier, y = residu_deviance)) +
    geom_hline(yintercept = 0, color = "grey70") +
    geom_vline(
        xintercept = seuil_levier,
        linetype = "dashed",
        color = okabe_ito[["vermillon"]]
    ) +
    geom_point(alpha = 0.65, color = okabe_ito[["bleu"]]) +
    ggrepel::geom_text_repel(
        data = dplyr::filter(diag_logistique, levier > seuil_levier),
        aes(label = observation),
        seed = 67,
        box.padding = 0.4,
        point.padding = 0.2,
        min.segment.length = 0,
        max.overlaps = Inf,
        size = 3,
        color = "black"
    ) +
    labs(
        x = "Levier",
        y = "Résidu de déviance",
        title = "Profils de covariables inhabituels"
    ) +
    theme_ste()

p_cook <- ggplot(
    diag_logistique,
    aes(x = observation, y = distance_cook)
) +
    geom_hline(
        yintercept = seuil_cook,
        linetype = "dashed",
        color = okabe_ito[["vermillon"]]
    ) +
    geom_point(alpha = 0.65, color = okabe_ito[["bleu"]]) +
    ggrepel::geom_text_repel(
        data = dplyr::filter(diag_logistique, distance_cook > seuil_cook),
        aes(label = observation),
        seed = 67,
        box.padding = 0.4,
        point.padding = 0.2,
        min.segment.length = 0,
        max.overlaps = Inf,
        size = 3,
        color = "black"
    ) +
    labs(
        x = "Observation",
        y = "Distance de Cook",
        title = "Observations potentiellement influentes"
    ) +
    theme_ste()

p_levier + p_cook

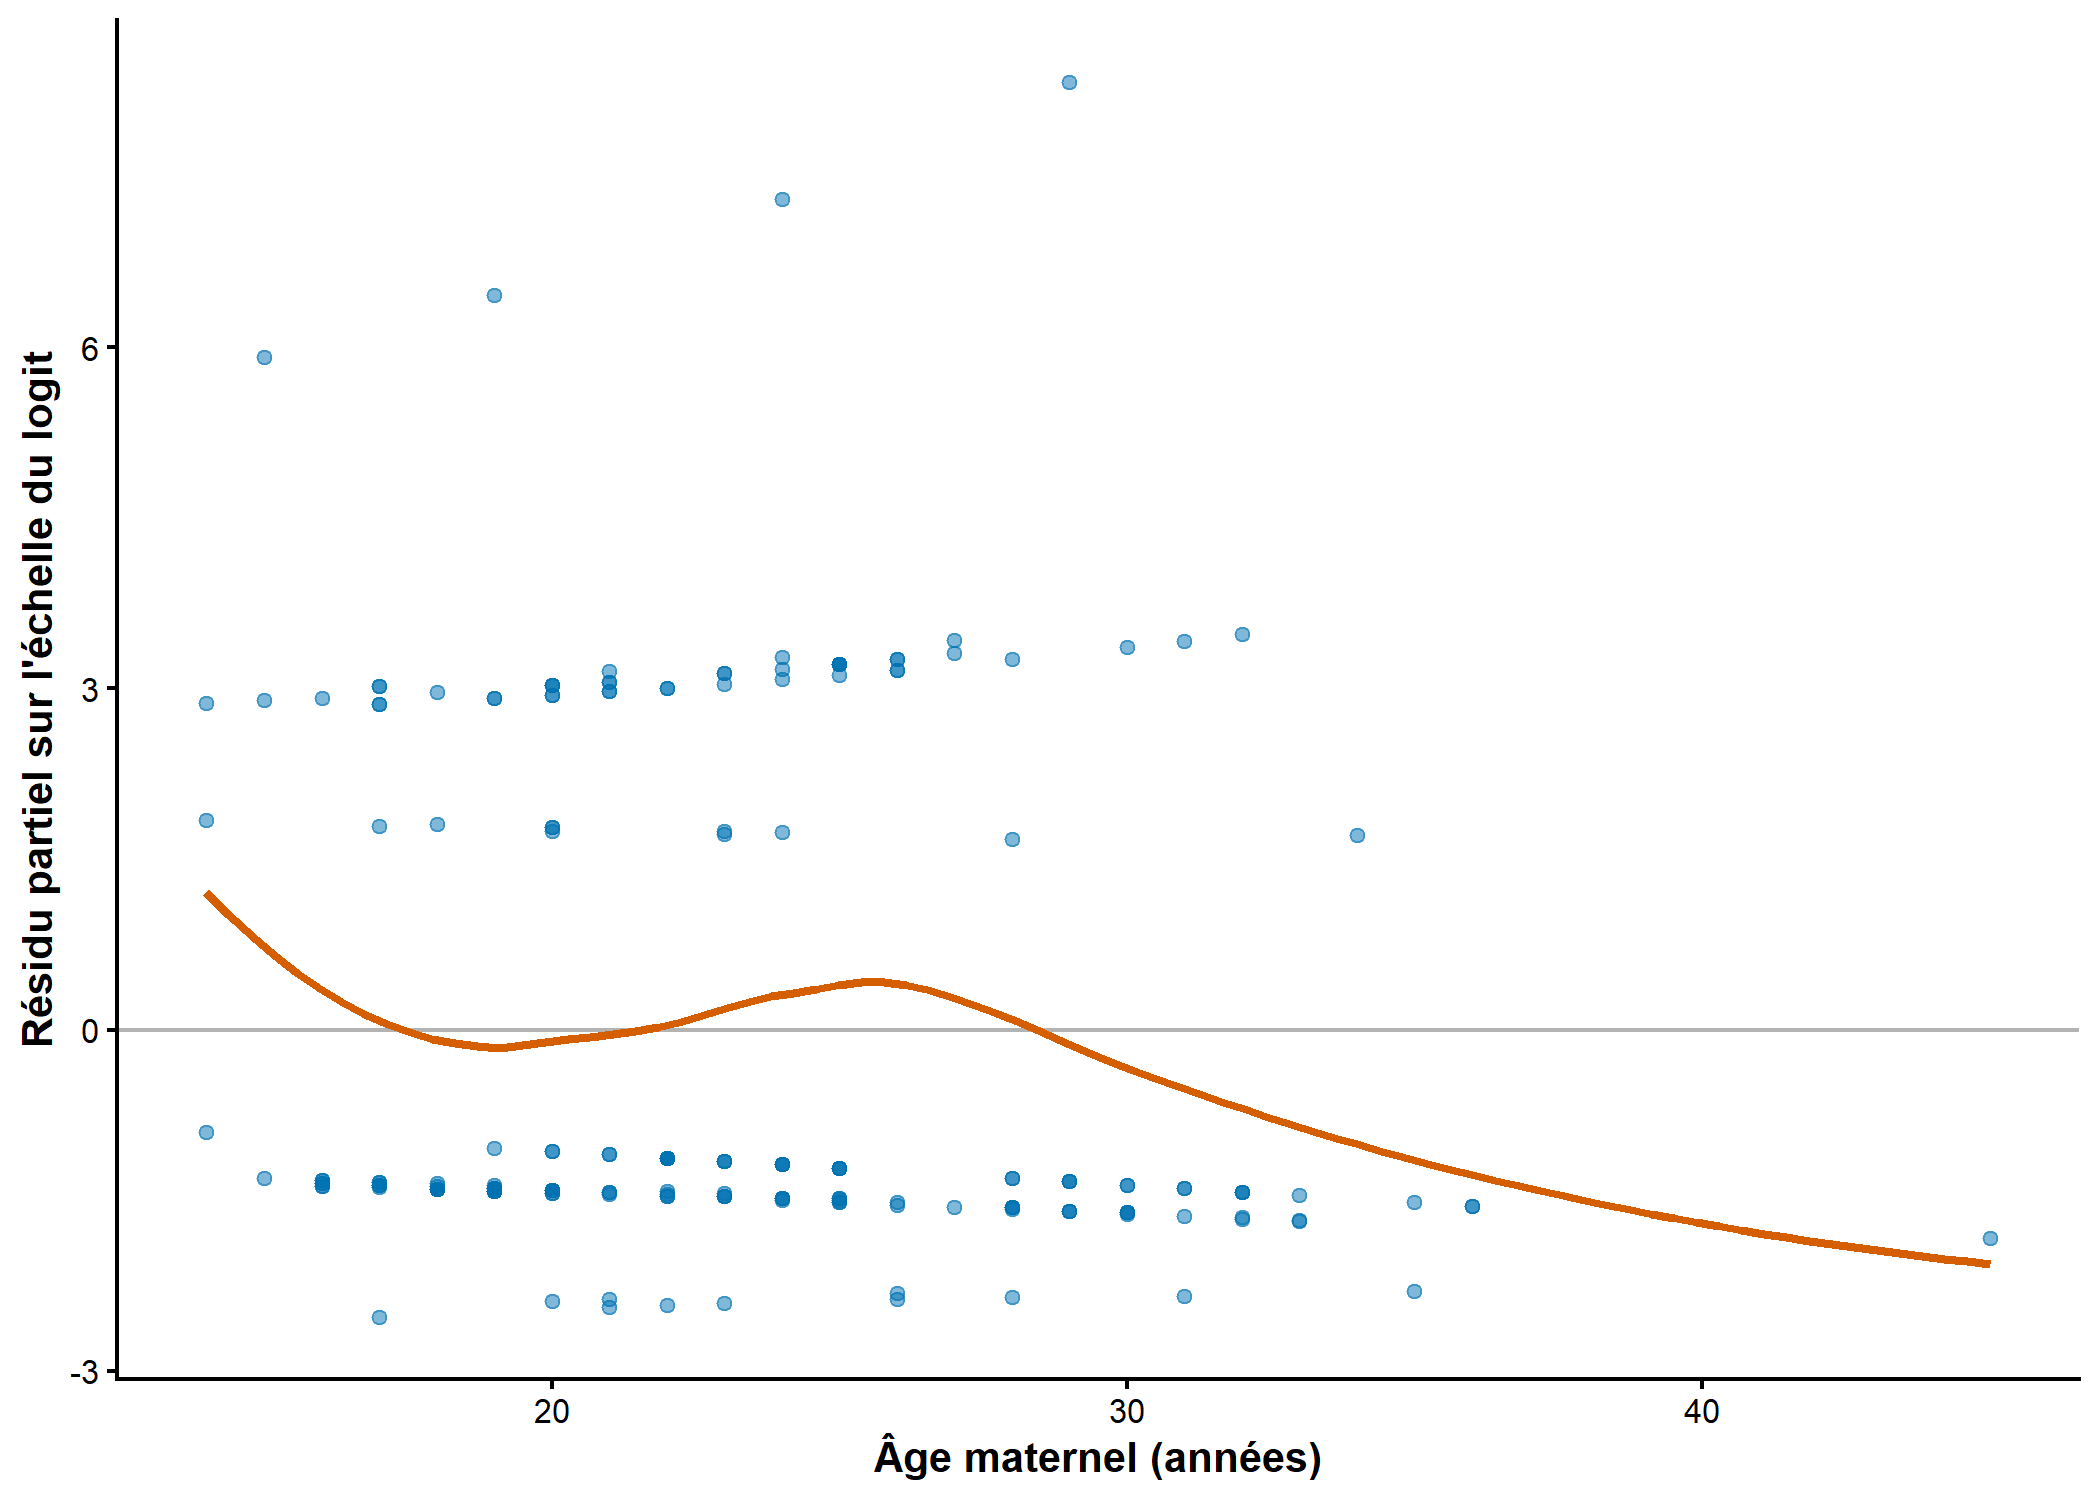
  1. Enfin, age est la seule variable quantitative du modèle, on se doit d’en vérifier l’hypothèse de linéarité du logit. Pour cela, on fait un graphique des résidus partiels en fonction des valeurs de l’âge. Si la relation est linéaire, on devrait avoir une droite (ce qui ne semble pas être le cas ici, probablement à cause de l’individu dont l’âge est d’environ 45 ans).
donnees_linearite_age <- model.frame(modele_logistique_complet) |>
    dplyr::mutate(
        effet_age = as.numeric(
            predict(
                modele_logistique_complet,
                type = "terms",
                terms = "age"
            )[, "age"]
        ),
        residu_travail = residuals(modele_logistique_complet, type = "working"),
        residu_partiel_age = effet_age + residu_travail
    )

ggplot(
    donnees_linearite_age,
    aes(x = age, y = residu_partiel_age)
) +
    geom_hline(yintercept = 0, color = "grey70") +
    geom_point(color = okabe_ito[["bleu"]], alpha = 0.5) +
    geom_smooth(
        formula = y ~ x,
        se = FALSE,
        color = okabe_ito[["vermillon"]],
        linewidth = 0.9
    ) +
    labs(
        x = "Âge maternel (années)",
        y = "Résidu partiel sur l'échelle du logit"
    ) +
    theme_ste()

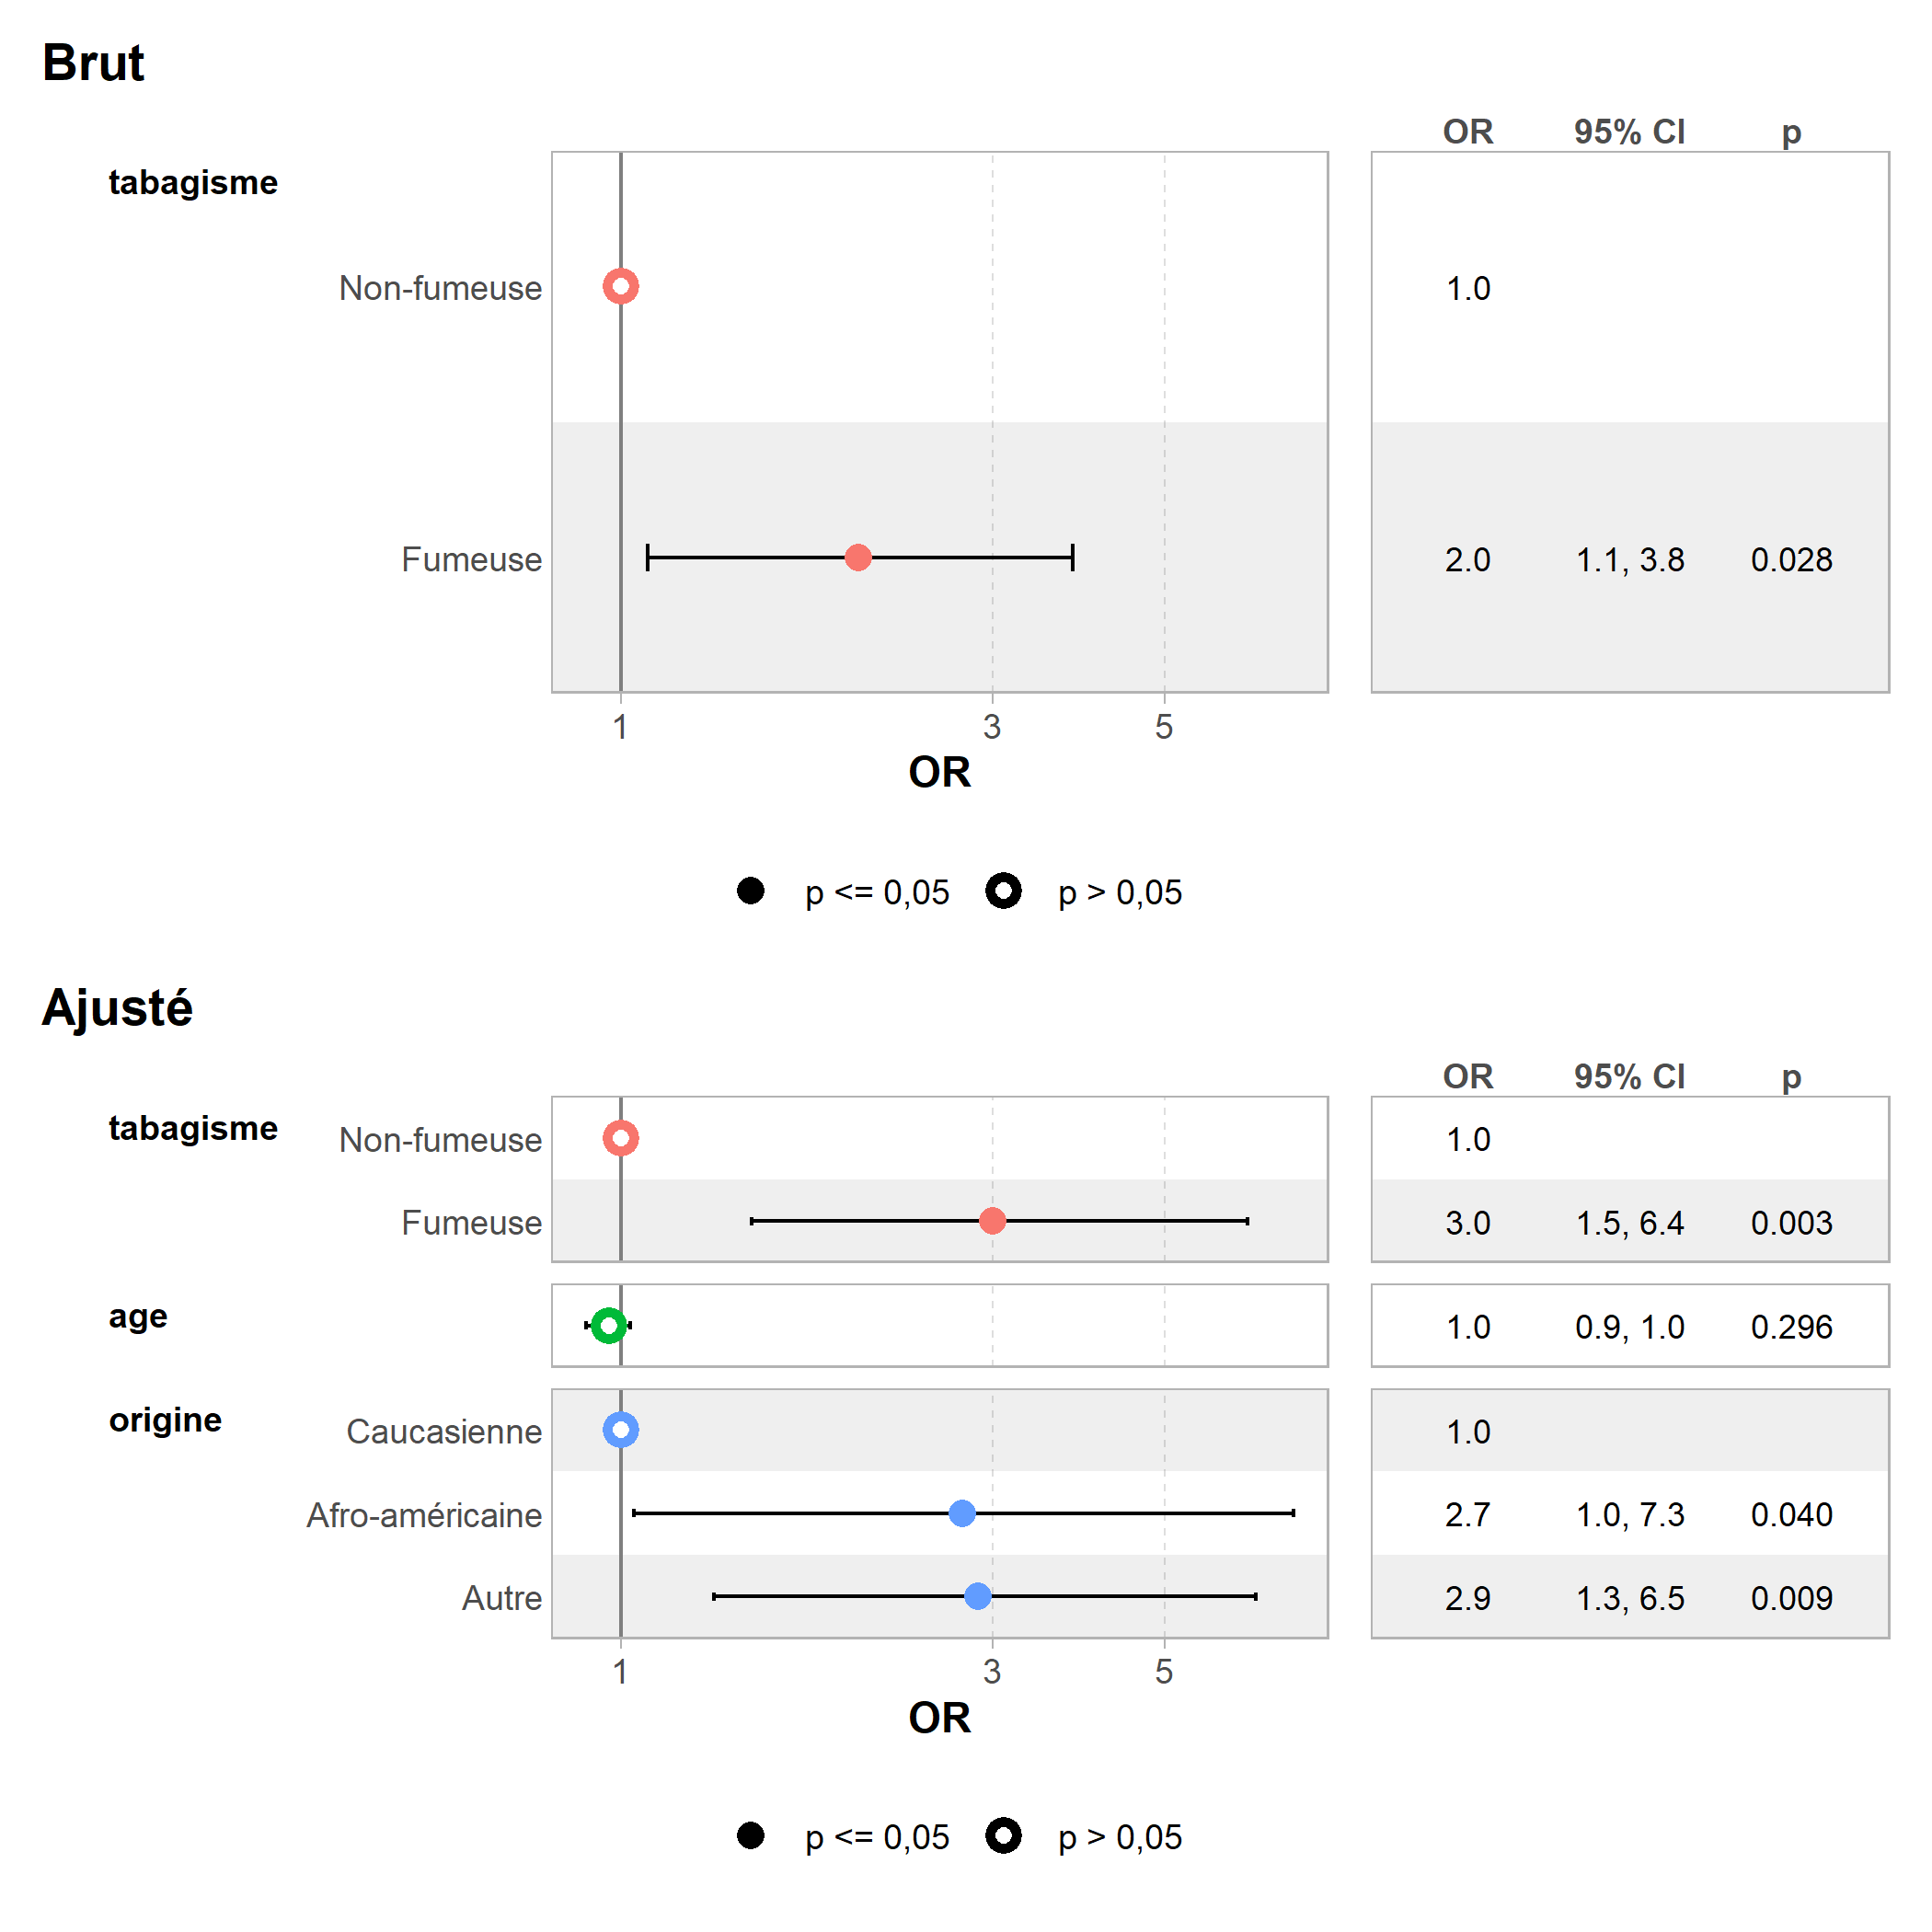
Bonus - Forest plots avec ggstats

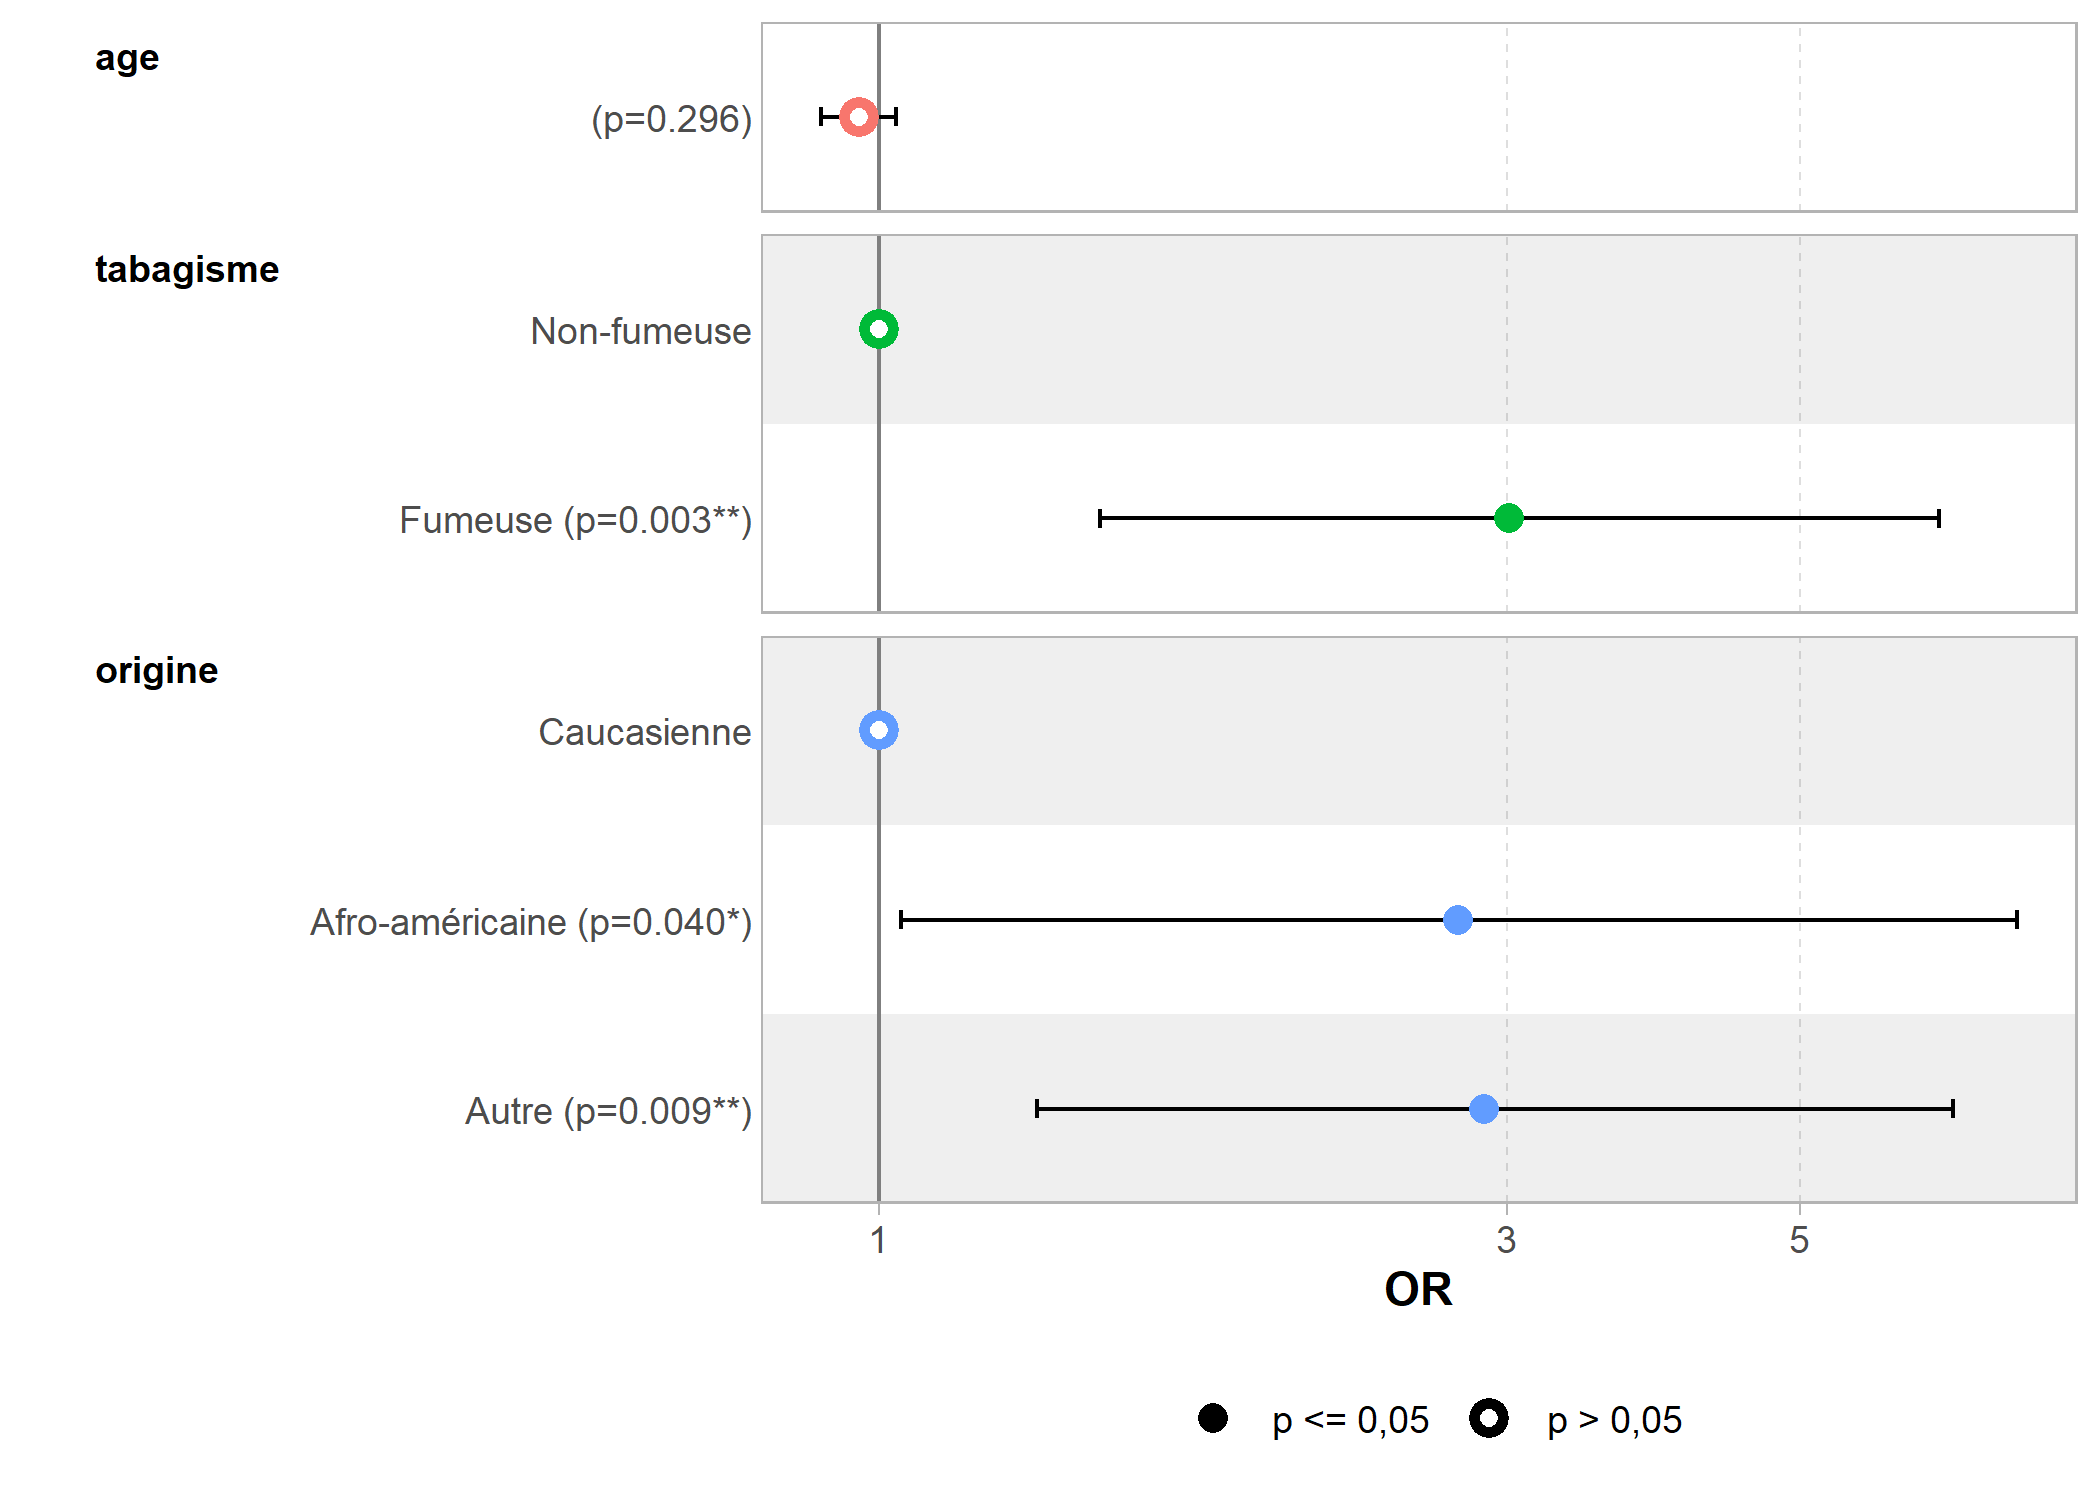
Pour finir, on voulait présenter le package ggstats pour construire des forest plots.

Un modèle

ggstats::ggcoef_model(
    modele_logistique_complet,
    exponentiate = TRUE
)

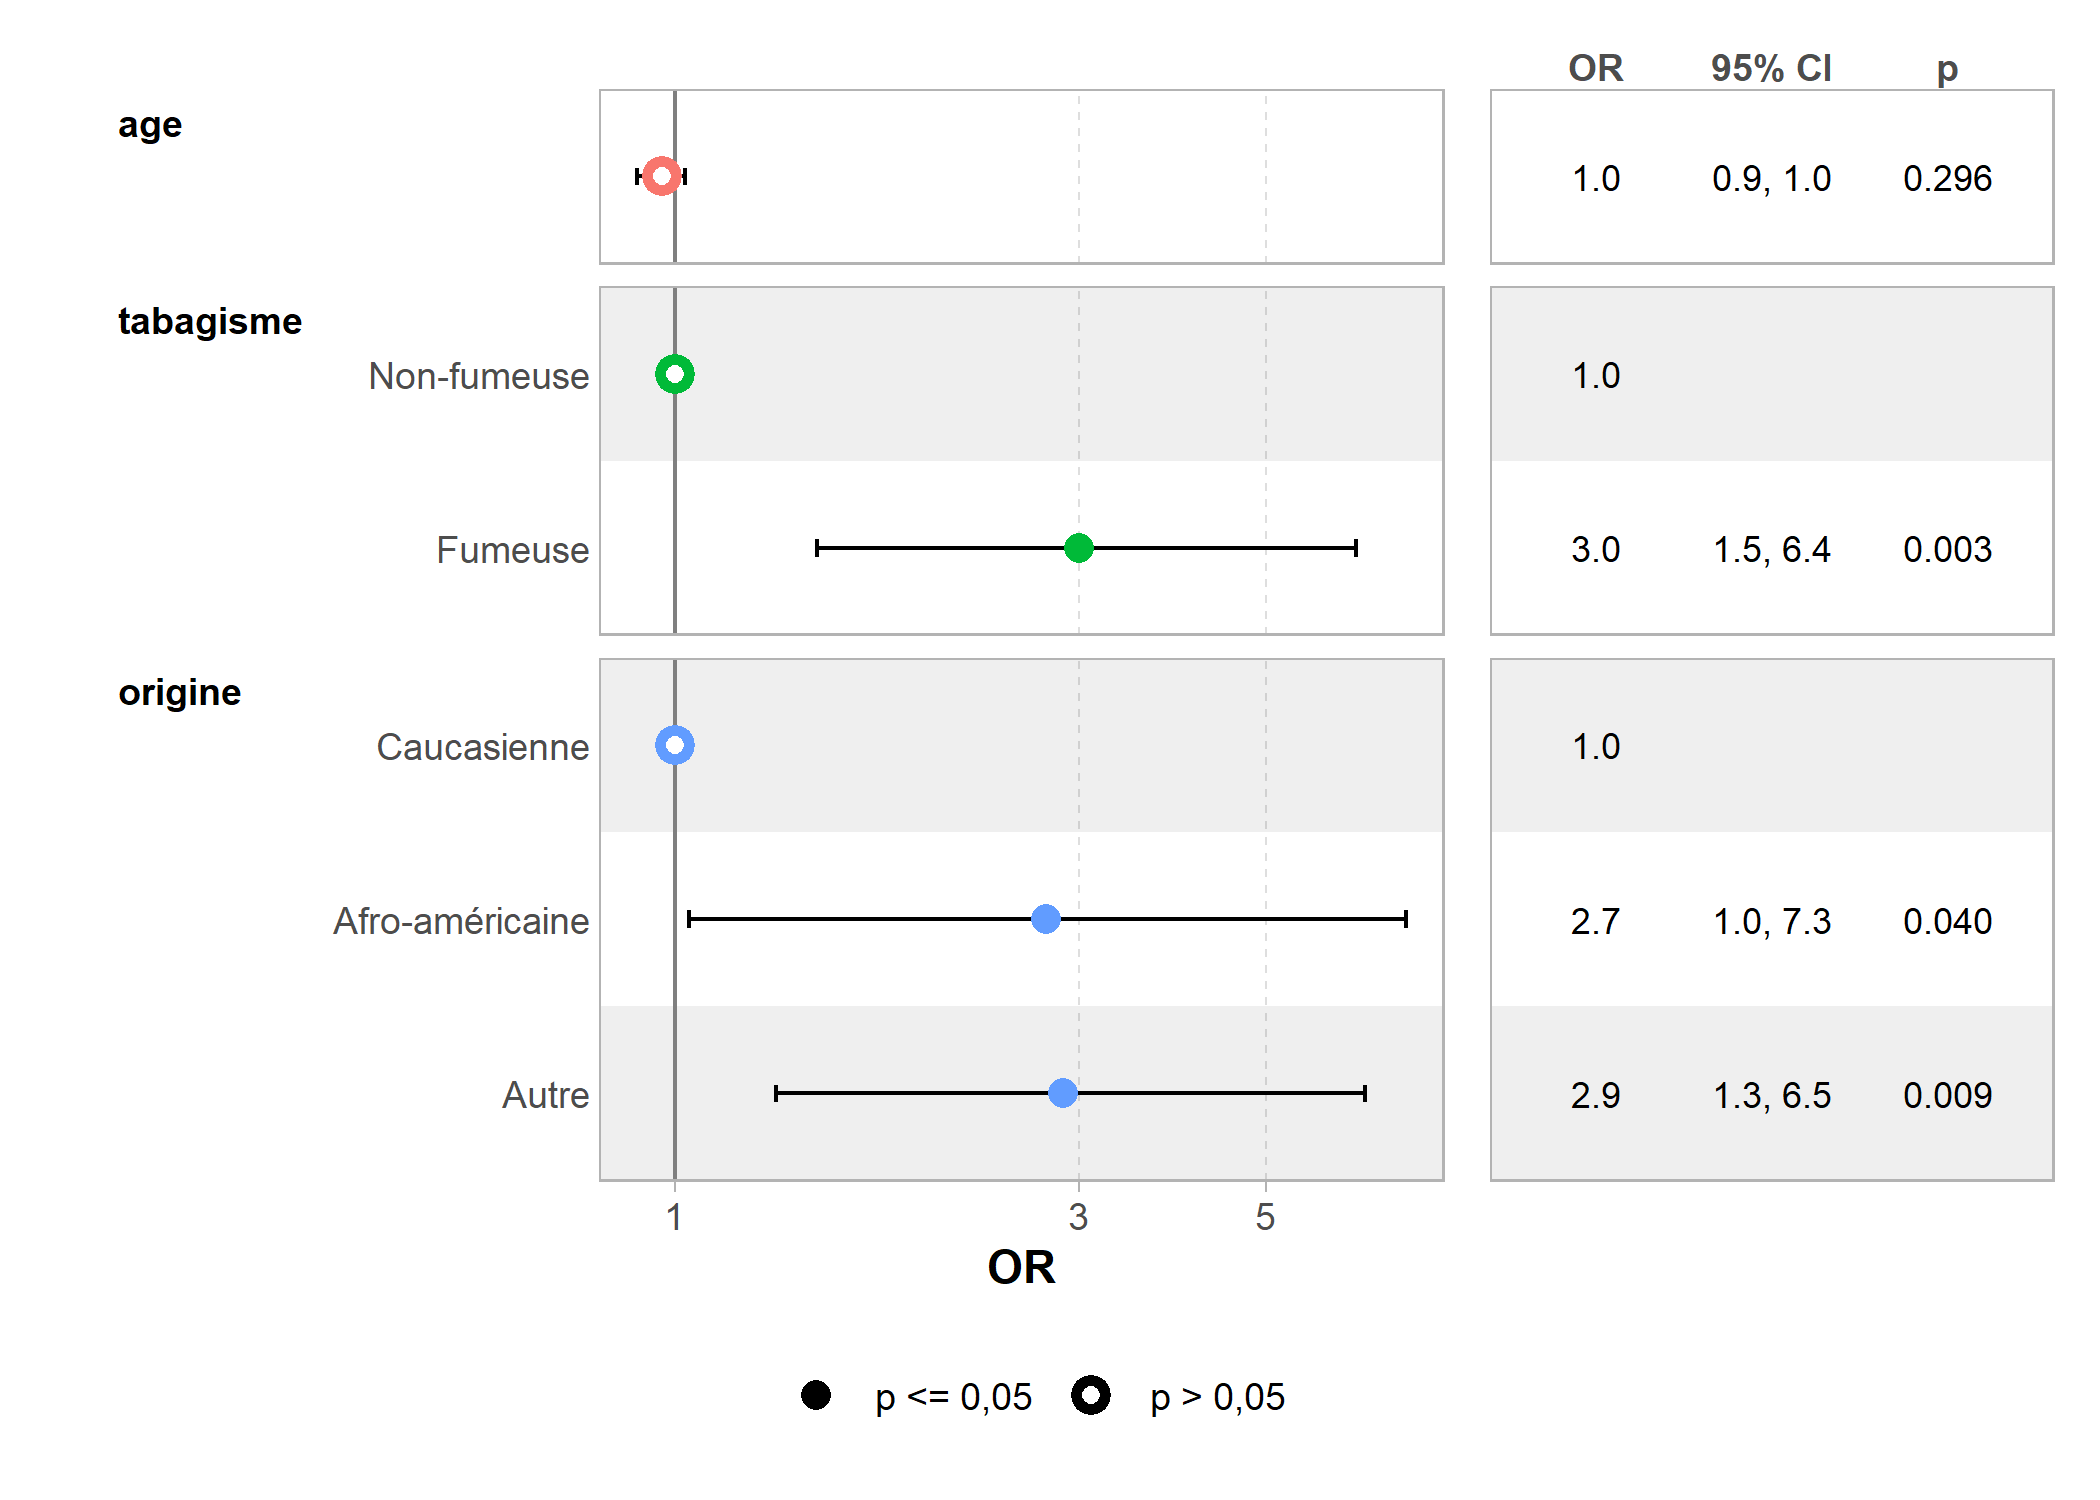
ggcoef_table() place les valeurs numériques à côté du forest plot :

ggstats::ggcoef_table(
    modele_logistique_complet,
    exponentiate = TRUE,
    table_stat = c("estimate", "ci", "p.value"),
)

Comparer plusieurs modèles

modele_logistique_brut <- glm(
    faible_poids ~ tabagisme,
    data = bw,
    family = binomial
)

ggstats::ggcoef_compare(
    type = "table",
    models = list(
        "Brut" = modele_logistique_brut,
        "Ajusté" = modele_logistique_complet
    ),
    exponentiate = TRUE
)