5 Modèle de Cox à risques proportionnels
On a vu comment estimer la fonction de survie groupe par groupe (Kaplan-Meier) et comment comparer globalement ces courbes (log-rank). Deux besoins restent pourtant sans réponse :
- Le log-rank est un test : il dit si les courbes diffèrent, mais pas de combien. Il ne fournit aucune mesure de l’intensité de l’association.
- Le log-rank ne permet pas d’ajuster sur d’autres variables. Un log-rank stratifié peut tenir compte de quelques variables catégorielles, mais le nombre de strates augmente très vite, et une variable quantitative (p. ex., l’âge) doit être découpée en classes.
Au chapitre précédent, l’OR de Mantel-Haenszel avait laissé la place à la régression logistique. Ici, c’est le log-rank qui laisse la place au modèle de Cox !
Le modèle de régression le plus utilisé en analyse de survie est le modèle de Cox à risques proportionnels. Il modélise la fonction de risque instantané \(\alpha(t)\), définie en section 2.5, en fonction de variables explicatives \(X\). Il permet :
- d’estimer une mesure d’association, le risque relatif, avec son intervalle de confiance ;
- d’ajuster sur plusieurs variables, qualitatives ou quantitatives ;
- de prendre en compte la censure à droite et l’entrée retardée.
David Roxbee Cox a proposé ce modèle en 1972 ; son article montre comment estimer les effets des variables sans imposer une forme à la fonction de risque de base (Cox 1972).
Avertissement
Dans ce chapitre, on note \(RR\) (pour risque relatif) le rapport de deux risques instantanés. En anglais, et dans beaucoup d’articles écrits en français, on le note HR (pour hazard ratio) : il s’agit de la même chose.
Attention toutefois : ce RR n’est pas le risque relatif vu au chapitre précédent (section “Comment comparer deux cotes ?” du chapitre Régression logistique binaire), qui était un rapport de proportions (“nombre d’évènements / effectif du groupe”) calculé à un horizon fixé.
Enfin, comme le modèle de Cox est un modèle de régression, les remarques faites aux chapitres précédents s’appliquent ici aussi (ajustement, modification de l’effet…).
5.1 Écriture du modèle
Ce modèle est dit semi-paramétrique : il laisse le risque de base \(\alpha_0(t)\) non spécifié (partie “non paramétrique”, qui ne dépend que du temps), tout en décrivant l’association avec les variables explicatives par un nombre fini de paramètres \(\beta\) (partie “paramétrique”). De plus, on peut lire ce modèle comme un produit de deux morceaux : \[ \underbrace{\alpha(t\mid X)}_{\text{risque du sujet}} = \underbrace{\alpha_0(t)}_{\substack{\text{risque de base}\\ \text{(dépend du temps)}}} \times \underbrace{\exp(\beta_1 X_1 + \dots + \beta_p X_p)}_{\substack{\text{facteur multiplicatif}\\ \text{(dépend des variables)}}} \]
C’est une des raisons qui explique son succès : on n’a pas besoin de savoir comment le risque évolue au cours du temps pour estimer l’association avec les variables explicatives !
Note
Contrairement à la régression logistique, le modèle de Cox ne contient pas d’intercept \(\beta_0\). Son rôle est tenu par le risque de base \(\alpha_0(t)\).
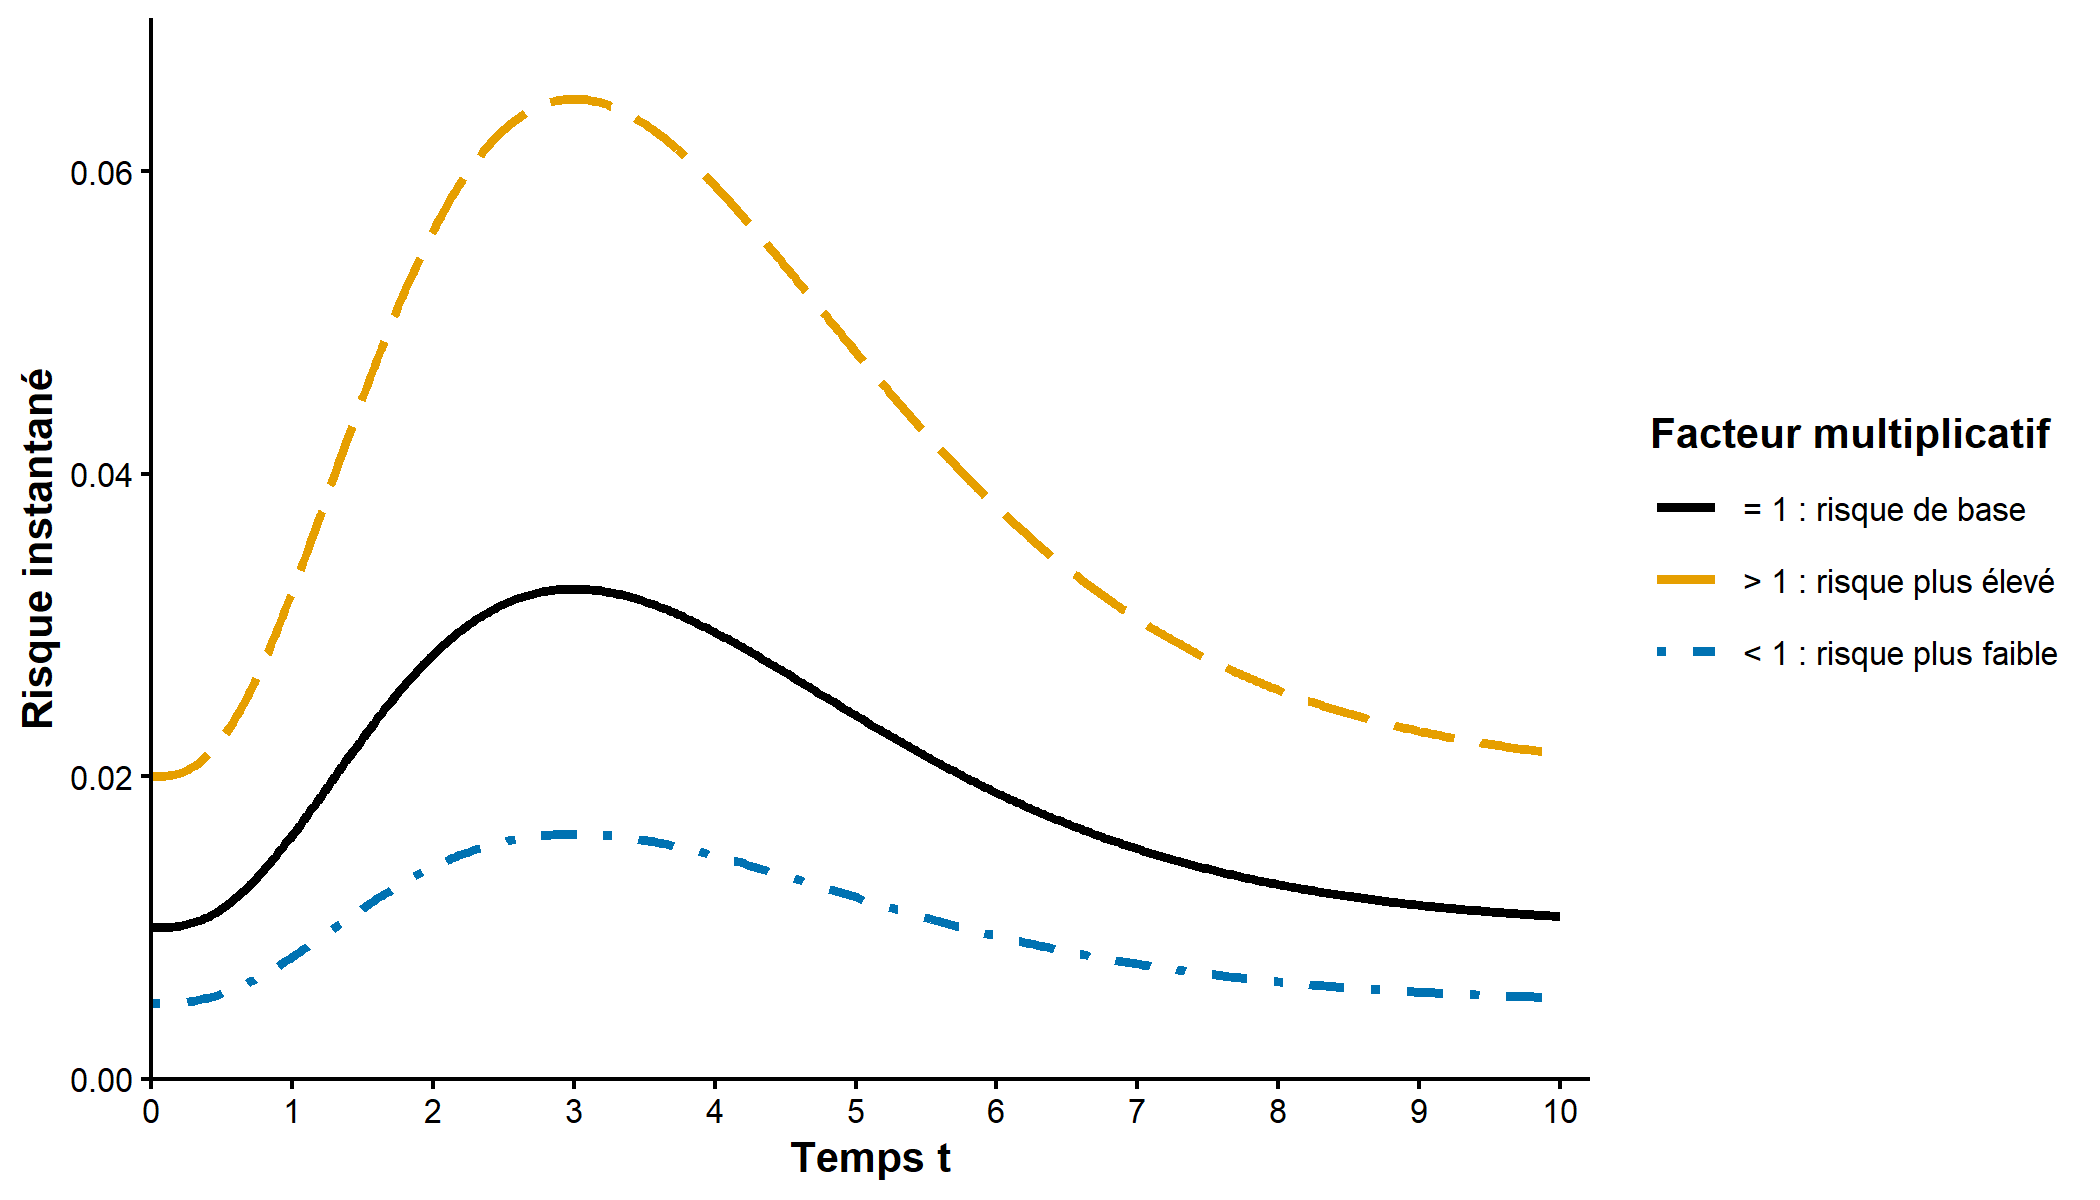
Le mécanisme multiplicatif est illustré en Figure 1. Tous les sujets partagent la même forme de risque au cours du temps, celle du risque de base : si le facteur \(\exp(\beta^\top X)\) est supérieur à 1, la courbe du sujet est au-dessus de celle du risque de base ; s’il est inférieur à 1, elle est en dessous.
5.2 Pourquoi “à risques proportionnels” ?
Comparons deux sujets \(i\) et \(j\), de caractéristiques \(X_i\) et \(X_j\). Dans le modèle de Cox, ils partagent le même risque de base \(\alpha_0(t)\). Le rapport de leurs risques instantanés s’écrit donc : \[ \frac{\alpha(t\mid X_i)}{\alpha(t\mid X_j)} = \frac{\cancel{\alpha_0(t)}\exp(\beta^\top X_i)}{\cancel{\alpha_0(t)}\exp(\beta^\top X_j)} = \exp\bigl(\beta^\top (X_i - X_j)\bigr) \]
Ce rapport ne dépend plus du temps : c’est exactement cela, la proportionnalité des risques. Le risque de chaque sujet évolue au cours du suivi, mais le risque de l’un reste, à chaque instant, un multiple fixe du risque de l’autre.
Note
- La proportionnalité des risques est une hypothèse forte du modèle de Cox : elle implique que l’effet d’une variable sur le risque instantané est constant dans le temps. En pratique, c’est rarement le cas (p. ex., un traitement efficace au début mais qui perd de son efficacité ; une chirurgie qui augmente le risque de décès dans la période périopératoire mais le diminue à plus long terme).
- La proportionnalité des risques étant une hypothèse du modèle, elle doit être évaluée lors de l’analyse. Ceci est abordé en section 6.
5.3 Interpréter un modèle de Cox
Cette proportionnalité des risques est pratique pour interpréter nos résultats. En effet, après avoir estimé le modèle, on obtient un coefficient \(\hat\beta\) pour chaque variable explicative. Si on en prend son exponentielle, \(\exp(\hat\beta)\), on obtient alors un risque relatif.
Comme pour l’OR au chapitre précédent, on a trois cas possibles :
- \(RR=1\) : les deux profils ont le même risque d’évènement (absence d’association) ;
- \(RR>1\) : le risque d’évènement est plus élevé pour le profil \(X_i\) que pour le profil \(X_j\) ;
- \(RR<1\) : le risque d’évènement est plus faible pour le profil \(X_i\) que pour le profil \(X_j\).
Avec évènement défavorable (p. ex., décès, rechute), un \(RR > 1\) indique un facteur de risque et un \(RR < 1\) indique un facteur protecteur. Si l’évènement est favorable (p. ex., guérison, rémission), l’interprétation est simplement inversée.
Illustrons cela avec les données de l’étude Toxo. Les 550 patients ont été suivis jusqu’à 970 jours après la randomisation et 89 d’entre eux ont présenté une toxoplasmose. L’évènement étudié est la toxoplasmose, et les décès survenus avant toute toxoplasmose sont censurés. On s’intéresse alors à trois caractéristiques recueillies à l’inclusion :
- le sexe : 468 hommes et 82 femmes ;
- l’âge, découpé en trois classes : moins de 35 ans (183 patients), de 35 à 44 ans (239 patients) et 45 ans ou plus (128 patients) ;
- le nombre de lymphocytes CD4, en cellules/mm\(^3\), qui mesure le degré d’immunodépression (plus il est bas, plus le système immunitaire est affaibli).
5.3.1 Avec une variable explicative (RR bruts)
5.3.1.1 Variable explicative binaire
Soit une variable binaire \(X\), codée 1 pour la modalité étudiée et 0 pour la modalité de référence. D’après le modèle de Cox : \[ \alpha(t\mid X=1)=\alpha_0(t)\exp(\beta) \quad \text{et} \quad \alpha(t\mid X=0)=\alpha_0(t) \] Le risque relatif est le rapport de ces deux risques instantanés : \[ RR=\frac{\alpha(t\mid X=1)}{\alpha(t\mid X=0)} = \frac{\alpha_0(t)\exp(\beta)}{\alpha_0(t)} = \exp(\beta) \]
À chaque instant \(t\), le risque d’évènement d’un sujet \(X=1\) vaut \(\exp(\beta)\) fois celui d’un sujet \(X=0\). Si \(\exp(\beta) = 2\), le risque d’évènement est deux fois plus élevé, et ce à tout instant du suivi. On peut aussi présenter un RR en pourcentage. Pour cela, on regarde son écart à 1 :
- \(RR=1{,}5\) : le risque d’évènement est augmenté de 50 % ;
- \(RR=2\) : le risque d’évènement est doublé (augmenté de 100 %) ;
- \(RR=0{,}8\) : le risque d’évènement est diminué de 20 % ;
- \(RR=0{,}5\) : le risque d’évènement est deux fois plus faible (diminué de 50 %).
5.3.1.2 Variable explicative qualitative à plus de deux modalités
Une variable qualitative à \(K\) modalités est représentée, comme en régression logistique, par \(K-1\) indicatrices : l’une des modalités sert de référence. Chaque RR compare alors une modalité à la référence.
Dans l’exemple précédent, le risque semble augmenter légèrement avec l’âge. Cependant, les intervalles de confiance contiennent 1, donc cet effet n’est pas significatif ; les p-valeurs sont supérieures à 0,05.
5.3.1.3 Variable explicative quantitative
Si la variable \(X\) est quantitative, on compare deux sujets dont les valeurs de \(X\) diffèrent d’une unité, \(X=x+1\) et \(X=x\) : \[ RR=\frac{\alpha(t\mid X=x+1)}{\alpha(t\mid X=x)} = \frac{\alpha_0(t)\exp(\beta(x+1))}{\alpha_0(t)\exp(\beta x)} = \exp(\beta) \]
À chaque instant \(t\), une augmentation d’une unité de \(X\) multiplie le risque instantané par \(\exp(\beta)\), quelle que soit la valeur de départ \(x\). Si \(\exp(\beta) = 1{,}10\), le risque est multiplié par 1,10 en passant de \(X=10\) à \(X=11\), mais aussi en passant de \(X=50\) à \(X=51\).
Plus généralement, pour une augmentation de \(d\) unités : \[ RR(d)=\frac{\alpha_0(t)\exp(\beta(x+d))}{\alpha_0(t)\exp(\beta x)}=\exp(d\beta)=\exp(\beta)^d \]
Comme pour l’OR, le RR pour 50 cellules est souvent plus lisible que le RR par unité lorsque ce dernier est très proche de 1 ou que l’unité est très petite (1 cellule CD4, ce n’est pas grand chose…)
Avertissement
Dire que \(\exp(\beta)\) est le même “quelle que soit la valeur de départ” est une hypothèse du modèle, appelée log-linéarité. Ici, on suppose que passer de 0 à 50 CD4 a le même effet relatif que passer de 300 à 350 CD4. Elle n’est pas toujours vérifiée (cf. section 6.2).
5.3.2 Avec plusieurs variables explicatives (RR ajustés)
Au lieu de prendre les variables isolément, on peut les combiner dans un même modèle. Comme vu dans les chapitres précédents, on ajoute une variable, soit car on s’intéresse à son effet, soit pour contrôler un potentiel biais de confusion.
Avec \(X=(X_1,\dots,X_p)^\top\) et \(\beta=(\beta_1,\dots,\beta_p)^\top\), le modèle s’écrit : \[ \alpha(t\mid X)=\alpha_0(t)\exp(\beta_1X_1+\dots+\beta_pX_p) \]
Dans ce cas, \(RR_k=\exp(\beta_k)\) est le risque relatif associé à la variable \(X_k\) ajusté sur toutes les autres variables du modèle : on compare deux sujets qui ne diffèrent que par la valeur de \(X_k\). On utilise l’expression “toutes choses égales par ailleurs” pour désigner cet ajustement.
Il n’est pas rare de voir (donc de présenter) côte à côte les RR bruts (modèles univariés) et les RR ajustés (modèle multiple), pour illustrer l’effet de l’ajustement sur les estimations.
Enfin, on peut aussi comparer deux profils qui diffèrent sur plusieurs variables : il suffit d’additionner les “contributions” dans l’exponentielle.
5.4 Inférence statistique
Dans les sorties précédentes figuraient des colonnes “Erreur standard”, “z”, “p-valeur” et “IC 95 %”. Ces quantités sont construites à partir des coefficients estimés \(\hat\beta\) et leur erreur-type \(\widehat{SE}(\hat\beta)\), via le “maximum de vraisemblance partielle”. Bien que les détails dépassent le cadre de ce cours, vous pouvez retenir que
- seuls l’ordre des évènements et la composition des effectifs à risque comptent (et non les temps d’évènements). Ainsi, si l’on remplaçait les délais 1, 2, 3 mois par 0,1, 0,5, 1 mois sans changer leur ordre, on obtiendrait exactement le même \(\hat\beta\) ;
- les sujets censurés ne présentent pas d’évènement, mais qu’ils contribuent quand même à l’estimation des \(\beta\) ;
- le risque de base \(\alpha_0(t)\) n’influe pas sur l’estimation des coefficients \(\beta\).
5.4.1 Intervalle de confiance
Comme dans les chapitres précédents, l’intervalle de confiance s’écrit sous la forme “estimation \(\pm\) marge d’erreur”. Pour le coefficient \(\beta\), cela donne : \[ \text{IC}_{95\%}(\beta)=\left[\hat{\beta}-1{,}96\times SE(\hat{\beta})\, ; \,\hat{\beta}+1{,}96\times SE(\hat{\beta}) \right] \]
Pour obtenir l’intervalle de confiance du RR, il suffit d’exponentier les bornes : \[ \text{IC}_{95\%}(RR)=\left[\exp\left(\hat{\beta}-1{,}96\times SE(\hat{\beta})\right) ; \exp\left(\hat{\beta}+1{,}96\times SE(\hat{\beta})\right) \right] \]
L’intervalle est symétrique autour de \(\hat\beta\), mais pas autour du RR : la borne haute est plus éloignée du RR que la borne basse. Ceci est normal et correspond à l’effet de l’exponentielle !
Chose bonne à savoir : pour un RR associé à \(d\) unités d’une variable quantitative, il suffit de multiplier le coefficient et son erreur standard par \(d\).
Note
La largeur de l’intervalle dépend surtout du nombre d’évènements, bien plus que du nombre de sujets : plus il y a d’évènements, plus l’intervalle est étroit !
5.4.2 Tests d’hypothèses
Comme pour les modèles de régression linéaire et logistique, on peut se demander si les variables explicatives sont associées à la survenue de l’évènement, c’est-à-dire si leurs coefficients \(\beta\) sont différents de \(0\) dans la population.
Note
Tester \(H_0 : \beta_k = 0\) revient à tester \(H_0 : RR_k = 1\), c’est-à-dire l’absence d’association entre \(X_k\) et le risque instantané, puisque \(\exp(0)=1\). La remarque vaut aussi pour plusieurs coefficients à la fois.
On distingue deux situations :
- tester un seul coefficient : on utilise le plus souvent le test de Wald ;
- tester un sous-ensemble (càd, un ou plus) de coefficients (p. ex., une variable qualitative à plusieurs modalités) : on utilise le test du rapport de vraisemblance (partielle).
On peut quand même utiliser le test du rapport de vraisemblance pour ne tester qu’un seul coefficient
5.4.3 Test de Wald
On teste : \[ H_0:\beta_k=0 \quad \text{vs.} \quad H_1:\beta_k\neq0 \] La statistique de test est la même qu’en régression logistique : \[ Z=\frac{\hat\beta_k}{SE(\hat\beta_k)} \underset{H_0}{\overset{approx.}{\sim}} \mathcal{N}(0,1) \; \text{ ou, de façon équivalente, } \; Z^2 \underset{H_0}{\overset{approx.}{\sim}} \chi^2_1 \] Au seuil de 5 %, on rejette \(H_0\) si \(|Z|>1{,}96\), ou si \(Z^2>3{,}84\).
C’est ce test qui donne les colonnes “z” et “p-valeur” des sorties.
Pour un test bilatéral au seuil de 5 %, regarder si l’IC 95 % du RR contient 1 conduit à la même conclusion que le test de Wald.
5.4.4 Test du rapport de vraisemblances (LRT)
On compare deux modèles de Cox emboîtés, ajustés sur les mêmes sujets et avec la même échelle de temps :
- un modèle réduit \(\mathcal M_R\) avec \(p_R\) coefficients de régression ;
- un modèle complet \(\mathcal M_C\) comprenant les mêmes termes explicatifs, plus un bloc de \(q=p_C-p_R\) coefficients supplémentaires.
Sans perte de généralité, on peut supposer que ces \(q\) coefficients supplémentaires sont les derniers du modèle complet. Les deux modèles s’écrivent alors : \[ \begin{aligned} \mathcal{M}_C \; : \; \alpha_i(t) &= \alpha_0(t)\exp\left( \beta_1 X_{i1} + \beta_2 X_{i2} + \cdots + \beta_{p_R} X_{i,p_R} + \underbrace{\beta_{p_R+1} X_{i,p_R+1} + \cdots + \beta_{p_C} X_{i,p_C}}_{\text{$q=p_C-p_R$ coefficients testés}} \right) \\ \mathcal{M}_R \; : \; \alpha_i(t) &= \alpha_0(t)\exp\left( \beta_1 X_{i1} + \beta_2 X_{i2} + \cdots + \beta_{p_R} X_{i,p_R} \right) \end{aligned} \]
On teste alors : \[ H_0:\beta_{p_R+1}=\cdots=\beta_{p_C}=0 \quad \text{vs.} \quad H_1:\text{au moins un de ces coefficients est non nul} \] Sous \(H_0\), tous les RR associés à ces coefficients valent \(1\), conditionnellement aux autres covariables. La comparaison repose sur les vraisemblances partielles des deux modèles.
En notant \(\ell_R\) et \(\ell_C\) les log-vraisemblances partielles des deux modèles, la statistique du test du rapport de vraisemblance est : \[ LRT=-2\times(\ell_R-\ell_C) = (-2 \times \ell_R) - (- 2 \times \ell_C) \underset{H_0}{\overset{asympt.}{\sim}} \chi^2_q \] On rejette \(H_0\) si \(LRT\) dépasse la valeur critique de la loi du \(\chi^2\) à \(q\) degrés de liberté (3,84 pour \(q=1\), 5,99 pour \(q=2\), 7,81 pour \(q=3\), etc.). Si \(LRT\) dépasse la valeur seuil à 5 % de la loi du \(\chi^2\) à \(q\) degrés de liberté, on rejette \(H_0\).
Avertissement
- Pour le test du rapport des vraisemblances, il faut s’assurer que les deux modèles que l’on compare sont estimés sur exactement le même échantillon, la même méthode d’estimation… bref, les mêmes conditions !
- Ainsi, attention aux données manquantes : si une variable ajoutée a des valeurs manquantes, le modèle complet est estimé sur moins de sujets que le modèle réduit, et la comparaison n’a plus de sens.
Les références
Cox, David R. 1972. « Regression Models and Life-Tables ». Journal of the Royal Statistical Society: Series B (Methodological) 34 (2): 187‑202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x.