1 Oh non, encore un autre modèle ?
Reprenons notre point de départ. Lorsque l’on cherche à expliquer une variable quantitative \(Y\) par une variable \(X\), on peut ajuster une régression linéaire : \[ Y=\beta_0+\beta_1X+\varepsilon. \]
La droite décrit la moyenne de \(Y\) pour une valeur donnée de \(X\). Le coefficient \(\beta_1\) indique de combien cette moyenne varie lorsque \(X\) augmente d’une unité, et \(\varepsilon\) représente ce que le modèle n’explique pas pour une observation. Avec plusieurs variables explicatives, le principe reste le même : on cherche une relation moyenne en tenant compte des autres variables du modèle.
Dans le chapitre sur la régression linéaire, nous avons notamment supposé que les erreurs étaient indépendantes d’une observation à l’autre. C’est cette hypothèse qui va nous intéresser ici. En effet, il n’est pas rare d’avoir des données non indépendantes. Imaginez que l’on mesure la pollution de l’eau du robinet dans des maisons de plusieurs communes de la métropole bordelaise. Deux maisons alimentées par le même réseau de distribution, ou exposées à la même source de pollution locale, auront probablement des mesures plus proches que deux maisons de communes différentes : leurs mesures ne sont pas indépendantes.
1.1 Quand les observations ne sont pas indépendantes…
Le plus fréquent, est d’avoir plusieurs observations qui proviennent d’un même patient, ou que les patients soient pris en charge dans les mêmes centres. On a alors trois grandes situations de dépendance : soit on a des …
- … données longitudinales (ou mesures répétées) : un même patient est mesuré à plusieurs visites ;
- … données groupées : des patients sont pris en charge dans différents centres, plusieurs lésions sont observées chez un même patient, ou une même image est lue par plusieurs radiologues ;
- … ou des données hiérarchiques (ou emboîtées) : des patients appartiennent à des services, qui appartiennent eux-mêmes à des centres (nous n’en parlerons pas dans ce cours).
Deux mesures réalisées chez un même patient ont des caractéristiques en commun : sa génétique, ses habitudes de vie, etc. De la même façon, deux patients pris en charge dans un même centre partagent un équipement, des pratiques locales… Même après avoir pris en compte nos variables explicatives, leurs observations peuvent donc encore se ressembler.
Ces données étant corrélées au sein d’un même regroupement (chez un même patient pour des mesures répétées, ou dans un même centre pour des données groupées), on parle de corrélation intra-groupe.
On a alors deux grandes raisons de s’intéresser de plus près à cette corrélation intra-groupe :
- Les observations d’un même groupe peuvent être corrélées (malgré la prise en compte des variables explicatives). Dans ce cas, l’hypothèse d’indépendance des erreurs n’est plus respectée et nous pourrions tirer des conclusions erronées ;
- Les intercepts et les pentes des groupes peuvent être des objets d’intérêt. On souhaite alors quantifier leurs différences et prédire la droite propre à un centre (données groupées) ou la trajectoire propre à un individu (données longitudinales), en utilisant aussi l’information apportée par les autres groupes (et non seulement les données au sein d’un même regroupement).
1.2 Un premier exemple : mesurer avant et après
Nous avons déjà rencontré cette difficulté avec les tests pour données appariées. Reprenons une situation simple.
Pour étudier le changement, on s’intéresse à la différence entre les deux mesures. Sa variance vaut :
\[ \mathrm{Var}(X_1 - X_2) = \mathrm{Var}(X_1) + \mathrm{Var}(X_2) - 2\,\mathrm{Cov}(X_1, X_2). \]
Le dernier terme, celui de covariance, correspond justement à ce que les deux mesures ont en commun. Il permet notamment de définir un coefficient de corrélation, défini par : \[ r = \frac{\mathrm{Cov}(X_1, X_2)}{\sqrt{\mathrm{Var}(X_1)\,\mathrm{Var}(X_2)}} \]
Avec un test de Student non apparié, on ne prend pas en compte la corrélation entre les deux mesures : on considère que \(r=0\), donc que \(\mathrm{Cov}(X_1, X_2)=0\) (ce qui n’est pas forcément vrai !). Si cette covariance est positive (donc, que la corrélation est positive), on surestime alors la variance de la différence et on perd de la puissance. Avec sa version apparié, on tient compte de cette dépendance, étant donné qu’on compare chaque patient à lui-même.
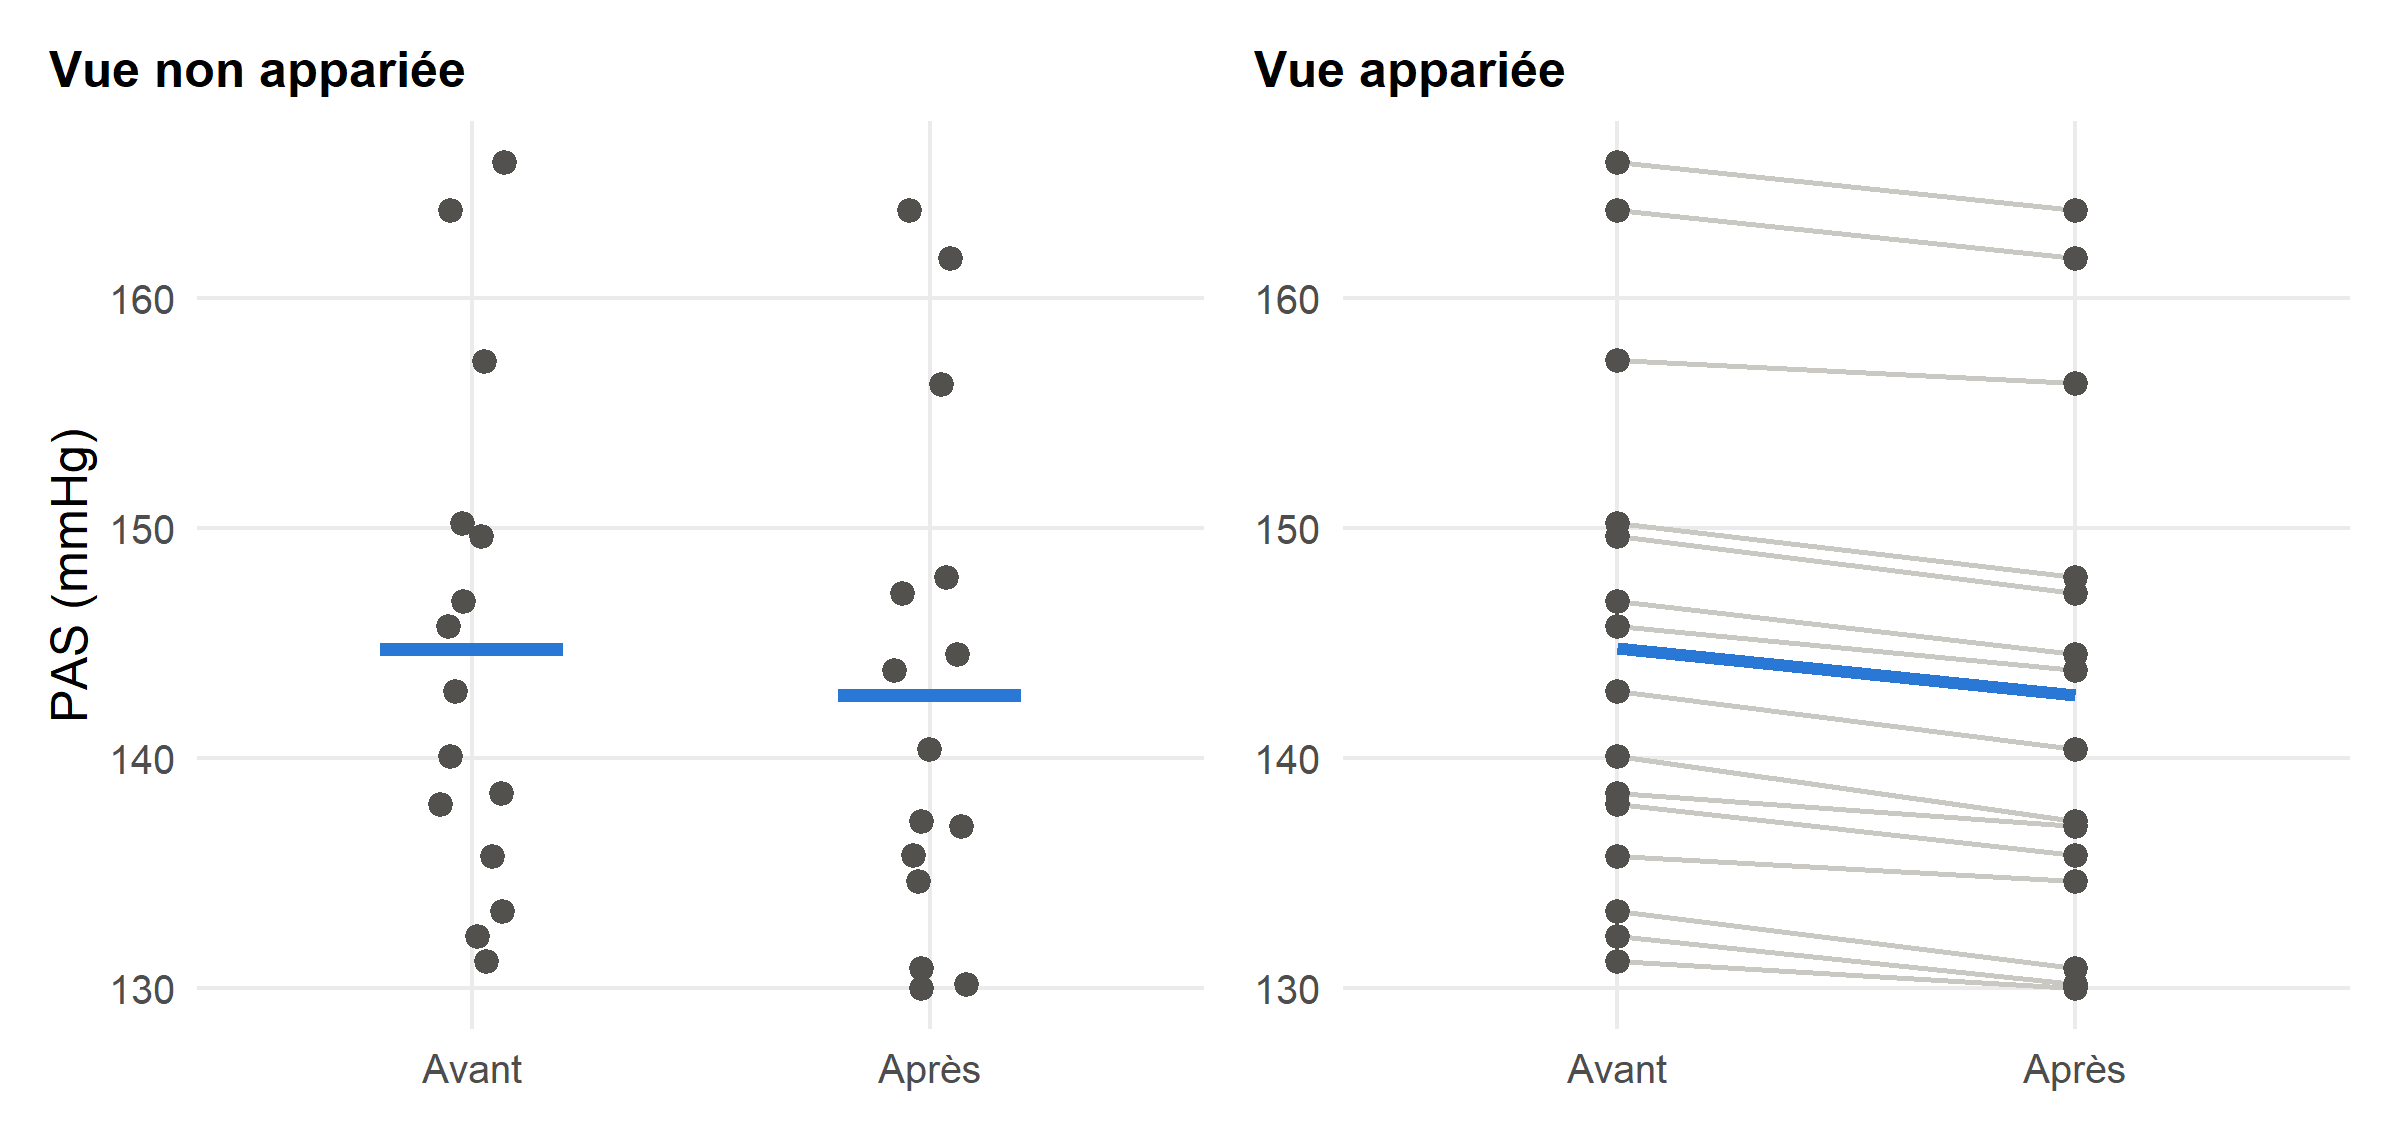
Représentons les deux mesures de 15 patients avant et après traitement. À gauche, on ne tient pas compte du fait que les deux mesures proviennent des mêmes patients : la baisse moyenne est noyée dans la variabilité entre patients. À droite, chaque segment relie les deux mesures d’un même patient, et la plupart baissent.
Dans notre exemple, la corrélation entre les deux mesures vaut 1 (elle est parfaite) ! Si on souhaite comparer les moyennes sans prendre cela en compte - un test de student non apparié - on obtient une p-valeur de \(0,620 < 0,05\) : la baisse moyenne n’est aps considéré significatif. Or, on voit bien que, quand on regarde les mesures des patients 1 à 1, la PAS baisse systématiquement. Ceci est confirmé avec le test apparié, où \(p<0,001\) !
Nous avons pourtant utilisé exactement les mêmes mesures ; la seule chose qui change, c’est la prise en compte - ou non - de la dépendance entre les mesures. Autrement dit, la corrélation intra-groupe peut avoir un impact sur nos conclusions.
1.3 Second exemple : éducation thérapeutique du diabète (données groupées)
Les tests, c’est bien, mais ici, on parle surtout de régression. Reprenons donc notre idée avec des patients pris en charge dans plusieurs centres : est-ce qu’une seule droite suffira à décrire tout le monde ?
Les patients d’un même centre ont des choses en commun : l’équipe qui les accompagne, les pratiques de suivi, les outils utilisés… On peut donc imaginer que certains centres aient des patients dont l’HbA1c est globalement un peu plus élevée, et que l’association avec l’éducation thérapeutique soit plus ou moins marquée selon le centre.
Cette étude n’existe pas, nous avons donc créé des données pour simuler cette situation. Comme nous créons les données, nous connaissons les paramètres utilisés (cela va nous servir, plus tard, pour voir si on estime correctement ces paramètres). On sait donc que :
- la pente moyenne vaut -0,20 point de pourcentage d’HbA1c par heure d’éducation supplémentaire, avec un écart-type des pentes de 0,06 : les centres n’ont donc pas tous exactement la même pente ;
- les intercepts varient autour de 8 % d’HbA1c, avec un écart-type de 0,25 point. Il s’agit du niveau moyen prédit pour zéro heure d’éducation ;
- les observations individuelles fluctuent autour de la droite de leur centre, avec un écart-type de 0,40 point ;
- les centres ont entre 3 et 50 patients, pour un total de 431 patients.
Voici les mesures de 6 patients au sein du premier centre :
| centre | education | hba1c |
|---|---|---|
| C01 | 3.962430 | 5.670885 |
| C01 | 3.999058 | 6.775919 |
| C01 | 3.354487 | 6.704101 |
| C01 | 2.300615 | 6.504411 |
| C01 | 1.693122 | 6.848442 |
| C01 | 3.211041 | 7.248462 |
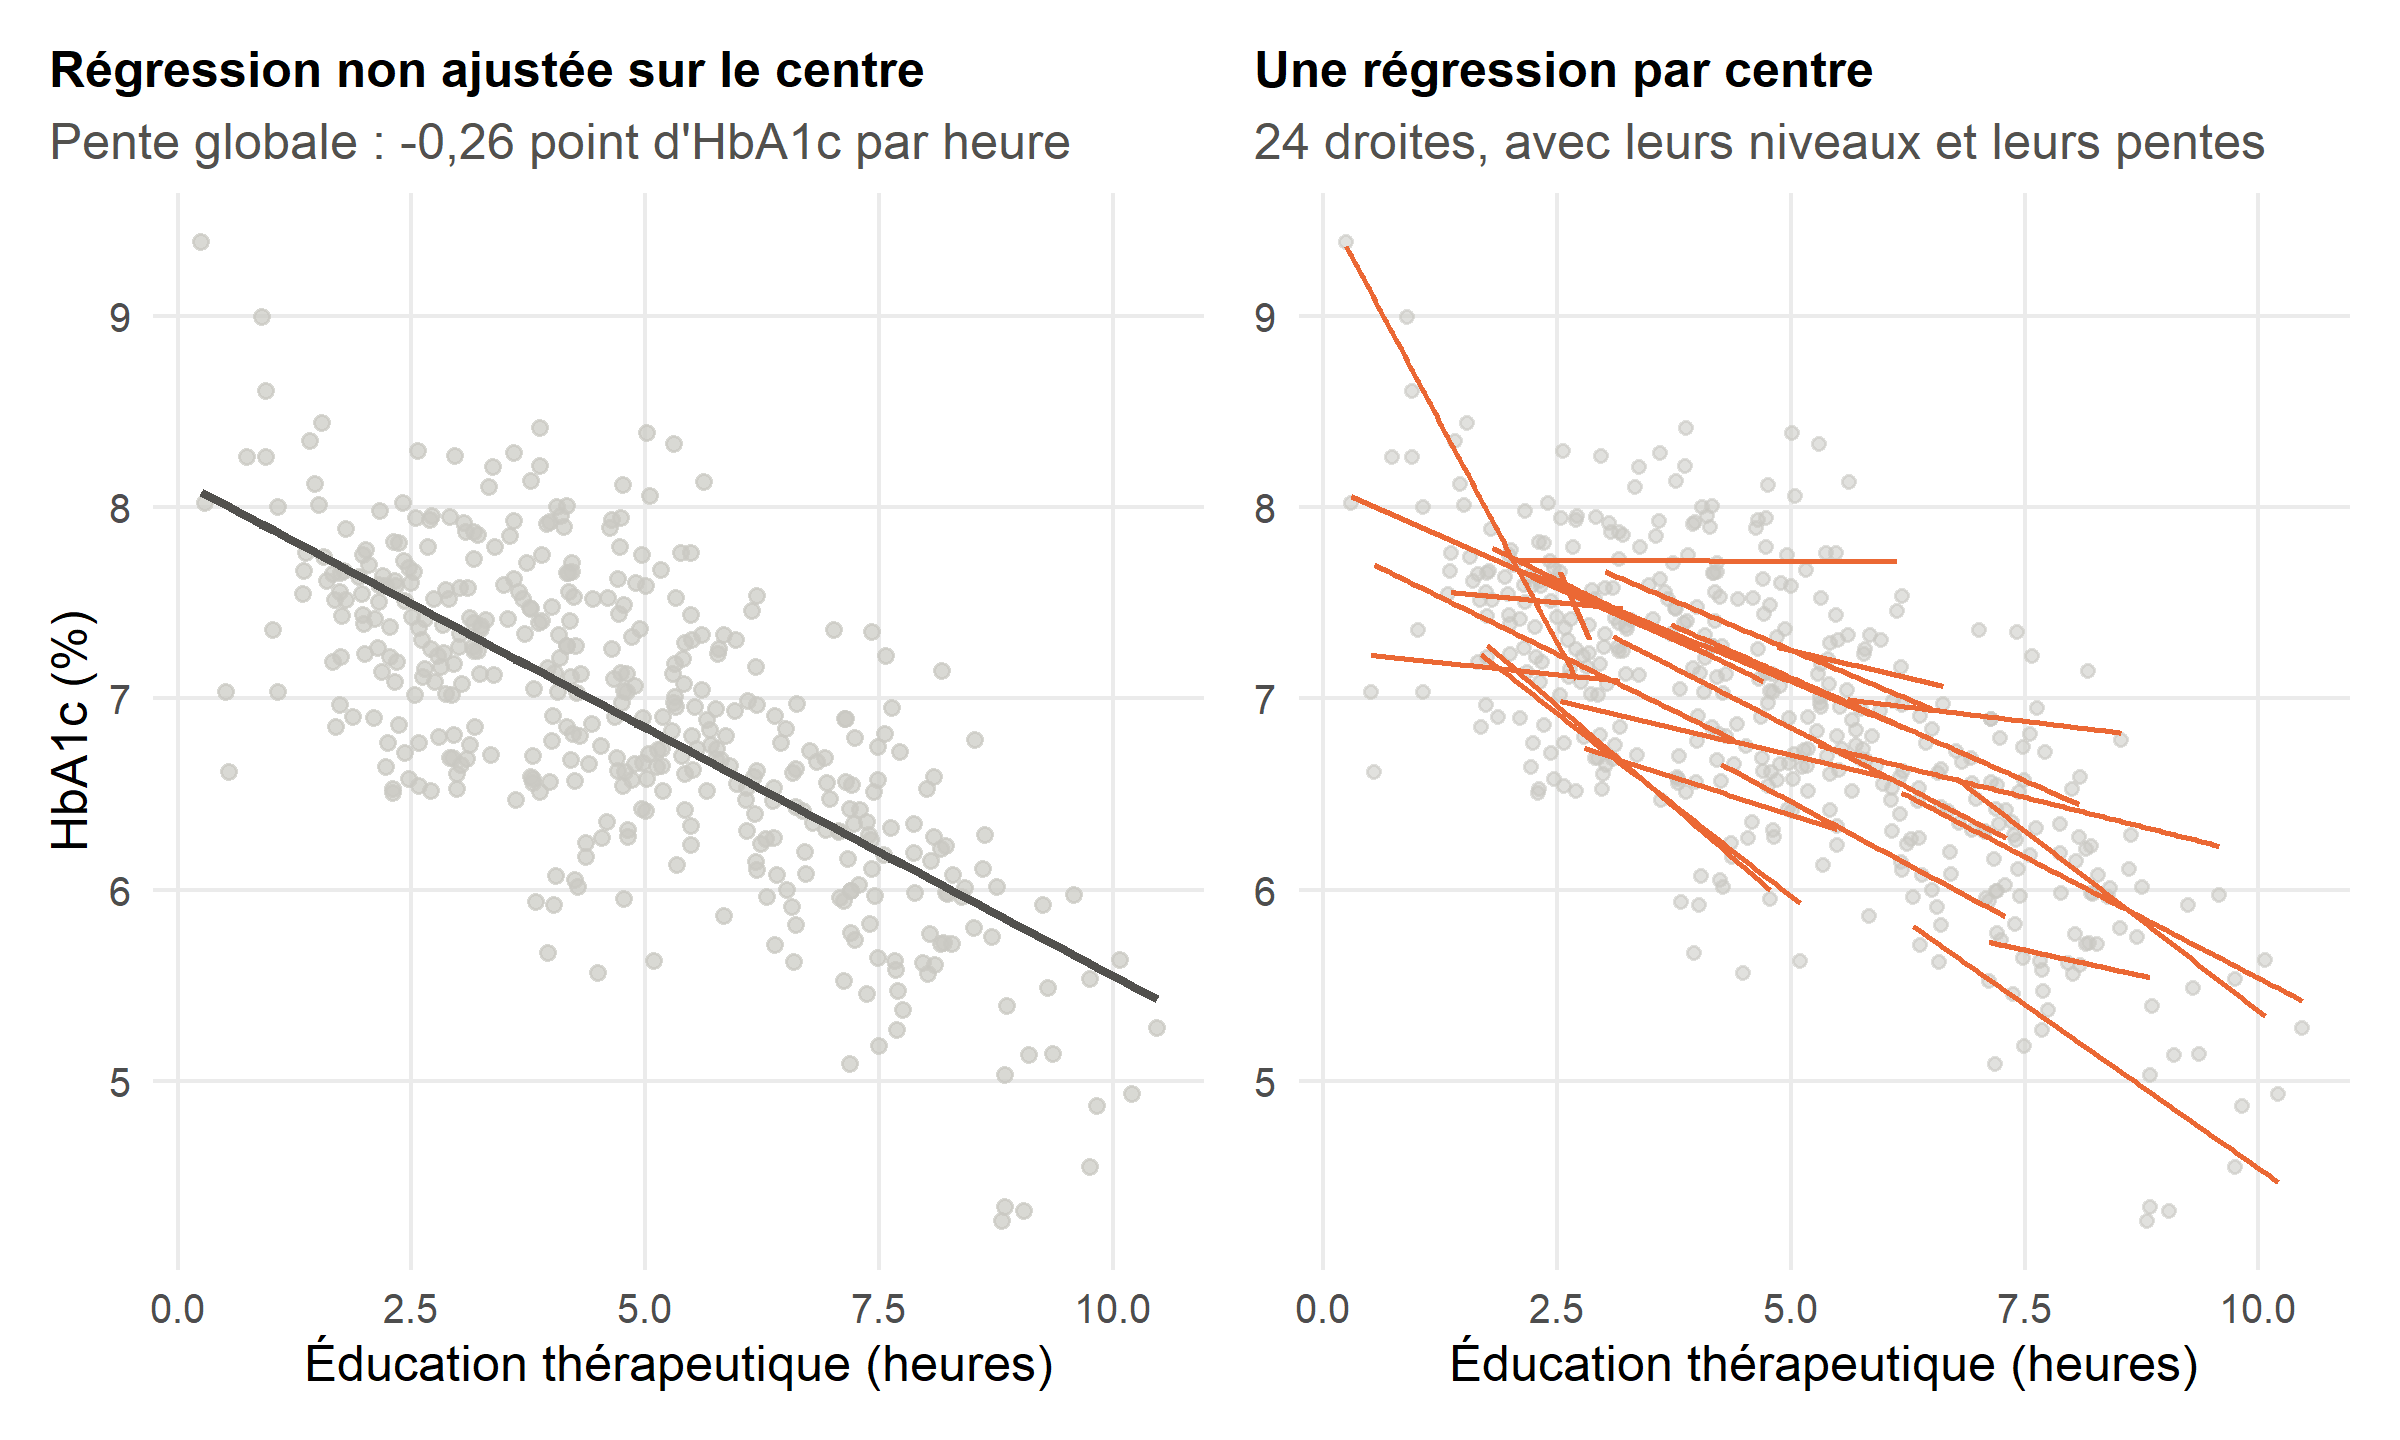
Comme souvent, il peut être bon de représenter graphiquement nos données. À gauche, on a le nuage de points de tous les patients, avec une seule droite de régression. On retrouve bien une association négative : plus d’éducation thérapeutique va, en moyenne, avec une HbA1c plus faible. À droite, on a tracé une droite par centre. La tendance générale est la même, mais les droites ne se superposent pas : certaines sont plus hautes, d’autres plus pentues. Voilà ce que notre droite unique ne montre pas !
1.4 Une droite pour tous, ou des coefficients propres à chaque centre ?
Notons \(Y_i\) l’HbA1c du patient \(i\), en pourcentage, et \(X_i\) son nombre d’heures d’éducation thérapeutique.
1.4.1 Une seule droite pour tous les patients
C’est la régression linéaire simple que l’on connaît : \[ Y_i=\beta_0+\beta_1X_i+\varepsilon_i \]
On utilise le même intercept et la même pente pour les 431 patients, sans indiquer au modèle dans quel centre ils ont été pris en charge. C’est la droite globale, à gauche de la Figure 2, dont la pente vaut -0,26 point d’HbA1c par heure.
La droite unique donne une association globale, mais ne décrit pas les niveaux et les pentes propres aux centres. De plus, elle laisse dans les erreurs les particularités partagées par leurs patients : le calcul habituel de l’erreur standard, qui suppose ces erreurs indépendantes, n’est donc pas adapté. Pour notre question, nous allons d’abord tenir compte des différences de niveau entre centres.
1.4.2 Un intercept par centre, avec une pente commune
Une première idée serait d’ajouter le centre comme variable qualitative, comme nous l’avons fait dans le chapitre sur la régression multiple. Pour chaque patient, on crée des variables nommées C01, C02, C03, etc. : C02 vaut 1 si le patient est pris en charge dans le centre C02 et 0 sinon. Même principe pour les autres.
En choisissant C01 comme centre de référence, le modèle s’écrit alors :
\[ \begin{aligned} Y_i ={}& \beta_0 + \beta_1 X_i \\ & {}+ \beta_{2}\,\mathrm{C02} + \beta_{3}\,\mathrm{C03} + \beta_{4}\,\mathrm{C04} \\ & {}+ \beta_{5}\,\mathrm{C05} + \beta_{6}\,\mathrm{C06} + \beta_{7}\,\mathrm{C07} \\ & {}+ \beta_{8}\,\mathrm{C08} + \beta_{9}\,\mathrm{C09} + \beta_{10}\,\mathrm{C10} \\ & {}+ \beta_{11}\,\mathrm{C11} + \beta_{12}\,\mathrm{C12} + \beta_{13}\,\mathrm{C13} \\ & {}+ \beta_{14}\,\mathrm{C14} + \beta_{15}\,\mathrm{C15} + \beta_{16}\,\mathrm{C16} \\ & {}+ \beta_{17}\,\mathrm{C17} + \beta_{18}\,\mathrm{C18} + \beta_{19}\,\mathrm{C19} \\ & {}+ \beta_{20}\,\mathrm{C20} + \beta_{21}\,\mathrm{C21} + \beta_{22}\,\mathrm{C22} \\ & {}+ \beta_{23}\,\mathrm{C23} + \beta_{24}\,\mathrm{C24} + \varepsilon_i \end{aligned} \]
Ca en fait du monde !
Comme d’habitude :
- \(\beta_0\) est l’intercept de C01 : l’HbA1c moyenne prédite dans ce centre pour 0 heure d’éducation ;
- \(\beta_1\) est la variation moyenne d’HbA1c associée à une heure d’éducation supplémentaire, au sein d’un même centre. On suppose cette pente identique dans tous les centres ;
- \(\beta_2\) est la différence d’HbA1c moyenne entre C02 et C01, pour un même nombre d’heures d’éducation. Si \(\beta_2<0\), la droite de C02 est en dessous de celle de C01 ;
- \(\beta_3\) compare C03 à C01, \(\beta_4\) compare C04 à C01, etc.
En écrivant les modèles, voici ce qu’on a pour trois patients :
\[ \begin{aligned} \text{Patient de C01 :}\quad Y_i &= \beta_0&+\beta_1X_i+\varepsilon_i, \\ \text{Patient de C02 :}\quad Y_i &= (\beta_0+\beta_2)&+\beta_1X_i+\varepsilon_i, \\ \text{Patient de C03 :}\quad Y_i &= (\beta_0+\beta_3)&+\beta_1X_i+\varepsilon_i \end{aligned} \]
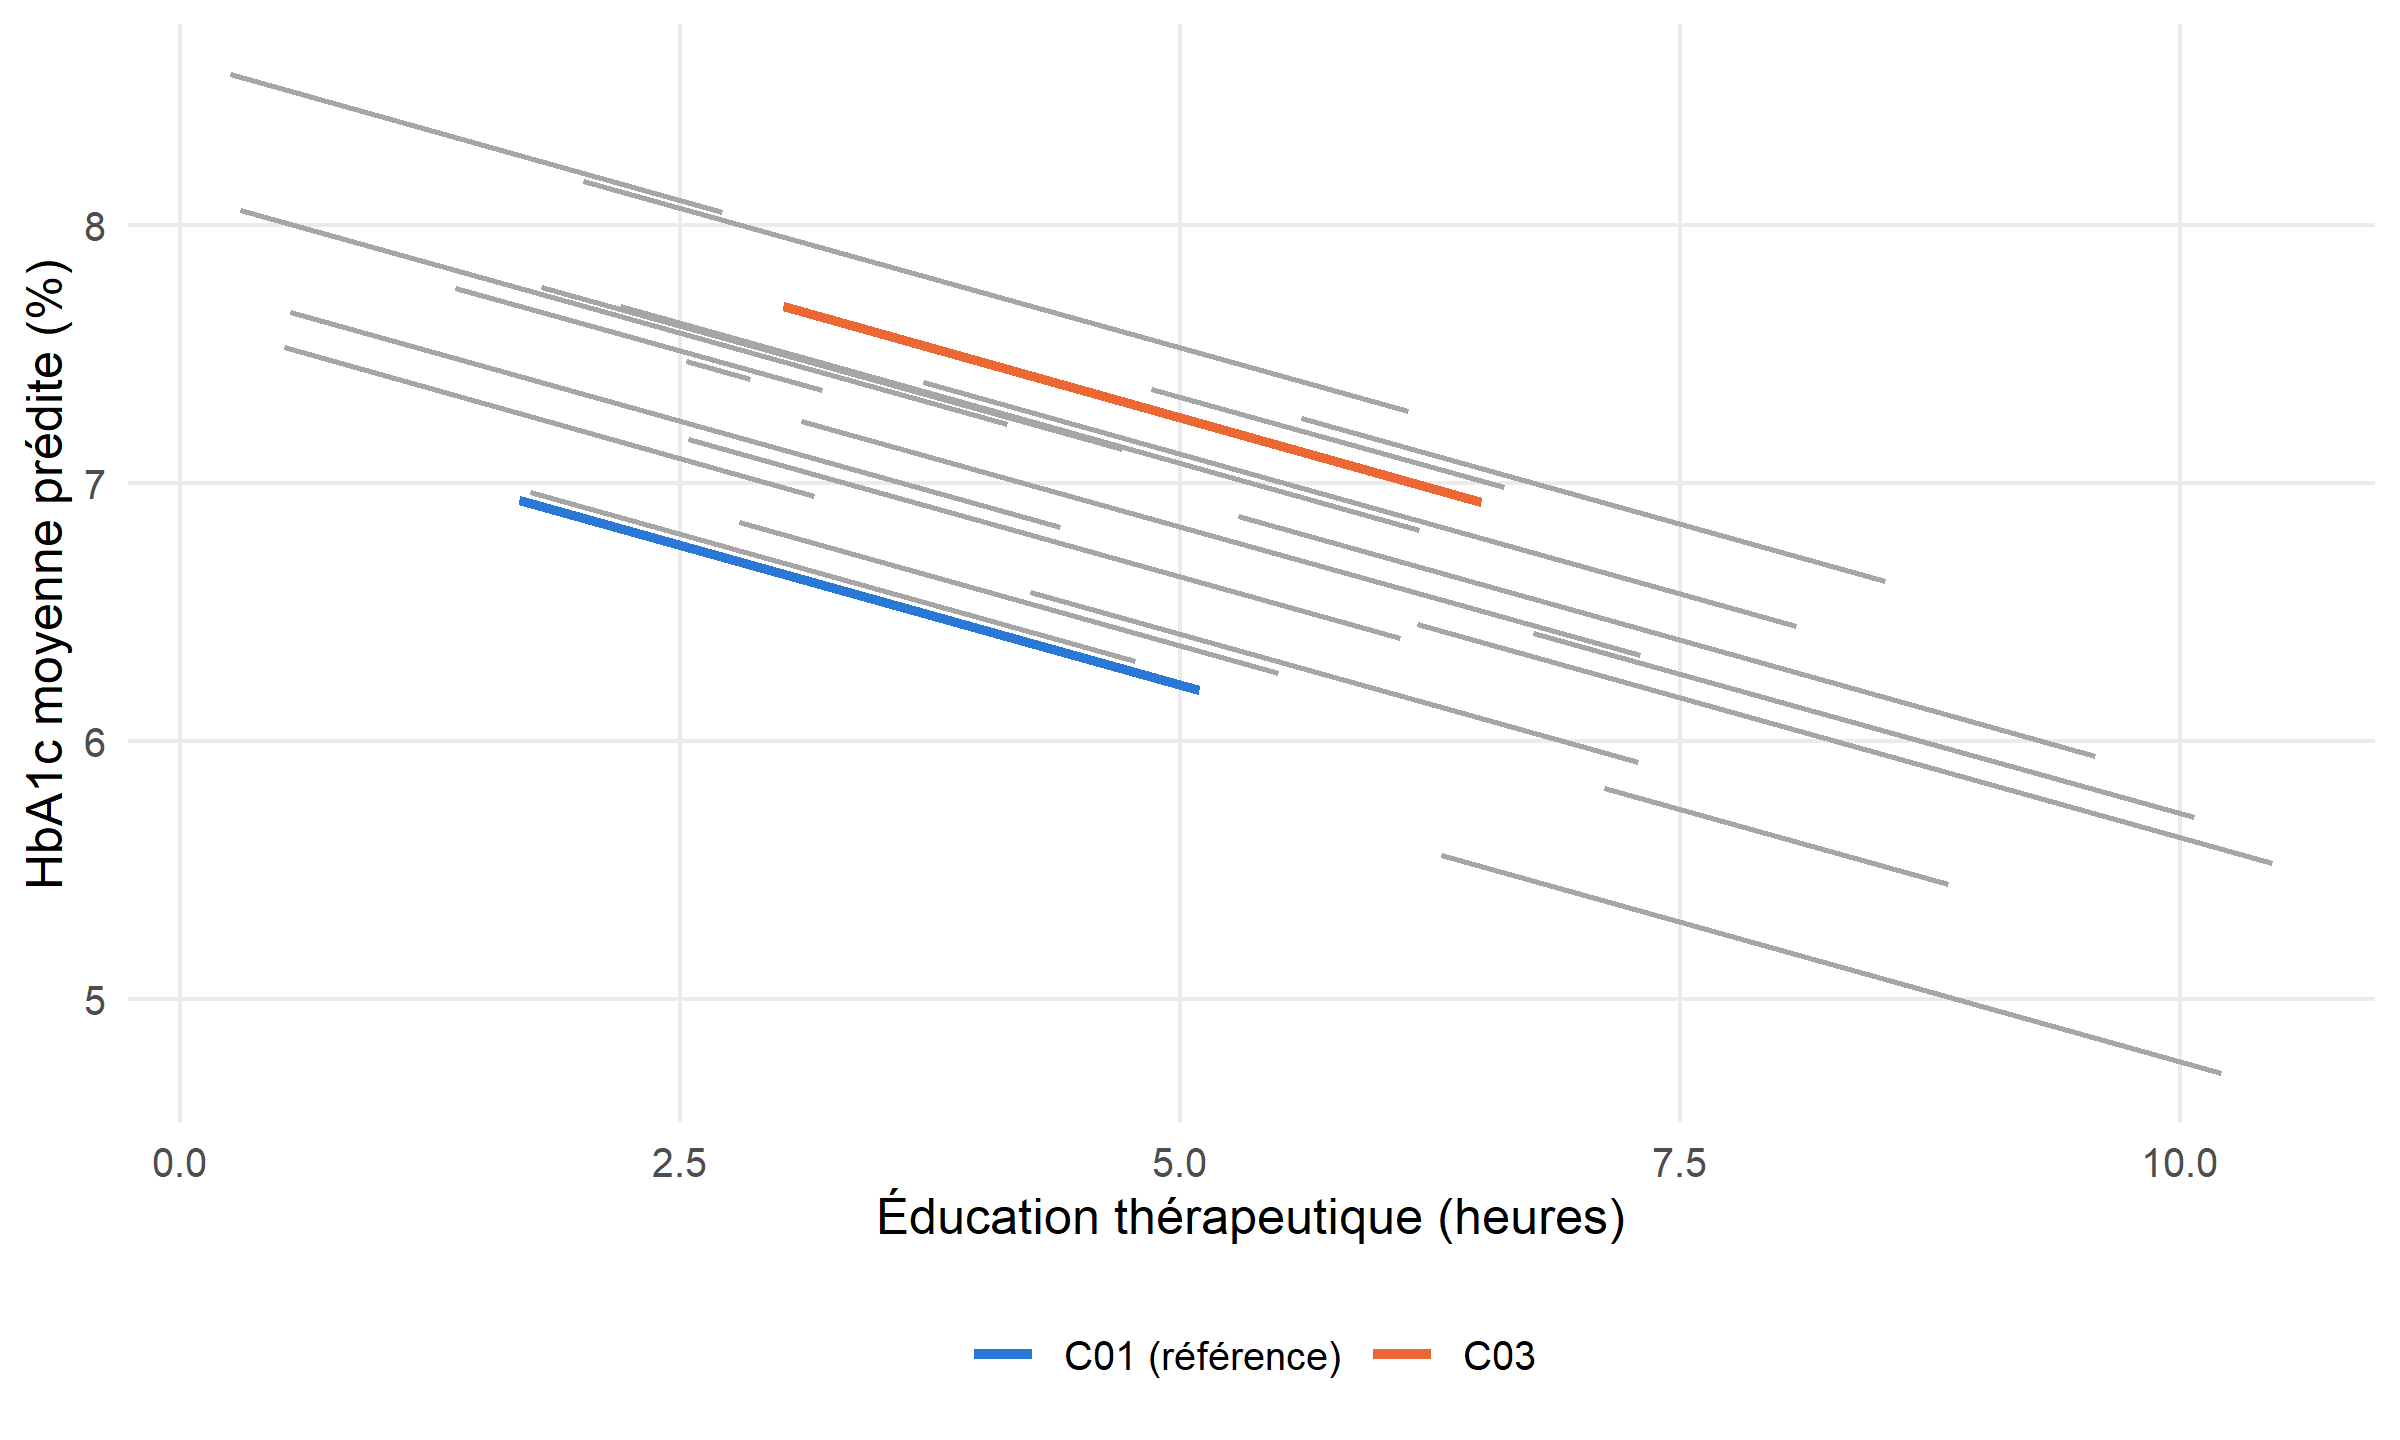
On voit bien que les valeurs de \(Y\) (l’HbA1c) évoluent toujours de la même manière, et que seul le niveau de départ (pour \(X = 0\) heure d’éducation thérapeutique) change. Autrement dit, la pente est la même pour tous, mais pas l’intercept (qui est propre à chaque centre). Graphiquement, cela se traduit par 24 droites parallèles (une par centre) comme présenté en Figure 3 :
Cette solution est donc utile ! Elle peut même suffire si l’on cherche une pente commune et que les erreurs restantes vérifient les hypothèses du modèle. Mais elle suppose toujours que l’association (= la pente) est la même dans tous les centres. Si on suspecte que les associations varient d’un centre à l’autre - donc si on suspecte une modification de l’effet de l’éducation thérapeutique selon le centre - il suffit d’ajouter des interactions. Faisons cela !
1.4.3 Un intercept et une pente par centre
Imposer une évolution commune à tous les centres est une hypothèse assez forte. On peut imaginer que l’effet de l’éducation thérapeutique varie selon le centre. Pour tenir compte de cette possibilité, on peut ajouter des interactions entre le nombre d’heures d’éducation et les variables indicatrices de centre.
En plus des 25 coefficients présents, on ajoute maintenant 23 interactions entre le nombre d’heures d’éducation et les variables indicatrices de centre ! Avec un peu de courage, on peut écrire le modèle complet :
\[ \begin{aligned} Y_i ={}& \beta_0 + \beta_1 X_i \\ & {}+ \beta_{2}\,\mathrm{C02} + \beta_{3}\,\mathrm{C03} + \beta_{4}\,\mathrm{C04} \\ & {}+ \beta_{5}\,\mathrm{C05} + \beta_{6}\,\mathrm{C06} + \beta_{7}\,\mathrm{C07} \\ & {}+ \beta_{8}\,\mathrm{C08} + \beta_{9}\,\mathrm{C09} + \beta_{10}\,\mathrm{C10} \\ & {}+ \beta_{11}\,\mathrm{C11} + \beta_{12}\,\mathrm{C12} + \beta_{13}\,\mathrm{C13} \\ & {}+ \beta_{14}\,\mathrm{C14} + \beta_{15}\,\mathrm{C15} + \beta_{16}\,\mathrm{C16} \\ & {}+ \beta_{17}\,\mathrm{C17} + \beta_{18}\,\mathrm{C18} + \beta_{19}\,\mathrm{C19} \\ & {}+ \beta_{20}\,\mathrm{C20} + \beta_{21}\,\mathrm{C21} + \beta_{22}\,\mathrm{C22} \\ & {}+ \beta_{23}\,\mathrm{C23} + \beta_{24}\,\mathrm{C24} + \beta_{25}\,X_i\,\mathrm{C02} \\ & {}+ \beta_{26}\,X_i\,\mathrm{C03} + \beta_{27}\,X_i\,\mathrm{C04} + \beta_{28}\,X_i\,\mathrm{C05} \\ & {}+ \beta_{29}\,X_i\,\mathrm{C06} + \beta_{30}\,X_i\,\mathrm{C07} + \beta_{31}\,X_i\,\mathrm{C08} \\ & {}+ \beta_{32}\,X_i\,\mathrm{C09} + \beta_{33}\,X_i\,\mathrm{C10} + \beta_{34}\,X_i\,\mathrm{C11} \\ & {}+ \beta_{35}\,X_i\,\mathrm{C12} + \beta_{36}\,X_i\,\mathrm{C13} + \beta_{37}\,X_i\,\mathrm{C14} \\ & {}+ \beta_{38}\,X_i\,\mathrm{C15} + \beta_{39}\,X_i\,\mathrm{C16} + \beta_{40}\,X_i\,\mathrm{C17} \\ & {}+ \beta_{41}\,X_i\,\mathrm{C18} + \beta_{42}\,X_i\,\mathrm{C19} + \beta_{43}\,X_i\,\mathrm{C20} \\ & {}+ \beta_{44}\,X_i\,\mathrm{C21} + \beta_{45}\,X_i\,\mathrm{C22} + \beta_{46}\,X_i\,\mathrm{C23} \\ & {}+ \beta_{47}\,X_i\,\mathrm{C24} + \varepsilon_i \end{aligned} \]
Ca va de mal en pis…
Nous voilà avec 48 coefficients de régression, de \(\beta_0\) à \(\beta_{47}\) ! Les 23 derniers coefficients représentent des écarts de pente par rapport à C01. Par exemple, \(\beta_{25}\) indique de combien la pente de C02 diffère de celle de C01.
Pour lire le modèle, il suffit à nouveau de remplacer les variables de centre par 0 ou 1 :
\[ \begin{aligned} \text{Patient de C01 :}\quad Y_i &= \beta_0 &+&\beta_1X_i+\varepsilon_i, \\ \text{Patient de C02 :}\quad Y_i &= (\beta_0+\beta_2) &+&(\beta_1+\beta_{25})X_i+\varepsilon_i, \\ \text{Patient de C03 :}\quad Y_i &= (\beta_0+\beta_3) &+&(\beta_1+\beta_{26})X_i+\varepsilon_i \end{aligned} \]
On voit donc bien que l’évolution de l’HbA1c n’est plus la même dans tous les centres, en plus d’avoir un niveau de départ différent. En bref, chaque centre a maintenant sa propre droite, avec son intercept et sa pente, ce qui est représenté en Figure 4.
Mais du coup, il n’y a aucun soucis, nos modèles comme on a vu marchent très bien ! Non ?
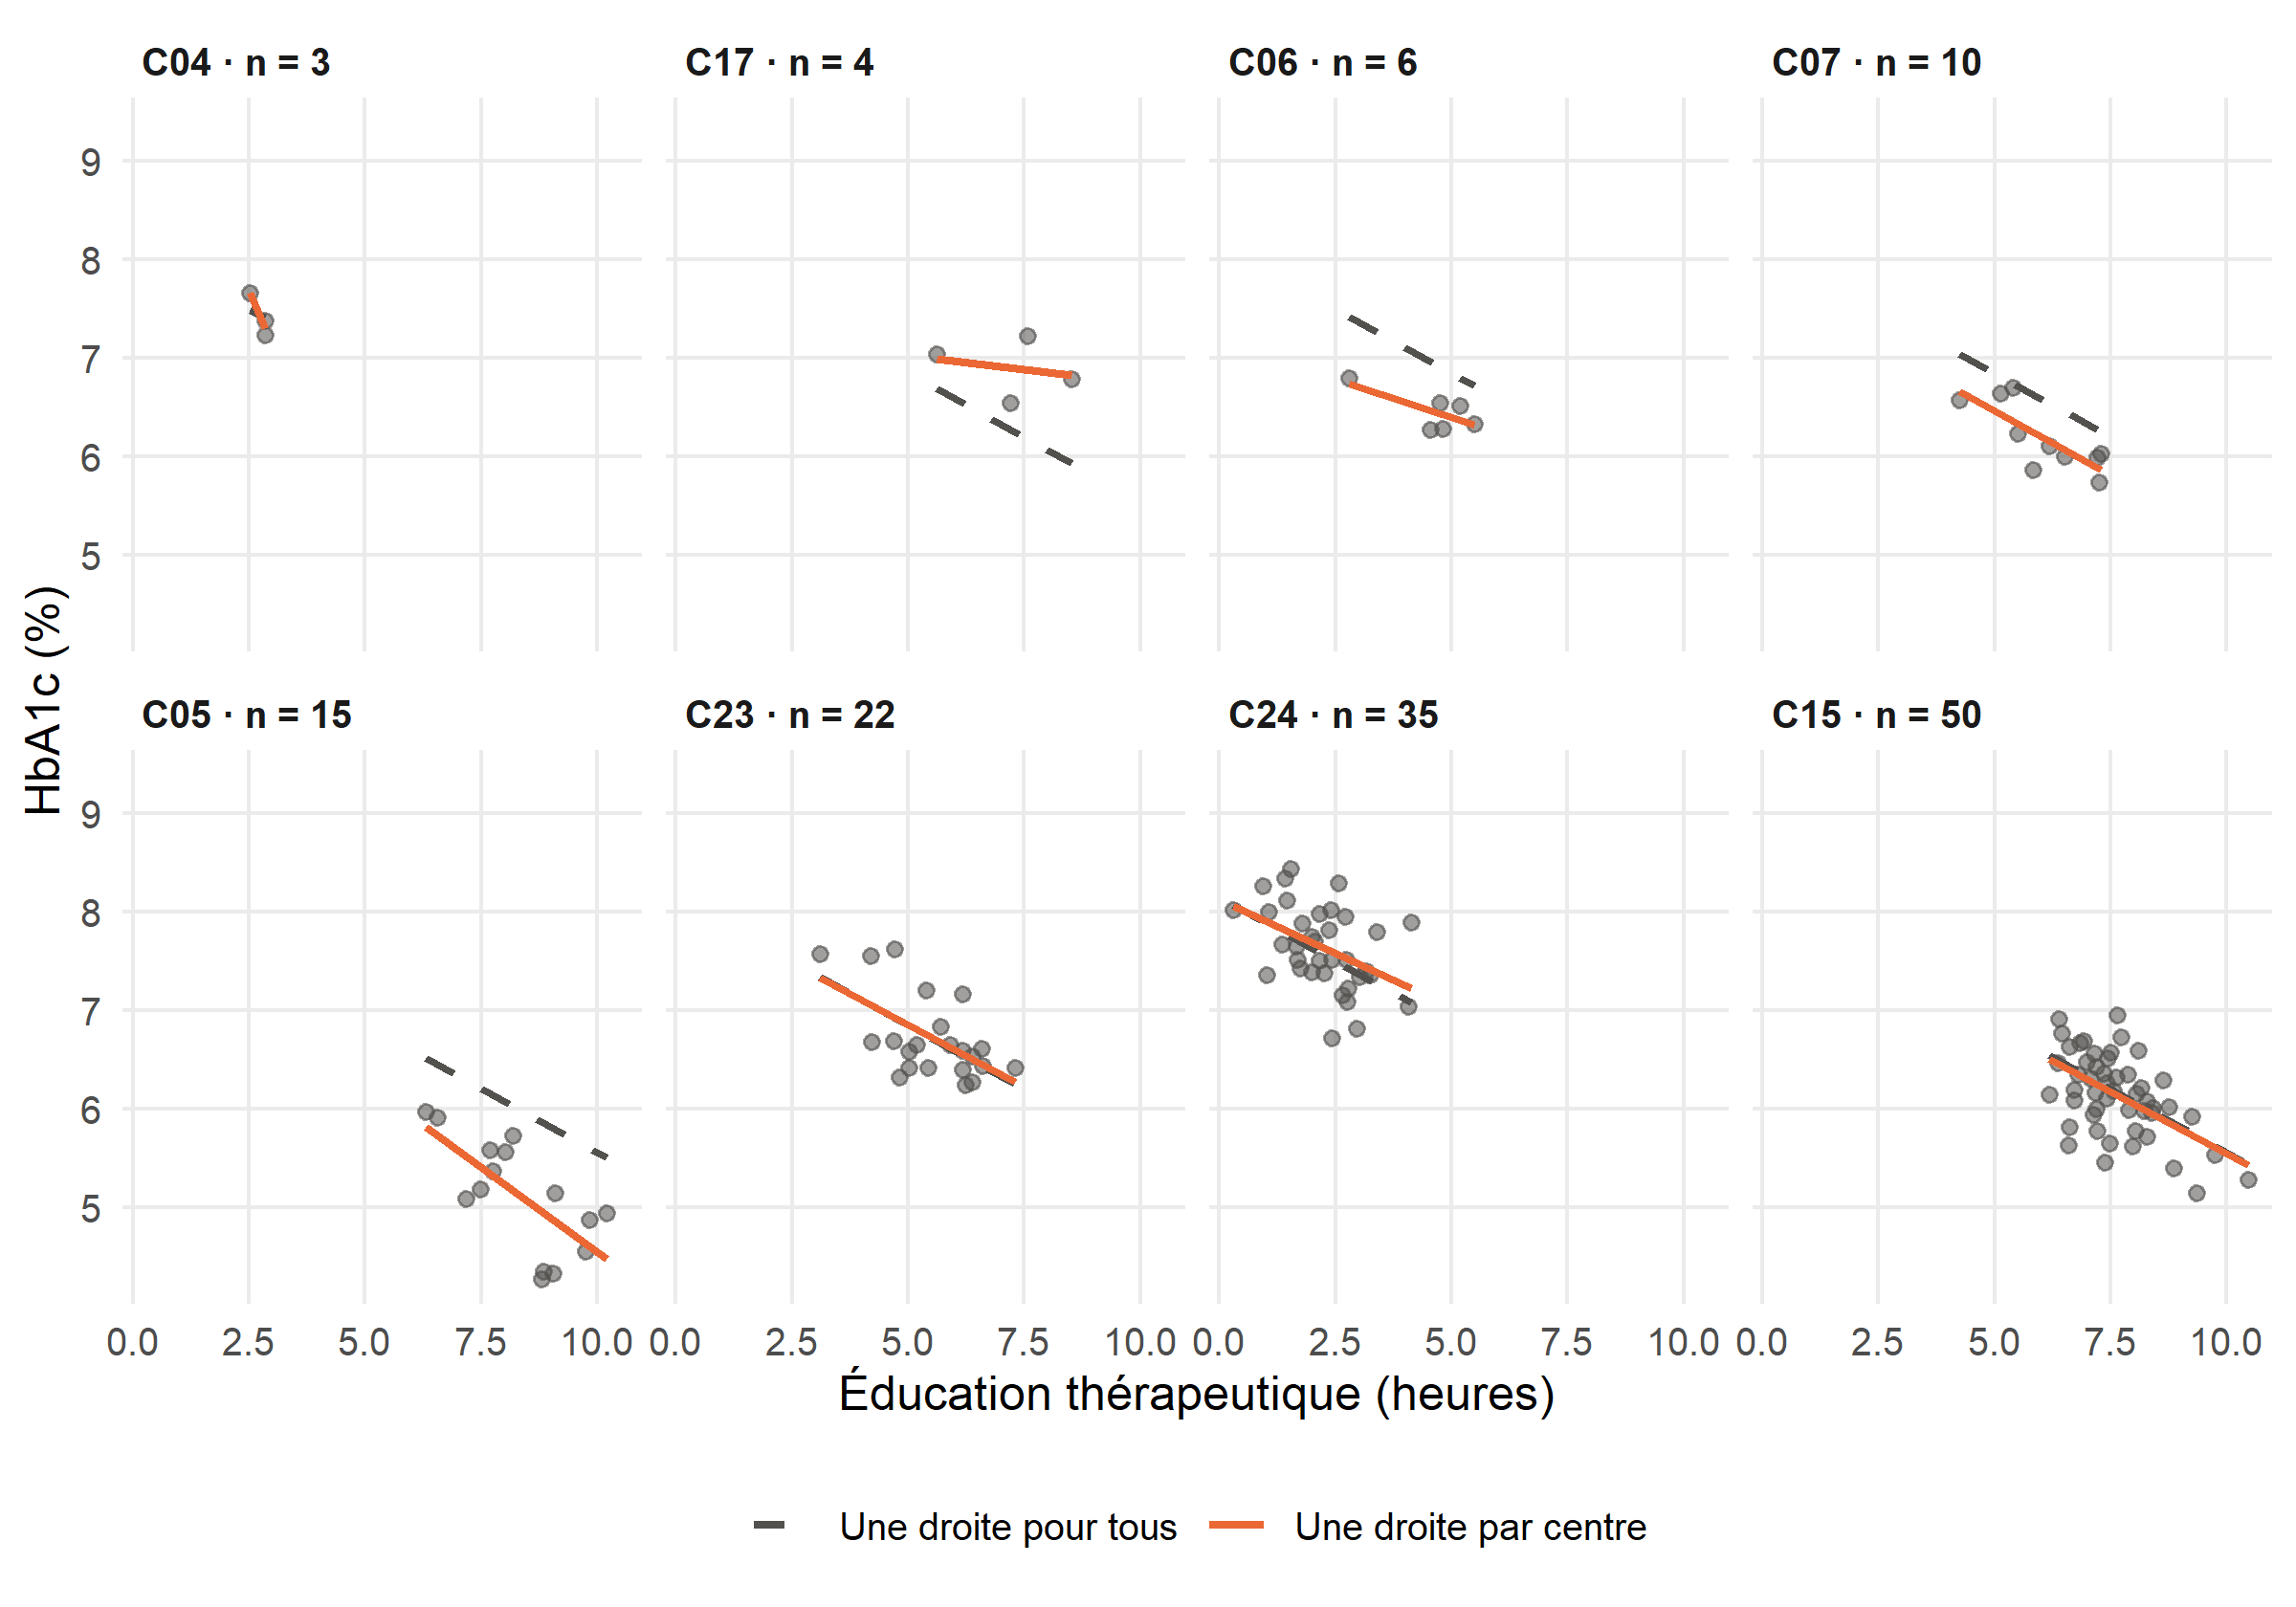
D’une part, c’est EXTRÊMEMENT fastidieux à écrire (et ne parlons même pas de la présentation des résultats …). D’autre part, il y a un problème plus subtil : les petits centres fournissent très peu d’information pour estimer leurs coefficients. Autrement dit, une droite calculée sur 3 patients ne contient pas autant d’information qu’une droite calculée sur 50 patients, et ceci impactera les conclusions que nous pourrions tirer. Pour le voir, regardons les pentes propres aux centres et leurs intervalles de confiance, calculés à partir du modèle avec toutes les interactions que nous venons d’écrire :
| Centre | Patients (n) | Pente estimée | IC à 95 % |
|---|---|---|---|
| C04 | 3 | −1,12 | [−4,11 ; 1,86] |
| C17 | 4 | −0,06 | [−0,42 ; 0,30] |
| C06 | 6 | −0,16 | [−0,52 ; 0,20] |
| C07 | 10 | −0,26 | [−0,51 ; −0,01] |
| C05 | 15 | −0,34 | [−0,52 ; −0,17] |
| C23 | 22 | −0,25 | [−0,42 ; −0,08] |
| C24 | 35 | −0,22 | [−0,37 ; −0,06] |
| C15 | 50 | −0,25 | [−0,37 ; −0,13] |
Chaque ligne donne la pente du centre. Par exemple, la pente du centre C04 est de -1,12, donc bien plus grande que les autres ! Cependant, l’IC est tellement large qu’il contient 0, nous empêchant de conclure à une association différente de 0 dans ce centre au seuil de 5 %. Ceci peut s’expliquer par le fait qu’on ait QUE 3 petients. Dans C15, avec 50 patients, la pente est moins marquée (-0,25), mais son intervalle étant plus étroit, il ne contient pas 0 et l’effet est significatif !
En bref, estimer un coefficient par centre ne semble donc pas être une mauvaise idée en soi, mais on y voit plusieurs limites :
- on a BEAUCOUP de coefficients à estimer : ici, 24 intercepts et 24 pentes, soit 48 coefficients de régression. Imaginez maintenant que vous ayiez des résultats au sein de 100 centres maintenants : bref, c’est pas tenable ;
- peu d’information est partagée d’un centre à l’autre pour estimer les pentes. De fait, la pente d’un centre repose sur ses propres patients, ce qui aura notamment pour effet de gonfler les IC des petits centres ;
- on n’a pas de pente moyenne d’un effet dans notre population, seulement les pentes propres à chaque centre.
L’idéal serait donc d’avoir (en gros) l’effet global dans notre population, l’effet propre à chaque groupe et que les effets estimés soient relativement précis (pour avoir des IC le moins large possible).
1.5 Un dernier pour la route : privation de sommeil (données longitudinales)
Tout ce qu’on a dit avant valait pour des données groupées, mais la situation est semblables pour des données longitudinales, où l’on mesure plusieurs fois quelque choses au sein d’un même individu.
Le dataset comprend trois variables :
-
Reaction: le temps de réaction moyen (ms) ; -
Days: le jour de l’étude (de 0 à 9), appelé “nombre de jours de privation de sommeil” dans la documentation ; -
Subject: l’identifiant du sujet, avec 18 sujets et 10 mesures par sujet.
NoteRemarque
Si on chipote, il se trouve que, d’après la documentation de lme4, les jours 0 et 1 étaient des jours d’adaptation et d’entraînement, et le jour 2 correspondait à la mesure de référence. La restriction de sommeil n’a commencé qu’ensuite. Nous analysons ici les 10 jours pour illustrer la méthode (comme dans la plupart des tutos), et conservons l’appellation “jours de privation de sommeil” pour Days. En toute rigueur, pour étudier spécifiquement l’évolution à partir de la mesure de référence, on se restreindrait aux jours 2 à 9 ! Bref.
On peut représenter la situation sujet par sujet, avec une droite de tendance estimé pour chaque sujet :
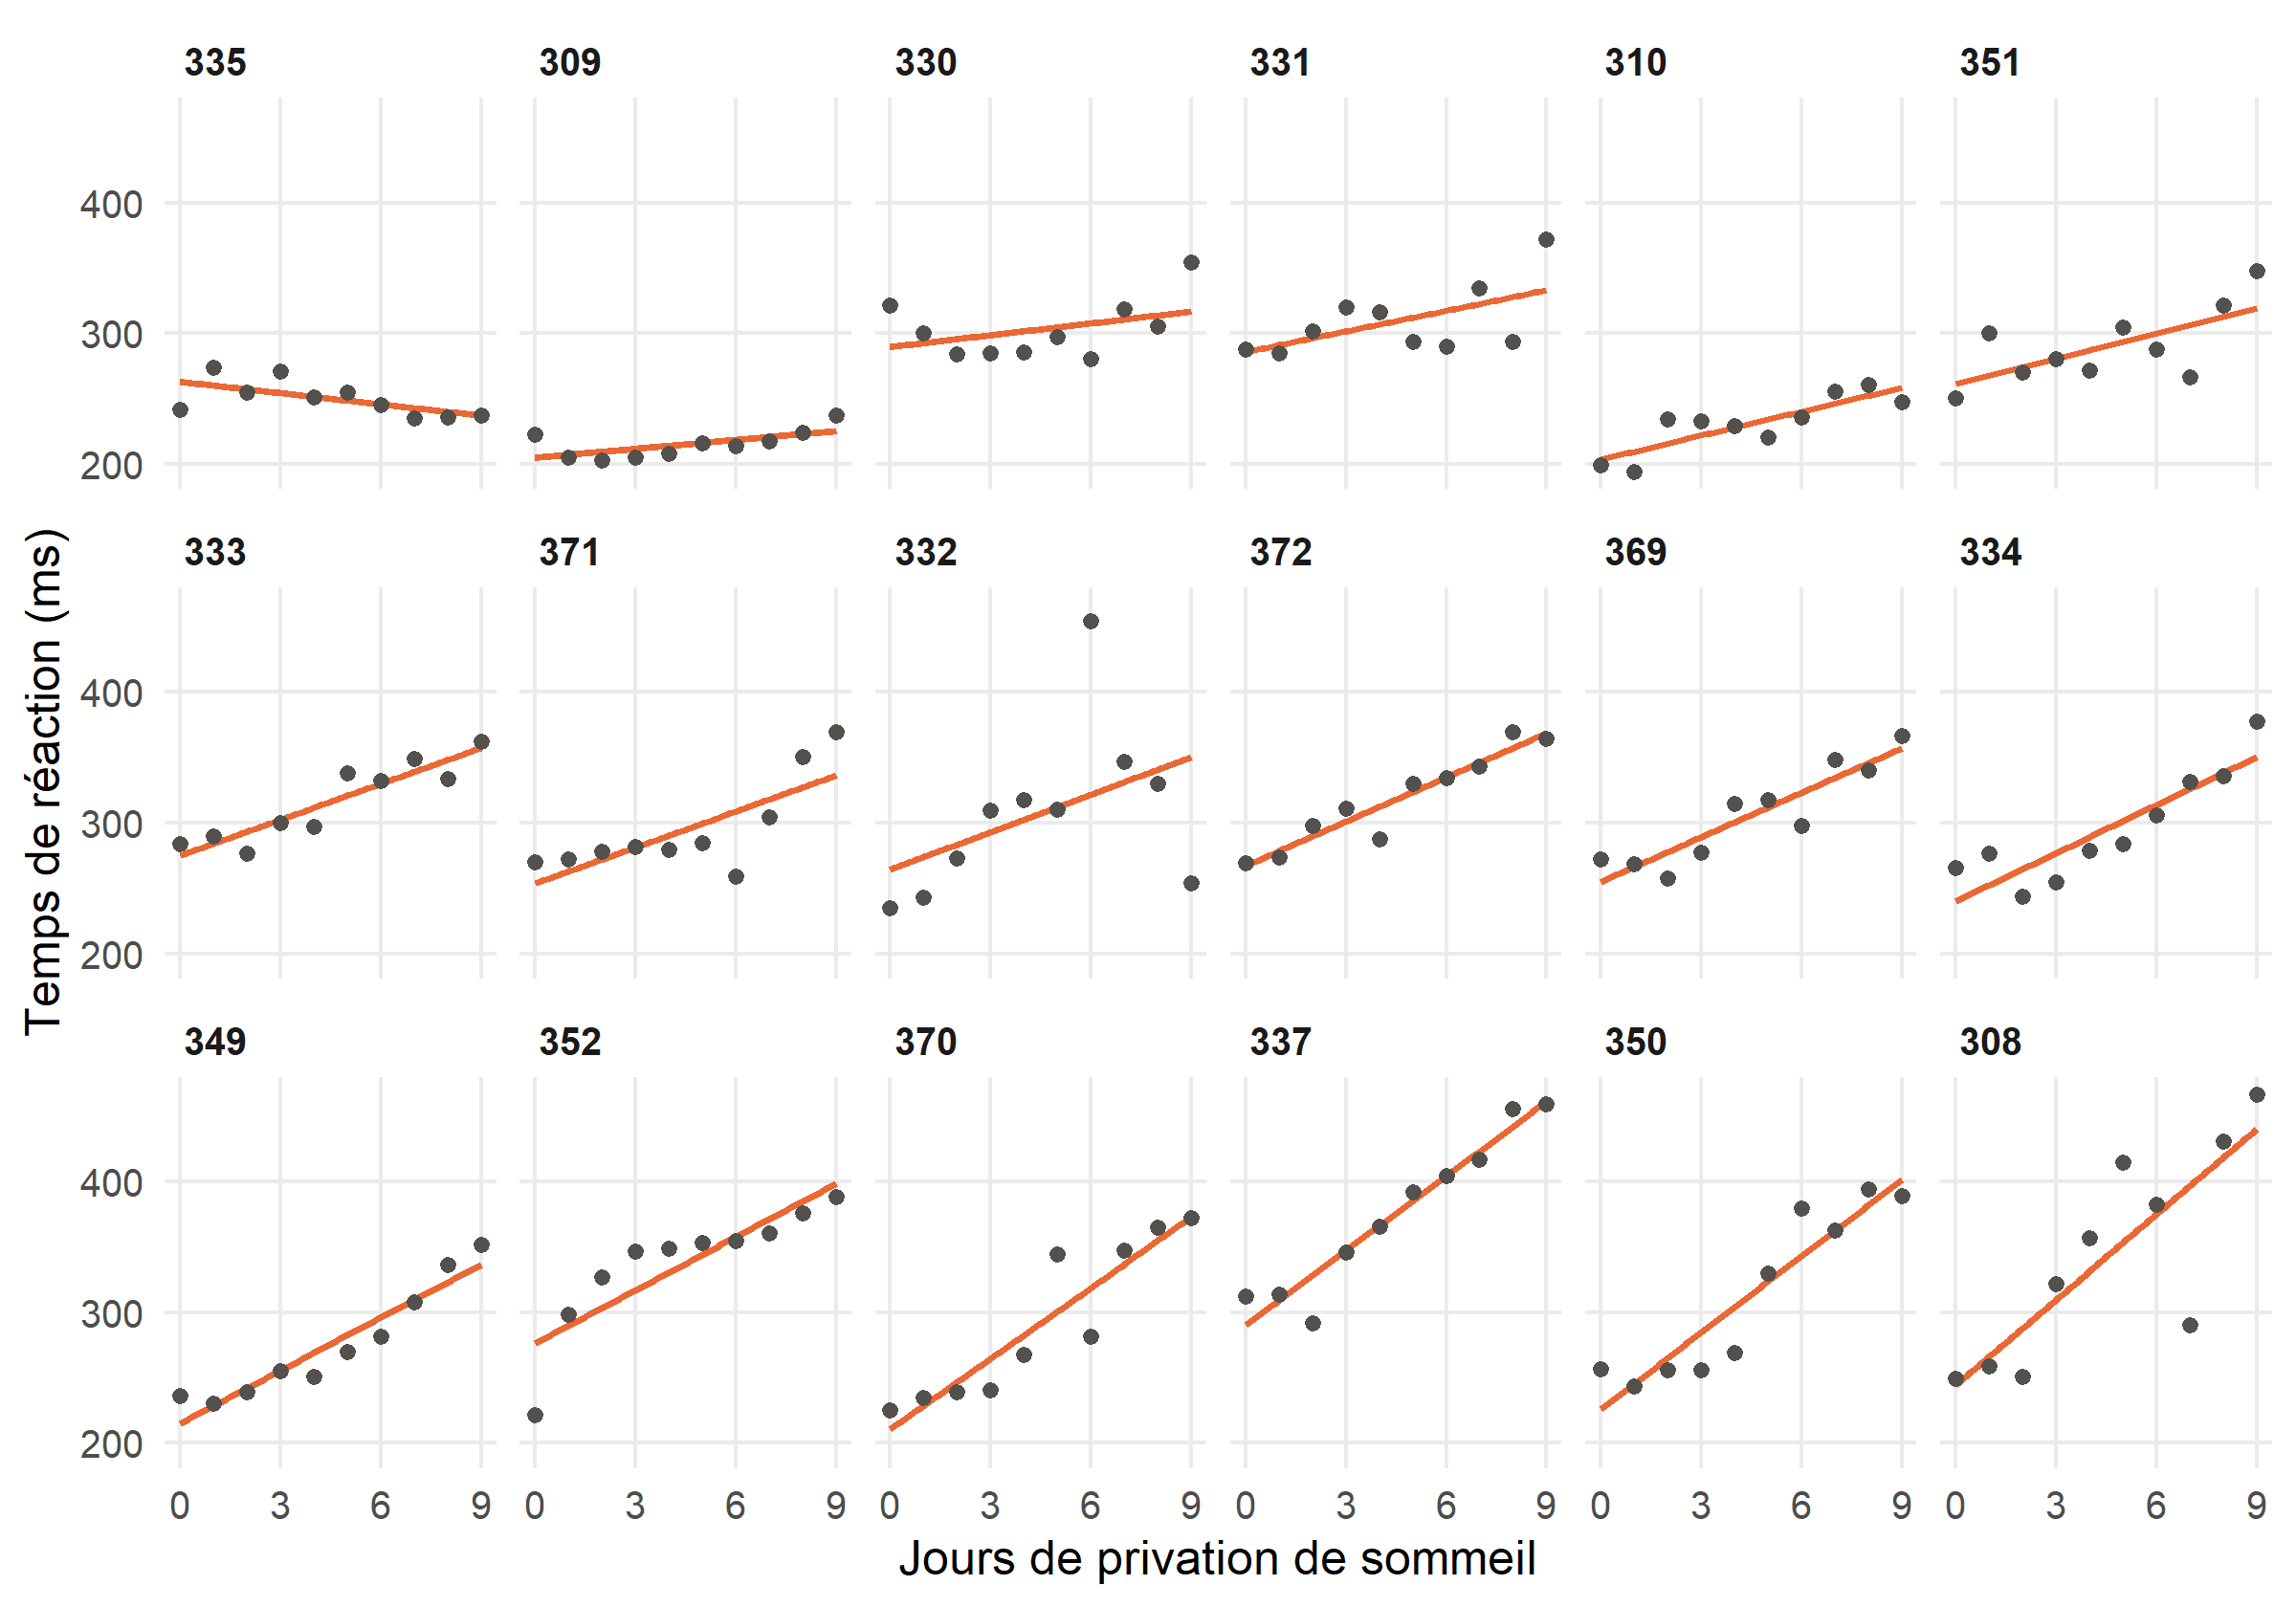
Il y a comme une sorte de ressemblance avec nos centres..
Sur la Figure 5, le temps de réaction augmente avec les jours chez presque tous les sujets : en moyenne, il y a donc une tendance générale vers une hausse de temps de réaction. Cependant, sujet par sujet, on voit que deux choses diffèrent :
- les niveaux de départ diffèrent : certains sujets sont plus rapides que d’autres dès le jour 0. Cela correspond à des différences d’intercept ;
- l’évolution dans le temps diffèrent aussi : le temps de réaction de certains sujets évolue peu, voire diminue légèrement (sujet 335), alors qu’il augmente fortement chez d’autres (sujet 308).
1.6 Et du coup ?
Quelque soit la situation, on souhaiterait pouvoir :
- Tenir compte de la corrélation entre les observations d’un même centre ou les mesures chez un même sujet ;
- Obtenir un effet moyen dans notre population ;
- Obtenir des effets propres aux regroupements (centres ou sujets) ;
- Le tout, en évitant d’avoir des erreurs standards trop grands (ce qui donnerait des IC trop larges)
Et, c’est fou, mais il se trouve qu’on a un outil statistique exactement fait pour ça !
Les références
Belenky, Gregory, Nancy J. Wesensten, David R. Thorne, et al. 2003. « Patterns of Performance Degradation and Restoration During Sleep Restriction and Subsequent Recovery: A Sleep Dose-Response Study ». Journal of Sleep Research 12 (1): 1‑12. https://doi.org/10.1046/j.1365-2869.2003.00337.x.