2 Anatomie d’un modèle linéaire mixte
Note
Pour essayer d’alléger un peu le texte, on emploie le terme groupe au sens large : il désigne ce qui rassemble plusieurs observations, donc aussi un sujet lorsqu’il est mesuré plusieurs fois.
| Dans le modèle | Données groupées (exemple 2) | Données longitudinales (exemple 3) |
|---|---|---|
| “Groupe” \(i\) | Un centre de soins | Un sujet |
| Observation \(j\) dans ce “groupe” | Un patient du centre | Une mesure chez ce sujet |
| Variable explicative | Les heures d’éducation thérapeutique. On la note généralement \(x_{ij}\) | Le temps de la j-ième mesure. On la note généralement \(t_{ij}\) |
2.1 Effets fixes et effets aléatoires
Dans la partie précédente, nous souhaitions décrire une tendance moyenne tout en laissant chaque centre ou chaque sujet avoir sa propre droite. Pour y arriver, on va décomposer les coefficients de cette droite en deux parties : ce qui est commun à l’ensemble des groupes, et l’écart propre à chacun d’eux.
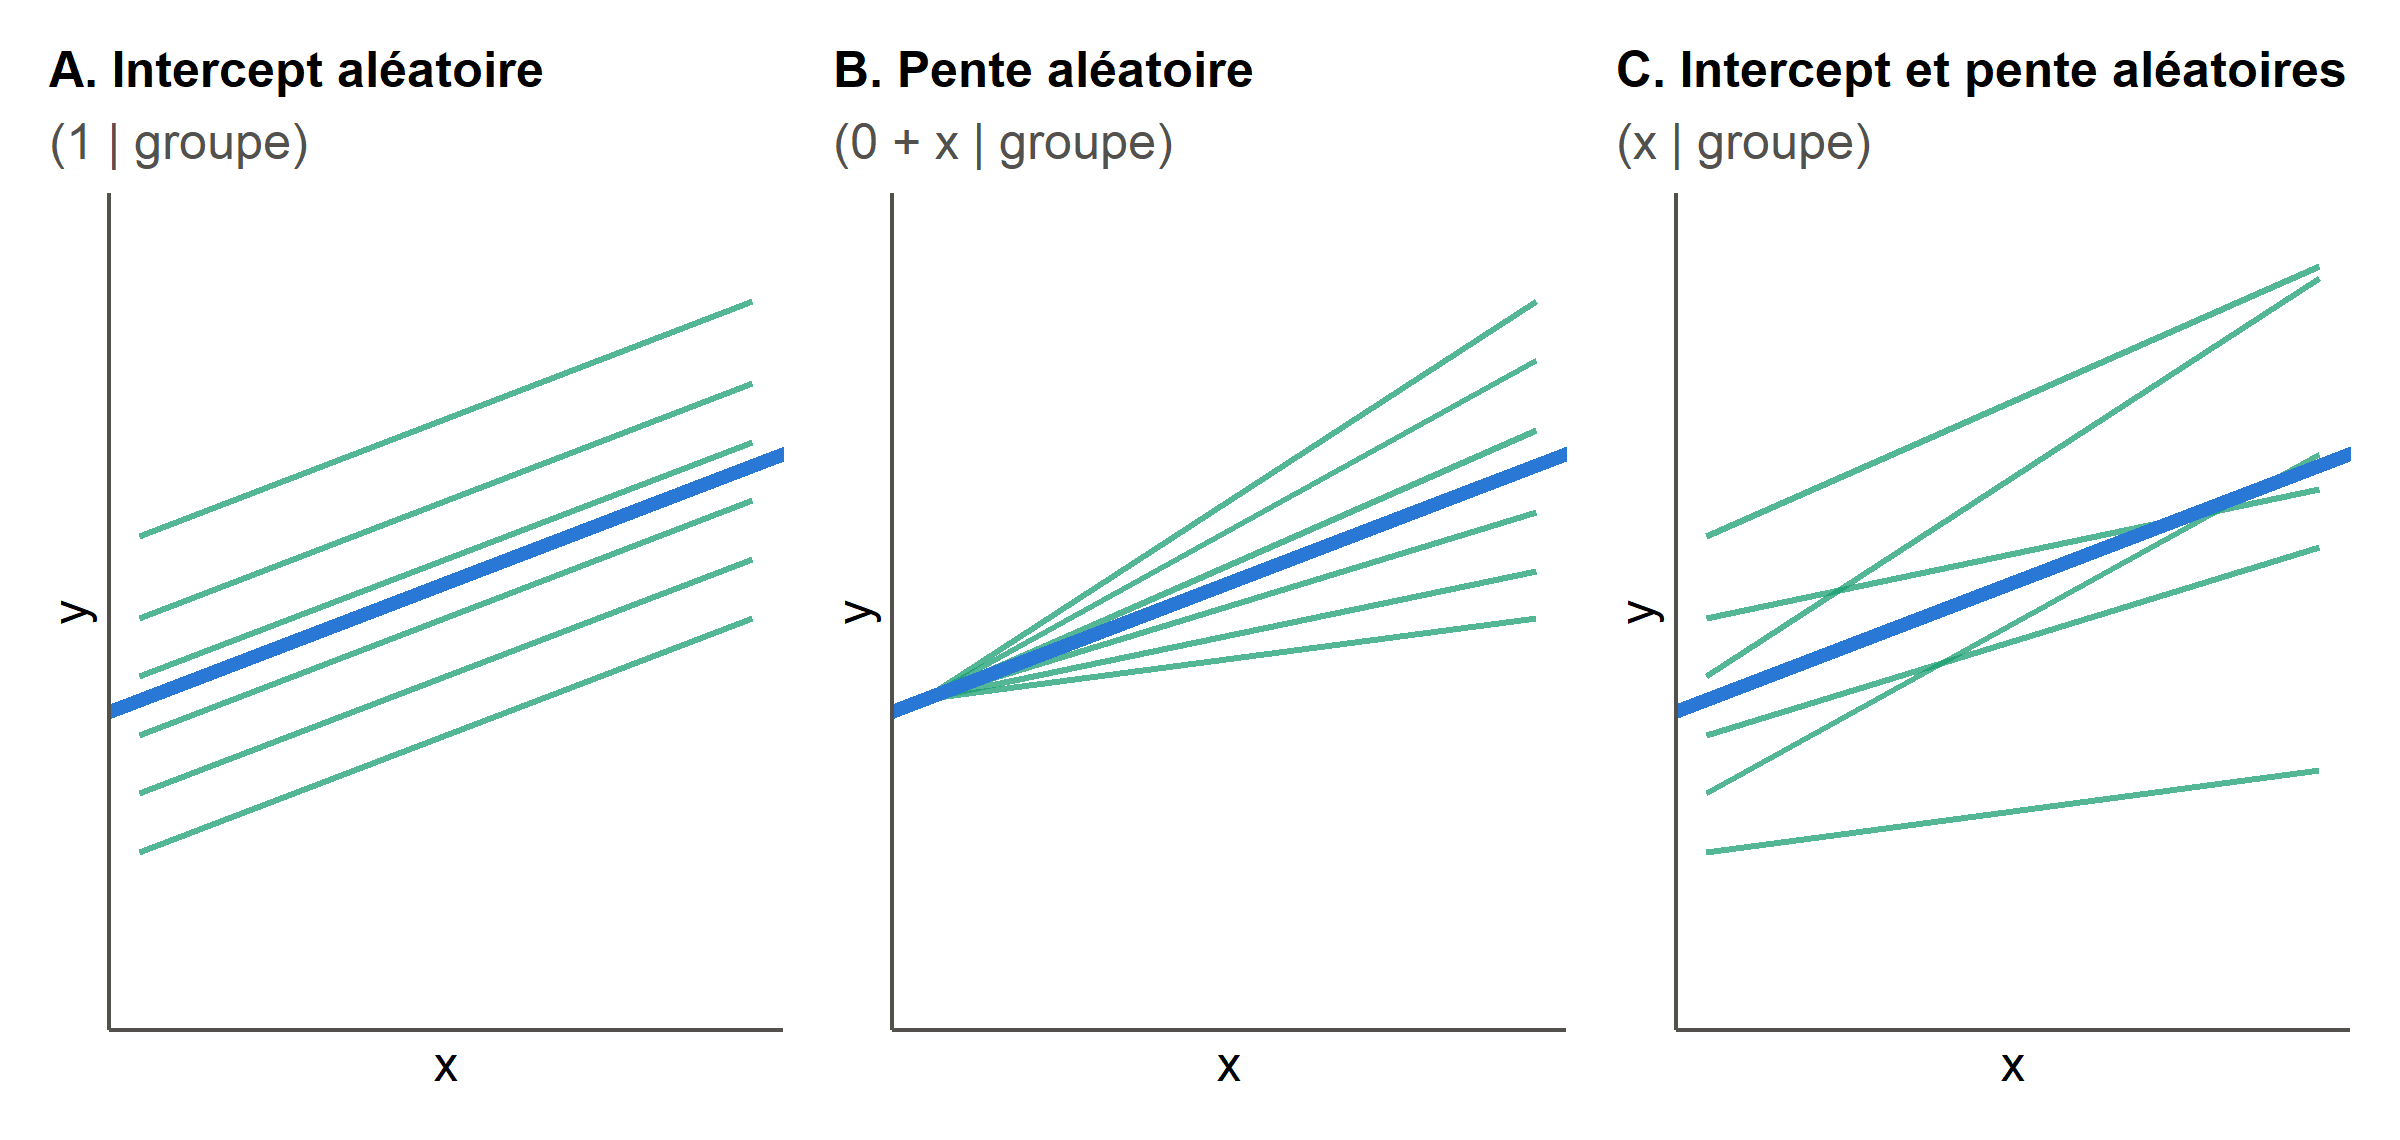
La Figure 1 présente trois grandes situations : les groupes peuvent différer seulement par leur niveau de référence (intercept aléatoire), seulement par leur pente (pente aléatoire), ou par les deux à la fois.
2.1.1 Intercept aléatoire
Commençons par le cas A : les droites ont toutes la même pente, mais leurs niveaux de référence diffèrent. Il peut s’agir de centres où l’HbA1c est globalement plus élevée, ou de sujets dont le temps de réaction est plus long dès le départ.
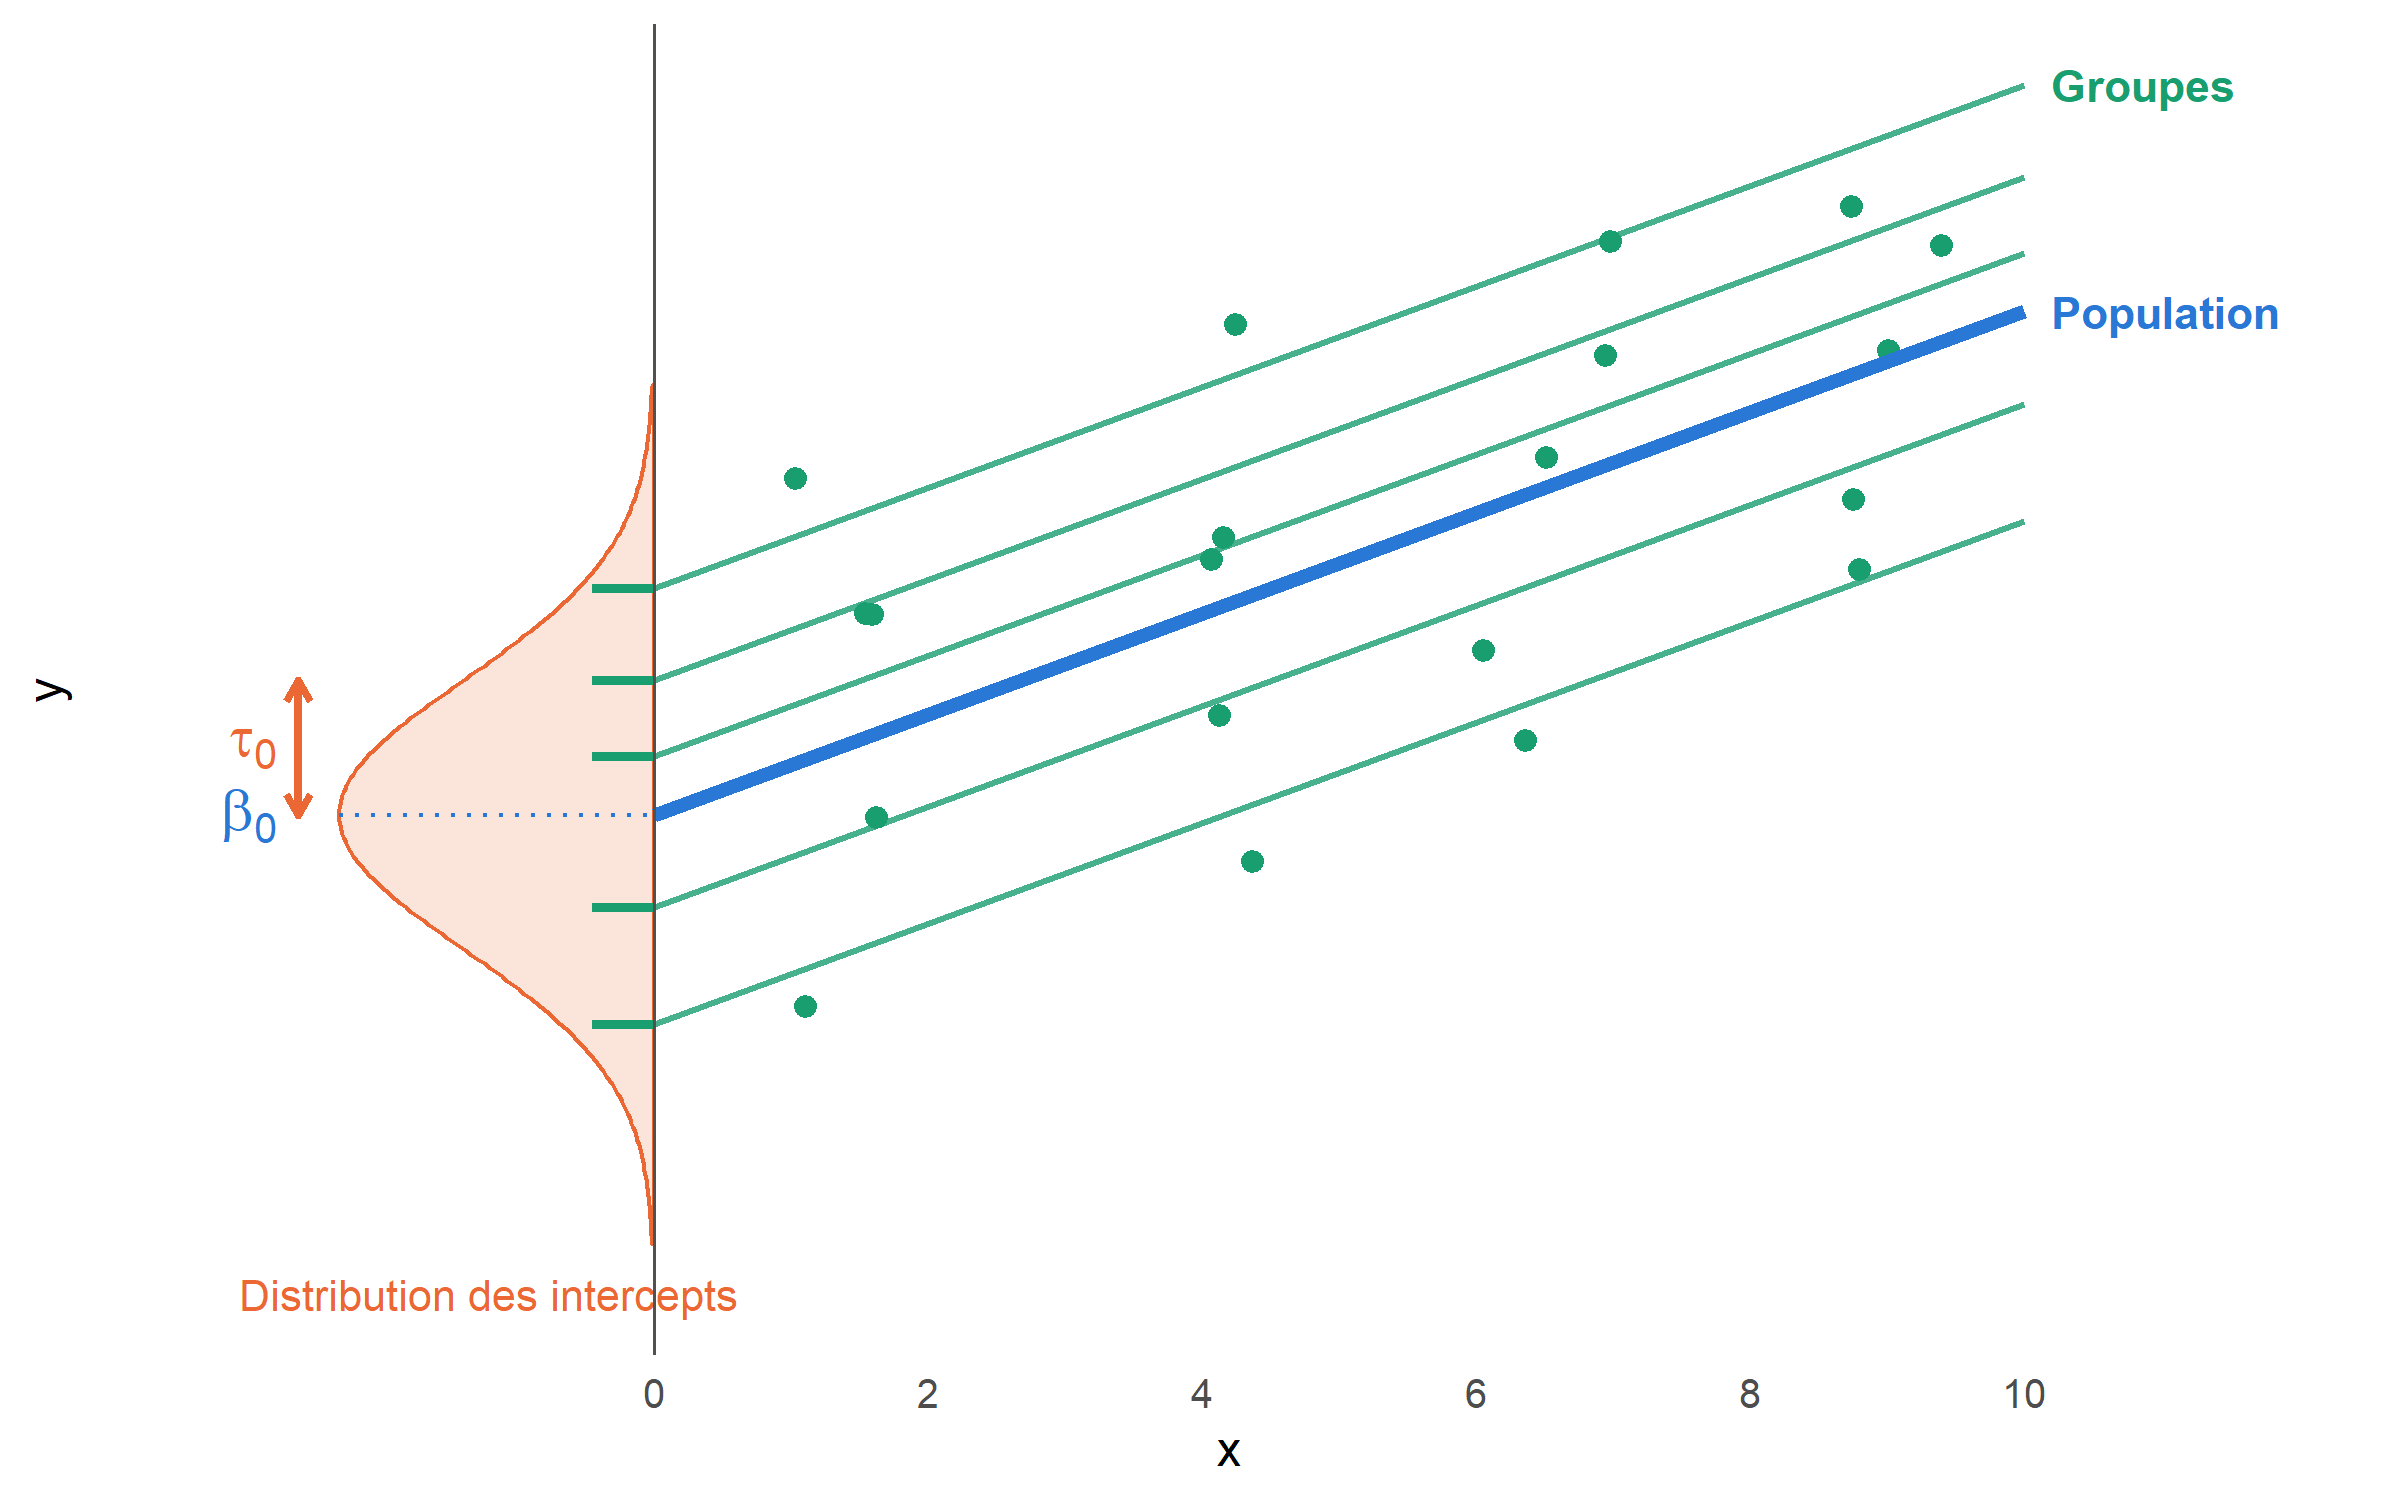
Si \(u_{0i}>0\), la droite du groupe est au-dessus de la droite moyenne ; si \(u_{0i}<0\), elle est en dessous. Plus \(\tau_0\) est grand, plus les intercepts des groupes sont dispersés autour de \(\beta_0\).
Contrairement à une régression avec une indicatrice par groupe, on n’estime donc pas chaque écart comme un coefficient libre. On estime les paramètres de leur distribution. La Figure 2 permet de visualiser cette idée.
Un modèle à intercept aléatoire serait adapté pour modéliser la situation avec la mesure avant-après, et donnerait la même réponse d’un test t de Student pour échantillons appariés !
2.1.2 Pente aléatoire
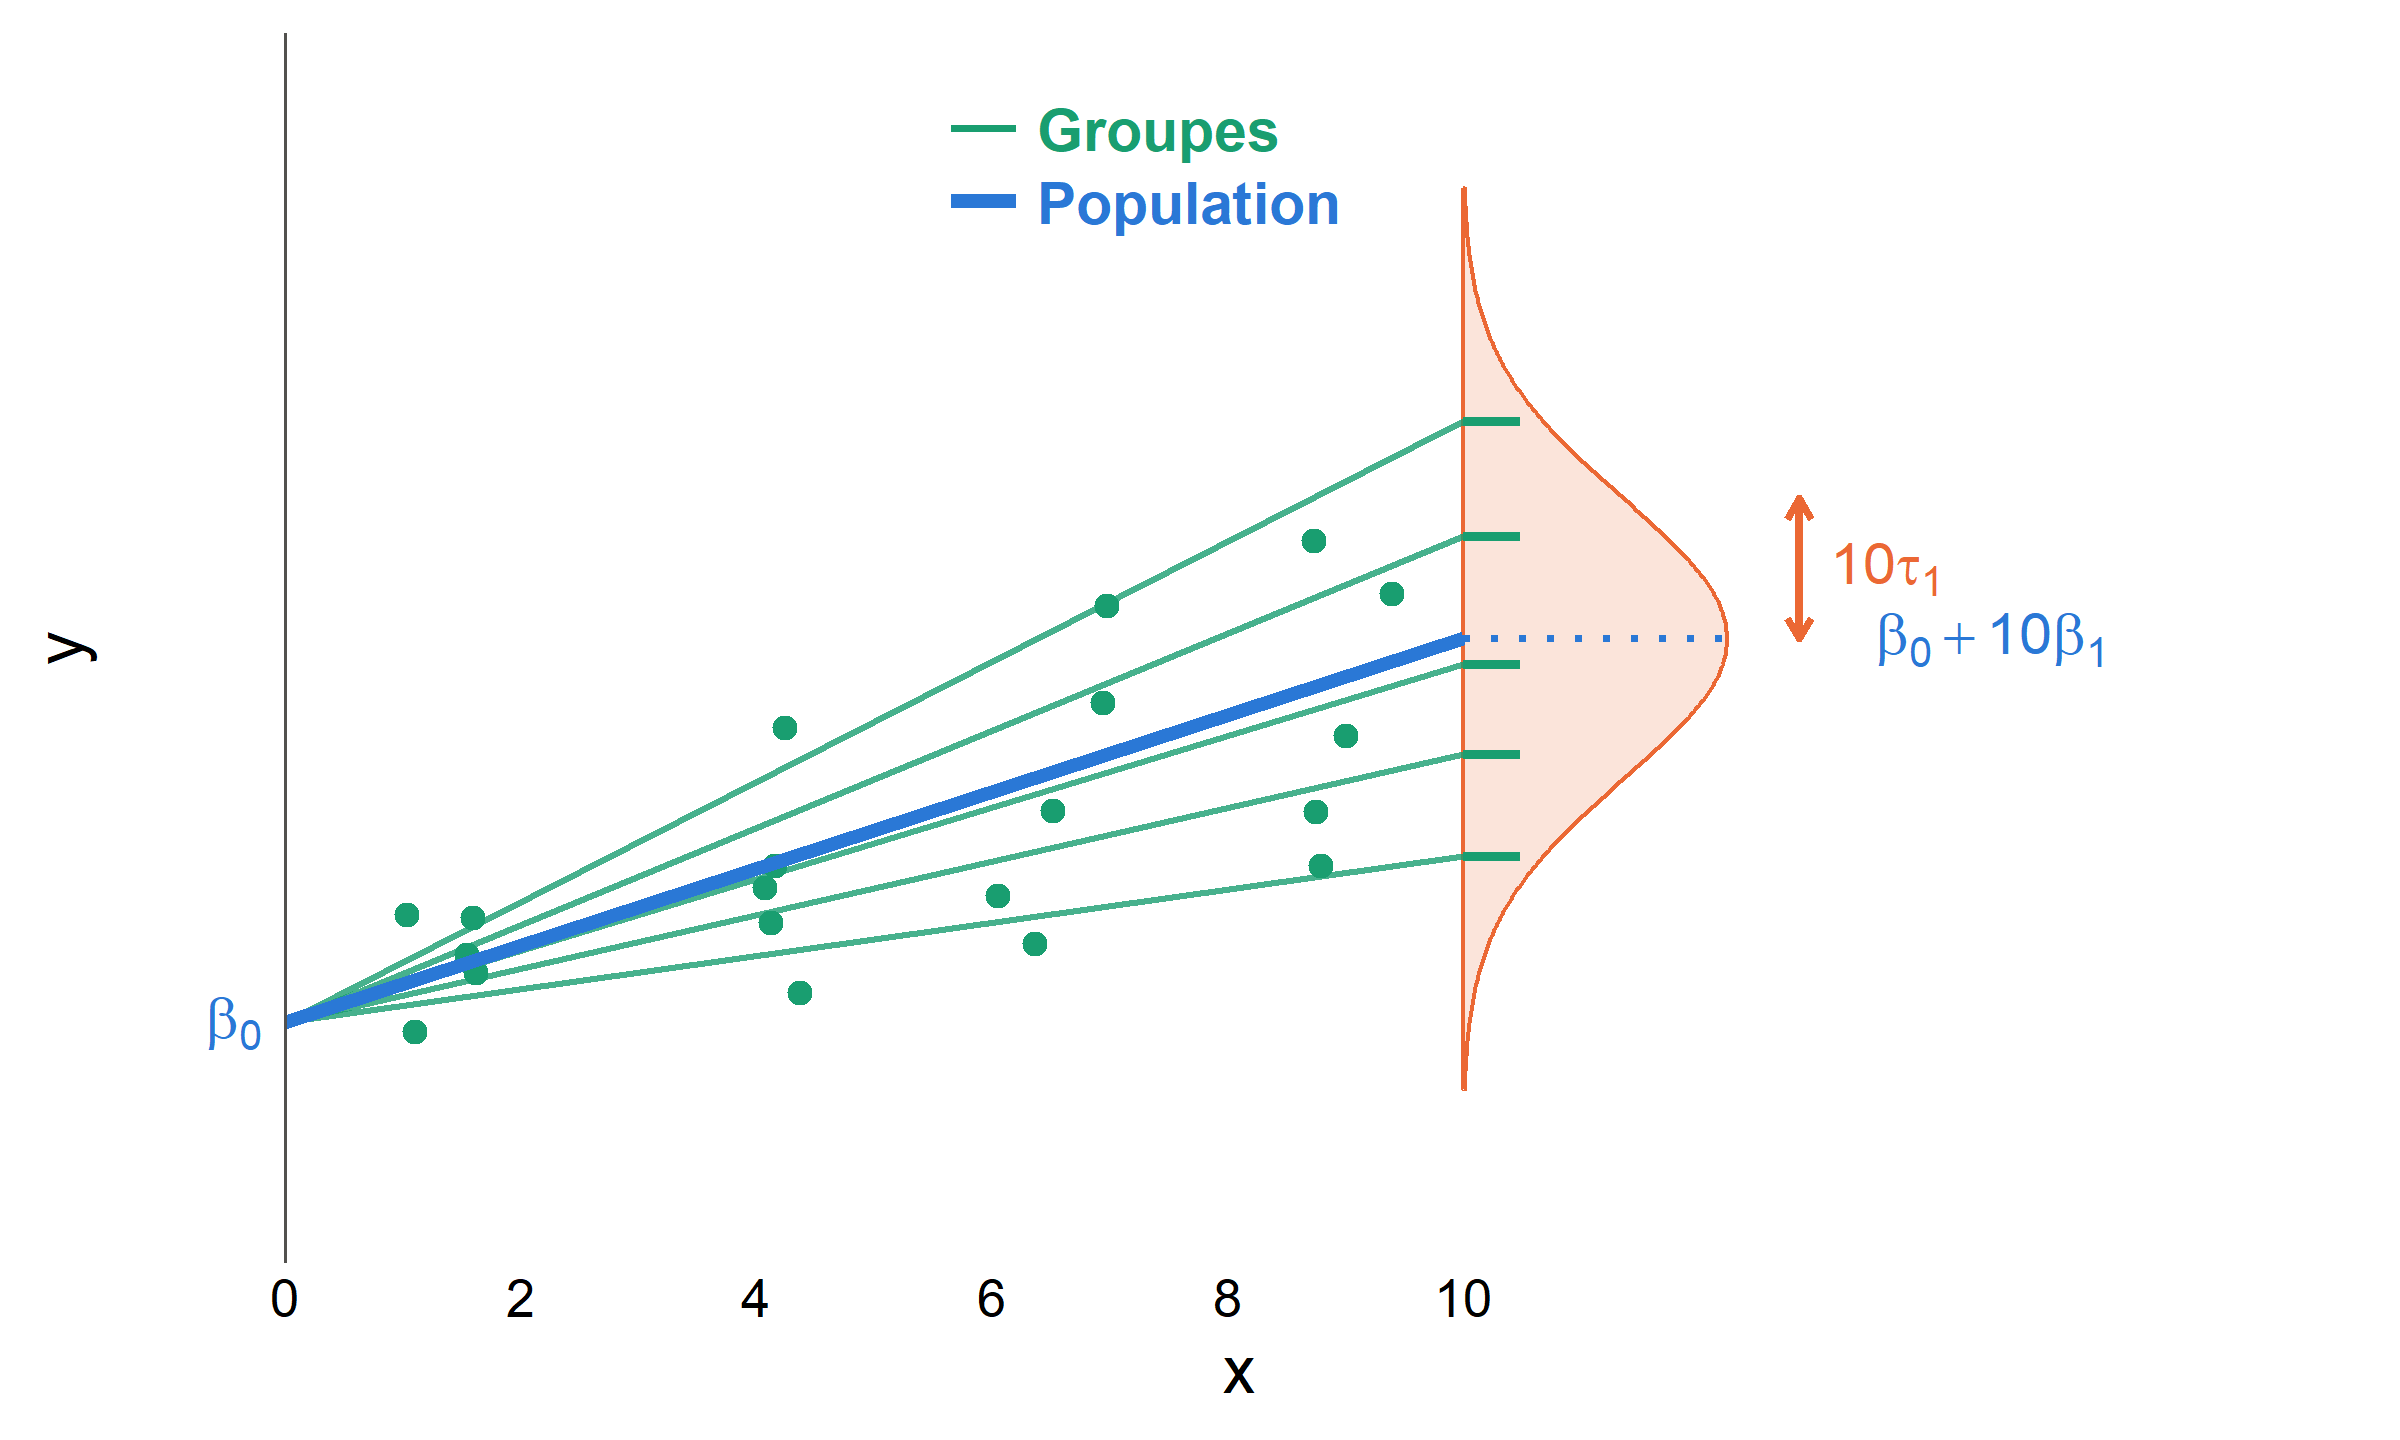
Dans le cas B, les droites partent du même niveau, mais elles n’ont plus la même pente. Cela signifie que l’association entre la variable explicative et la variable réponse \(y\) varie d’un groupe à l’autre.
Plus \(\tau_1\) est grand, plus les pentes diffèrent entre les groupes. Comme avant, on essaie de représenter cette idée sur la Figure 3.
2.1.3 Intercept et pente aléatoires
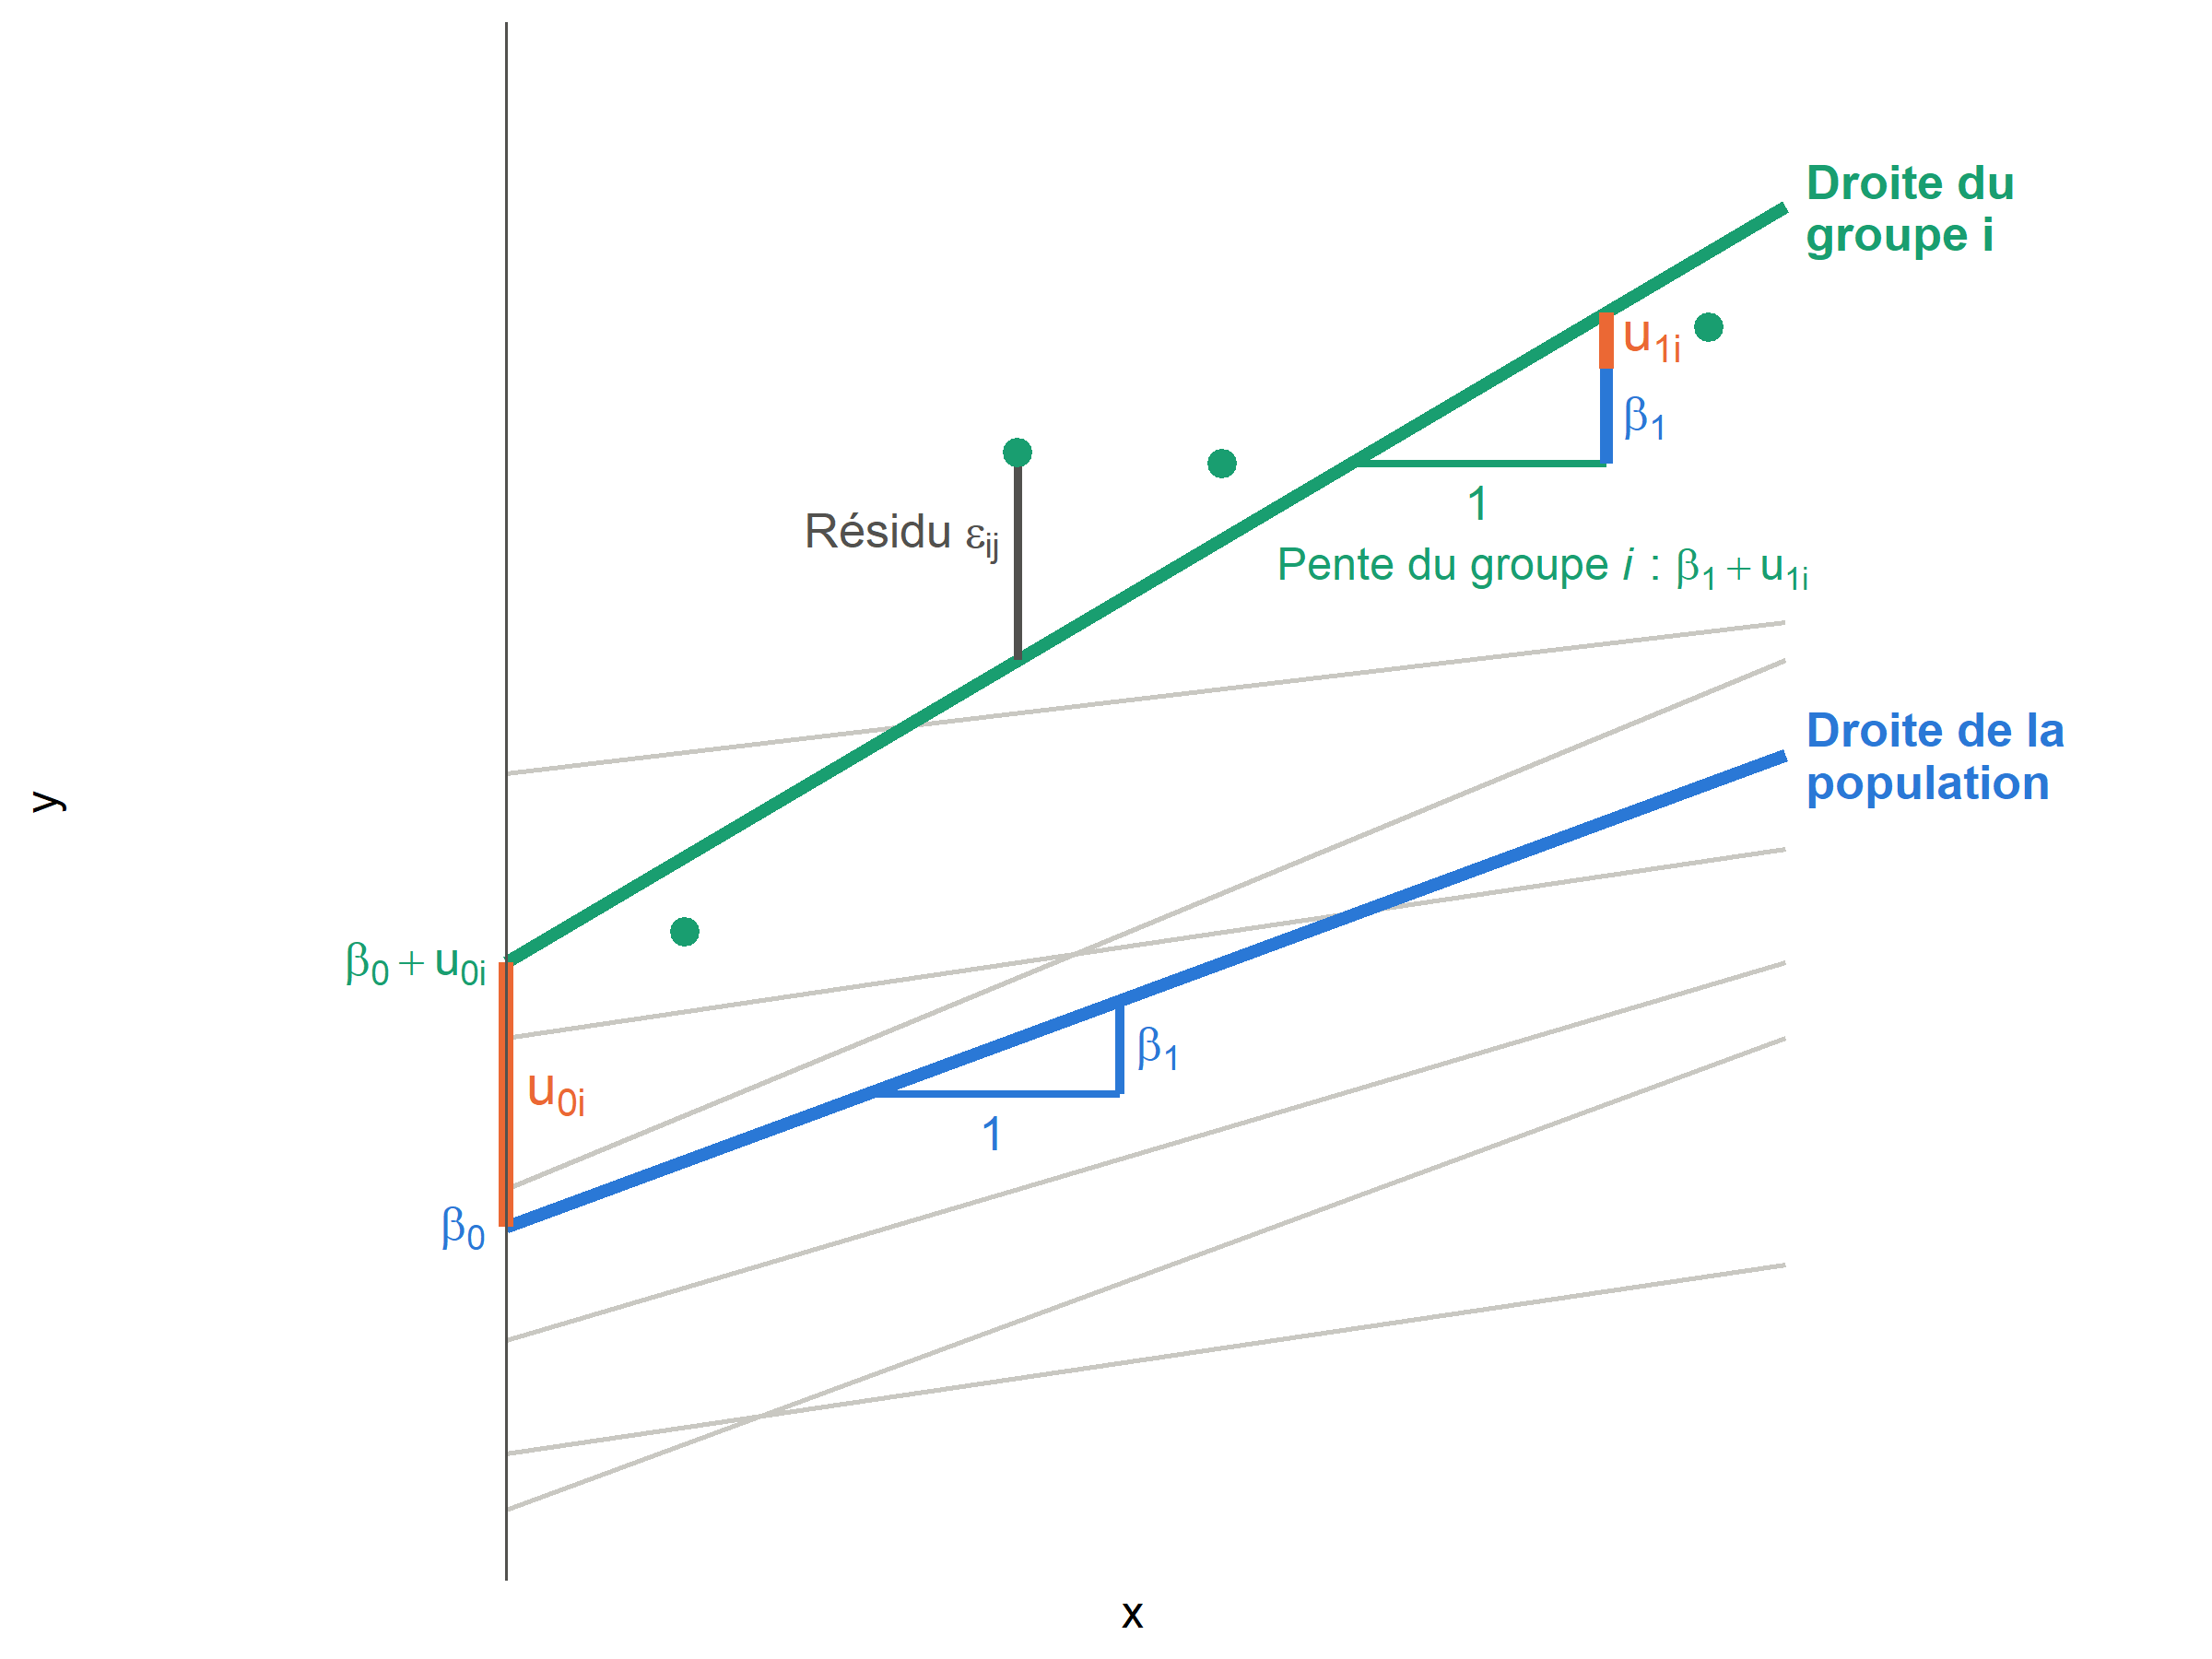
On peut maintenant réunir les deux idées : chaque groupe a son propre niveau de référence et sa propre pente. La Figure 4 reprend tous les éléments pour un groupe \(i\) particulier, qu’il s’agisse d’un centre ou d’un sujet. Cette structure permet de répondre aux deux questions qui nous intéressent :
- on laisse la possibilité à chaque groupe d’avoir sa propre droite, ce qui est souvent réaliste (et c’est ce qu’on voulait dans la partie précédente !) ;
- et surtout, on peut regarder comment sont liés intercept et pente aléatoire entre eux.
Supposons que notre \(Y\) soit une note à un devoir, et \(X\) le temps passé avec un professeur pour s’y préparer. A priori, quelqu’un qui a déjà des 18 sans professeur, aura moins de marge de progression (au plus 2 points) avec \(X\) qui augmente, que quelqu’un qui commence avec 0 (au plus 20 points). Mieux formulé, on voit que, plus le niveau de départ est élevé, plus la pente sera faible (et inversément). Avec un modèle mixte, ceci se traduit par une corrélation négative entre l’intercept et la pente aléatoire.
Dans la figure ci-dessous, la droite verte d’un groupe (p. ex., un centre en données groupées, ou une mesure sur un sujet en données longitudinales). Son intercept vaut \(\beta_0+u_{0i}\), et sa pente vaut \(\beta_1+u_{1i}\). Les observations ne sont pas toutes sur cette droite : il reste un écart \(\varepsilon_{ij}\) pour chaque observation, comme dans la régression linéaire classique.
2.2 Écriture du modèle
Nous avons maintenant tous les éléments pour écrire notre modèle. L’indice \(i\) désigne le groupe, et \(j\) une observation dans ce groupe : un patient \(j\) du centre \(i\), ou une mesure \(j\) chez le sujet \(i\).
C’est en 1982, grâce à Nan Laird et James Ware, que cette approche par effets aléatoires a été développée (Laird et Ware 1982).
Cela fait un peu plus de lettres que dans notre première régression, mais quand même beaucoup moins de \(\beta\) à écrire. Ici :
- \(\beta_0\) et \(\beta_1\) sont l’intercept et la pente moyens dans la population de groupes (= effets fixes). Leur interprétation reste celle des coefficients d’une régression linéaire ;
- \(u_{0i}\) et \(u_{1i}\) correspondent aux écarts à l’intercept et de la pente pour chaque groupe et suivent une distribution normale (= effets aléatoires) ;
- \(\tau_0\) et \(\tau_1\) sont les écarts-types de ces écarts. Ils décrivent donc à quel point les groupes diffèrent des valeurs moyennes ;
- \(\tau_{01}\) est la covariance entre l’intercept et la pente aléatoires d’un même groupe. Elle permet de décrire, par exemple, si les groupes qui partent plus haut ont aussi tendance à avoir une pente plus forte (cf. l’exemple de la note à un devoir). Elle peut aussi s’exprimer à l’aide de leur corrélation \(\rho\) : \(\tau_{01} = \rho \tau_0 \tau_1\).
- \(\sigma\) est l’écart-type résiduel : il décrit la dispersion des observations autour de la droite de leur groupe.
Les effets aléatoires sont partagés par toutes les observations d’un même groupe : tous les patients d’un centre, ou toutes les mesures d’un sujet. Le résidu, lui, est propre à une observation. C’est cette distinction qui permet de représenter leur dépendance.
Deux exemples concrets valent mieux que tous ces discours faits jusqu’à présent ! Si ce qui a été énoncé jusqu’à présent ne paraît pas clair, les exemples ci-dessous devraient vous aider à mieux comprendre l’intérêt de ces modèles. Pour les deux exemples de la partie précédente, j’énonce ci-dessous, l’idée générale qui amène à construire notre modèle mixte. J’espère que ce sera plus clair ainsi !
Avec des données groupées d’abord :
La même logique s’applique aux données longitudinales, où l’on suit les mêmes sujets dans le temps. Le groupe est maintenant le sujet, et la pente décrit son évolution au fil du suivi. On note ici \(t_{ij}\) le temps de la j-ième mesure chez le sujet \(i\), plutôt que \(x_{ij}\).
Il n’y a jamais de vraie réponse, le choix du modèle dépend surtout de vos hypothèses de départ. Bien-sûr, on peut ajuster sur d’autres variables explicatives pour tenir compte de facteurs de confusion, mais le raisonnement reste le même.
Entre nous, c’est généralement le modèle à intercept et pente aléatoires qui est choisi, mais il faut toujours justifier en raisonnant comme dans les deux exemples précédents.
NoteÉcriture matricielle du modèle
Pour écrire le modèle pour toutes les observations à la fois, on peut regrouper ces termes dans des vecteurs et des matrices : \[ \mathbf y = \mathbf X \boldsymbol\beta + \mathbf Z \mathbf u + \boldsymbol\varepsilon, \qquad \mathbf u \sim \mathcal N(\mathbf 0, \mathbf G), \qquad \boldsymbol\varepsilon \sim \mathcal N(\mathbf 0, \mathbf R), \]
On retrouve les trois parties de notre équation : les effets fixes, les effets aléatoires et les résidus. \(\mathbf X\) est la matrice de design des effets fixes, et \(\mathbf Z\) celle des effets aléatoires. Ici, \(\mathbf G\) rassemble les matrices de covariance des effets aléatoires de tous les groupes ; \(\mathbf R\) décrit la covariance des résidus. Dans le cas standard, \(\mathbf R=\sigma^2\mathbf I\).
En intégrant les effets aléatoires, on obtient la loi marginale des observations, c’est-à-dire leur distribution lorsque l’on ne conditionne plus sur les effets propres à chaque groupe : \[ \mathbf y \sim \mathcal N\big(\mathbf X\boldsymbol\beta,\; \mathbf V = \mathbf Z \mathbf G \mathbf Z^\top + \mathbf R\big). \]
Cette écriture montre comment les effets aléatoires interviennent dans la matrice de covariance \(\mathbf V\) des observations :
- Deux observations d’un même groupe partagent les mêmes effets aléatoires : cela peut les rendre corrélées
- Deux observations de groupes différents ne partagent pas ces effets et sont indépendantes dans ce modèle.
NoteLa covariance induite par les effets aléatoires
Avec un intercept aléatoire seul, deux observations \(j\neq k\) d’un même groupe partagent le terme \(u_{0i}\) : il peut s’agir de deux patients d’un centre ou de deux mesures d’un sujet. On obtient alors : \[ \mathrm{Var}(y_{ij}) = \tau_0^2 + \sigma^2, \; \mathrm{Cov}(y_{ij}, y_{ik}) = \tau_0^2, \; \mathrm{Corr}(y_{ij}, y_{ik}) = \frac{\tau_0^2}{\tau_0^2 + \sigma^2}. \]
On voit donc que les mesures sont corrélées et qu’on en tient compte dans la modélisation. De plus, cette corrélation est la même pour toutes les paires d’observations d’un groupe. Cette structure est appelée symétrie composée, et cette corrélation correspond à l’ICC que nous verrons en section 3.4.
Avec une pente aléatoire, la situation change : la contribution de l’effet aléatoire dépend de la valeur de \(x\). La variance des observations devient : \[ \mathrm{Var}(y_{ij}) = \tau_0^2 + 2\tau_{01}\, x_{ij} + \tau_1^2\, x_{ij}^2 + \sigma^2 . \]
La dispersion entre centres peut ainsi varier selon le nombre d’heures d’éducation ; et celle entre sujets, selon le jour du suivi. Nous utiliserons ce lien pour discuter du choix de la structure de corrélation en section 5.1.
2.3 Qu’estime-t-on du coup ?
Dans le modèle que nous venons d’écrire, on estime les effets fixes (\(\beta_0\), \(\beta_1\)) et les paramètres qui décrivent les variances et la corrélation (\(\tau_0\), \(\tau_1\), \(\tau_{01}\), \(\sigma\)). Cela fait 6 paramètres, quel que soit le nombre de groupes ou d’observations par groupe : centres et patients dans un cas, sujets et mesures dans l’autre !
Pour nos 24 centres, le modèle avec une droite indépendante par centre en demandait 49 : 24 intercepts, 24 pentes et \(\sigma\), si l’on suppose une variance résiduelle commune. Ici, nous avons besoin de 8x moins de paramètres !
Quant à eux, les écarts \(u_{0i}\) et \(u_{1i}\) sont des variables aléatoires (d’où le terme “effets aléatoires”). On ne va pas les estimer directement, mais les prédire dans un second temps à partir du modèle.
Estimons un modèle mixte et faisons alors une telle prédiction sur nos données du diabète. Nous gardons une seule variable explicative, le nombre d’heures d’éducation, et on part sur un modèle à intercept et pente aléatoires. Autrement dit, nous demandons au modèle de retrouver une tendance moyenne, puis de prédire la manière dont chaque centre s’en écarte. La Figure 5 compare ces nouvelles droites à celles des deux approches de la section 1.
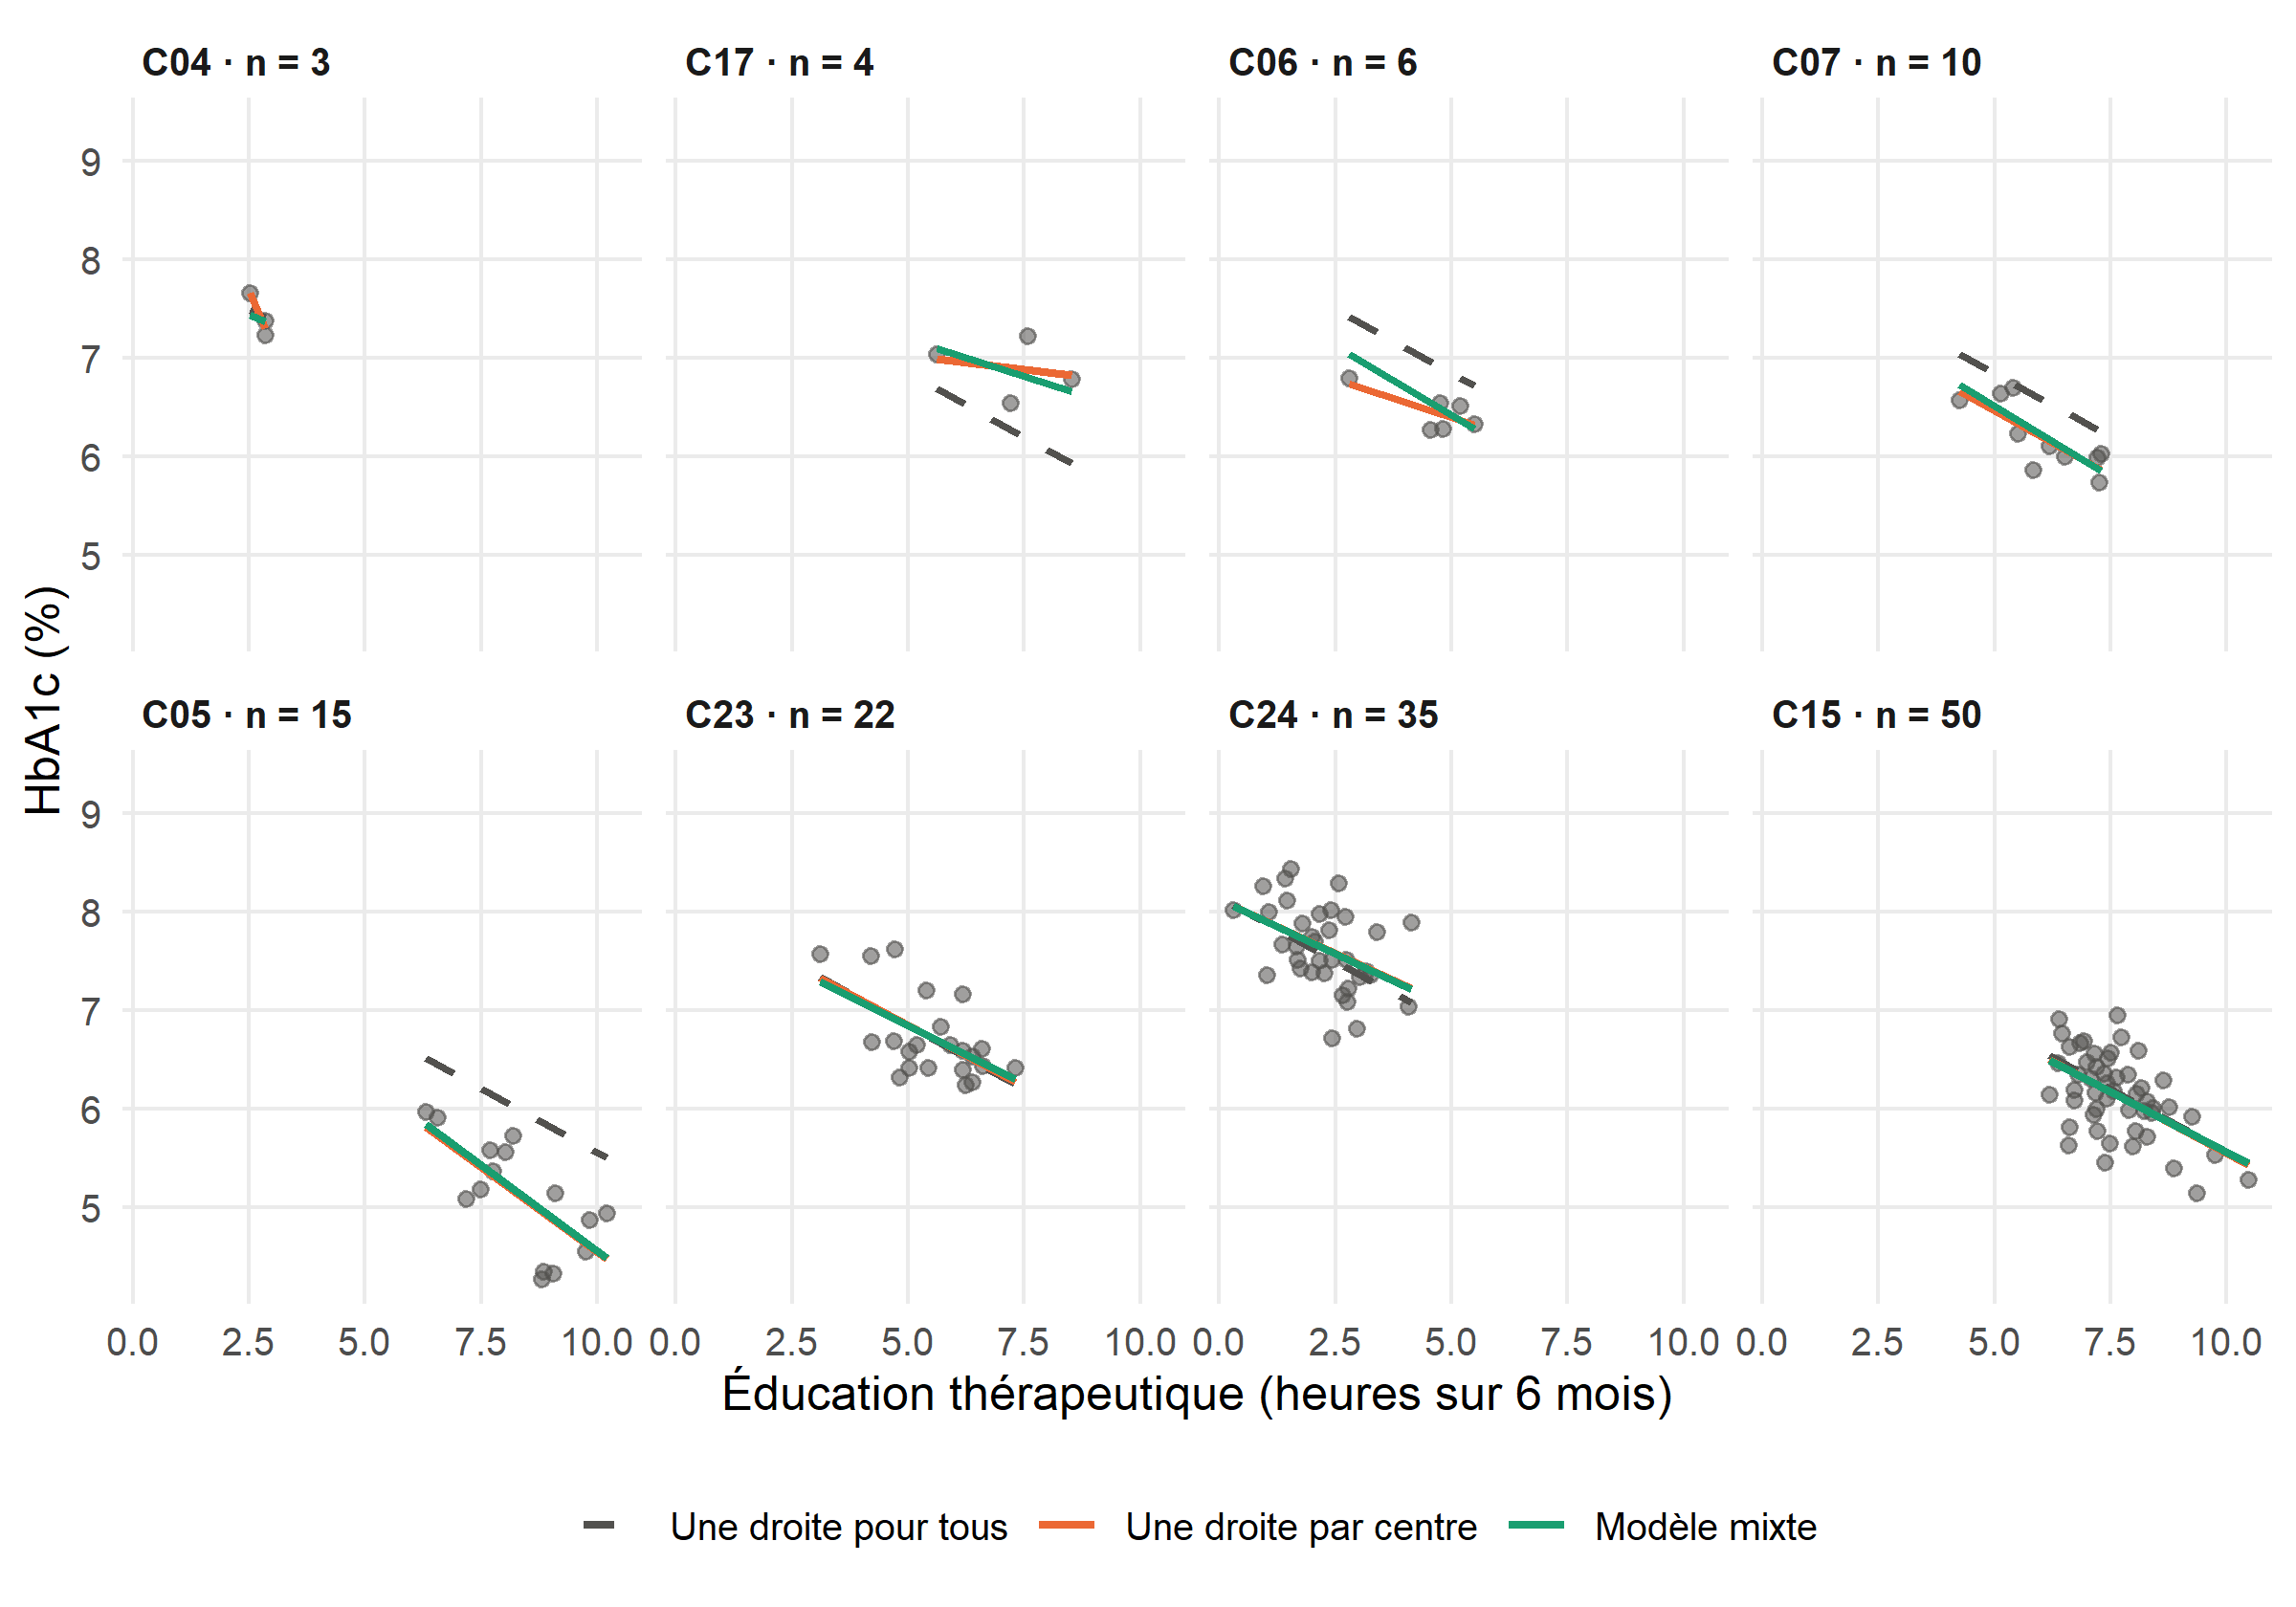
- La droite en pointillés est la même dans tous les centres : elle résume la tendance générale, mais passe parfois assez loin des patients du centre. Les droites orange et verte, elles, tiennent compte de ses particularités ;
- Dans les grands centres, en bas à droite, les droites orange et verte sont proches ;
- Dans les petits centres, en haut à gauche, la différence est plus nette : le modèle mixte tient davantage compte de la relation estimée à partir de l’ensemble des centres (et c’est ça son grand avantage ! En prédisant l’intercept d’un centre, il se base sur les données de ce centre, mais aussi sur celles des autres centres, le rendant plus précis).
Ainsi, les autres centres renseignent deux choses : la tendance moyenne et l’ampleur des différences entre centres. Le modèle mixte utilise ensuite cette information pour interpréter les résultats du petit centre : - Si les centres se ressemblent beaucoup, leur tendance commune est une information utile pour prédire celle du petit centre ; - Si leurs effets sont très différents, la tendance commune renseigne moins sur ce centre particulier : le bénéfice du partage d’information est plus limité.
Attention, le modèle mixte n’est pas non plus une solution miraculeuse, et l’incertitude restera tout de même plus grande dans les petits centres que dans les grands (mais moindre qu’avec une autre solution !).
Ces différences s’expliquent par le fait que le modèle mixte utilise à la fois les données du centre et celles des autres centres pour prédire sa droite. Avec des données longitudinales, il combine de la même façon les mesures du sujet et celles des autres sujets pour prédire sa trajectoire. C’est ce que l’on appelle le pooling partiel.
NotePooling partiel
Comme nos données sont simulées, nous pouvons aller un peu plus loin : nous connaissons la vraie pente de chaque centre. Nous pouvons donc la comparer à la pente de la régression séparée et à celle prédite par le modèle mixte, \(\hat\beta_1+\hat u_{1i}\).
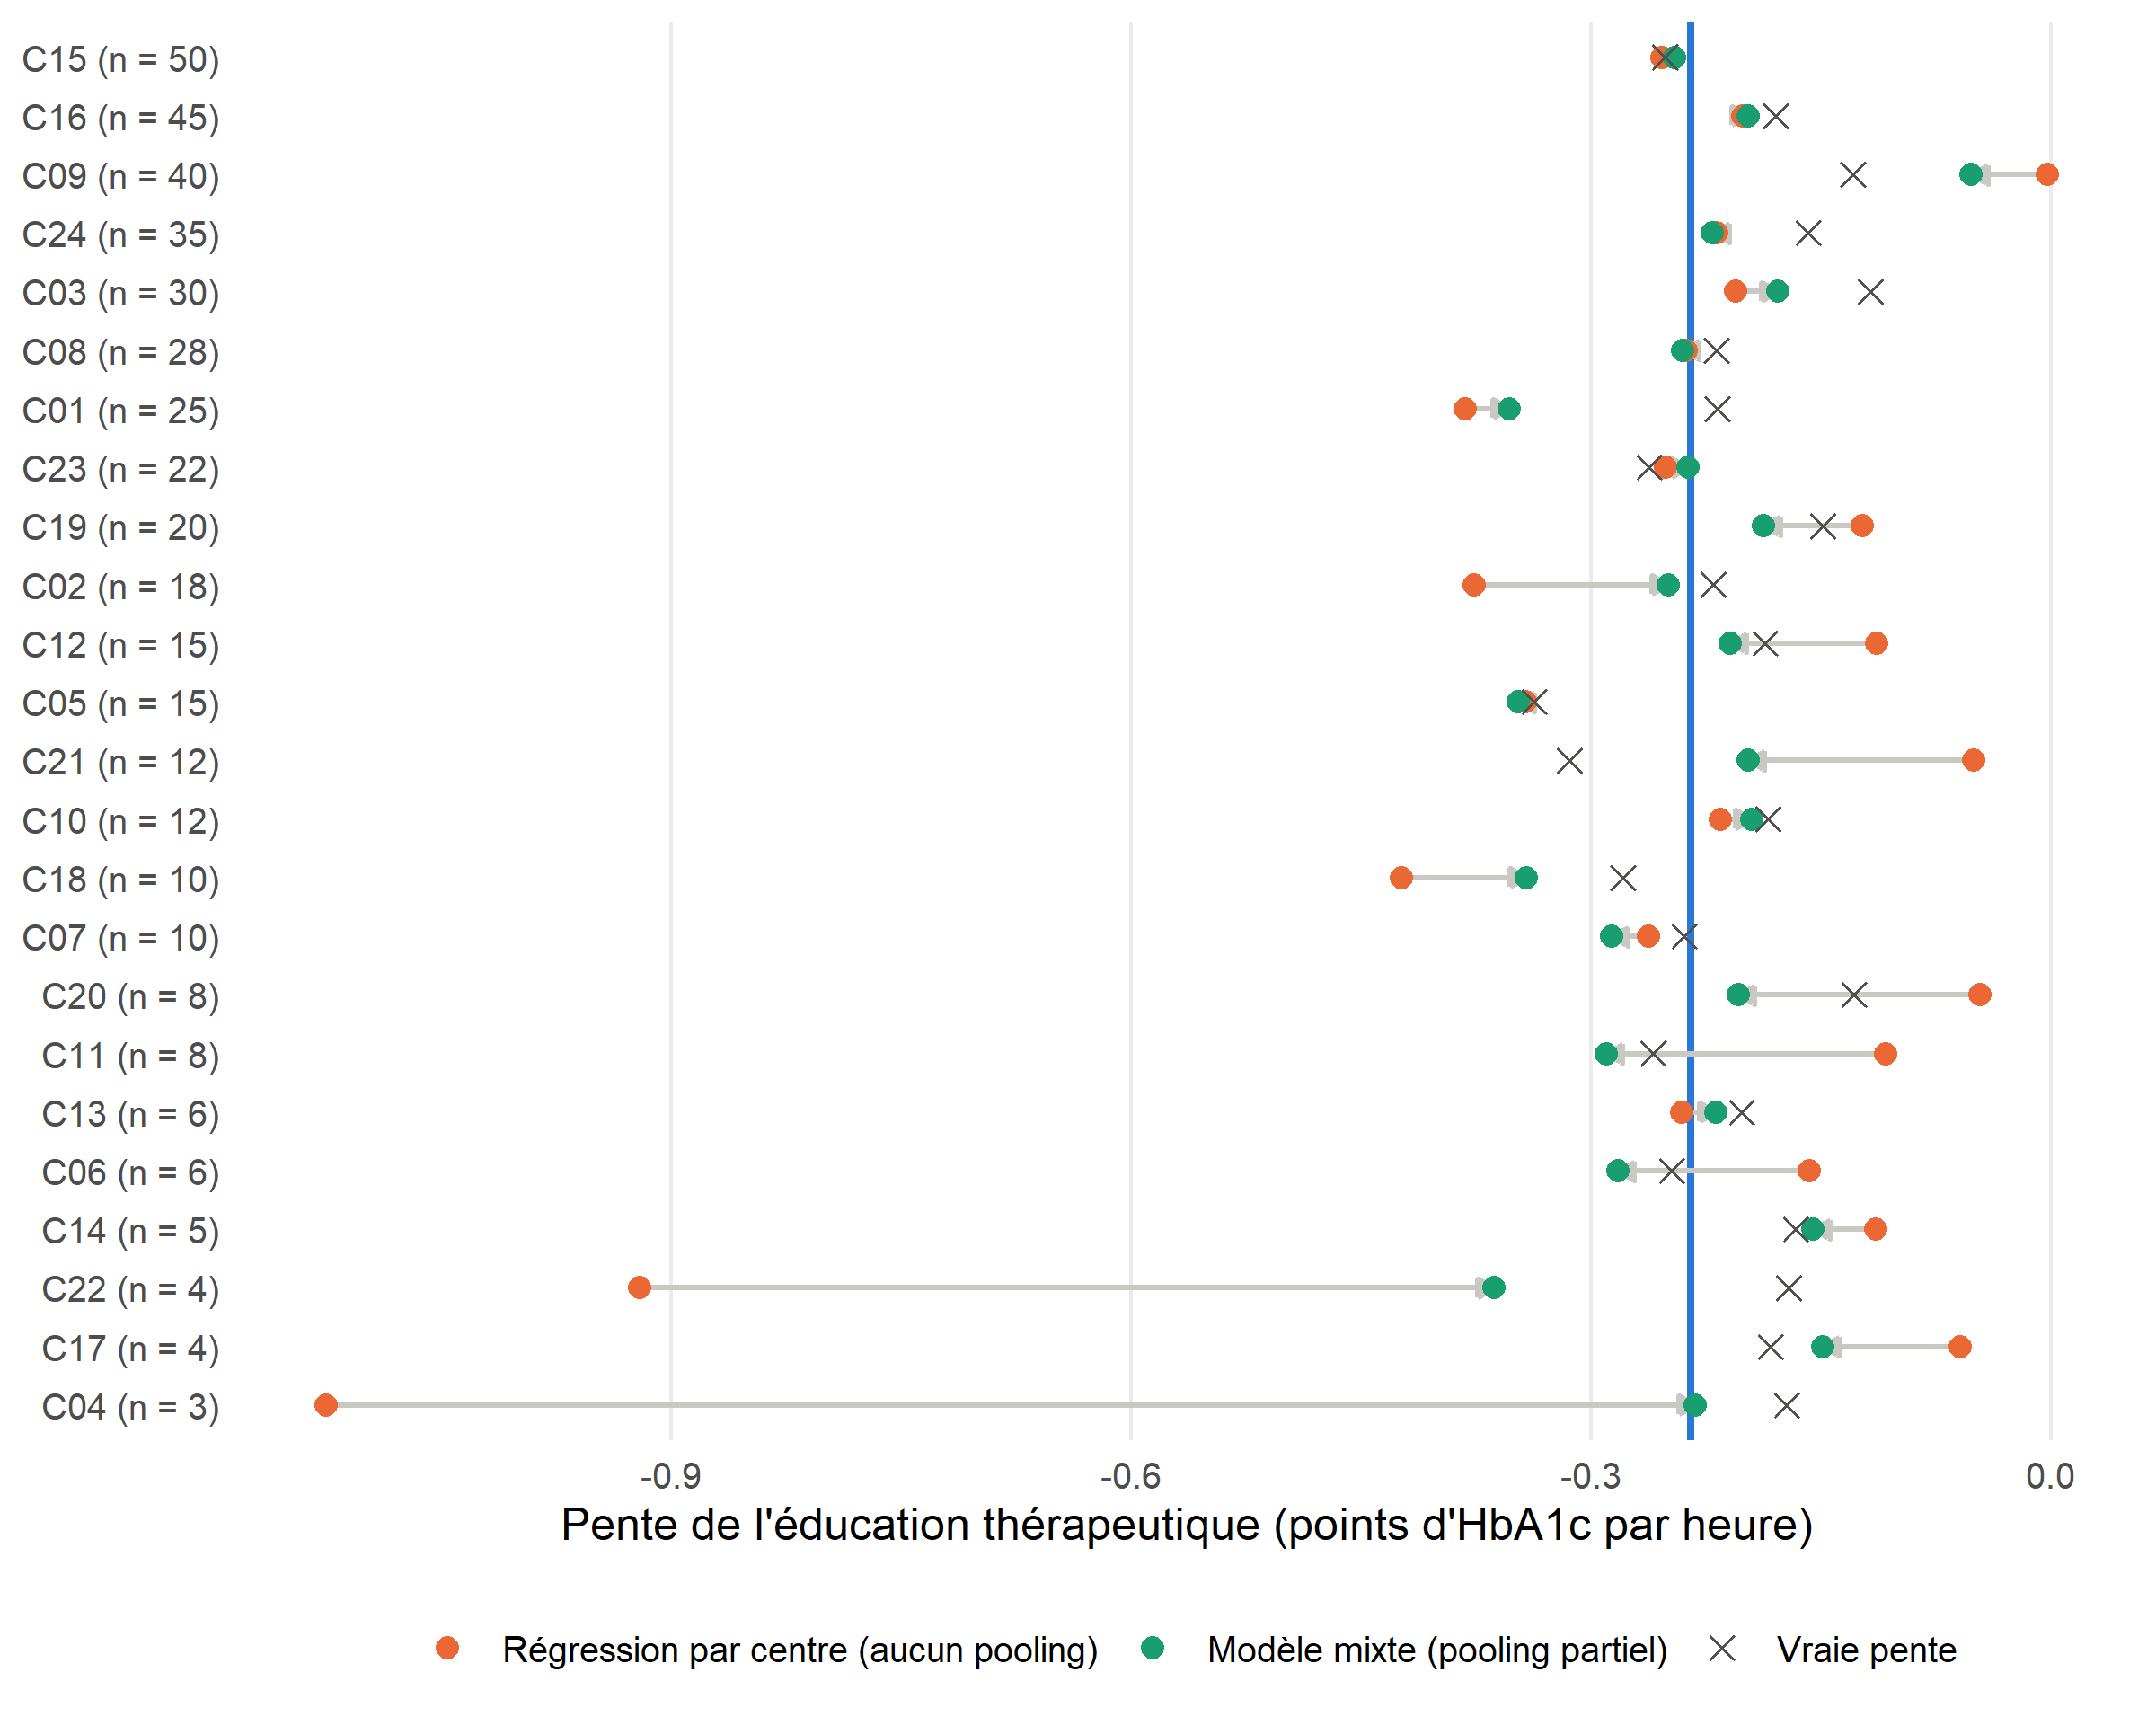
Regardons d’abord les petits centres : ce sont souvent ceux pour lesquels la pente change le plus. La pente de C04 (3 patients) passe de -1,12 à -0,23 point d’HbA1c par heure. Celle de C15 (50 patients) bouge si peu, qu’elle reste à 0,25.
Le déplacement se fait généralement vers la moyenne. Ce phénomène s’appelle le shrinkage (rétrecissement en français ?), et correspon au fait qu’une estimation peu précise est rapprochée de la tendance commune aux groupes (ici, la ligne bleue).
Les références
Laird, Nan M., et James H. Ware. 1982. « Random-Effects Models for Longitudinal Data ». Biometrics 38 (4): 963‑74. https://doi.org/10.2307/2529876.