3 Interprétons un modèle linéaire mixte

Reprenons les 18 sujets de l’étude sur la privation de sommeil (section 1.5). On y a mesuré le temps de réaction des mêmes sujets au fil des jours de privation de sommeil. Nous allons ajuster trois modèles mixtes pour voir ce qu’ils nous apprennent sur la population et sur les différences entre sujets.

3.1 Trois modèles

Nous comparons un intercept aléatoire seul, puis un intercept et une pente aléatoires, corrélés ou non. Ici, le regroupement se fait par sujet (Subject) et la pente porte sur le temps (Days) (pour le diabète, on utiliserait les centres et les heures d’éducation).

# intercept aléatoire
m_randIntercept <- lmer(Reaction ~ Days + (1 | Subject), data = sleepstudy)
# intercept + pente, corrélés
m_randInterceptSlope <- lmer(Reaction ~ Days + (Days | Subject), data = sleepstudy)
# intercept + pente, mais pas corrélés
m_randIntSlope_uncorrelated <- lmer(Reaction ~ Days + (Days || Subject), data = sleepstudy)


summary(m_randInterceptSlope)
Linear mixed model fit by REML. t-tests use Satterthwaite's method [
lmerModLmerTest]
Formula: Reaction ~ Days + (Days | Subject)
   Data: sleepstudy

REML criterion at convergence: 1743.6

Scaled residuals: 
    Min      1Q  Median      3Q     Max 
-3.9536 -0.4634  0.0231  0.4634  5.1793 

Random effects:
 Groups   Name        Variance Std.Dev. Corr 
 Subject  (Intercept) 612.10   24.741        
          Days         35.07    5.922   0.07 
 Residual             654.94   25.592        
Number of obs: 180, groups:  Subject, 18

Fixed effects:
            Estimate Std. Error      df t value Pr(>|t|)    
(Intercept)  251.405      6.825  17.000  36.838  < 2e-16 ***
Days          10.467      1.546  17.000   6.771 3.26e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Correlation of Fixed Effects:
     (Intr)
Days -0.138
NoteRemarque

Pour nous repérer dans la sortie de summary(), voici les principales rubriques :

  • Random effects présente les variances/écarts-types estimées des effets aléatoires. La colonne Corr donne la corrélation entre intercept et pente aléatoires, et la ligne Residual donne \(\hat\sigma\).
  • Number of obs et groups indiquent le nombre d’observations et de groupes. Ici, on a 180 mesures et 18 sujets (dans l’exemple du diabète, ce seraient 431 patients et 24 centres).
  • Fixed effects présente les effets fixes, comme dans lm().
NoteExemple

Commençons par les effets fixes du modèle m_randInterceptSlope. Le temps de réaction moyen estimé dans la population au jour 0 est de 251,4 ms. Il augmente en moyenne de 10,47 ms par jour de privation de sommeil, avec une erreur standard de 1,55.

Côté effets aléatoires maintenant :

  • On peut regarder l’écart-type estimé pour l’intercept et la pente aléatoire (bien que ce ne soit pas vraiment interprétable directement) :
    • \(\hat\tau_0 = 24,7\) ms : les temps de réaction au départ varient entre les sujets, avec un écart-type d’environ 24,7 ms ;
    • \(\hat\tau_1 = 5,92\) ms/jour : les pentes varient elles aussi, avec un écart-type de 5,92 ms/jour ;
    • En tout cas, les deux semblent être assez éloignés de 0, donc on peut supposer qu’utiliser un modèle à intercept et pente aléatoires est pertinent pour ces données (on peut le tester, ce qui est plus rigoureux !) ;
  • Un truc interprétable, en revanche, c’est la corrélation entre l’intercept et la pente :
    • \(\hat\rho = 0,07\) : la corrélation estimée est positive, donc, dans l’idée, un sujet avec un temps de réaction plus élevé au départ aurait tendance à avoir une pente plus forte.
    • Cependant, elle est super proche de 0. De fait, on pencherait plus vers le fait que l’intercept et la pente aléatoires sont indépendantes dans la population.
  • Enfin, \(\hat\sigma = 25,6\) ms : c’est l’écart-type de la variabilité d’un jour à l’autre autour de la droite de chaque sujet. Voilà voilà.

Comparons avec les deux autres modèles :

VarCorr(m_randIntercept)
 Groups   Name        Std.Dev.
 Subject  (Intercept) 37.124  
 Residual             30.991  
VarCorr(m_randIntSlope_uncorrelated)
 Groups    Name        Std.Dev.
 Subject   (Intercept) 25.0513 
 Subject.1 Days         5.9882 
 Residual              25.5653 

Avec le modèle à intercept aléatoire seul, l’écart-type entre sujets (37,1) et l’écart-type résiduel (31,0) sont plus grands. Ceci peut s’expliquer par le fait que, les différences de pentes n’étant plus modélisées, elles se retrouvent comme “absorbées” entre ces deux composantes.

L’effet fixe de Days est identique (à 10,47), mais son erreur standard est bien plus petite (0,80 contre 1,55). En ignorant que les sujets ont des pentes différentes, on surestime ici la précision de la pente moyenne. Le modèle non corrélé, lui, est très proche de m_randInterceptSlope, ce qui est cohérent avec \(\hat\rho = 0,07 \approx 0\) :)

3.2 ICC et VPC

Dans un modèle à intercept aléatoire, la variabilité qui reste après prise en compte des effets fixes se partage entre les différences entre groupes et les différences au sein des groupes. Concrètement :

Composante Données groupées Données longitudinales
Entre groupes : \(\tau_0^2\) Différences de niveau entre centres Différences de niveau entre sujets
Au sein du groupe : \(\sigma^2\) Écarts des patients autour de la droite de leur centre Écarts des mesures autour de la trajectoire de leur sujet

On peut alors se demander quelle part revient aux différences entre groupes.

ImportantDéfinition

Dans un modèle à intercept aléatoire, le coefficient de corrélation intraclasse, ou ICC, est la part de la variance entre groupes dans la variance qui reste après prise en compte des effets fixes : \[ \text{ICC} = \frac{\tau_0^2}{\tau_0^2 + \sigma^2} \in [0; 1] \] Il correspond aussi à la corrélation entre deux observations distinctes d’un même groupe, lorsque les résidus sont indépendants comme dans notre modèle.

Ce coefficient a deux lectures équivalentes :

  1. la part de la variance (résiduelle après les effets fixes) due aux différences entre les groupes ;
  2. la corrélation attendue entre deux observations d’un même groupe (p. ex., deux patients du même centre, ou deux mesures du même sujet)

Si les groupes diffèrent peu par rapport à la variabilité intra-groupe (\(\tau_0^2 \ll \sigma^2\)), l’ICC tend vers 0 : les observations d’un même groupe ne se ressemblent pas plus que les autres, et le regroupement importe peu. À l’inverse, lorsque presque toute la variabilité vient des différences entre groupes (\(\tau_0^2 \gg \sigma^2\)), l’ICC tend vers 1 : les observations d’un même groupe se ressemblent beaucoup autour de la tendance expliquée par les effets fixes.

vc_ri <- as.data.frame(VarCorr(m_randIntercept))
ICC <- vc_ri$vcov[1] / (vc_ri$vcov[1] + vc_ri$vcov[2]) # = (37.124^2) / (37.124^2 + 30.991^2)
NoteExemple

Sur l’étude sur la privation de sommeil, notre modèle à intercept aléatoire, l’ICC vaut environ 0,59. Ainsi, après avoir pris en compte la tendance moyenne au fil des jours, environ 59 % de la variabilité qui reste s’explique par les différences entre sujets. Les mesures d’un même sujet sont donc assez corrélées entre elles (p. ex., le temps de réaction du second jour dépend du premier, ce qui n’est pas fou à penser).

Avec une pente aléatoire, on peut se poser deux questions différentes :

  • quelle part vient des différences entre sujets ou entre centres, à une valeur donnée de la covariable ?
  • les sujets au-dessus de la moyenne à un jour tendent-ils à l’être aussi à un autre jour ? Ou les HbA1c de deux patients d’un même centre tendent-elles à s’écarter dans le même sens de leurs moyennes attendues ?

Pour le premier point, on peut calculer la VPC. Pour le second point, on calcule une corrélation.

Le truc, c’est qu’avec une pente aléatoire, les trajectoires des sujets ou les droites des centres peuvent s’écarter, se rapprocher ou se croiser. Les calculs sont donc un peu plus compliqués que pour l’ICC, étant donné que la variance entre unités de \(x\) (le jour de mesure dans l’étude sur le sommeil, ou les heures d’éducation dans l’exemple du diabète).

Notons cette variance : \[ q(x) = \mathrm{Var}(u_{0i}+u_{1i}x) = \tau_0^2 + 2x\rho\tau_0\tau_1 + x^2\tau_1^2 \]

Pour rappel, \(\rho\) est la corrélation entre l’intercept et la pente aléatoires. Ce n’est pas la corrélation entre deux observations !

ImportantDéfinition

La VPC (pour variance partition coefficient) est la part de variance attribuable aux différences entre unités de regroupement, après prise en compte des effets fixes. À une valeur donnée de \(x\) : \[ \mathrm{VPC}(x) = \frac{q(x)}{q(x)+\sigma^2} \in [0;1]. \] Elle décrit la part de variance attribuable aux différences entre sujets ou entre centres à cette valeur de \(x\).

NoteExemple

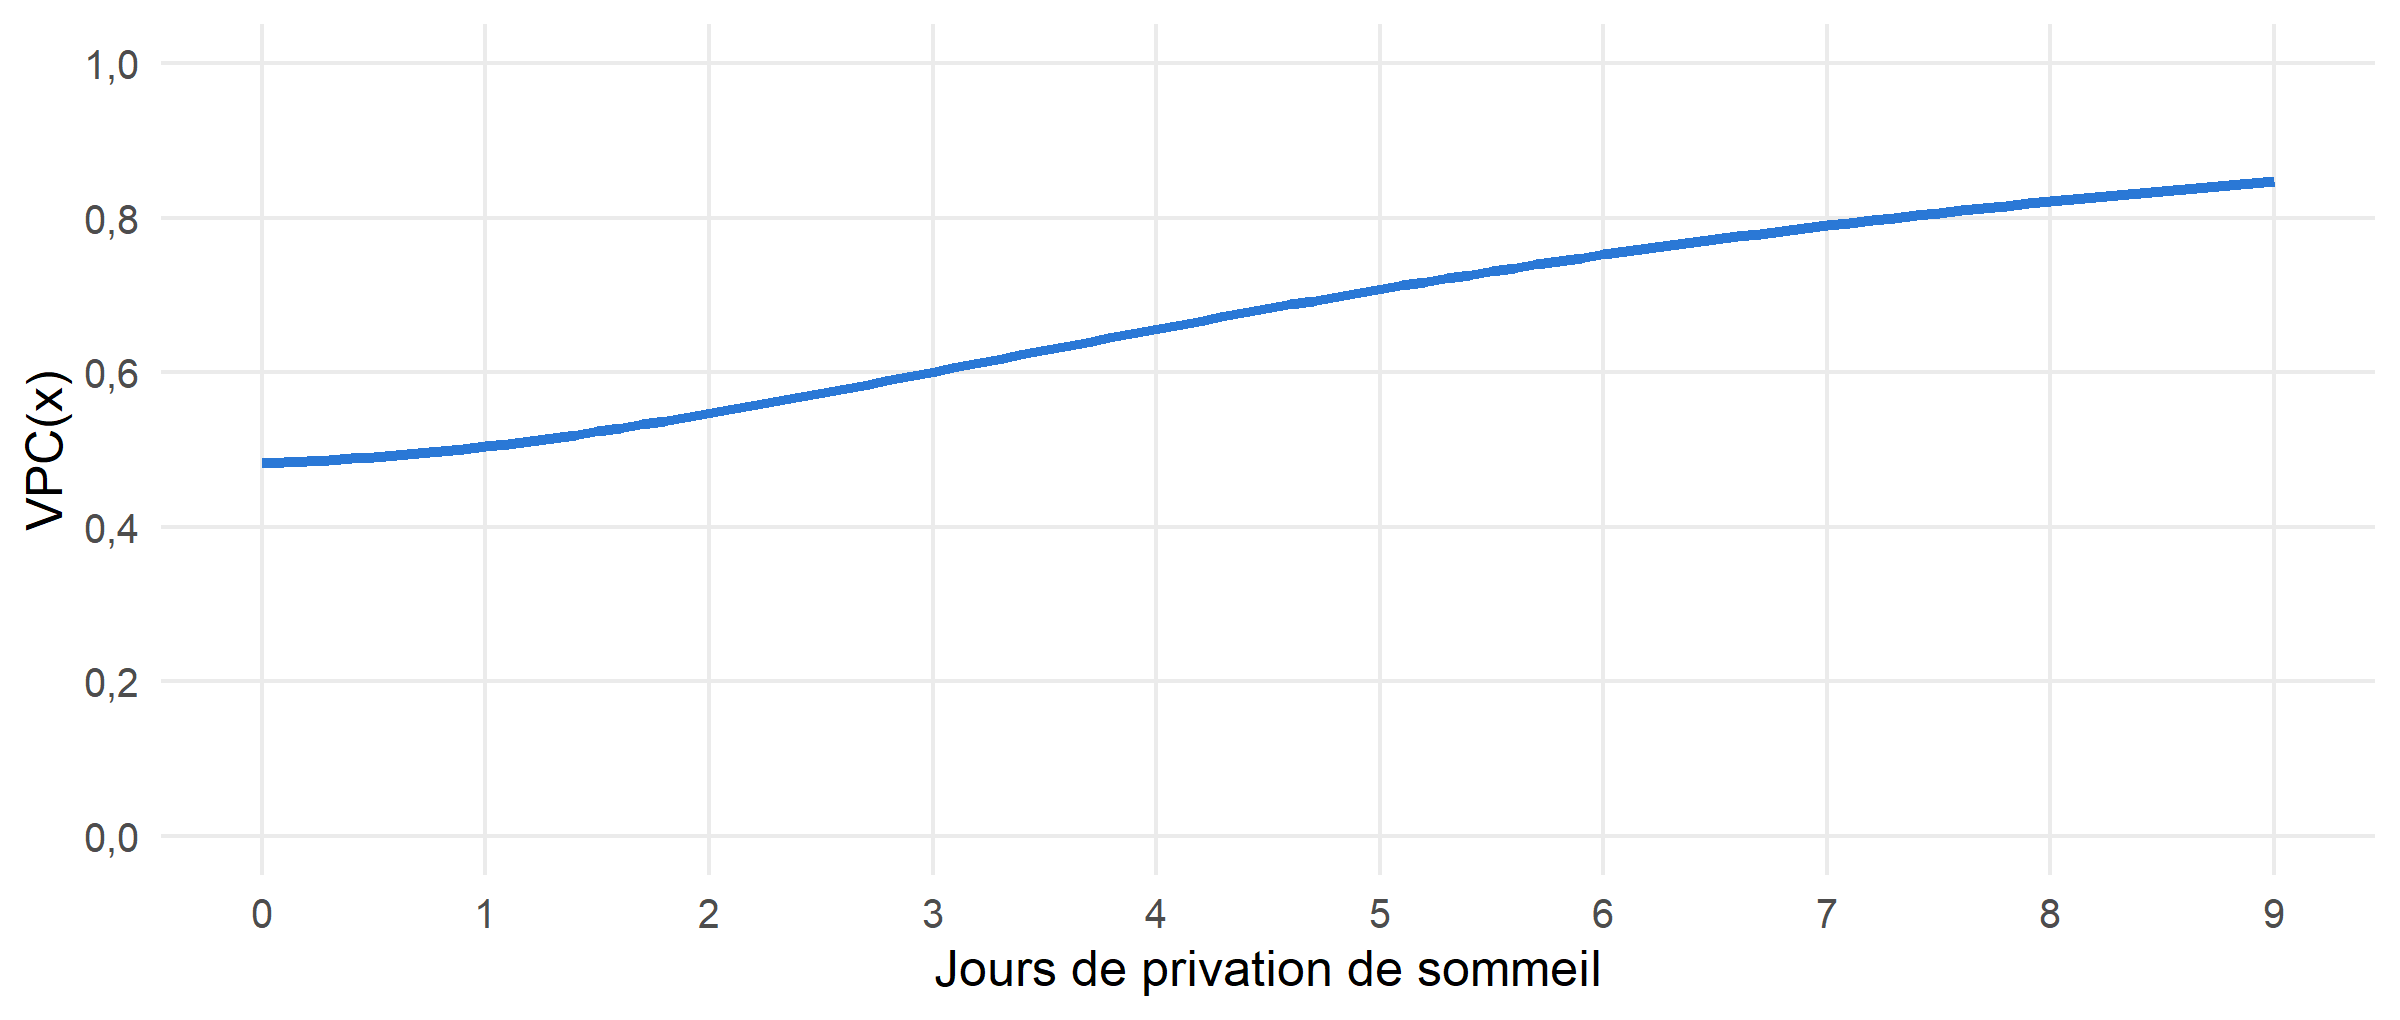
Au jour 5, la VPC vaut environ 0,71 : 71 % de la variance des temps de réaction à ce jour est attribuable aux différences entre les trajectoires des sujets. Les 29 % restants correspondent à la variabilité résiduelle autour de ces trajectoires.

On peut répéter ce calcul pour chaque jour et tracer la courbe suivante. Chaque point décrit la décomposition de la variance à un seul jour.

Figure 1: Part de variance attribuable aux différences entre sujets à chaque jour, selon le modèle à intercept et pente aléatoires. La variance entre sujets augmente sur la période, tandis que la variance résiduelle est supposée constante. La VPCpasse d’environ 48 % au jour 0, à 85 % au jour 9. Cela traduit que les trajectoires individuelles deviennent globalement plus dispersées avec le temps.
NoteExemple

Dans l’exemple du diabète, \(q(x)\) est la variance entre centres pour \(x\) heures d’éducation. Une VPC de 0,20 à 4 heures signifierait que, pour des patients ayant reçu 4 heures d’éducation, 20 % de la variance de l’HbA1c est attribuable aux différences entre centres et 80 % à la variabilité résiduelle entre patients au sein des centres.

On peut aussi tracer la VPC selon les heures d’éducation, comme on vient de le faire selon le jour.

Pour ce qui est de la corrélation entre deux observations distinctes (donc entre deux valeurs \(x\) et \(x'\)), on a besoin d’une covariance. Pour un même sujet à deux temps différents (données longitudinales) ou un même centre entre deux sujets (données groupées), on a : \[ \mathrm{Cov}\bigl(Y_i(x),Y_i(x')\bigr) = \tau_0^2 + \rho\tau_0\tau_1(x+x') + \tau_1^2xx', \] duquel on peut tirer : \[ \mathrm{Corr}\bigl(Y_i(x),Y_i(x')\bigr) = \frac{\tau_0^2 + \rho\tau_0\tau_1(x+x') + \tau_1^2xx'} {\sqrt{\bigl(q(x)+\sigma^2\bigr)\bigl(q(x')+\sigma^2\bigr)}} \]

NoteExemple

En données longitudinales, la corrélation estimée entre les mesures des jours 2 et 5 vaut 0,57 > 0. Ainsi, les sujets au-dessus de la moyenne au jour 2 tendent donc aussi à être au-dessus de la moyenne au jour 5.

En données groupées, la corrélation estimée entre les HbA1c de deux patients distincts du même centre, ayant reçu respectivement 2 et 5 heures d’éducation, vaut 0,31 > 0. Ainsi, si le patient ayant reçu 2 heures d’éducation a une HbA1c supérieure à la moyenne attendue pour 2 heures, celui ayant reçu 5 heures tend lui aussi à avoir une HbA1c supérieure à la moyenne attendue pour 5 heures.
3.3 R² marginal et conditionnel

Au lieu de s’intéresser à la part de la variabilité expliquée par les groupes, on peut viser plus large et se demander : quelle part de la variance est expliquée par le modèle ? On ne regarde donc plus seulement ce qu’apportent les effets aléatoires, mais aussi les effets fixes.

En régression linéaire standard, on avait vu le R², qui était un nombre entre 0 et 1, indiquant la part de la variabilité totale expliquée par le modèle. Pour les modèles linéaires mixtes, il faut adapter cette notation. Nakagawa et Schielzeth (2013) ont alors proposé deux versions.

ImportantDéfinition
  • Le R² marginal \(R^2_m\) est la part de la variance expliquée par les effets fixes seuls ;
  • Le R² conditionnel \(R^2_c\) est la part expliquée par l’ensemble des effets fixes et effets aléatoires.

Dans l’exemple du diabète, on compare donc la variance expliquée par les heures d’éducation seules à celle expliquée en ajoutant les particularités des centres. Dans l’étude sur la privation de sommeil, on compare la tendance moyenne au fil des jours à cette tendance complétée par les particularités des sujets.

performance::r2_nakagawa(m_randInterceptSlope)
# R2 for Mixed Models

  Conditional R2: 0.799
     Marginal R2: 0.279

Dans notre exemple, le nombre de jours explique à lui seul 28 % de la variance du temps de réaction. Si l’on ajoute les différences entre sujets (= un intercept et une pente propres à chacun), on en explique 80 % ! Les différences entre sujets pèsent donc bien plus que la tendance moyenne.

Pour calculer ces deux R² dans un modèle linéaire mixte gaussien, on décompose la variance totale en \[ \sigma^2_{\text{tot}} = \underbrace{\sigma^2_f}_{\mathrm{Var}(\mathbf X\hat{\boldsymbol\beta})} + \underbrace{\sigma^2_{u}}_{\text{effets aléatoires}} + \underbrace{\sigma^2}_{\text{résidu}}, \]

De cela, on peut calculer les deux R² :

  • Le R² marginal : \(R^2_m = \frac{\sigma^2_f}{\sigma^2_{\text{tot}}}\)
  • Et le R² conditionnel : \(R^2_c = \frac{\sigma^2_f + \sigma^2_u}{\sigma^2_{\text{tot}}}\)

Avec un intercept aléatoire seul, \(\sigma^2_u = \tau_0^2\).

3.4 Prédictions

Enfin, comme tous nos modèles jusqu’à présent, on peut être intéressé par le fait de faire des prédictions, comme, par exemple, une HbA1c ou un temps de réaction.

Avec nos modèles mixtes, on pourra faire des prédictions à deux niveaux :

  • Les prédictions marginales (ou de population) utilisent juste les effets fixes : \(\hat y = \mathbf x^\top\hat{\boldsymbol\beta}\).
    • Elles donnent la moyenne dans la population de groupes, pour les valeurs des variables explicatives choisies.
    • On les obtient avec predict(modele, re.form = NA).
  • Les prédictions conditionnelles (ou spécifiques) ajoutent les effets aléatoires prédits : \(\hat y = \mathbf x^\top\hat{\boldsymbol\beta} + \mathbf z^\top \hat{\mathbf u}_i\).
    • Elles donnent la moyenne prédite propre à un groupe déjà observé : la droite d’un centre ou la trajectoire d’un sujet.
    • On les obtient avec predict(modele).
Avertissement
  • Si on souhaite faire une prédiction pour un nouveau centre (données groupées) / nouveau sujet (données longitudinales), l’effet aléatoire vaut alors 0 étant donné qu’il n’y a aucune information qui a pu être estimée sur nos données relatif à ce groupe / sujet ! La commande predict(modele, newdata, allow.new.levels = TRUE) renvoie alors la prédiction marginale.

  • Si on souhaite faire une prédiction pour un nouveau sujet dans un centre déjà existant (données groupées) / une nouvelle mesure chez un sujet déjà observé (données longitudinales), alors on peut utiliser l’effet aléatoire prédit pour ce groupe. La commande predict(modele, newdata) renvoie alors la prédiction conditionnelle.

NoteExemple
nouveaux <- data.frame(
    # 308 = existe déjà, 999 = nouveau sujet
    Days = c(0, 9, 0, 9),
    Subject = c("308", "308", "999", "999")
)
cbind(nouveaux,
    conditionnelle = predict(m_randInterceptSlope, newdata = nouveaux, allow.new.levels = TRUE),
    marginale = predict(m_randInterceptSlope, newdata = nouveaux, re.form = NA)
)
Days Subject conditionnelle marginale
0 308 253.6637 251.4051
9 308 430.6600 345.6107
0 999 251.4051 251.4051
9 999 345.6107 345.6107
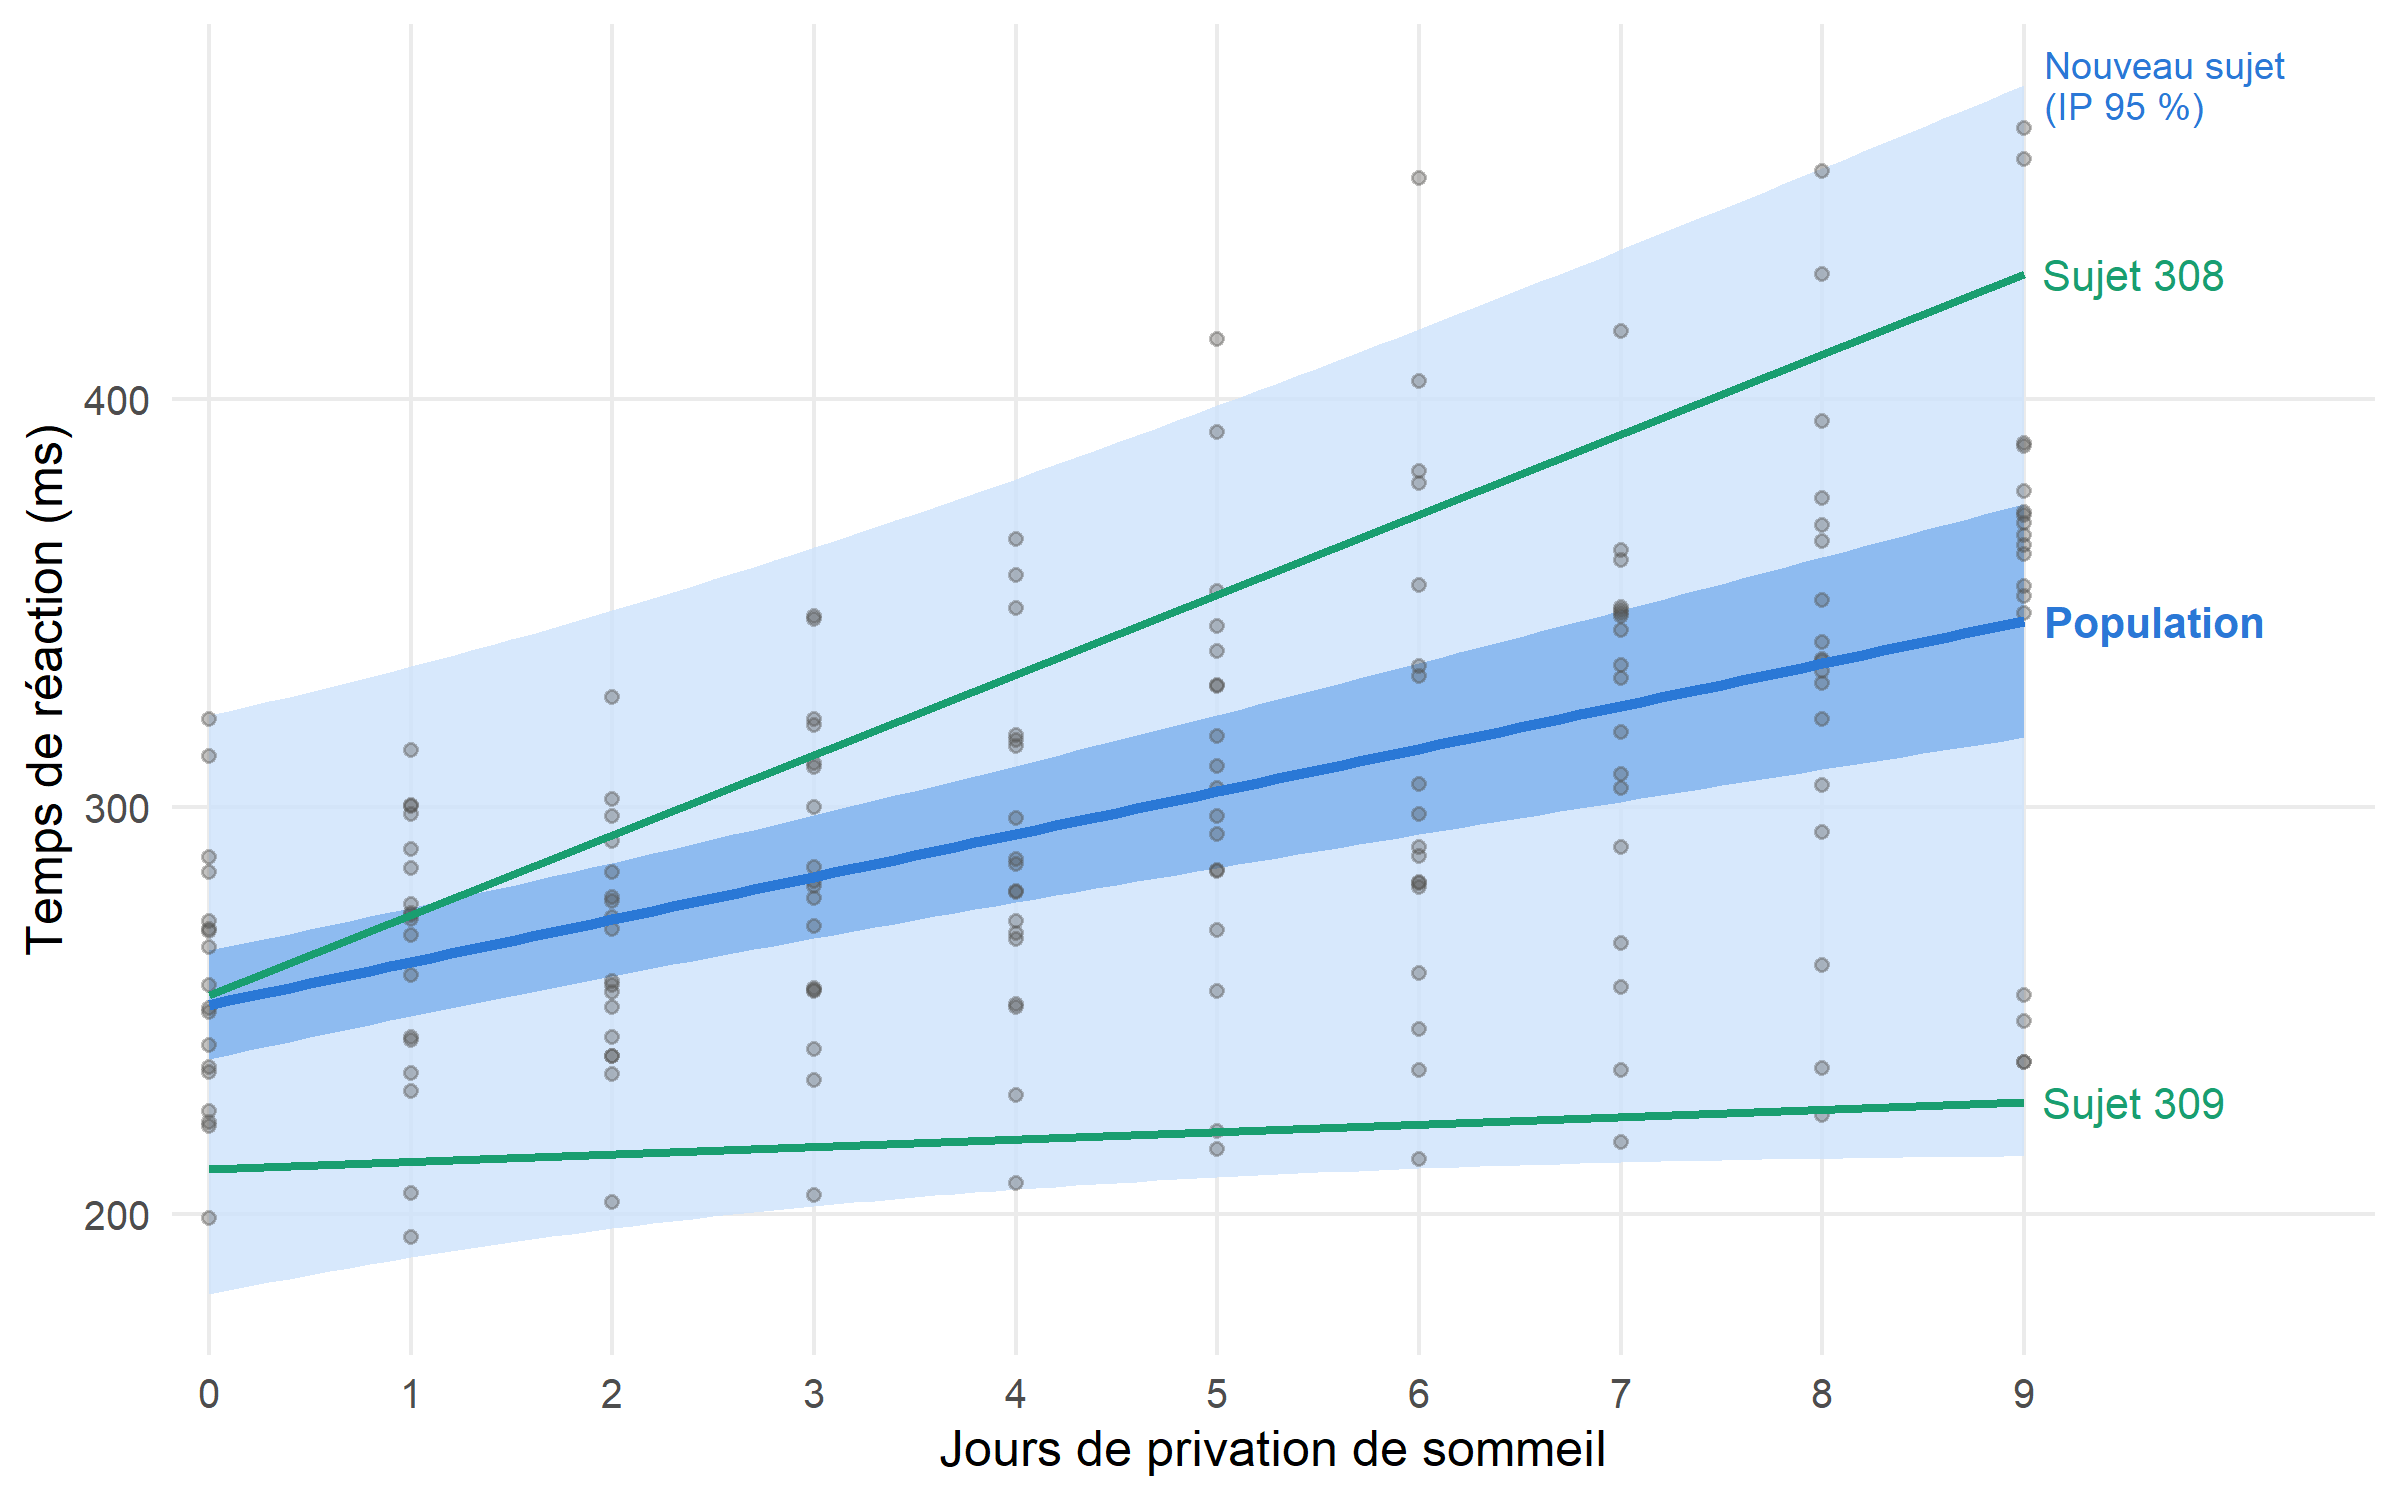
  • Pour le sujet 308 (qui existe dans nos données), la prédiction marginale et la prédiction conditionnelle diffèrent. On peut notamment voir qu’à \(t=0\), le temps de réaction moyen prédit et proche de la moyenne de population, mais qu’au bout de \(t=9\) jours, son temps de réaction prédit est plus élevé que la moyenne de population !
  • Pour le sujet 999, inconnu du modèle, les deux prédictions coïncident.

On peut quantifier l’incertitude des prédictions marginales et conditionnelles avec des intervalles de confiance et de prédiction. Ces deux intervalles seront différents, car …

  • … l’intervalle de confiance de la moyenne ne reflète que l’incertitude sur \(\hat{\boldsymbol\beta}\) ;
  • … tandis que l’intervalle de prédiction pour une observation dans un nouveau groupe ajoute la variabilité entre groupes ET la variabilité résiduelle (autrement dit, beaucoup plus d’incertitude).

On s’attend alors à une plage de valeurs plus large pour l’intervalle de prédiction que pour l’intervalle de confiance.

La figure suivante illustre cette distinction avec l’étude sur la privation de sommeil.

Figure 2: Prédictions du modèle m_randInterceptSlope. Ligne bleue et bande foncée : trajectoire moyenne de la population et son intervalle de confiance à 95 %. Bande claire : intervalle de prédiction à 95 % pour la mesure d’un nouveau sujet. En vert, les prédictions conditionnelles de deux sujets observés.

Au jour 9, la moyenne de la population est estimée à 346 ms, avec un intervalle de confiance de [317 ; 374] ms. Mais pour la mesure d’un nouveau sujet, l’intervalle de prédiction est de [214 ; 477] ms, soit environ 5 fois plus large !

Les références

Nakagawa, Shinichi, et Holger Schielzeth. 2013. « A General and Simple Method for Obtaining \(R^2\) from Generalized Linear Mixed-Effects Models ». Methods in Ecology and Evolution 4 (2): 133‑42. https://doi.org/10.1111/j.2041-210x.2012.00261.x.