4 Hypothèses du modèle

Comme pour la régression linéaire, ajuster un modèle mixte ne suffit pas : il faut aussi vérifier si les hypothèses qui le rendent pertinent semblent raisonnables. Certaines nous sont déjà familières, tandis que d’autres concernent les groupes et les effets aléatoires.

Voici les points auxquels nous allons faire attention :

  1. Linéarité : la relation moyenne entre les variables explicatives et la réponse est correctement spécifiée ;
  2. Homoscédasticité : la variance des résidus est constante, conditionnellement aux effets aléatoires.
  3. Normalité des résidus \(\varepsilon_{ij}\);
  4. Normalité des effets aléatoires \(u_i\) ;
  5. Indépendance entre effets aléatoires et variables explicatives : les particularités des groupes qui restent après prise en compte des variables du modèle sont supposées indépendantes de ces variables ;
  6. Structure de dépendance correcte : une fois les effets aléatoires et la structure résiduelle pris en compte, il ne doit plus rester de corrélation inexpliquée, notamment entre les résidus normalisés (voir plutôt, la section 5.1).

Le plus simple est de vérifier ces hypothèses graphiquement. Reprenonsalors le modèle de l’étude sur la privation de sommeil avec intercept et pente aléatoires. Comme en régression linéaire, on peut examiner les résidus et les valeurs ajustées à l’aide de graphiques.

Code R pour obtenir les graphiques de diagnostic
m_randInterceptSlope <- lmer(Reaction ~ Days + (Days | Subject), data = sleepstudy)

diag_df <- tibble(
    ajuste = fitted(m_randInterceptSlope),
    residu = resid(m_randInterceptSlope),
    std = resid(m_randInterceptSlope, type = "pearson", scaled = TRUE),
    Subject = sleepstudy$Subject,
    Days = sleepstudy$Days
)
re <- ranef(m_randInterceptSlope)$Subject

p1 <- ggplot(diag_df, aes(ajuste, residu)) +
    geom_hline(yintercept = 0, colour = col_cp) +
    geom_point(colour = col_pop, alpha = 0.6, size = 1.5) +
    geom_smooth(method = "loess", se = FALSE, colour = col_np, linewidth = 0.9) +
    labs(title = "Linéarité", x = "Valeurs ajustées", y = "Résidus")
p2 <- ggplot(diag_df, aes(ajuste, sqrt(abs(std)))) +
    geom_point(colour = col_pop, alpha = 0.6, size = 1.5) +
    geom_smooth(method = "loess", se = FALSE, colour = col_np, linewidth = 0.9) +
    scale_y_continuous(labels = function(x) fr(x, 1)) +
    labs(title = "Homoscédasticité", x = "Valeurs ajustées", y = "√|résidus standardisés|")
p3 <- ggplot(diag_df, aes(sample = std)) +
    stat_qq_line(colour = col_cp) +
    stat_qq(colour = col_pop, alpha = 0.6, size = 1.5) +
    scale_y_continuous(labels = function(x) fr(x, 1)) +
    labs(title = "Normalité des résidus", x = "Quantiles théoriques", y = "Résidus standardisés")
p4 <- ggplot(diag_df, aes(reorder(Subject, residu, FUN = median), residu)) +
    geom_hline(yintercept = 0, colour = col_cp) +
    geom_boxplot(fill = "#cde2fb", colour = col_pop, outlier.colour = col_np, linewidth = 0.4) +
    labs(title = "Résidus par sujet", x = "Sujet", y = "Résidus") +
    theme(axis.text.x = element_text(angle = 90, vjust = 0.5, size = 8))
p5 <- ggplot(re, aes(sample = `(Intercept)`)) +
    stat_qq_line(colour = col_cp) +
    stat_qq(colour = col_grp, size = 2) +
    labs(title = "Intercepts aléatoires", x = "Quantiles théoriques", y = expression(hat(u)[0 * i]))
p6 <- ggplot(re, aes(sample = Days)) +
    stat_qq_line(colour = col_cp) +
    stat_qq(colour = col_grp, size = 2) +
    labs(title = "Pentes aléatoires", x = "Quantiles théoriques", y = expression(hat(u)[1 * i]))

(p1 | p2) / (p3 | p4) / (p5 | p6) + plot_annotation(tag_levels = "A")
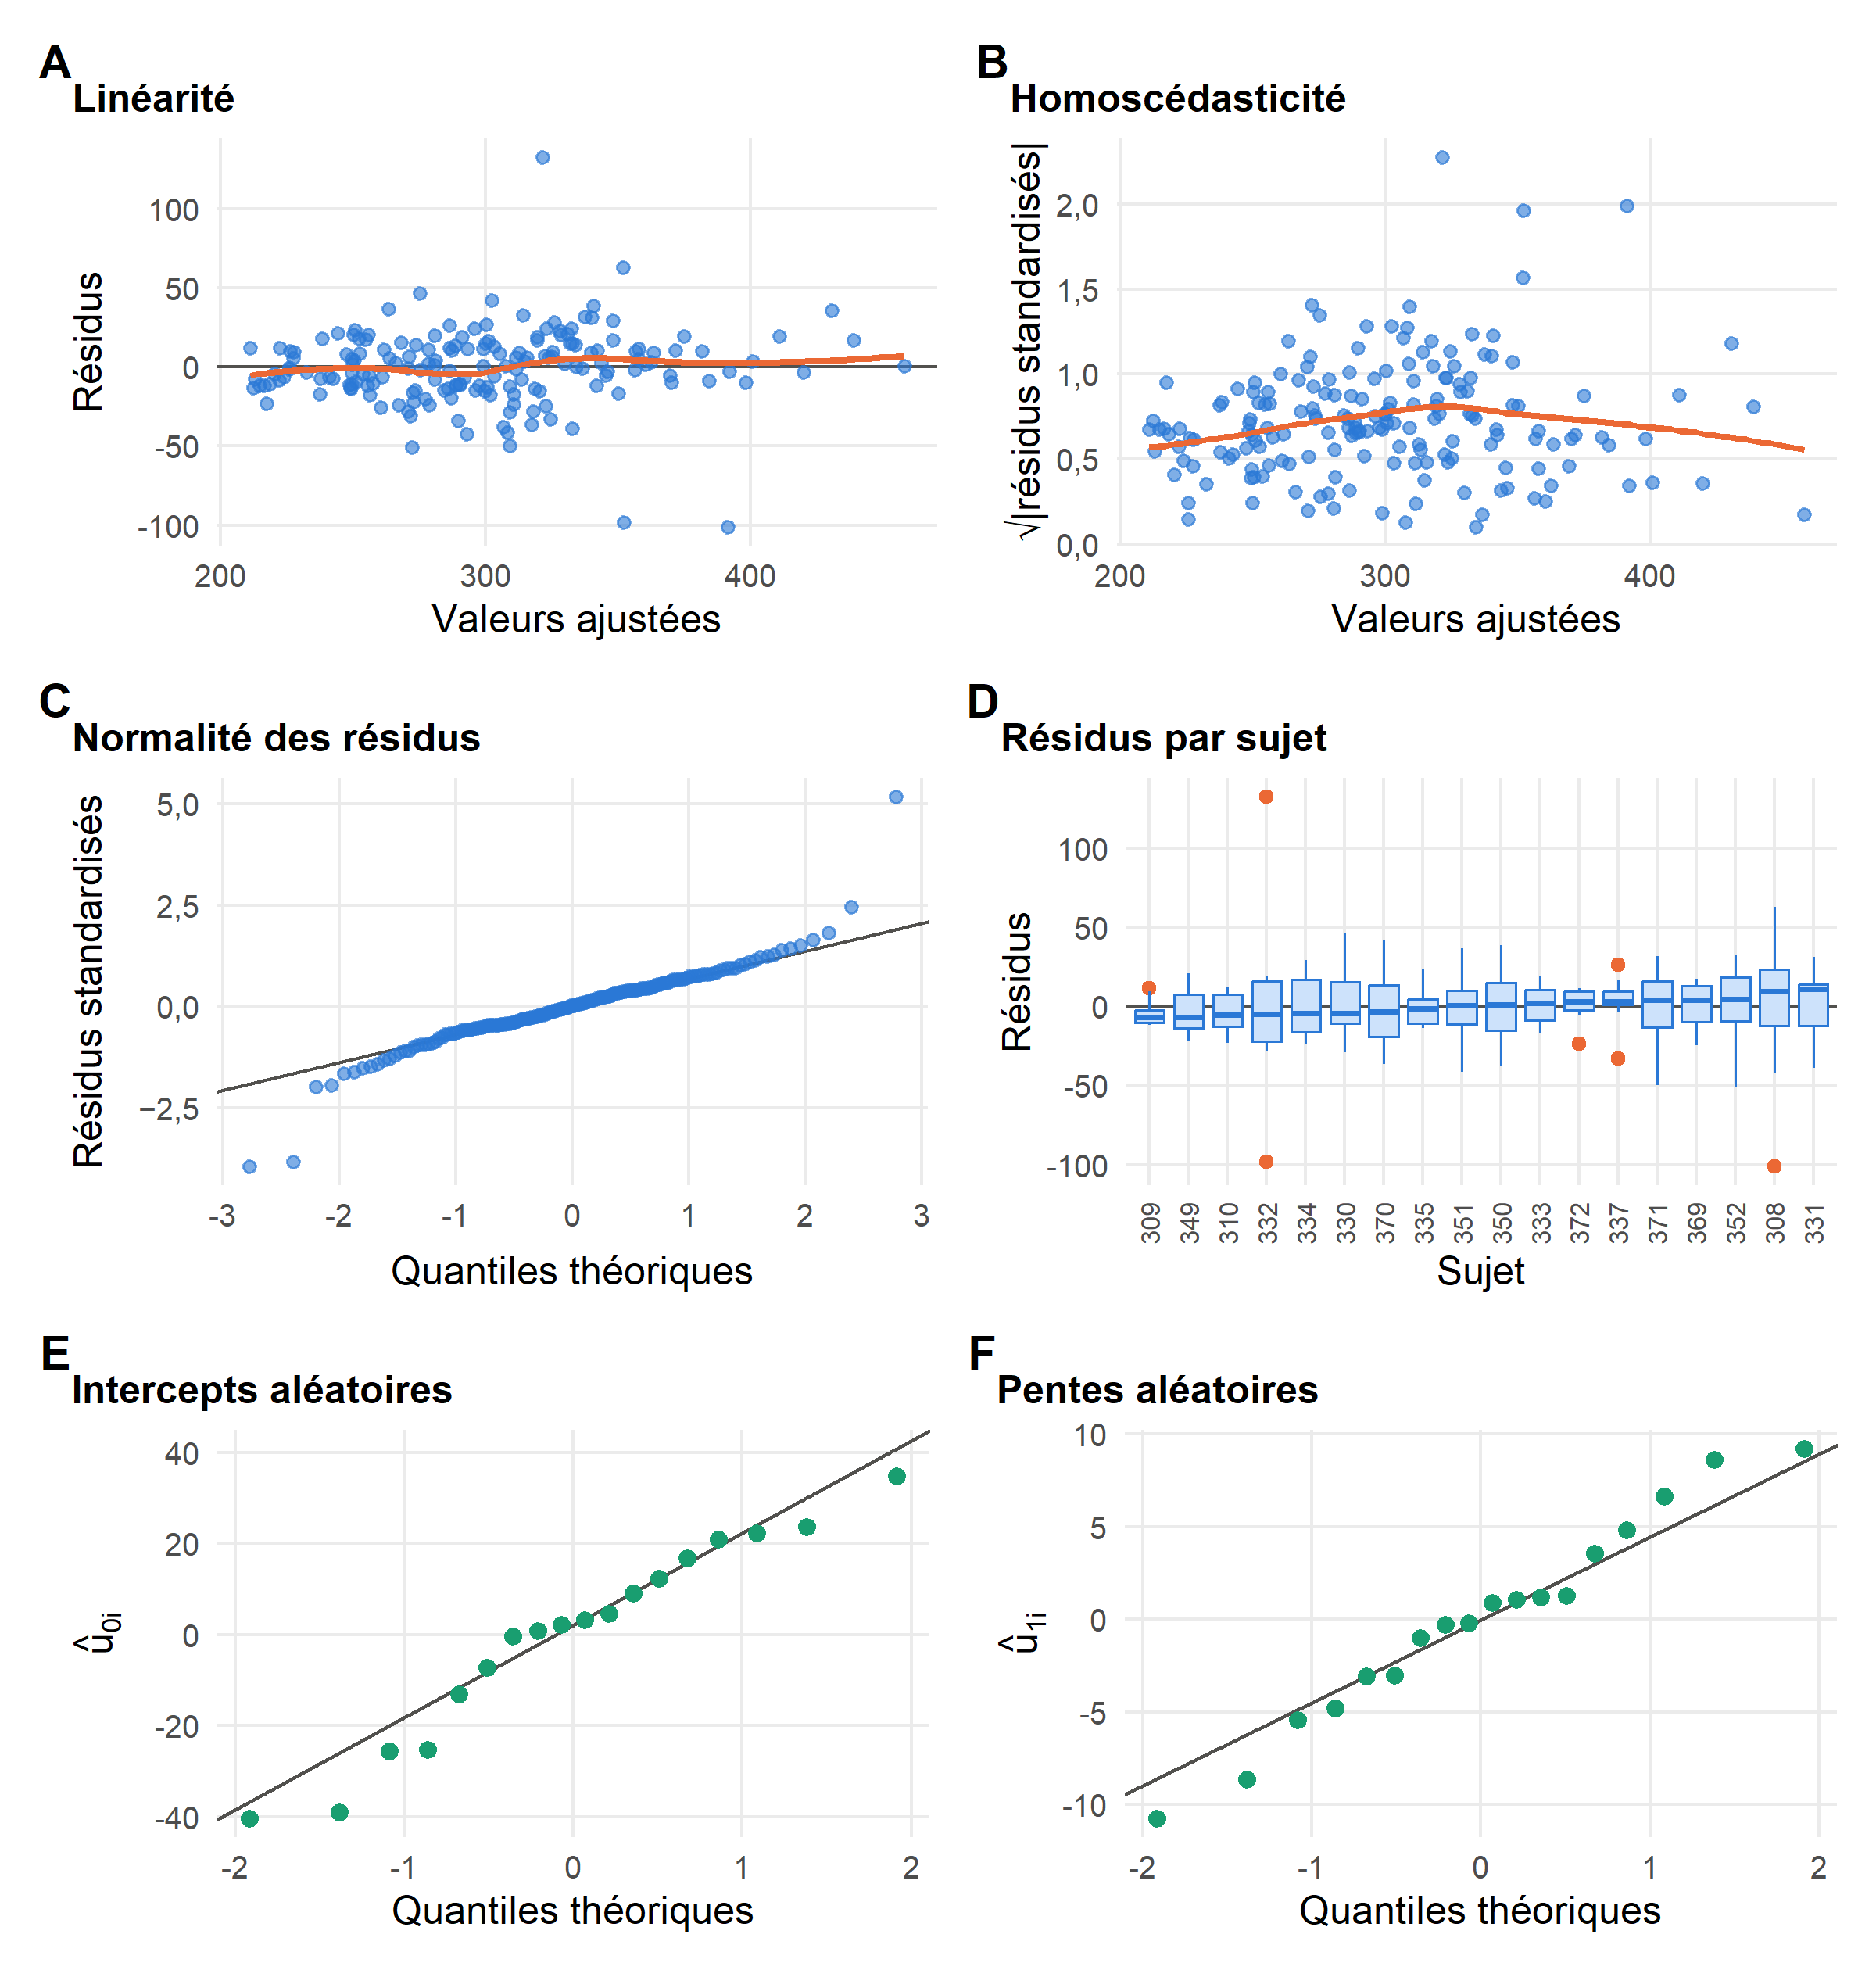
Figure 1: Diagnostics du modèle à intercept et pente aléatoires (m_randInterceptSlope). A : résidus en fonction des valeurs ajustées. B : racine des résidus standardisés absolus. C : QQ-plot des résidus. D : résidus par sujet. E et F : QQ-plots des effets aléatoires prédits.

Décrivons brièvement ce qu’on peut dire de la Figure 1 ?

  • A : les résidus ne présentent pas de tendance en fonction des valeurs ajustées. La relation linéaire avec Days semble donc adéquate ;
  • B : la dispersion augmente légèrement jusqu’aux valeurs ajustées intermédiaires (environ 300 à 350 ms), puis semble diminuer là où les points se raréfient. Ceci pourrait s’expliquer par la présence de quelques observations avec des résidus standardisés élevés (regardez en haut du graphique). L’homoscédasticité semble aussi correcte ;
  • C : sur le QQ-plot, les résidus suivent bien la droite, sauf aux extrémités. Quelques observations ont des résidus standardisés élevés ! La plus extrême est celle du sujet 332 au jour 6 (résidu standardisé de 5,2). Il peut être bon d’étudier l’influence de ces individus, comme on le présente en section 5.3 ;
  • D : la dispersion des résidus varie d’un sujet à l’autre ; le sujet 332 se distingue. Cela peut suggérer une variance résiduelle propre à chaque sujet (dit plus simplement, certains sujets sont plus “variables” que d’autres et ce qu’on utilise dans le modèle ne suffit pas à expliquer cette variabilité). La structure de covariance des résidus pourrait donc être changée (voir la section 5.1) ;
  • E et F : les effets aléatoires prédits semblent compatibles avec une loi normale.

On pourrait obtenir ces graphiques (en gros) avec une simple commande R, via : performance::check_model(). C’est peut-être moins joli, mais c’est bien plus pratique !